

Niektoré Enterprise aplikácie a virtualizačné systémy majú svoje vlastné mechanizmy na vytváranie odolných riešení. Konkrétne Oracle RAC (Oracle Real Application Cluster) je klaster pozostávajúci z dvoch alebo viacerých Oracle databázových serverov, ktoré spolupracujú na vyvážení záťaže a zabezpečení odolnosti na úrovni servera/aplikácie. Na prevádzku v takom režime je potrebné spoločné úložisko, ktorého úlohu zvyčajne plní úložné zariadenie.
Ako sme už diskutovali v jednom z našich , samo o sebe úložné zariadenie, napriek existencii redundantných komponentov (vrátane ovládačov), stále má body zlyhania – predovšetkým vo forme jedného súboru údajov. Preto, na vybudovanie riešenia Oracle s vysokými požiadavkami na spoľahlivosť, je potrebné komplikovať schému „N serverov – jedno úložné zariadenie”.
Najprv sa samozrejme musíme rozhodnúť, od akých rizík sa snažíme chrániť. V rámci tohto článku nebudeme skúmať ochranu pred hrozbami typu „priletel meteorit”. Takže vytváranie teritoriálne vzdialeného riešenia disaster recovery zostane témou nasledujúcich článkov. Tu preskúmame takzvané riešenie Cross-Rack disaster recovery, kde sa ochrana buduje na úrovni serverových skríň. Samotné skrine môžu byť umiestnené ako v jednej miestnosti, tak aj v rôznych, ale zvyčajne v rámci jednej budovy.
Tieto skrine by mali obsahovať celý potrebný súbor zariadení a softvéru, ktorý umožní prevádzku databáz Oracle nezávisle od stavu „suseda”. Inými slovami, pri použití riešenia Cross-Rack disaster recovery eliminujeme riziká pri zlyhaní:
- Servery aplikácií Oracle
- Úložné systémy
- Systémy prepínania
- Úplné zlyhanie všetkého zariadenia v skrini:
- Zlyhanie napájania
- Zlyhanie chladenia
- Externé faktory (ľudia, príroda a pod.)
Replikácia serverov Oracle predpokladá základný princíp fungovania Oracle RAC a realizuje sa prostredníctvom aplikácie. Replikácia prepínacích prostriedkov tiež nie je problém. Ale s replikáciou úložných systémov to nie je také jednoduché.
Najjednoduchšou možnosťou je replikácia dát z hlavného úložiska na záložné. Môže byť synchronná alebo asynchronná, v závislosti od možností úložiska. Pri asynchronnej replikácii sa však okamžite objavuje otázka zabezpečenia konzistencie dát vo vzťahu k Oracle. Aj keď existuje programová integrácia s aplikáciou, v prípade poruchy hlavného úložiska bude potrebné manuálne zásah od správcov, aby prepli klaster na záložné úložisko.
Zložitejšou možnosťou sú softvérové a/alebo hardvérové „virtualizátory“ úložiska, ktoré eliminujú problémy s konzistenciou a manuálnym zásahom. Avšak zložitosti nasadenia a následnej administrácie, ako aj značné náklady na takéto riešenia odrádzajú mnohých.
Presne pre takéto scenáre, ako je obnovovanie po katastrofách Cross-Rack, je vynikajúce riešenie All Flash pole AccelStor NeoSapphire™ s využitím architektúry Shared-Nothing. Tento model predstavuje dvojuzlový systém úložiska, ktorý využíva vlastnú technológiu FlexiRemap® pre prácu s flash pamäťami. Vďaka NeoSapphire™ H710 je schopná zabezpečiť výkonnosť až 600K IOPS pri 4K náhodnom zápise a viac ako 1M IOPS pri 4K náhodnom čítaní, čo je nedosiahnuteľné pri použití klasických RAID-based úložísk.
Hlavnou vlastnosťou NeoSapphire™ H710 je však realizácia dvoch uzlov vo forme samostatných skríň, z ktorých každá má vlastnú kópiu dát. Synchronizácia uzlov prebieha cez externé rozhranie InfiniBand. Vďaka takejto architektúre je možné rozložiť uzly na rôzne lokácie do vzdialenosti až 100 m, čím sa zabezpečuje riešenie obnovovania po katastrofách Cross-Rack. Oba uzly pracujú úplne synchronne. Z pohľadu hostiteľov H710 vyzerá ako bežné dvojkontrolerové úložisko. Preto nie sú potrebné žiadne dodatočné softvérové a hardvérové možnosti a žiadne obzvlášť zložené nastavenia.
Ak porovnáme všetky vyššie opísané riešenia obnovovania po katastrofách Cross-Rack, možnosť od AccelStor sa výrazne vyníma na pozadí ostatných:
AccelStor NeoSapphire™ Architektúra Shared Nothing
Softvérový alebo hardvérový „virtualizátor“ úložiska
Riešenie založené na replikácii
Dostupnosť
Zlyhanie servera
Bez výpadku
Bez výpadku
Bez výpadku
Zlyhanie prepínača
Bez výpadku
Bez výpadku
Bez výpadku
Zlyhanie úložného systému
Bez výpadku
Bez výpadku
S výpadkom
Zlyhanie celého rámca
Bez výpadku
Bez výpadku
S výpadkom
Náklady a zložitosť
Cena riešenia
Nízke*
Vysoká
Vysoká
Zložitosť nasadenia
Nízka
Vysoká
Vysoká
*AccelStor NeoSapphire™ je plne flash úložisko, ktoré stojí viac ako '3 centy', najmä ak má dvakrát väčšiu kapacitu. Avšak v porovnaní s konečnou cenou riešenia založeného na jeho platforme s porovnateľnými produktmi od iných dodávateľov, je cena považovaná za nízku.
Topológia pripojenia aplikačných serverov a uzlov All Flash úložiska bude vyzerať nasledovne:
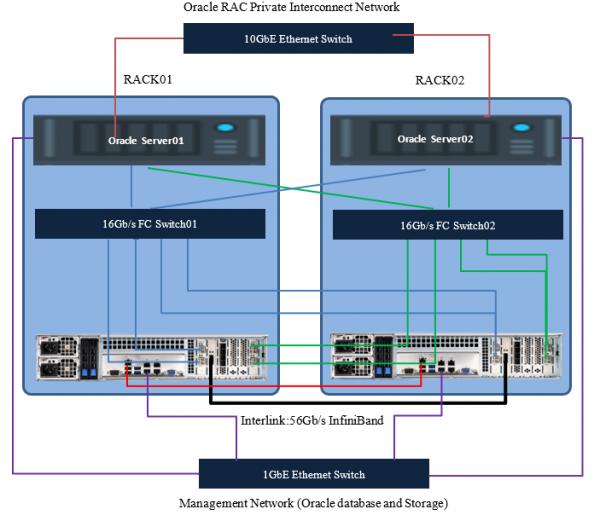
Pri plánovaní topológie je tiež veľmi odporúčané vytvoriť zálohu správcovských a interkonektívnych prepínačov serverov.
Odkiaľ budeme hovoriť, je pripojenie cez Fibre Channel. V prípade použitia iSCSI bude všeobecne rovnaké, s úpravami pre použité typy prepínačov a mierne odlišnými nastaveniami úložiska.
Príprava na úložisko
Používané vybavenie a softvér
Špecifikácie serverov a prepínačov
Komponenty
Popis
Servery Oracle Database 11g
Dva
Prevádzkový systém servera
Oracle Linux
Verzia databázy Oracle
11g (RAC)
Procesory na server
Dva 16-jadrové procesory Intel® Xeon® CPU E5-2667 v2 @ 3,30 GHz
Fyzická pamäť na server
128 GB
FC sieť
16 Gb/s FC s multipath
FC HBA
Emulex Lpe-16002B
Vyhradené verejné 1 GbE porty pre správu klastru
Intel Ethernet adaptér RJ45
16 Gb/s FC prepínač
Brocade 6505
Vyhradené súkromné 10 GbE porty pre synchronizáciu dát
Intel X520
Špecifikácia AccelStor NeoSapphire™ All Flash úložiska
Komponenty
Popis
Úložný systém
Model vysokej dostupnosti NeoSapphire™: H710
Verzia obrázku
4.0.1
Celkový počet diskov
48
Veľkosť disku
1,92 TB
Typ disku
SSD
FC cieľové porty
16 x 16 Gb porty (8 na uzol)
Správne porty
Kábel Ethernet 1 GbE spájajúci hostiteľov cez ethernetový prepínač
Srdcový port
Kábel Ethernet 1 GbE spájajúci medzi dvoma úložnými uzlami
Port na synchronizáciu dát
56 Gb/s InfiniBand kábel
Pred začiatkom používania úložiska je potrebné ho inicializovať. Predvolená adresa správy oboch uzlov je rovnaká (192.168.1.1). Je potrebné sa postupne pripojiť k nim a zadať nové (už rôzne) adresy správy a nastaviť synchronizáciu času, po čom môžu byť správcovské porty pripojené do jednej siete. Potom sa uzly spoja do HA páru určením podnetov pre interlinkové pripojenia.
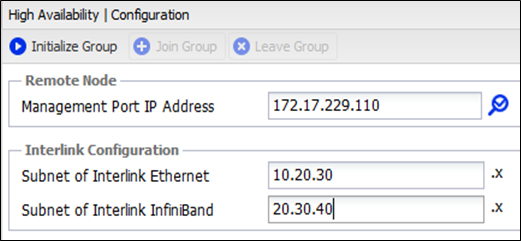
Po dokončení inicializácie je možné spravovať úložisko z akéhokoľvek uzla.
Potom vytvoríme potrebné objemy a publikujeme ich pre aplikačné servery.
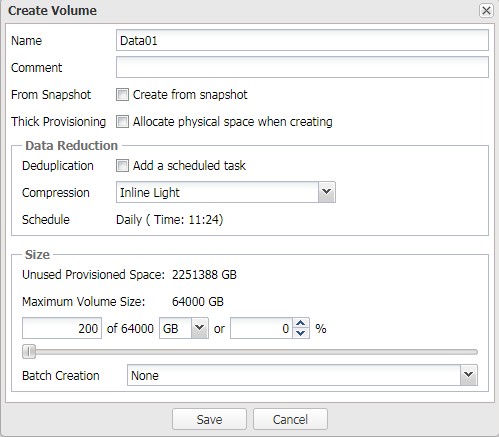
Veľmi sa odporúča vytvoriť niekoľko objemov pre Oracle ASM, pretože to zvýši počet cieľov pre servery, čo nakoniec zlepší celkový výkon (podrobnosti o frontách v inom) ).
Testovacia konfigurácia
Názov úložného objemu
Veľkosť objemu
Data01
200GB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Niektoré vysvetlenia týkajúce sa režimov prevádzky poľa a procesov, ktoré sa vyskytujú pri neštandardných situáciách
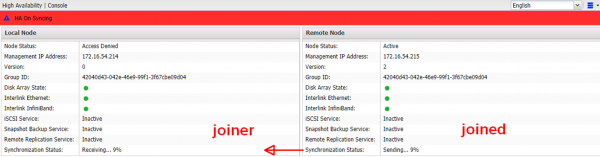
Každý uzol má parameter „verzia čísla“ v súbore dát. Po primárnej inicializácii je ten istý a rovný 1. Ak sú čísla verzií z akýchkoľvek dôvodov rôzne, vždy sa uskutoční synchronizácia dát z vyššej verzie na nižšiu, po čom sa číslo nižšej verzie zosúladí, čo znamená, že kópie sú rovnaké. Dôvody, prečo môžu byť verzie rôzne:
- Plánované reštartovanie jedného z uzlov
- Havária na jednom z uzlov v dôsledku náhleho vypnutia (napájanie, prehriatie a pod.).
- Prerušenie spojenia InfiniBand s nemožnosťou synchronizácie
- Havária na jednom z uzlov v dôsledku poškodenia dát. Tu bude potrebné vytvoriť novú HA skupinu a úplnú synchronizáciu súboru dát.
V každom prípade uzol, ktorý zostáva online, zvýši svoje číslo verzie o jednotku, aby po obnovení spojenia mohol synchronizovať svoj súbor dát s párom.
Ak dôjde k prerušeniu spojenia cez Ethernet link, Heartbeat sa dočasne prepne na InfiniBand a vráti sa späť počas 10s po jeho obnovení.
Nastavenie hostiteľov
Na zabezpečenie odolnosti voči poruchám a zvýšenie výkonu je potrebné povoliť podporu MPIO pre pole. K tomu je potrebné pridať do súboru /etc/multipath.conf riadky, po ktorých je nutné reštartovať službu multipath
Skrytý textdevices {
device {
vendor „AStor“
path_grouping_policy „group_by_prio“
path_selector „queue-length 0“
path_checker „tur“
features „0“
hardware_handler „0“
prio „const“
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
Ďalej, aby ASM pracoval s MPIO cez ASMLib, je potrebné zmeniť súbor /etc/sysconfig/oracleasm a potom vykonať /etc/init.d/oracleasm scandisks
Skrytý text
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER=„dm“
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE=„sd“
Poznámka
Ak nechcete používať ASMLib, môžete použiť pravidlá UDEV, ktoré sú základom pre ASMLib.
Od verzie 12.1.0.2 je možnosť Oracle Database dostupná na inštaláciu ako súčasť softvéru ASMFD.
Je dôležité zabezpečiť, aby vytvárané disky pre Oracle ASM boli zarovnané s veľkosťou bloku, s ktorým fyzicky pracuje pole (4K). Inak môžu nastať problémy s výkonom. Preto je potrebné vytvárať objemy s príslušnými parametrami:
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Rozdelenie databáz na vytvorené objemy pre našu testovaciu konfiguráciu
Názov úložného objemu
Veľkosť objemu
Mapovanie LUN objemov
Podrobnosti o objekte ASM Volume
Veľkosť alokačnej jednotky
Data01
200GB
Mapovať všetky úložné objemy na úložný systém všetkými dátovými portami
Redundancia: Normálna
Názov: DGDATA
Účel: Dátové súbory
4MB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Redundancia: Normálna
Názov: DGGRID1
Účel: Mriežka: CRS a hlasovanie
4MB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Redundancia: Normálna
Názov: DGGRID2
Účel: Mriežka: CRS a hlasovanie
4MB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redundancia: Normálna
Názov: DGREDO1
Účel: Redo log vlákna 1
4MB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redundancia: Normálna
Názov: DGREDO2
Účel: Redo log vlákna 2
4MB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Nastavenia databázy
- Veľkosť bloku = 8K
- Priestor na swap = 16GB
- Zakázať AMM (Automatické riadenie pamäte)
- Zakázať transparentné obrovské stránky
Ostatné nastavenia
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness=10
✓ vm.min_free_kbytes=524288 # ne nastavujte toto, ak používate Linux x86
✓ vm.vfs_cache_pressure=200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus “/as sysdba”
alter system set processes=2000 scope=spfile;
alter system set open_cursors=2000 scope=spfile;
alter system set session_cached_cursors=300 scope=spfile;
alter system set db_files=8192 scope=spfile;
Test na odolnosť voči poruchám
Na účely demonštrácie bol použitý HammerDB na simuláciu OLTP záťaže. Konfigurácia HammerDB:
Počet skladov
256
Celkový počet transakcií na používateľa
1000000000000
Virtuálni používatelia
256
Výsledkom bolo 2.1M TPM, čo je ďaleko od limitu výkonu poľa , ale je to "strop" pre aktuálnu hardvérovú konfiguráciu serverov (predovšetkým kvôli procesorom) a ich počtu. Cieľom tohto testu je však demonštrácia odolnosti riešenia ako celku, nie dosiahnutie maximálnych výkonov. Preto sa jednoducho budeme odvolávať na toto číslo.
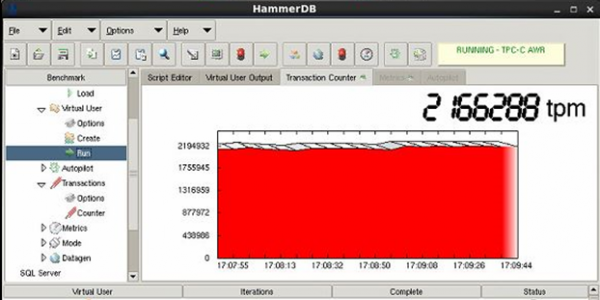
Test na poruchu jednej z nód
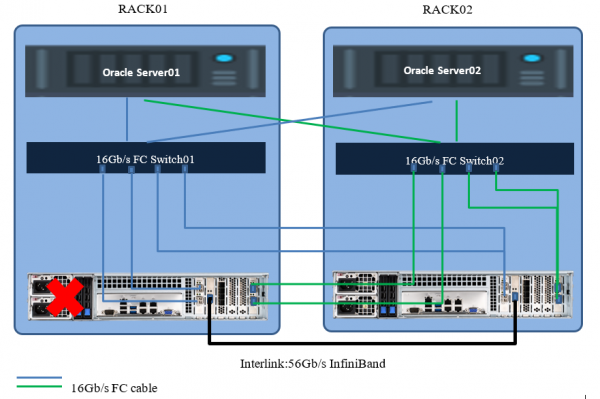
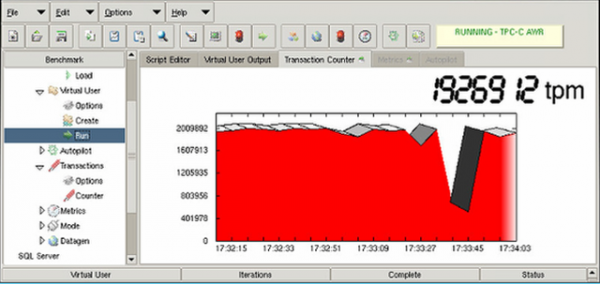
Hostitelia stratili časť ciest do úložiska, ale pokračovali v práci cez zostávajúce so druhou nódou. Výkon klesol na niekoľko sekúnd kvôli prestavbe ciest a potom sa vrátil na normálne hodnoty. K prerušeniu obsluhy nedošlo.
Test na poruchu skrinky so všetkým vybavením
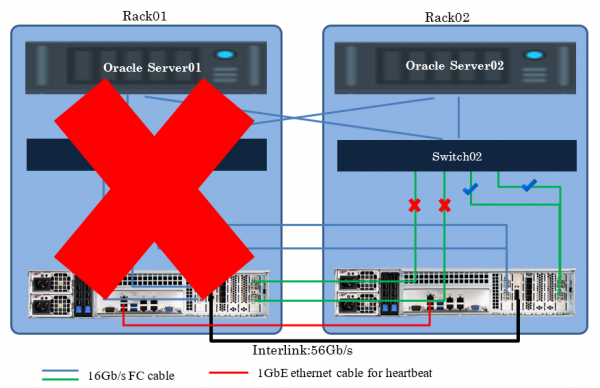
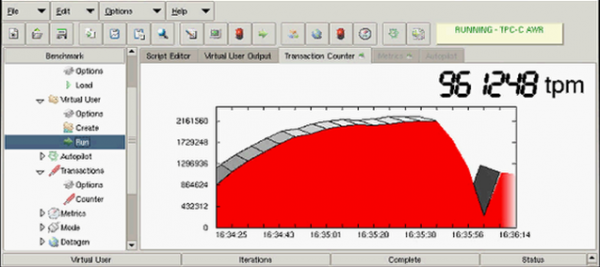
V tomto prípade výkon tiež klesol na niekoľko sekúnd kvôli prestavbe ciest a potom sa vrátil na polovičné hodnoty pôvodného ukazovateľa. Výsledok sa znížil na polovicu od pôvodnej hodnoty kvôli vylúčeniu jedného servera aplikácií. K prerušeniu obsluhy tiež nedošlo.
Ak existujú požiadavky na implementáciu riešenia s vysokou dostupnosťou Cross-Rack disaster recovery pre Oracle za rozumnú cenu a s minimálnym úsilím na nasadenie/administráciu, potom spolupráca Oracle RAC a architektúry bude jednou z najlepších možností. Namiesto Oracle RAC môže byť akýkoľvek iný softvér, ktorý podporuje klastrové riešenia, tie isté DBMS alebo virtualizačné systémy, napríklad. Zásada budovania riešenia zostane rovnaká. A konečný ukazovateľ – to je nulová hodnota pre RTO a RPO.
Zdroj: habr.com
