

Ak používate databázu časových radov (timeseries db, ) ako hlavné úložisko pre web so štatistikou, môžete namiesto riešenia problému získať len množstvo problémov. Pracujem na projekte, kde sa používa takáto databáza, a niekedy mi InfluxDB, o ktorej bude reč, priniesla úplne neočakávané prekvapenia.
Upozornenie: uvedené problémy sa týkajú verzie InfluxDB 1.7.4.
Prečo časové radové databázy?
Projekt spočíva v sledovaní transakcií v rôznych blockchainoch a zobrazovaní štatistiky. Konkrétne sledujeme emisiu a spaľovanie stablecoinov (). Na základe týchto transakcií je potrebné vytvárať grafy a zobrazovať súhrnné tabuľky.
Pri analýze transakcií prišla myšlienka: využiť databázu časových radov InfluxDB ako hlavné úložisko. Transakcie sú bodmi v čase a do modelu časového radu sa dobre hodia.
Ešte funkcie agregácie vyzerali veľmi pohodlne — ideálne sú pre spracovanie grafov s dlhým obdobím. Užívateľ potrebuje graf za rok, a v databáze je súbor údajov s časovým rámcom päť minút. Posielať mu všetkých sto tisíc bodov je bezvýznamné — okrem dlhého spracovania sa ani na obrazovku nezmestia. Môžete napísať svoju implementáciu zvýšenia časového rámca alebo využiť integrované funkcie agregácie v Influx. S ich pomocou môžete zoskupiť údaje podľa dní a poslať potrebných 365 bodov.
Trošku ma znepokojovalo, že takéto databázy sa zvyčajne používajú na zbieranie metrík. Monitorovanie serverov, IoT zariadení, všetko, z čoho „tečú“ milióny bodov vo forme: [<čas> — <hodnota metriky>]. Ale ak databáza dobre funguje s veľkým tokom údajov, prečo by mala malá kapacita spôsobovať problémy? S touto myšlienkou sme vzali InfluxDB do práce.
Čo ešte ponúka InfluxDB
Okrem spomínaných funkcií agregácie je ešte jedna úžasná vec — kontinuálne dotazy (). To je integrovaný plánovač v databáze, ktorý môže spracovávať údaje podľa harmonogramu. Napríklad, môžete každých 24 hodín zoskupiť všetky záznamy za deň, vypočítať priemer a zapísať jeden nový bod do inej tabuľky bez písania vlastných riešení.
Existuje tiež zásady uchovávania () — nastavenie vymazania údajov po určitom období. Je užitočné, keď je potrebné uchovávať zaťaženie CPU za týždeň s meraniami každú sekundu, ale na obdobie niekoľkých mesiacov nie je taká presnosť potrebná. V takej situácii sa dá urobiť toto:
- vytvoriť continuous query na agregáciu údajov do inej tabuľky;
- pre prvú tabuľku určiť politiku vymazania metrík, ktoré sú staršie ako ten týždeň.
A Influx bude samostatne zmenšovať veľkosť údajov a vymazávať nepotrebné.
O uchovávaných údajoch
Uchovávaných údajov nie je veľa: okolo 70 tisíc transakcií a ešte jeden milión bodov s trhovými informáciami. Pridávanie nových záznamov — nie viac ako 3000 bodov za deň. Rovnako sú tu metriky pre web, ale tam je údajov málo a podľa retention policy sú uchovávané maximálne mesiac.
Problémy
Počas vývoja a následného testovania služby sa vyskytovali čoraz závažnejšie problémy pri prevádzke InfluxDB.
1. Vymazanie údajov
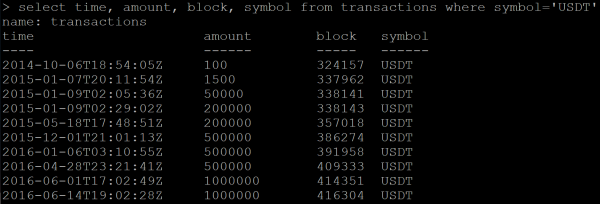
Existuje séria údajov s transakciami:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Výsledok:
Posielam príkaz na vymazanie údajov:
DELETE FROM transactions WHERE symbol='USDT'Následne robím dopyt na získanie už vymazaných údajov. A Influx namiesto prázdnej odpovede vracia časť údajov, ktoré mali byť vymazané.
Snažím sa vymazať tabuľku celú:
DROP MEASUREMENT transactionsKontrolujem vymazanie tabuľky:
SHOW MEASUREMENTSTabuľku v zozname nepozorujem, ale nový dopyt údajov stále vracia ten istý súbor transakcií.
Problém sa mi vyskytol len raz, pretože prípad s vymazaním — ojedinelý jav. Ale takéto správanie databázy zjavne nezapadá do rámcov 'správnej' práce. Neskôr na GitHube som našiel otvorený príspevok takmer ročnej starosti na túto tému.
Výsledkom bolo, že pomohlo vymazanie a následné obnovenie celej databázy.
2. Čísla s pohyblivou desatinnou čiarkou
Matematické výpočty pri použití zabudovaných funkcií v InfluxDB dávajú chyby presnosti. Nie je to, že by to bolo niečo nezvyčajné, ale nepríjemné.
V mojom prípade údaje majú finančný aspekt a chcel by som ich spracovávať s vysokou presnosťou. Z tohto dôvodu plánujem vzdať sa continuous queries.
3. Continuous queries sa nedajú prispôsobiť rôznym časovým zónam
Na službe je tabuľka s dennou štatistikou transakcií. Pre každý deň je potrebné zgrupovať všetky transakcie za tieto dni. Ale deň pre každého používateľa začne v inom čase, a teda aj súbor transakcií je odlišný. Podľa UTC je posunov, pre ktoré je potrebné agregovať údaje.
V InfluxDB pri zgrupovaní podľa času je možné dodatočne zadať posun, napríklad pre moskovský čas (UTC+3):
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Ale výsledok dopytu bude nesprávny. Z nejakého dôvodu zgrupované údaje budú začínať až v roku 1677 (InfluxDB oficiálne podporuje časový interval od tohto roku):
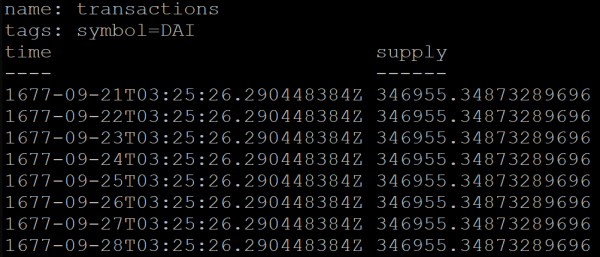
Na obídenie tejto problémy sme dočasne prešli na UTC+0.
4. Výkon
Na internete je veľa benchmarkov s porovnaniami InfluxDB a iných databáz. Pri prvom oboznámení vyzerali ako marketingové materiály, ale teraz si myslím, že v nich je určitý podiel pravdy.
Povieme o mojom prípade.
Služba poskytuje metódu API, ktorá vracia štatistiku za posledných 24 hodín. Pri výpočtoch metóda trikrát vyžaduje databázu s takýmito dopytmi:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCVysvetlenie:
- V prvom dopyte dostaneme posledné body pre každú mincu s údajmi o trhu. Osem bodov pre osem mincí v mojom prípade.
- Druhý dopyt získava jeden najnovší bod.
- Tretí dopyt žiada zoznam transakcií za posledných 24 hodín, ich môže byť niekoľko sto.
Ujasním, že v InfluxDB sa index automaticky vytvára podľa tagov a času, čo urýchľuje dopyty. V prvom dopyte symbol je tag.
Urobil som stresový test pre túto metódu API. Pri 25 RPS server vykazoval úplné vyťaženie šiestich CPU:
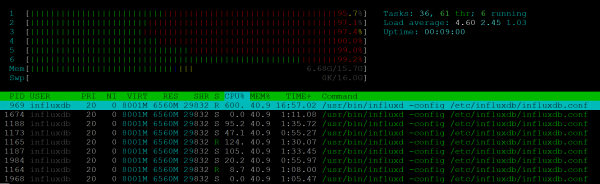
Pri tom proces NodeJs vôbec nezapril záťaž.
Rýchlosť vykonávania sa zhoršila už na 7-10 RPS: ak jeden klient mohol získať odpoveď za 200 ms, tak 10 klientov muselo čakať sekundu. 25 RPS je hranica, pri ktorej sa stabilita zhoršila, klientom sa vracali 500 chyby.
S takýmto výkonom nie je možné používať Influx v našom projekte. Viac ako to: v projekte, kde je potrebné preukazovať monitoring viacerým klientom, môžu vzniknúť podobné problémy a server s metrikami bude preťažený.
Záver
Hlavný záver z získaných skúseností je ten, že do projektu nemožno zavádzať neznámu technológiu bez dostatočnej analýzy. Jednoduché prehľadanie otvorených tiketov na GitHub-e mohlo poskytnúť informácie, ktoré by zabránili použitiu InfluxDB ako hlavného úložiska dát.
InfluxDB mala dobre vyhovieť potrebám môjho projektu, no prax ukázala, že táto databáza nespĺňa požiadavky a má množstvo chýb.
Vo repozitári projektu už nájdete verziu 2.0.0-beta, zostáva len dúfať, že v druhej verzii prinesú významné vylepšenia. A zatiaľ sa pustím do štúdia dokumentácie TimescaleDB.
Zdroj: habr.com
