

Logy sú dôležitou súčasťou systému, ktorá umožňuje pochopiť, či funguje (alebo nefunguje) tak, ako sa očakávalo. V podmienkach mikroslužobnej architektúry sa práca s logmi stáva samostatnou disciplínou špeciálnej olympiády. Je potrebné vyriešiť množstvo otázok:
- ako zapisovať logy z aplikácie;
- kam zapisovať logy;
- ako doručovať logy na uloženie a spracovanie;
- ako spracovávať a ukladať logy.
Použitie populárnych technológii kontajnerizácie pridáva piesok na hrable na poli možností riešenia úlohy.
O tom je práve prepis prednášky Jurija Bušmeleva „Mapa hrablí na poli zbierania a doručovania logov“
Kto má záujem, prosím, pod kat.
Volám sa Jurij Bušmelev. Pracujem v Lazada. Dnes budem rozprávať o tom, ako sme robili naše logy, ako sme ich zbierali a čo do nich zapisujeme.
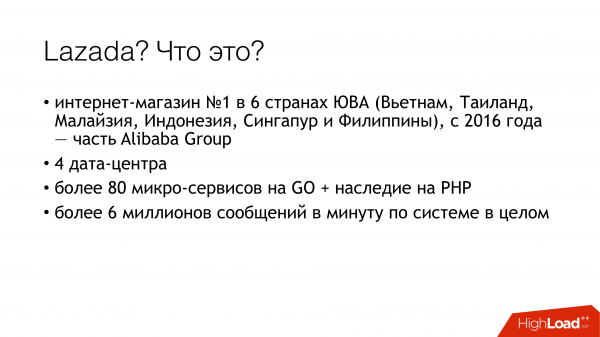
Odkiaľ sme? Kto sme? Lazada je internetový obchod číslo 1 v šiestich krajinách juhovýchodnej Ázie. Všetky tieto krajiny máme rozdelené podľa dátových centier. Momentálne máme 4 dátové centrá. Prečo je to dôležité? Pretože niektoré riešenia boli podmienené tým, že medzi centrami je veľmi slabé prepojenie. Máme mikroslužobnú architektúru. Bol som prekvapený, keď som zistil, že máme už 80 mikroslužieb. Keď som začínal s úlohou ohľadom logov, bolo ich len 20. Navyše máme pomerne veľký kus PHP legacy, s ktorým tiež musíme žiť a zmierovať sa. To všetko nám v súčasnosti generuje viac ako 6 miliónov správ za minútu v celom systéme. Ďalej budem ukazovať, ako sa s tým snažíme žiť a prečo je to také.
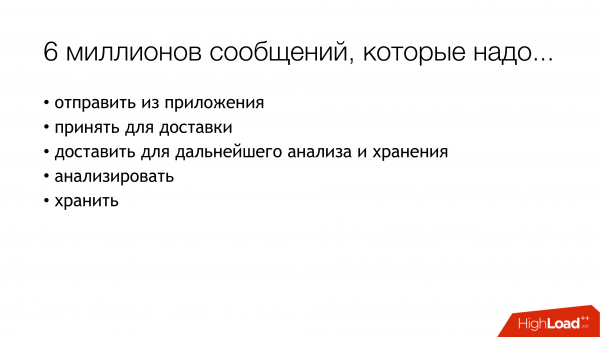
S týmito 6 miliónmi správ musíme nejakým spôsobom žiť. Čo s nimi musíme urobiť? 6 miliónov správ, ktoré musíme:
- odoslať z aplikácie
- prijať na doručenie
- doručiť na analýzu a uloženie.
- analyzovať
- nejako ukladať.
Keď sa objavilo tri milióny správ, vyzeral som približne takto. Pretože sme začínali s nejakými centami. Je jasné, že sa tam zapisujú logy aplikácií. Napríklad, nepodarilo sa pripojiť k databáze, podarilo sa pripojiť k databáze, ale nepodarilo sa niečo prečítať. Ale okrem toho každý náš mikroslužba zapisuje aj access-log. Každý požiadavok, ktorý pristane na mikroslužbe, padne do logu. Prečo to robíme? Vývojári chcú mať možnosť sledovania. V každom access-logu leží pole traceid, podľa ktorého špeciálne rozhranie odkrýva celú reťaz a pekne zobrazuje sledovanie. Sledovanie ukazuje, ako prebiehala požiadavka, a to pomáha našim vývojárom rýchlejšie sa vysporiadať so všetkou neidentifikovanou anomáliou.
Ako s tým žiť? Teraz v skratke opíšem možnosti — ako sa táto problématika vôbec rieši. Ako riešiť úlohu zbierania, prenosu a ukladania logov.
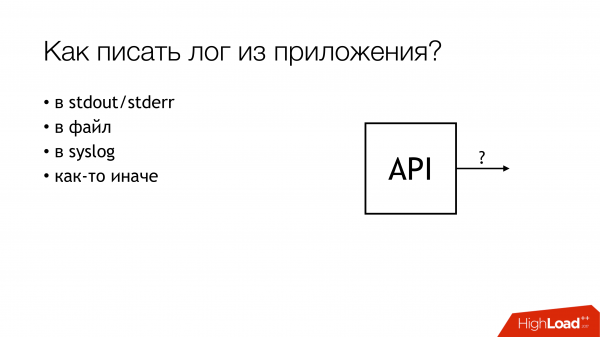
Ako zapisovať z aplikácie? Je jasné, že existujú rôzne spôsoby. Predovšetkým existujú best practices, ako hovoria módni odborníci. Existuje aj stará škola v dvoch variantoch, ako rozprávali naši predkovia. Existujú aj iné spôsoby.
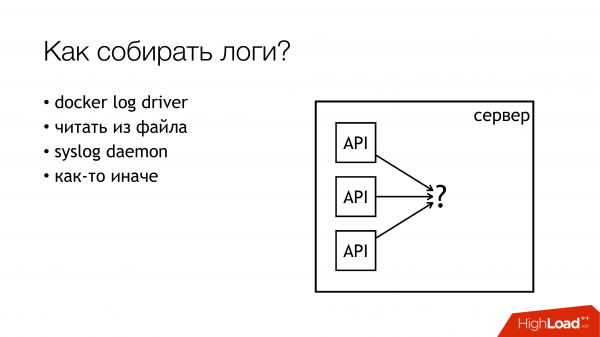
So zbieraním logov je situácia približne rovnaká. Možností riešenia tejto konkrétnej časti nie je až tak veľa. Je ich už viac, ale ešte stále nie tak veľa.
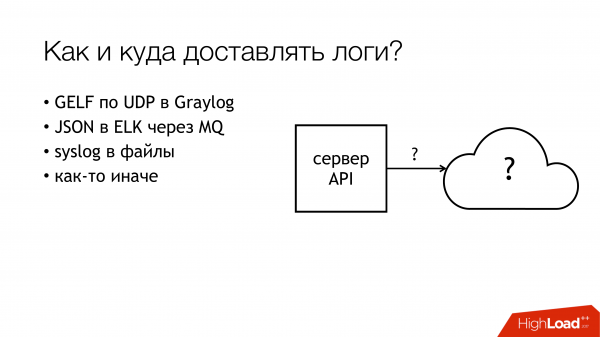
S dodávaním a následnou analýzou sa však počet variácií začína explodovať. Každý variant teraz nebudem opisovať. Myslím, že hlavné možnosti sú známe každému, kto sa zaujímal o túto tému.
Ukážem, ako sme to robili v Lazada, a ako vlastne všetko začalo.
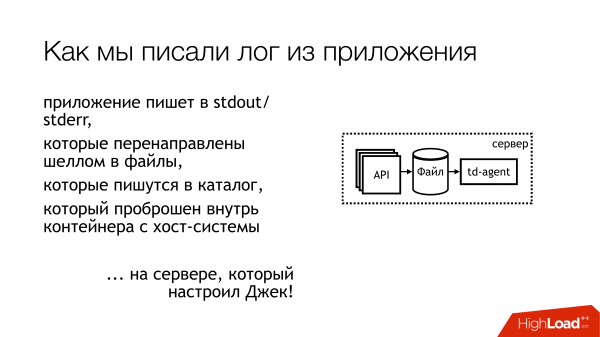
Pred rokom som prišiel do Lazady a poslali ma na projekt o logoch. Bolo to približne takto. Log z aplikácie sa zapisoval do stdout a stderr. Všetko bolo urobené štýlovo. Ale potom to vývojári vyhodili zo štandardných prúdov, a potom sa s tým nejakým spôsobom vysporiadajú odborníci na infraštruktúru. Medzi odborníkmi na infraštruktúru a vývojármi sú ešte release manažéri, ktorí povedali: „ehm… no dobre, zabaliť ich do súboru jednoducho shellom a koniec“. A keďže to všetko bolo v kontejnery, zabaliť to priamo do samotného kontajnera, mapovali sme dovnútra priečinok a položili to tam. Myslím, že je všetkým približne jasné, čo z toho vzniklo.
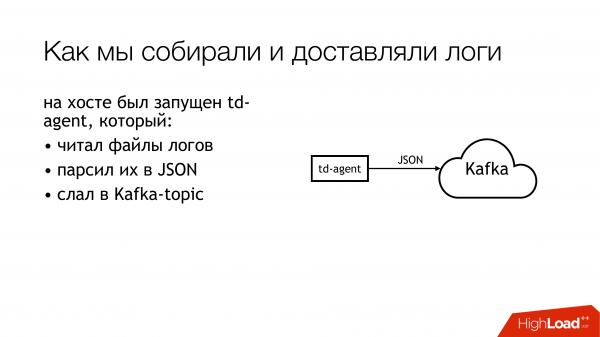
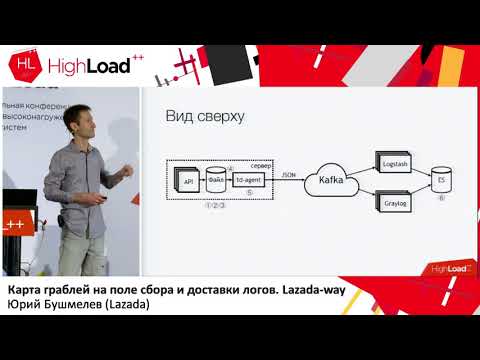
Pozrime sa zatiaľ trochu širšie. Ako sme tieto logy doručovali. Niekto si vybral td-agent, ktorý je v skutočnosti fluentd, ale nie úplne fluentd. Ja som nikdy nepochopil vzťah týchto dvoch projektov, ale zdá sa, že sú o tom istom. A tento fluentd, napísaný v Ruby, čítal súbory logov, parsel ich do JSON podľa nejakých regulárnych výrazov. Potom ich odosielal do Kafka. A v Kafka sme mali pre každé API štyri samostatné topic-y. Prečo štyri? Pretože máme live, staging a preto existuje stdout a stderr. Vývojári ich vytvárajú, a infraštruktúrni odborníci ich musia vytvárať v Kafka. A Kafka bola kontrolovaná iným oddelením. Preto bolo potrebné vytvoriť tiket, aby vytvorili štyri topic-y na každé API. Všetci na to zabúdali. Celkovo to bola chaotická situácia.
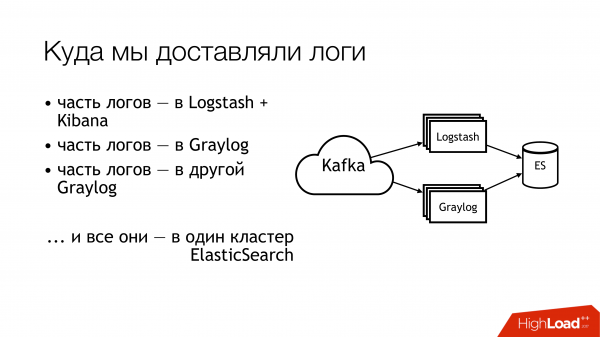
Čo sme s tým ďalej robili? Odosielali sme to do Kafka. Potom z Kafka polovica logov odletela do Logstash. Druhá polovica logov sa rozdelila. Časť odletela do jedného Graylogu, časť – do druhého Graylogu. Nakoniec to všetko skončilo v jednom Elasticsearch klastri. Teda, celý tento chaos nakoniec padol tam. Takto sa to nerobí!
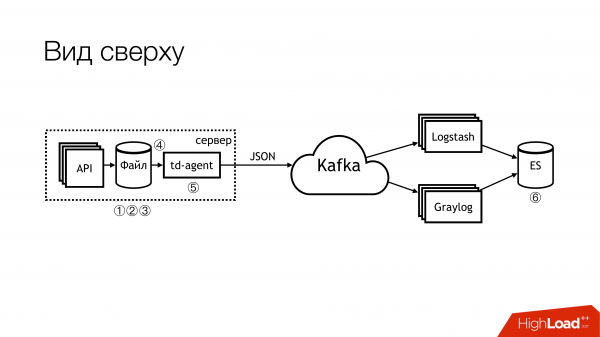
Toto je takto vyzerá, ak sa na to pozrieme z diaľky. Takto to nerobte! Tu sú číslicami okamžite označené problematické miesta. V skutočnosti ich je viac, ale 6 — to sú naozaj veľmi problematické, s ktorými je potrebné niečo urobiť. O nich teraz zvlášť poviem.
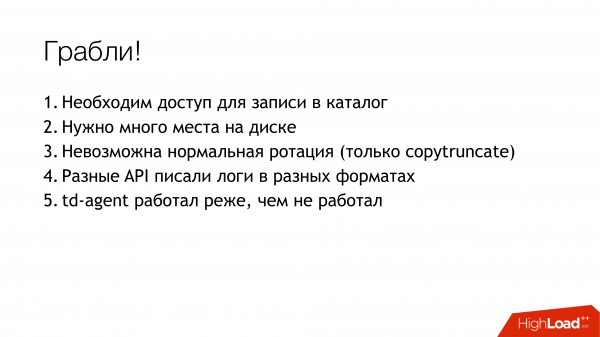
Tu (1,2,3) sa píšu súbory, a teda tu sú hneď tri prekážky.
Prvé (1) — musíme ich niekam zapisovať. Nie vždy by sme chceli poskytnúť API možnosť zapisovať priamo do súboru. Je dobré, aby API bolo izolované v kontajneri, a ešte lepšie – aby bolo v režime iba na čítanie. Ja som sysadmin, takže mám trochu alternatívny pohľad na tieto veci.
Druhý bod (2,3) — prichádza k nám množstvo požiadaviek do API. API zapisuje veľa údajov do súboru. Súbory rastú. Musíme ich rotovať. Lebo inak na disku nezostane miesto. Rotácia je zložitá, pretože sú vytvorené preposielaním cez shell do adresára. Nemôžeme to rotovať. Nemožno povedať aplikácii, aby znovu otvorila deskriptory. Pretože vývojári sa na vás pozrú ako na blázna: „Aké deskriptory? My píšeme rovno do stdout.“ Infrastruktúrny tím urobil copytruncate v logrotate, ktorý jednoducho skopíruje súbor a zmenší pôvodný. Takže medzi týmito procesmi kopírovania väčšinou dôjde k zaplneniu miesta na disku.
(4) Mali sme rôzne formáty v rôznych API. Trochu sa líšili, ale bolo potrebné písať rôzne regexp. Keďže to všetko spravoval Puppet, bola tam veľká kôpka tried so svojimi problémami. Navyše, td-agent mohol väčšinu času spotrebovávať pamäť a spomaľovať, mohol sa tváriť, že pracuje, a nič nerobiť. Z vonku bolo nemožné pochopiť, že nič nerobí. V tom lepšom prípade spadol, a niekto ho neskôr znovu naštartoval. Presnejšie, prišiel alert a niekto ho šiel manuálne reštartovať.
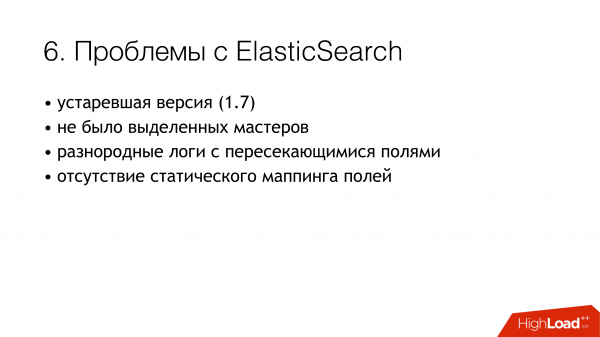
(6) A najhoršie a najšialenejšie bolo elasticsearch. Pretože to bola stará verzia. Nemali sme vtedy vyhradených majstrov. Mali sme rôznorodé protokoly, ktorých polia sa mohli prekryť. Rôzne protokoly rôznych aplikácií mohli byť písané so rovnakými názvami polí, ale vnútri mohli mať rôzne údaje. Teda, jeden protokol prichádza s Integer v poli, napríklad, level. Druhý protokol prichádza so String v poli level. Bez statického mapovania dostaneme taký úžasný problém. Ak sa po rotácii indexu v elasticsearch ako prvé dostane správa so stringom, všetko je v poriadku. Ak sa prvé dostane s Integer, všetky nasledujúce správy, ktoré prídu so String, sa jednoducho odmietajú. Pretože typ poľa sa nezhoduje.
Začali sme sa pýtať na tieto otázky. Rozhodli sme sa nehľadať vinníkov.
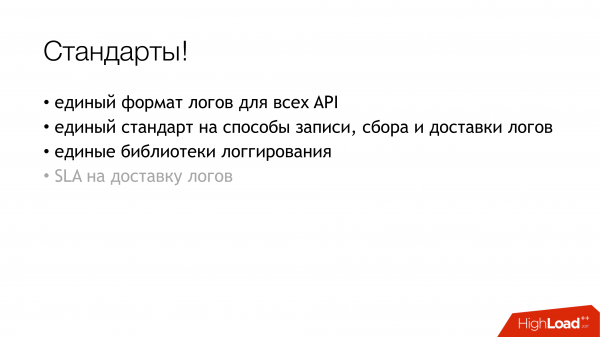
Ale niečo musíme robiť! Je to jasná vec — musíme zaviesť štandardy. Niektoré štandardy sme už mali. Niektoré sme zaviedli neskôr. Našťastie, jednotný formát logov pre všetky API bol už v tom čase schválený. Je zapísaný priamo v štandardoch interakcie služieb. Tí, ktorí chcú prijímať logy, ich musia písať v tomto formáte. Ak niekto nepíše logy v tomto formáte, znamená to, že nič negarantujeme.
Ďalej by sme chceli zaviesť jednotný štandard na spôsoby zápisu, doručenia a zbierania logov. V podstate, kam ich písať a čím ich doručovať. Ideálna situácia je, keď sa v projektoch používa rovnaká knižnica. Existuje samostatná knižnica logovania pre Go, existuje osobitná knižnica pre PHP. Všetci, ktorí u nás sú — musia ich používať. V súčasnosti by som povedal, že to máme na 80 %. Ale niektorí stále jedia kaktusy.
A tam (na snímke) len veľmi pomaly začína vystupovať „SLA na doručenie logov“. Zatiaľ to neexistuje, ale pracujeme na tom. Pretože je veľmi pohodlné, keď infraštruktúra hovorí, že ak píšete v takomto formáte na takéto miesto a nie viac ako N správ za sekundu, potom to s takou pravdepodobnosťou doručíme tam. To odbúrava množstvo bolesti hlavy. Ak SLA existuje, je to skvelé!
Ako sme začali riešiť problém? Hlavný problém bol s td-agent. Nevedeli sme, kam sa naše logy dostávajú. Doručujú sa? Zbierajú sa? Kde sú vlastne? Preto sa rozhodlo v prvom bode nahradiť td-agent. Možnosti, čím ho nahradiť, som tu stručne načrtol.
Fluentd. Po prvé, stretol som sa s ním pri predchádzajúcej práci a tam tiež občas zlyhal. Po druhé, je to to isté, len v profile.
Filebeat. Čím bol pre nás pohodlný? Tým, že je na Go, a my máme veľkú expertízu v Go. Preto ak by bolo treba, mohli sme ho prispôsobiť. Preto sme ho nezobrali. Aby sa ani nenaskytla myšlienka začať ho prepísať.
Evidentným riešením pre sysadmina zostávajú rôzne syslogy v takomto množstve (syslog-ng/rsyslog/nxlog).
Alebo napísať niečo vlastné, ale to sme odmietli, rovnako ako filebeat. Ak niečo písať, tak je lepšie písať niečo užitočné pre biznis. Na doručenie logov je lepšie zobrať niečo hotové.
Preto sa výber vlastne zúžil na výber medzi syslog-ng a rsyslog. Naklonil som sa k rsyslog len preto, že sme už mali v Puppet triedy pre rsyslog a nenašiel som medzi nimi očividný rozdiel. Čo tam syslog, to tu syslog. Áno, niekto má zlú dokumentáciu, niekto lepšiu. Ten vie to takto, a ten — inak.
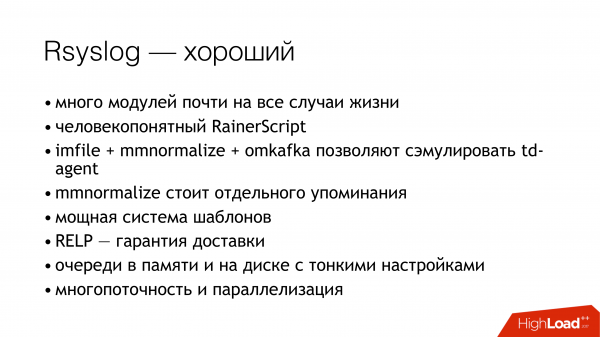
A trochu o rsyslog. Po prvé, je skvelý, pretože má veľa modulov. Má človeku zrozumiteľný RainerScript (moderný jazyk konfigurácie). Úžasný bonus je, že sme mohli jeho štandardnými prostriedkami simulovať správanie td-agent, a pre aplikácie sa nič nezmenilo. To znamená, že vymeníme td-agent za rsyslog a všetko ostatné zatiaľ nemeníme. A okamžite dostaneme fungujúce doručenie. Ďalej, mmnormalize — to je úžasná vec v rsyslog. Umožňuje analyzovať logy, ale nie pomocou Grok a regexp. Vytvára abstraktný syntaktický strom. Analyzuje logy podobne, ako kompilátor analyzuje zdrojové kódy. To umožňuje pracovať veľmi rýchlo, spotrebovať málo CPU, a vôbec, je to naozaj skvelá vec. Je tu množstvo ďalších bonusov. Na tých sa nebudem zastavovať.
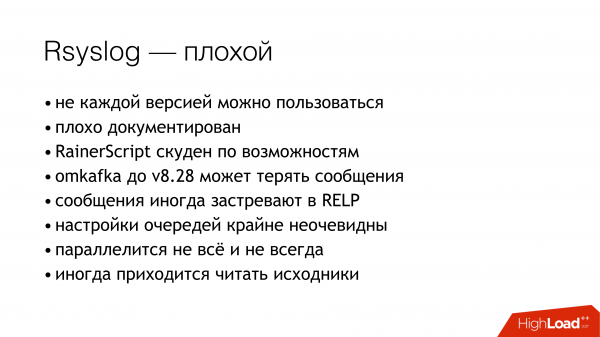
Rsyslog má ešte množstvo nedostatkov. Sú približne také isté ako bonusy. Hlavné problémy — je potrebné vedieť ho nastaviť a je potrebné vyberať verziu.
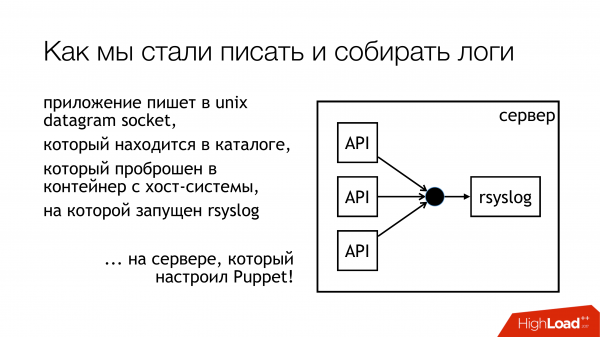
Rozhodli sme sa, že budeme zapisovať logy do unixového socketu. A to nie do /dev/log, pretože tam máme chaos zo systémových logov, tam je journald v tomto pipeline. Preto píšme do vlastného socketu. Pripneme ho k samostatnému rulesetu. Nič nebudeme miešať. Všetko bude transparentné a jasné. Tak sme vlastne urobili. Katalóg s týmito socketmi je štandardizovaný a prenáša sa do všetkých kontajnerov. Kontajnery môžu vidieť potrebný socket, otvoriť ho a zapisovať do neho.
Prečo nie súbor? Pretože všetci čítali , ktorá sa snažila preniesť súbor do dockeru, a zistilo sa, že po reštarte rsyslog sa mení deskriptor súboru, a docker stráca tento súbor. Drží otvorený niečo iné, ale už nie ten socket, do ktorého sa píše. Rozhodli sme sa, že túto problematiku obídeme a zároveň obídeme problém blokovania.
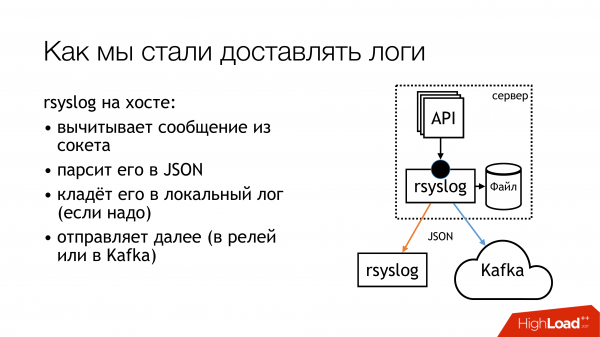
Rsyslog vykonáva akcie uvedené na snímke a odosiela logy buď do relay, alebo do Kafka. Kafka zodpovedá starému spôsobu. Relay — to som sa pokúsil použiť čisto rsyslog pre doručenie logov. Bez Message Queue, štandardnými prostriedkami rsyslog. V podstate to funguje.
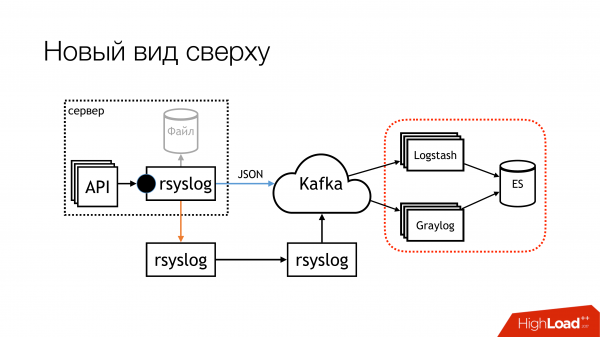
Existujú však špecifiká, pokiaľ ide o to, ako ich následne umiestniť do tejto časti (Logstash/Graylog/ES). Táto časť (rsyslog-rsyslog) sa používa medzi dátovými centrami. Je tu skomprimované tcp spojenie, ktoré šetrí šírku pásma a tým zvyšuje pravdepodobnosť, že získame nejaké logy z iného dátového centra, keď je kanál preťažený. Prečo? Pretože máme Indonéziu, kde je situácia zlá. Tam je to neustály problém.
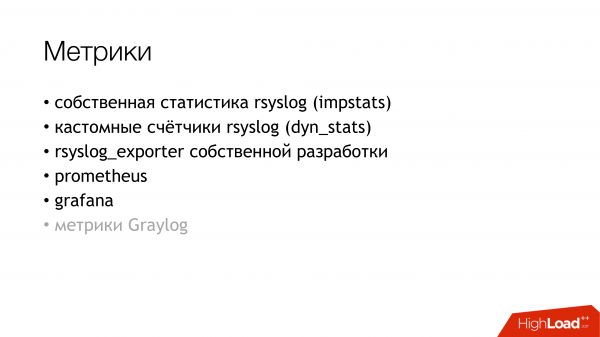
Zamysleli sme sa nad tým, ako v skutočnosti monitorovať pravdepodobnosť, že logy, ktoré zapisujeme z aplikácie, sa dostanú na druhý koniec? Rozhodli sme sa zaviesť metriky. Rsyslog má svoj modul na zber štatistík, ktorý obsahuje niečo ako počítadlá. Môže napríklad zobraziť veľkosť fronty alebo počet správ, ktoré prišli v konkrétnej akcii. Z toho už môžeme niečo získať. Navyše má aj vlastné počítadlá, ktoré môžeme nastaviť, a tie nám ukazujú napríklad počet správ, ktoré zaznamenalo nejaké API. Potom som napísal rsyslog_exporter v Pythone a všetko sme to poslali do Prometheus a vytvorili grafy. Veľmi sme túžili po metrikách Graylog, ale zatiaľ sme ich nestihli nastaviť.
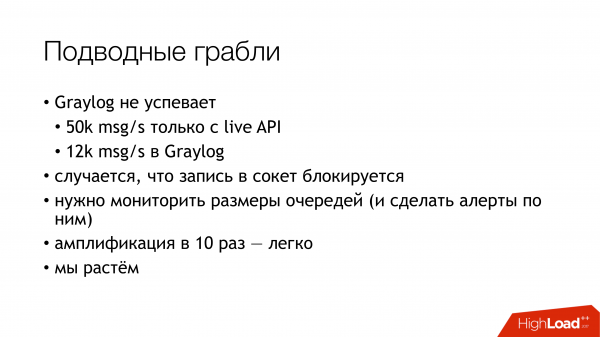
S akými problémami sme sa stretli? Problémy vznikli, keď sme zistili (úplne nečakane!), že naše Live API generuje 50 tisíc správ za sekundu. To je len Live API bez stagingu. A Graylog nám zobrazuje len 12 tisíc správ za sekundu. A objavil sa oprávnený dotaz, kde sú zvyšné správy? Z čoho sme usúdili, že Graylog jednoducho nezvláda. Pozreli sme sa a naozaj, Graylog s Elasticsearch nezvládajú tento tok.
Ďalej, iné objavy, ktoré sme urobili v procese.
Záznam do socketu je pozastavený. Ako sa to stalo? Keď som používal rsyslog na doručovanie, v určitom momente sa nám zlomil kanál medzi dátovými centrami. Doručovanie sa zastavilo na jednom mieste, zastavilo sa na druhom mieste. To všetko sa prenieslo na stroj s API, ktoré zapisovali do sockets rsyslog. Tam sa zaplnila fronta. Potom sa zaplnila fronta na zápis do unix socketu, ktorá je predvolene 128 paketov. A nasledujúci write() v aplikácii je zablokovaný. Keď sme sa pozreli do knižnice, ktorú používame v aplikáciách na Go, bolo tam napísané, že zápis do socketu prebieha v neblokujúcom režime. Boli sme presvedčení, že nič nie je zablokované. Pretože sme čítali. , ktorá o tom napísala. Ale je tu ešte jeden moment. Okolo tohto volania bol ešte nekonečný cyklus, v ktorom sa neustále snažilo zasunúť správu do soketu. To sme si nevšimli. Museli sme prepisovať knižnicu. Odvtedy sa párkrát zmenila, ale teraz sme sa zbavili blokovania vo všetkých subsystemoch. Preto môžeme zastaviť rsyslog a nič nespadne.
Musíme monitorovať veľkosť frontov, čo pomáha vyhnúť sa týmto problémom. Po prvé, môžeme monitorovať, kedy začíname strácať správy. Po druhé, môžeme sledovať, či máme všeobecne problémy s doručovaním.
A ešte nepríjemný moment — amplifikácia desaťkrát v mikroservisnej architektúre — to je naozaj veľmi jednoduché. Máme nie veľa prichádzajúcich požiadaviek, ale kvôli grafu, ktorým tieto správy následne prechádzajú, kvôli access-logom, naozaj zvyšujeme záťaž na logy približne desaťkrát. Bohužiaľ, nestihol som vypočítať presné čísla, ale mikroservisy — sú také. Musí sa to mať na pamäti. V súčasnosti je teda subsystém zbierania logov najviac zaťažený v Lazada.
Ako vyriešiť problém s elasticsearch? Ak potrebujete rýchlo získať logy na jednom mieste, aby ste nemali problém behaním po všetkých strojoch, a nesbierať ich tam, použite súborové úložisko. To zaručene funguje. Môže sa vytvoriť z akéhokoľvek servera. Stačí pridať disky a nastaviť syslog. Potom budete mať všetky logy zaručene na jednom mieste. A ďalej môžete pokojne nastavovať elasticsearch, graylog, alebo niečo iné. Ale už budete mať všetky logy, a môžete ich uchovávať, ako dlhé sú vaše diskové array.
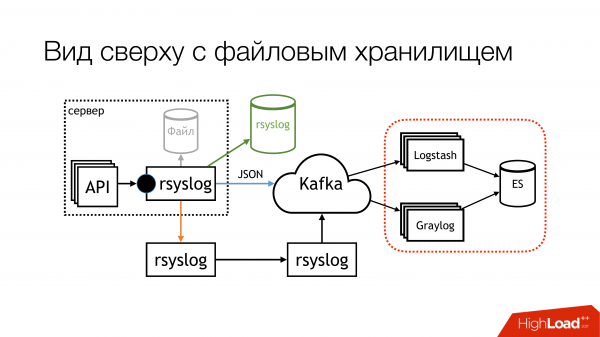
Kým som mal svoju prezentáciu, schéma vyzerala takto. Na súbor sme prakticky prestali zapisovať. Teraz pravdepodobne vypneme zostatky. Na lokálnych strojoch, na ktorých sú spustené API, prestaneme zapisovať do súborov. Po prvé, máme súborové úložisko, ktoré funguje veľmi dobre. Po druhé, na týchto strojoch sa neustále míňa miesto, a je potrebné ho neustále monitorovať.
Táto časť s Logstash a Graylog naozaj obťažuje. Preto sa jej treba zbaviť. Je potrebné vybrať niečo jedno.
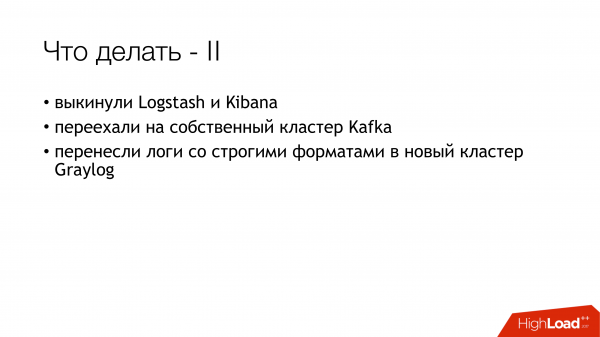
Rozhodli sme sa zbaviť Logstash a Kibana. Prečo? Pretože máme bezpečnostný oddelenie. Aký to má význam? To, že Kibana bez X-Pack a Shield neumožňuje obmedziť prístupové práva k logom. Takže sme si zvolili Graylog. Nie je to môj obľúbený, ale funguje. Kúpili sme nový hardvér, nainštalovali sme tam čerstvý Graylog a presunuli všetky logy so striktne definovanými formátmi do samostatného Graylogu. Riešili sme problém s rôznymi typmi rovnakých polí organizačne.
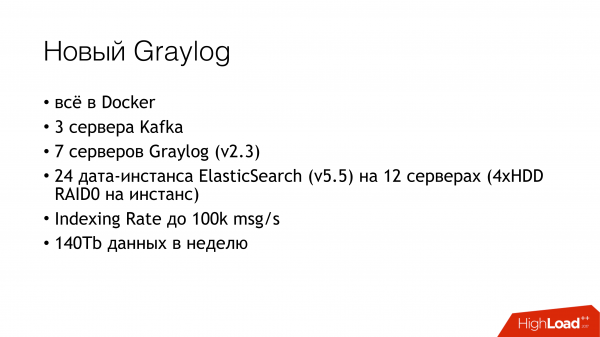
Čo presne zahŕňa nový Graylog? Jednoducho sme všetko nahrali do Dockera. Zobrali sme niekoľko serverov, rozložili tri inštancie Kafka, 7 serverov Graylog verzie 2.3 (pretože sme chceli Elasticsearch verziu 5). To všetko sme spustili na RAIDoch z HDD. Uvideli sme rýchlosť indexovania do 100 tisíc správ za sekundu. Uvideli sme číslo, že 140 terabajtov údajov za týždeň.
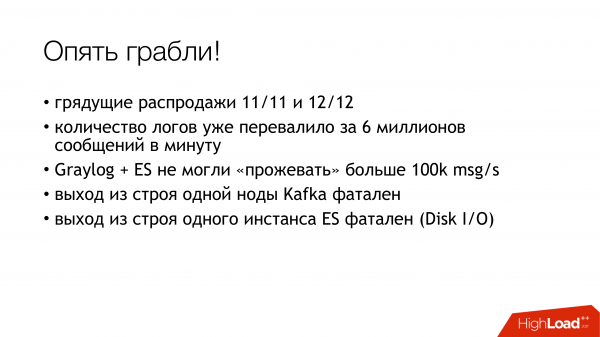
A znova problémy! Chystajú sa nám dve výpredaje. Presunuli sme sa k 6 miliónom správ. Naše Graylog nestíha spracovávať. Musíme sa znova nejako prispôsobiť.
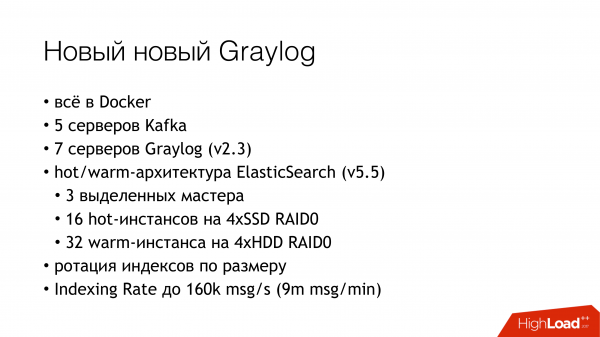
Takto sme prežili. Pridali sme ešte pár serverov a SSD. Momentálne žijeme týmto spôsobom. Teraz spracovávame už 160 tisíc správ za sekundu. Ešte sme nedosiahli limit, takže zatiaľ nie je jasné, koľko naozaj zvládneme.
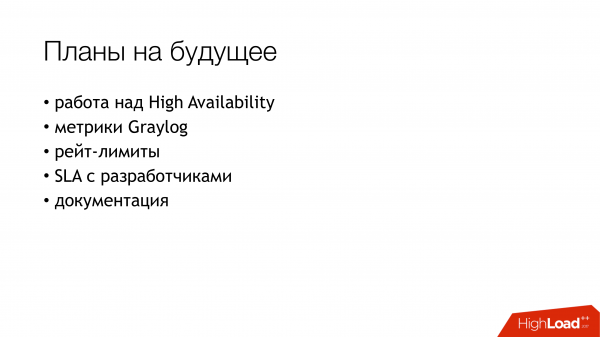
Toto sú naše plány do budúcnosti. Z nich je, pravdepodobne, najdôležitejšia vysoká dostupnosť. Ešte ju nemáme. Niekoľko strojov je nastavených rovnako, ale všetko putuje zatiaľ cez jeden server. Musíme stráviť čas nastavením failoveru medzi nimi.
Zbierať metriky z Graylogu.
Vytvoriť rate limit, aby nám jedna, šialená API, nezničila šírku pásma a všetko ostatné.
A nakoniec podpísať nejaký SLA s vývojármi, že môžeme obslúžiť totoľko. Ak píšete viac, tak prepáčte.
A napísať dokumentáciu.
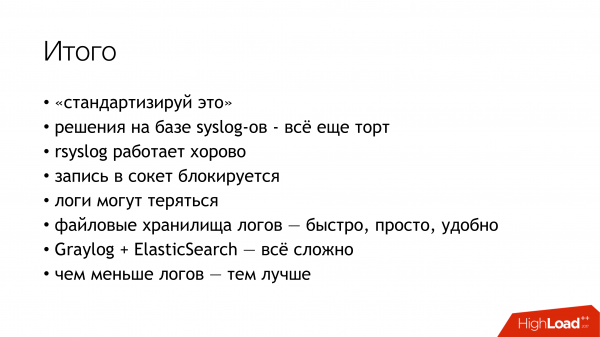
Krátko, závery všetkého, čo sme prežili. Po prvé, štandardy. Po druhé, syslog — torta. Po tretie, rsyslog funguje presne tak, ako je napísané na snímke. A poďme k otázkam.
Otázky.
Otázka: Prečo ste sa nakoniec rozhodli nezobrať… (filebeat?)
Odpoveď: Musí sa písať do súboru. Veľmi sa mi to nechcelo. Keď máš API, ktoré píše tisíce správ za sekundu, aj keď budeš rotovať raz za hodinu, nie je to stále cesta. Môžeš písať do potrubia. Na čo sa ma vývojári spýtali: «Čo sa stane, ak proces, do ktorého píšeme, padne»? Proste som nenašiel, čo im odpovedať, a povedal som: «No dobre, tak to nerobme».
Otázka: Prečo nezapisujete logy priamo do HDFS?
Odpoveď: Toto je ďalší krok. Premýšľali sme o ňom na začiatku, ale momentálne na to nemáme zdroje, takže to máme v dlhodobom riešení.
Otázka: Stĺpcový formát by bol vhodnejší.
Odpoveď: Všetko chápem. Sme za to oboma rukami.
Otázka: Zapisujete do rsyslog. Tam môže byť TCP aj UDP. Ale ak je to UDP, ako zabezpečíte dodávku?
Odpoveď: Sú tu dva aspekty. Po prvé, hneď všetkým hovorím, že nezaručujeme dodávku logov. Pretože, keď prídu vývojári a povedia: „Poďme tam začať zapisovať finančné údaje, a vy ich niekam uložíte pre prípad, že by sa niečo stalo“, odpovedáme im „Skvelé! Poďte najprv začať blokovať zápis do socketu a robiť to v transakciách, aby ste nám to tam naozaj poslali a uistili sa, že sme to prijali“ A v tom momente sa všetkým hneď prestane chcieť. A keď sa nechcú, tak aké k nám otázky? Ak nechcete zaručiť zápis do socketu, prečo by sme mali zaručiť dodávku? Robíme best effort. Naozaj sa snažíme dodať čo najviac a čo najlepšie, ale nedávame 100% záruku. Preto netreba zapisovať finančné údaje tam. Na to sú databázy s transakciami.
Otázka: Keď API generuje nejakú správu do logu a predáva riadenie mikroservisom, nenastali vám problémy s tým, že správy od rôznych mikroservisov prichádzajú v nesprávnom poradí? To spôsobuje zmätok.
Odpoveď: Je normálne, že prichádzajú v rôznom poradí. Treba na to byť pripravený. Pretože akákoľvek sieťová dodávka vám nezaručuje poradie, alebo musíte na to investovať špeciálne prostriedky. Ak vezmeme súborové úložiská, tak každé API ukladá logy do svojho súboru. Presnejšie, rsyslog ich triedi do priečinkov. Každé API má svoje logy, do ktorých sa dá ísť pozrieť, a potom ich podľa timestampu v týchto logoch môžeme porovnať. Ak sa idú pozrieť do Graylogu, tam budú zoradené podľa timestampu. Tam bude všetko v poriadku.
Otázka: Timestamp môže byť odlišný o milisekundy.
Odpoveď: Timestamp generuje samotné API. V tom je vlastne celé tajomstvo. Máme NTP. API generuje timestamp už v samotnej správe. Nie je to pridávané rsyslogom.
Otázka: Nie je veľmi jasné, ako prebieha interakcia medzi dátovými centrami. V rámci dátového centra je jasné, ako sa logy zbierajú a spracovávajú. Ako prebieha interakcia medzi dátovými centrami? Alebo každé dátové centrum žije svojím vlastným životom?
Odpoveď: Takmer. Každá krajina sa nachádza v jednom dátovom centre. Momentálne nemáme rozprestreté umiestnenie, aby jedna krajina bola umiestnená v rôznych dátových centrách. Preto ich nie je potrebné spájať. V každom centre je Log Relay. To je Rsyslog server. V skutočnosti sú to dve manažérske stroje. Sú nastavené rovnako. Ale zatiaľ priebežne prechádza prevádzka cez jeden z nich. Agreguje všetky logy. Má diskovú frontu pre každý prípad. Komprimuje logy a odosiela ich do centrálného dátového centra (v Singapure), odkiaľ už pokračujú do Graylog. A v každom dátovom centre je svoj úložný priestor. V prípade, ak stratíme spojenie, máme tam všetky logy. Tie tam zostanú. Budú tam uchované.
Otázka: Pri mimoriadnych situáciách dostávate logy odtiaľ?
Odpoveď: Môžete tam ísť (do súborového úložiska) a pozrieť sa.
Otázka: Ako monitorujete, že nestrácate logy?
Odpoveď: V skutočnosti ich strácame a monitorujeme to. Monitoring sme spustili pred mesiacom. V knižnici, ktorú používa Go API, sú metriky. Vie počítať, koľkokrát sa jej nepodarilo zapísať do socketu. Momentálne je tam šikovná heuristika. Je tam buffer. Snaží sa zapisovať z neho správy do socketu. Ak sa buffer naplní, začne ich zahadzovať. A počíta, koľko ich zahodil. Ak sa začnú napĺňať počítadlá, dozvieme sa o tom. Momentálne prichádzajú aj do Prometheus, a v Grafane môžete vidieť grafy. Je možné nastaviť upozornenia. Ale zatiaľ nie je jasné, komu ich posielať.
Otázka: V Elasticsearch skladujete logy s replikovaním. Koľko máte replik?
Odpoveď: Jedna replikácia.
Otázka: To je len jedna replikácia?
Odpoveď: To je master a replikácia. Dáta sú uchovávané v dvoch kópiách.
Otázka: Veľkosť bufferu rsyslog ste nejakým spôsobom upravovali?
Odpoveď: Píšeme datagramy do vlastného unixového socketu. To nám hneď kladie obmedzenie 128 kilobajtov. Nemôžeme do neho zapisovať viac. Toto sme zapísali do normy. Kto chce prechádzať do úložiska, ten píše 128 kilobajtov. Knižnice navyše truncujú a nastavujú flag, že správa bola orezaná. V našej norme samotnej správy je špeciálne pole, ktoré ukazuje, či bola správa orezaná pri zápise alebo nie. Takže máme možnosť sledovať aj tento moment.
Otázka: Píšete poškodený JSON?
Odpoveď: Poškodený JSON bude odmietnutý buď počas relay, pretože je balík príliš veľký. Alebo bude odmietnutý Graylogom, pretože nebude môcť JSON analyzovať. Ale sú tu nuansy, ktoré je potrebné vyriešiť a tie sú väčšinou spojené s rsyslogom. Už som tam zadal niekoľko problémov, na ktorých je potrebné ešte pracovať.
Otázka: Prečo Kafka? Skúšali ste RabbitMQ? Neprekonáva Graylog pri takýchto záťažiach?
Odpoveď: S Graylogom sa nám to nedarí. A Graylog sa nám darí. Je s ním naozaj problematické. Je to skutočne zvláštna vec. A v skutočnosti nie je potrebný. Radšej by som písal priamo z rsyslogu do Elasticsearch a potom si pozrel Kibanu. Ale musím dohodnúť otázku s bezpečnostnými ľuďmi. Toto je možná varianta nášho rozvoja, keď vyhodíme Graylog a budeme používať Kibanu. Používanie Logstash bude bezpredmetné. Pretože to všetko môžem urobiť pomocou rsyslogu. A má modul na zápis do Elasticsearch. S Graylogom sa pokúšame nejako žiť. Trochu sme ho aj vyladili. Ale stále je tam priestor na zlepšenie.
Pokiaľ ide o Kafka. Historicky to tak dopadlo. Keď som prišiel, už tu bola a už sa do nej zapisovali logy. My sme len spustili náš klaster a presunuli sme tam logy. Spravujeme ho, vieme, ako sa má. Čo sa týka RabbitMQ… nemáme s RabbitMQ dobré skúsenosti. Ale s RabbitMQ je to iné. Máme ho v produkcii a mali sme s ním problémy. Teraz, pred výpredajom, ho upravili a začal normálne fungovať. Ale predtým som nebol pripravený ho pustiť do produkcie. Je tu ešte jeden aspekt. Graylog dokáže čítať verziu AMQP 0.9, ale rsyslog dokáže písať verziu AMQP 1.0. A neexistuje žiadne riešenie, ktoré by vedelo oboje. Buď to, alebo to. Preto momentálne používame len Kafka. Ale aj tam sú nejaké nuansy. Pretože omkafka tej verzie rsyslog, ktorú používame, môže stratiť celý buffer správ, ktoré získala z rsyslog. Zatiaľ sa s tým zmierujeme.
Otázka: Používate Kafka len preto, že už bola vo vašich systémom? Na iné účely sa nepoužíva?
Odpoveď: Kafka, ktorá tam bola, sa používa tímom Data Science. To je úplne samostatný projekt, o ktorom, žiaľ, nemôžem povedať nič. Neviem o ňom. Bola v správe tímu Data Science. Keď začali zapisovať logy, rozhodli sa ju použiť, aby nemuseli inštalovať vlastnú. Teraz sme aktualizovali Graylog a stratili sme kompatibilitu, pretože tam je stará verzia Kafka. Museli sme zaviesť vlastnú. Zároveň sme sa zbavili týchto štyroch tém pre každý API. Urobili sme jednu širokú tému pre všetky live, jednu širokú tému pre všetky staging a jednoducho všetko tam posielame. Graylog to všetko paralelne spracováva.
Otázka: Prečo je potrebné robiť toto čarovanie so socketmi? Skúšali ste použiť log-dráver syslog pre kontejnery?
Odpoveď: V čase, keď sme sa touto otázkou zaoberali, sme mali s dockerom napäté vzťahy. Bol to docker 1.0 alebo 0.9. Docker bol sám o sebe zvláštny. Po druhé, ak doň ešte aj logy pcháme... Mám neoverené podozrenie, že všetky logy prechádzajú cez neho, cez docker demon. Ak jedno API blázni, tak ostatné API narážajú na to, že nemôžu poslať stdout a stderr. Neviem, kam to povedie. Mám pocit, že syslog driver dockera nie je na tomto mieste vhodný. Náš oddelenie funkčného testovania má svoj vlastný Graylog klaster s logmi. Používajú docker log drivery a vraj im to tam funguje celkom dobre. Ale GELF okamžite píšu do Graylogu. V tom čase, keď sme to všetko plánovali, sme potrebovali, aby to jednoducho fungovalo. Možno neskôr, keď niekto príde a povie, že to už dlhú dobu funguje normálne, to skúsime.
Otázka: Dodávku medzi dátovými centrami realizujete cez rsyslog. Prečo nie cez Kafka?
Odpoveď: V skutočnosti robíme oboje. Z dvoch dôvodov. Ak je kanál úplne zlomený, tak nám ani skomprimované logy neprejdú. A Kafka umožňuje ich jednoducho stratiť počas procesu. Týmto spôsobom sa zbavujeme zadržiavania týchto logov. Tento spôsob priamo používame na Kafku. Ak máme dobrý kanál a chceme ho uvoľniť, používame rsyslog. Ale v skutočnosti sa dá nastaviť tak, aby sám odmietal to, čo neprešlo. Momentálne niekde používame dodávku rsyslog priamo, niekde Kafka.
Zdroj: habr.com
