

Ahoj, priatelia. Pred odchodom na druhú časť májových sviatkov zdieľame s vami materiál, ktorý sme preložili v predvečer spustenia nového kurzu. .
Vývojári aplikácií trávia veľa času porovnávaním viacerých operačných databáz, aby si vybrali tú, ktorá najlepšie vyhovuje plánovanej pracovnej záťaži. Potreby môžu zahŕňať zjednodušené modelovanie dát, transakčné záruky, výkon pri čítaní/zapisovaní, horizontálne škálovanie a odolnosť voči chybám. Tradicionalne sa výber začína kategóriou databázy, SQL alebo NoSQL, keďže každá kategória ponúka jasnú sadu kompromise. Vysoký výkon z hľadiska nízkej latencie a vysokej priepustnosti sa zvyčajne považuje za požiadavku bez kompromisov a preto je nevyhnutný pre akúkoľvek databázu v výbere.
Cieľom tohto článku je pomôcť vývojárom aplikácií správne si vybrať medzi SQL a NoSQL v kontexte modelovania dát aplikácie. Preskúmame jednu databázu SQL, a to PostgreSQL, a dve databázy NoSQL – Cassandra a MongoDB, aby sme sa porozprávali o základoch návrhu databáz, ako je vytváranie tabuliek, ich naplnenie, čítanie dát z tabuliek a ich odstraňovanie. V nasledujúcom článku sa určite pozrieme na indexy, transakcie, príkazy JOIN, direktívy TTL a návrh databáz založených na JSON.
Aký je rozdiel medzi SQL a NoSQL?
SQL databázy zvyšujú flexibilitu aplikácie vďaka transakčným zárukám ACID a tiež vďaka svojej schopnosti požadovať dáta pomocou JOIN nečakanými spôsobmi nad existujúcimi normalizovanými modelmi relačných databáz.
Vzhľadom na ich monolitnú/jednouzlovú architektúru a použitie modelu replikácie master-slave kvôli redundancii, tradičné SQL databázy nemajú dve dôležité vlastnosti – lineárnu škálovateľnosť zápisu (t.j. automatické rozdelenie na niekoľko uzlov) a automatickú/nulovú stratu dát. To znamená, že objem prijímaných údajov nemôže prekročiť maximálnu priepustnosť zápisu jedného uzla. Okrem toho sa musí zohľadniť určitá časová strata dát pri odolnosti voči poruchám (v architektúre bez rozdelenia zdrojov). Je potrebné mať na pamäti, že nedávne transakcie sa ešte neodrazili v podradnej (slave) kópii. Aktualizácie bez prestojov sú tiež ťažko dosiahnuteľné v SQL databázach.
NoSQL databázy sú vo svojej podstate zvyčajne distribuované, t.j. údaje sú rozdelené na sekcie a distribuované na niekoľko uzlov. Vyžadujú denormalizáciu. To znamená, že zadané údaje musia byť tiež niekoľkokrát skopírované, aby mohli odpovedať na konkrétne dotazy, ktoré posielate. Hlavným cieľom je dosiahnuť vysoký výkon znížením počtu shardov dostupných počas čítania. Z toho vyplýva, že NoSQL si vyžaduje, aby ste modelovali svoje dotazy, zatiaľ čo SQL si vyžaduje modelovanie vašich údajov.
NoSQL sa sústreďuje na dosiahnutie vysokej výkonnosti v distribuovanom klastri a to je základným odôvodnením mnohých kompromisov v návrhu databáz, ktoré zahŕňajú stratu transakčných záruk ACID, JOIN-y a konzistentné globálne sekundárne indexy.
Existuje názor, že hoci NoSQL databázy poskytujú lineárnu škálovateľnosť zápisu a vysokú odolnosť voči poruchám, strata transakčných záruk ich robí nevhodnými pre kritické údaje.
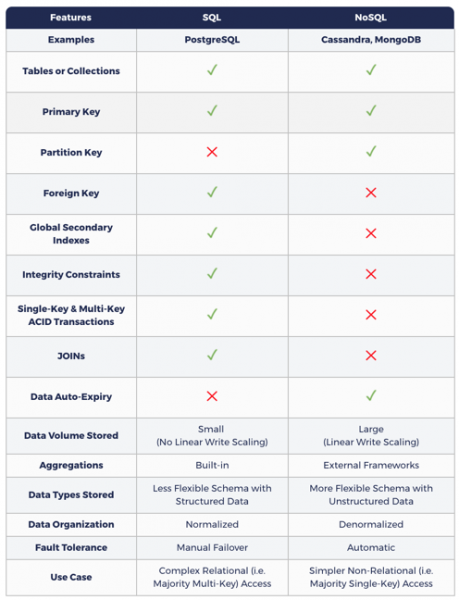
Nasledujúca tabuľka ukazuje, ako sa modelovanie údajov v NoSQL líši od SQL.
SQL a NoSQL: Prečo potrebujeme oboje?
Na skutočných aplikáciách s veľkým množstvom používateľov, ako sú Amazon.com, Netflix, Uber a Airbnb, spočíva plnenie zložitých rozmanitých úloh. Napríklad aplikácii pre elektronický obchod, ako je Amazon.com, je potrebné uchovávať ľahké, vysoko kritické údaje, ako sú informácie o používateľoch, produktoch, objednávkach, faktúrach, spolu s ťažšími, ale menej citlivými údajmi, ako sú recenzie produktov, správy služby podpory, aktivita používateľov, spätná väzba a odporúčania používateľov. Samozrejme, tieto aplikácie sa spoliehajú aspoň na jednu SQL databázu spolu s aspoň jednou NoSQL databázou. V medzioblastných a globálnych systémoch funguje NoSQL databáza ako geograficky rozložená cache pre údaje, ktoré sú uchovávané v dôveryhodnom zdroji, SQL databáze, ktorá funguje v nejakej oblasti.
Ako YugaByte DB spája SQL a NoSQL?
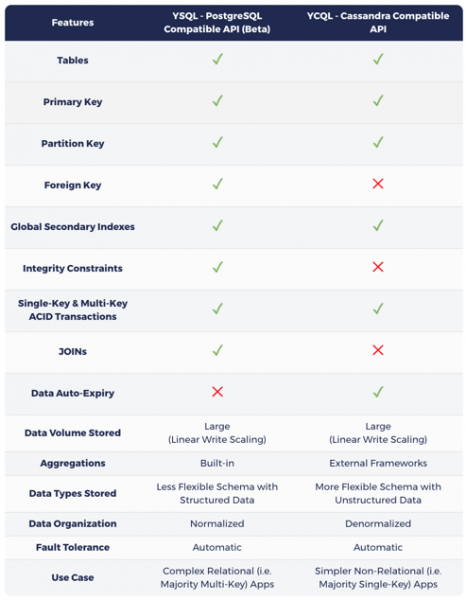
Postavená na logicky orientovanom zmiešanom mechanizme ukladania, automatickom shardovaní, shardovanej distribuovanej konsenzusovej replikácii a distribuovaných ACID transakciách (inšpirovaných Google Spanner), YugaByte DB je prvou na svete databázou s otvoreným zdrojom, ktorá je súčasne kompatibilná s NoSQL (Cassandra & Redis) a SQL (PostgreSQL). Ako je uvedené v tabuľke nižšie, YCQL, API YugaByte DB kompatibilné s Cassandrou, pridáva pojmy jedinečných a viacerých kľúčových ACID transakcií a globálnych sekundárnych indexov do API NoSQL, čím otvára éru transakčných NoSQL databáz. Okrem toho YCQL, API YugaByte DB kompatibilné s PostgreSQL, pridáva pojmy lineárneho škálovania zápisu a automatickej odolnosti voči výpadkom do SQL API, predstavujúc svetu distribuované SQL databázy. Keďže databáza YugaByte DB je vo svojej podstate transakčná, API NoSQL sa teraz môže používať v kontexte kritických údajov.
Ako už bolo spomenuté v článku , výber medzi SQL alebo NoSQL v YugaByte DB plne závisí od charakteristík základnej pracovnej záťaže:
- Ak je základná pracovná záťaž zložená z viacerých kľúčových operácií s JOIN, pri výbere YSQL si uvedomte, že vaše kľúče môžu byť rozložené na viacerých uzloch, čo povedie k vyššej latencii a/alebo zníženej priepustnosti v porovnaní s NoSQL.
- V opačnom prípade si vyberte jedno z dvoch NoSQL API, pamätajte, že dosiahnete vyšší výkon z požiadaviek obsluhovaných z jedného uzla naraz. YugaByte DB môže fungovať ako jediná operačná databáza pre reálne zložité aplikácie, kde je potrebné spravovať viacero pracovných záťaží súčasne.
Základom laboratória modelovania dát je v nasledujúcej časti kompatibilná s PostgreSQL a Cassandra API databáza YugaByte DB na rozdiel od pôvodných databáz. Tento prístup zdôrazňuje jednoduchosť interakcie s dvomi rôznymi API (na dvoch rôznych portoch) tej istej databázovej klastra, na rozdiel od používania plne nezávislých klastrov dvoch rôznych databáz.
V nasledujúcich sekciách sa oboznámime s laboratóriom modelovania dát, aby sme ilustrovali rozdiel a niektoré spoločné rysy zvažovaných databáz.
Laboratórium modelovania dát
Inštalácia databáz
S ohľadom na dôraz na navrhovanie modelu dát (a nie na zložité architektúry nasadenia) nainštalujeme databázy do Docker kontajnerov na lokálnom počítači a potom sa budeme s nimi interagovať pomocou príslušných príkazových riadkov.
Kompatibilná s PostgreSQL & Cassandra databáza YugaByte DB
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
Kľúč-hodnota, grafový*
docker run --name my-mongo -d mongo:latestPrístup cez príkazový riadok
Poďme sa pripojiť k databázam pomocou príkazového riadku pre príslušné API.
PostgreSQL
— je to príkazový riadok na interakciu s PostgreSQL. Pre jednoduchosti používania YugaByte DB je dodávané s psql priamo v priečinku bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— je to príkazový riadok na interakciu s Casserou a jej kompatibilnými databázami cez CQL (jazyk dotazov Cassandra). Pre pohodlné používanie YugaByte DB je dodávané s cqlsh v adresári bin.
Všimnite si, že CQL bol inšpirovaný SQL a má podobné pojmy tabuliek, riadkov, stĺpcov a indexov. Avšak ako jazyk NoSQL, pridáva určitú sadu obmedzení, z ktorých väčšinu si tiež prejdeme v iných článkoch.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshKľúč-hodnota, grafový*
– je príkazový riadok na interakciu s MongoDB. Nájdete ho v adresári bin inštalácie MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Vytvorenie tabuľky
Teraz môžeme interagovať s databázou na vykonávanie rôznych operácií pomocou príkazového riadku. Začnime vytvorením tabuľky, ktorá uchováva informácie o piesňach napísaných rôznymi interpretmi. Tieto piesne môžu byť súčasťou albumu. Možné voliteľné atribúty pre pieseň sú rok vydania, cena, žáner a hodnotenie. Musíme zvážiť ďalšie atribúty, ktoré by mohli byť potrebné v budúcnosti, prostredníctvom poľa „tagy“. Môže uchovávať polostruktúrované údaje vo forme párov kľúč-hodnota.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Vytvorenie tabuľky v Cassandre je veľmi podobné PostgreSQL. Jedným z hlavných rozdielov je absencia obmedzení integrity (napr. NOT NULL), ale to patrí do zodpovednosti aplikácie, a nie NoSQL databázy.. Primárny kľúč pozostáva z kľúča oddielu (stĺpec Artist v nasledujúcom príklade) a súboru stĺpcov klastra (stĺpec SongTitle v uvedenom príklade). Kľúč oddielu určuje, do ktorého oddielu/štiepu umiestniť riadok, zatiaľ čo stĺpce klastra určujú, ako by mali byť údaje organizované vo vnútri aktuálneho štiepu.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Kľúč-hodnota, grafový*
MongoDB organizuje údaje do databáz (Database) (analogicky k Keyspace v Cassandre), kde sú kolekcie (Collections) (analogicky k tabuľkám), v ktorých sa nachádzajú dokumenty (Documents) (analogicky k riadkom v tabuľke). V MongoDB v podstate nie je potrebné definovať počiatočnú schému. Príkaz „use database“, uvedený nižšie, vytvára inštanciu databázy pri prvom volaní a mení kontext pre práve vytvorenú databázu. Dokonca ani kolekcie nie je potrebné vytvárať explicitne, vytvárajú sa automaticky, jednoducho pridaním prvého dokumentu do novej kolekcie. Všimnite si, že MongoDB predvolene používa testovaciu databázu, takže akákoľvek operácia na úrovni kolekcie bez uvedenia konkrétnej databázy sa vo vykonávaní automaticky uskutoční v tejto databáze.
use myNewDatabase;Získanie informácií o tabuľke
PostgreSQL
d Music
Table "public.music"
    Column    |         Type          | Collation | Nullable | Default
--------------+-----------------------+-----------+----------+--------
 artist       | character varying(20) |           | not null |
 songtitle    | character varying(30) |           | not null |
 albumtitle   | character varying(25) |           |          |
 year         | integer               |           |          |
 price        | double precision      |           |          |
 genre        | character varying(10) |           |          |
 criticrating | double precision      |           |          |
 tags         | text                  |           |          |
Indexes:
    "music_pkey" PRIMARY KEY, btree (artist, songtitle)
Cassandra
DESCRIBE TABLE MUSIC;
CREATE TABLE myapp.music (
    artist text,
    songtitle text,
    albumtitle text,
    year int,
    price float,
    genre text,
    tags text,
    PRIMARY KEY (artist, songtitle)
) WITH CLUSTERING ORDER BY (songtitle ASC)
    AND default_time_to_live = 0
    AND transactions = {'enabled': 'false'};
Kľúč-hodnota, grafový*
use myNewDatabase;
show collections;
Vkladanie údajov do tabuľky
PostgreSQL
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Year, Price, Genre, CriticRating,
    Tags)
VALUES(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Composers": ["Smith", "Jones", "Davis"],"LengthInSeconds": 214}'
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre, CriticRating)
VALUES(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre)
VALUES(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INSERT INTO Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre,
    Tags)
VALUES(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
Vo všeobecnosti je výraz INSERT v Cassandre vyzerá veľmi podobne ako jeho ekvivalent v PostgreSQL. Avšak existuje jeden veľký rozdiel v semantike. V Cassandre INSERT je v skutočnosti operácia UPSERT, kde sú posledné hodnoty pridané do riadku, ak riadok už existuje.
Vkladanie údajov prebieha podobne ako v PostgreSQL
INSERTvyššie
.
Kľúč-hodnota, grafový*
Napriek tomu, že MongoDB je NoSQL databáza, podobne ako Cassandra, jej operácia vkladania údajov nemá nič spoločné so semantickým správaním v Cassandre. V MongoDB nemá možnosti UPSERT, čo ho robí podobným PostgreSQL. Pridanie údajov bez zásady _idspecified vedie k prídaniu nového dokumentu do kolekcie.
db.music.insert( {
 artist: "Nikto, koho poznáš",
 songTitle: "Zavolaj ma dnes",
 albumTitle: "Trafne trochu slávne",
 year: 2015,
 price: 2.14,
 genre: "Country",
 tags: {
 Composers: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "Nikto, koho poznáš",
 songTitle: "Môj pes Spot",
 albumTitle: "Hej teraz",
 price: 1.98,
 genre: "Country",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "Skupina Acme",
 songTitle: "Dávaj pozor, svet",
 albumTitle:"Centrum rozpočtu",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "Skupina Acme",
 songTitle: "Ešte stále v láske",
 albumTitle:"Centrum rozpočtu",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Intenzívne"
 }
 }
 );
Dotaz na tabuľku
Možno najvýznamnejší rozdiel medzi SQL a NoSQL z hľadiska zostavovania dotazov spočíva v použití formulácií FROM a WHERE. SQL umožňuje po výraze FROM vybrať niekoľko tabuliek, a výraz s WHERE môže byť akékoľvek zložitosti (vrátane operácií JOIN medzi tabuľkami). Avšak NoSQL má tendenciu uvalovať prísne obmedzenie na FROM, a pracovať iba s jednou špecifikovanou tabuľkou, a v WHERE, vždy by mal byť uvedený primárny kľúč. Toto vyplýva z túžby po zlepšení výkonu NoSQL, o ktorej sme hovorili skôr. Táto túžba vedie k zníženiu akýchkoľvek krížových tabuľkových a krížových kľúčových interakcií. Môže to spôsobiť veľké oneskorenie v medziuzlových spojeniach pri odpovedi na požiadavky, a preto je najlepšie tomu v zásade predchádzať. Napríklad Cassandra vyžaduje, aby boli požiadavky obmedzené na určité operátory (povolené sú len =, IN, , =>, <=) na kľúčoch rozdelení, okrem prípadov požiadavky sekundárneho indexu (tu je povolený len operátor =).
PostgreSQL
Nižšie nájdete tri príklady požiadaviek, ktoré môžu byť bez problémov vykonané v databáze SQL.
- Zobrazte všetky piesne umelca;
- Zobrazte všetky piesne umelca, ktoré sa zhodujú s prvou časťou názvu;
- Zobrazte všetky piesne umelca, ktoré majú určité slovo v názve a cena je menej ako 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Z uvedených požiadaviek PostgreSQL len prvý bude fungovať v Cassandre bez zmien, pretože operátor LIKE sa nemôže použiť na stĺpce klasifikácie, ako sú SongTitle. V tomto prípade sú povolené len operátory = a IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
Kľúč-hodnota, grafový*
Ako je ukázané v predchádzajúcich príkladoch, hlavným spôsobom vytvárania požiadaviek v MongoDB je . Tento príkaz obsahuje názov kolekcie (music v príklade nižšie), a preto sú požiadavky na niekoľko kolekcií zakázané.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Čítanie všetkých riadkov tabuľky
Čítanie všetkých riadkov je jednoducho špeciálnym prípadom vzoru požiadavky, ktorú sme prebrali skôr.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Podobne ako v prípade PostgreSQL vyššie.
Kľúč-hodnota, grafový*
db.music.find( {} );Úprava údajov v tabuľke
PostgreSQL
PostgreSQL poskytuje príkaz UPDATE na zmenu údajov. Nemá však možnosti UPSERT, takže vykonanie tohto príkazu skončí chybou, ak riadky už nie sú v databáze.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
V Cassandre existuje UPDATE podobný príkaz PostgreSQL. UPDATE má rovnakú sémantiku UPSERT, podobne ako INSERT.
Podobne ako v prípade PostgreSQL vyššie.
Kľúč-hodnota, grafový*
Operácia V MongoDB je možné úplne aktualizovať existujúci dokument alebo aktualizovať iba určité polia. Predvolene aktualizuje iba jeden dokument bez kvázi-semantiky. UPSERT. Aktualizácia viacerých dokumentov prebieha podobne. UPSERT Môže sa uplatniť nastavením dodatočných príznakov pre operáciu. Napríklad v nižšie uvedenom príklade sa aktualizuje žáner konkrétneho interpreta na základe jeho piesne.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Odstránenie údajov z tabuľky
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Podobne ako v prípade PostgreSQL vyššie.
Kľúč-hodnota, grafový*
V MongoDB sú dva typy operácií na odstraňovanie dokumentov — a . Oba typy odstraňujú dokumenty, ale vracajú odlišné výsledky.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Odstránenie tabuľky
PostgreSQL
DROP TABLE Music;Cassandra
Podobne ako v prípade PostgreSQL vyššie.
Kľúč-hodnota, grafový*
db.music.drop();Záver
Debaty o voľbe medzi SQL a NoSQL pretrvávajú už viac ako 10 rokov. Existujú dva hlavné aspekty tohto sporu: architektúra základne databázy (monolitný, transakčný SQL proti distribuovanému, netransakčnému NoSQL) a prístup k návrhu databázy (modelovanie údajov v SQL oproti modelovaniu vašich dotazov v NoSQL).
S distribuovanou transakčnou databázou, ako je YugaByte DB, sa debaty o architektúre databázy môžu ľahko rozplynúť. Ako sa objemy údajov stávajú väčšími, než čo môže byť zaznamenané v jednom uzle, úplne distribuovaná architektúra, ktorá podporuje lineárnu škálovateľnosť zápisu s automatickým shardovaním/prevážením, sa stáva nevyhnutnou.
Okrem toho, ako je uvedené v jednom z článkov , transakčné, striktne konzistentné architektúry sú teraz široko používané na zabezpečenie lepšej flexibility v návrhu, ako netransakčné, v konečnom dôsledku konzistentné architektúry.
Pri návrate k diskusii o návrhu databáz je spravodlivé povedať, že obidva prístupy k návrhu (SQL a NoSQL) sú nevyhnutné pre akúkoľvek zložitú reálnu aplikáciu. Prístup SQL „modelovanie dát“ umožňuje vývojárom ľahšie uspokojovať sa meniacim sa obchodným požiadavkám, zatiaľ čo prístup NoSQL „modelovanie dopytov“ umožňuje týmto istým vývojárom manipulovať s veľkým objemom dát pri nízkej latencii a vysokej priepustnosti. Práve z tohto dôvodu YugaByte DB poskytuje SQL a NoSQL API v spoločnom jadre, miesto toho, aby propagovala niektorý z prístupov. Okrem toho, zaisťujúc kompatibilitu s populárnymi databázovými jazykmi vrátane PostgreSQL a Cassandra, YugaByte DB zaručuje, že vývojári nemusia študovať iný jazyk, aby mohli pracovať s distribuovaným prísne konzistentným jadrom databázy.
V tomto článku sme preskúmali, ako sa základy návrhu databáz líšia v PostgreSQL, Cassandra a MongoDB. V nasledujúcich článkoch sa ponoríme do pokročilých konceptov návrhu, ako sú indexy, transakcie, JOIN-y, direktívy TTL a JSON-dokumenty.
Prajem vám, aby ste si posledné víkendy užili naplno a pozývam vás na , ktorý sa uskutoční už 14. mája.
Zdroj: habr.com
