

Trh distribuovaných výpočtov a veľkých dát sa, ak sa má veriť , zvyšuje o 18-19% ročne. Znamená to, že otázka výberu softvéru na tento účel zostáva aktuálna. V tomto príspevku začneme tým, prečo sú distribuované výpočty potrebné, podrobnejšie sa zameriame na výber softvéru, porozprávame sa o použití Hadoopu pomocou Cloudera a nakoniec budeme hovoriť o výbere hardvéru a o tom, ako rôznymi spôsobmi ovplyvňuje výkon.
Prečo sú distribuované výpočty potrebné v bežnom podnikaní? Tu je to jednoduché a zároveň zložité. Jednoduché — pretože vo väčšine prípadov vykonávame relatívne jednoduché výpočty na jednotku informácií. Zložité — pretože takýchto informácií je veľa. Veľmi veľa. Ako dôsledok musíme . Tým pádom sú scenáre použitia veľmi univerzálne: výpočty môžu byť aplikované všade, kde je potrebné zvážiť veľké množstvo metrík na ešte väčšom súbore dát.
Jeden z nedávnych príkladov: sieť pizzerií Dodo Pizza na základe analýzy databázy zákazníckych objednávok, že pri výbere pizze s náhodnou náplňou používatelia zvyčajne pracujú len s šiestimi základnými sadami ingrediencií plus pár náhodných. V súlade s tým pizzeria prispôsobila nákupy. Okrem toho sa im podarilo lepšie odporúčať používateľom ďalšie produkty, ktoré sú ponúkané v procese objednávania, čo umožnilo zvýšiť zisk.
Ešte jeden príklad: rozsah produktov umožnil obchodu H&M znížiť sortiment v niektorých obchodoch o 40%, pričom si zachoval úroveň predaja. Toho sa podarilo dosiahnuť vylúčením zle predávaných položiek, pričom sa zohľadnila sezónnosť.
Výber nástroja
Odvetvovým štandardom takýchto výpočtov je Hadoop. Prečo? Pretože Hadoop je skvelý, dobre zdokumentovaný rámec (rovnako ako Habr poskytuje množstvo podrobných článkov na túto tému), ktorý je sprevádzaný celým súborom utilít a knižníc. Môžete dodávať obrovské množstvá ako štruktúrovaných, tak aj neštruktúrovaných dát, a systém ich sám rozdelí medzi výpočtové kapacity. A tieto kapacity môžete kedykoľvek zvýšiť alebo vypnúť — táto horizontálna škálovateľnosť je v praxi.
V roku 2017 vplyvná konzultačná spoločnosť Gartner , že Hadoop čoskoro vyjde z módy. Dôvod je celkom prostý: analytici sa domnievajú, že firmy sa masovo presunú do cloudu, pretože tam budú môcť platiť za skutočné využitie výpočtových zdrojov. Druhým dôležitým faktorom, ktorý údajne môže "pohřbiť" Hadoop, je rýchlosť výkonu. Pretože možnosti ako Apache Spark alebo Google Cloud DataFlow fungujú rýchlejšie ako MapReduce, na ktorom Hadoop stojí.
Hadoop spočíva na niekoľkých pilieroch, pričom najvýraznejšie sú technológie MapReduce (systém rozdeľovania údajov na výpočty medzi servermi) a súborový systém HDFS. Posledný je špeciálne navrhnutý na ukladanie údajov rozdelených medzi uzlovou klastre: každý blok pevnej veľkosti môže byť umiestnený na viacerých uzloch a vďaka replikácii sa zabezpečuje odolnosť systému voči poruchám jednotlivých uzlov. Namiesto tabuľky súborov sa používa špeciálny server nazývaný NameNode.
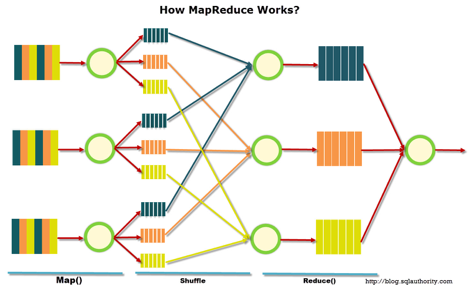
Na ilustrovaní nižšie je zobrazená schéma fungovania MapReduce. V prvom kroku sa údaje rozdeľujú podľa určitého kritéria, v druhom sa rozdeľujú medzi výpočtové zdroje a v treťom prebieha výpočet.
Pôvodne MapReduce vytvoril Google pre potreby svojho vyhľadávania. Následne sa MapReduce dostala do voľného kódu a projekt prevzala Apache. No Google sa postupne presunul na iné riešenia. Zaujímavá poznámka: v súčasnosti má Google projekt nazvaný Google Cloud Dataflow, ktorý je prezentovaný ako ďalší krok po Hadoop, akási rýchla náhrada.
Pri bližšom skúmaní je jasné, že Google Cloud Dataflow je založený na variante Apache Beam, pričom Apache Beam obsahuje dobre zdokumentovaný framework Apache Spark, čo nám umožňuje hovoriť o prakticky rovnakej rýchlosti vykonávania riešení. A Apache Spark skvelo funguje na súborovom systéme HDFS, čo umožňuje jeho nasadenie na serveroch Hadoop.
Pridáme sem objem dokumentácie a hotových riešení pre Hadoop a Spark oproti Google Cloud Dataflow a výber nástroja sa stáva zrejmým. Viac než to, inžinieri si môžu sami zvoliť, aký kód - pre Hadoop alebo Spark - budú vykonávať, pričom sa riadia úlohou, skúsenosťami a kvalifikáciou.
Cloud alebo lokálny server
Návrh celkového prechodu do cloudu vytvoril zaujímavý termín ako Hadoop-as-a-service. V takomto scenári je dôležité spravovanie pripojených serverov. Pretože, žiaľ, napriek svojej popularite, čistý Hadoop je pomerne zložitým nástrojom na nastavenie, pretože veľa sa musí robiť ručne. Napríklad je potrebné samostatne konfigurovať servery, sledovať ich výkon a starostlivo nastaviť množstvo parametrov. V podstate je to práca pre nadšencov a je tu veľké riziko, že sa niečo pokazí alebo prehliadne.
Preto získali veľkú popularitu rôzne distribúcie, ktoré sú od začiatku vybavené pohodlnými prostriedkami na nasadzovanie a spravovanie. Jedna z najpopulárnejších distribúcií, ktorá podporuje Spark a všetko uľahčuje, je Cloudera. Má platené aj bezplatné verzie – a v tej poslednej je dostupná všetka základná funkcionalita, pričom nie je obmedzený počet nód.
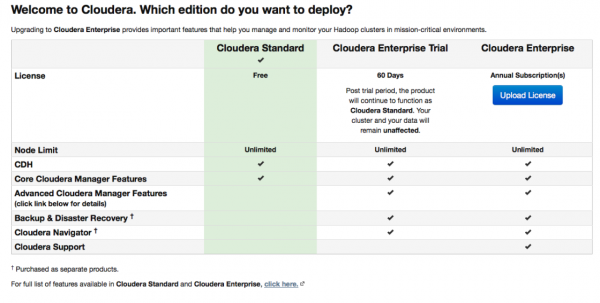
Počas nastavenia sa Cloudera Manager pripojí k vašim serverom cez SSH. Zaujímavý moment: pri inštalácii je lepšie uviesť, aby prebiehala takzvanými parcelami: špeciálnymi balíkmi, v ktorých sa nachádzajú všetky potrebné komponenty pripravené na spoluprácu. V podstate ide o vylepšenú verziu správcu balíkov.
Po inštalácii dostaneme konzolu na správu klastra, na ktorej môžete vidieť telemetriu klastra, nainštalované služby a navyše môžete pridávať/odstraňovať zdroje a upravovať konfiguráciu klastra.
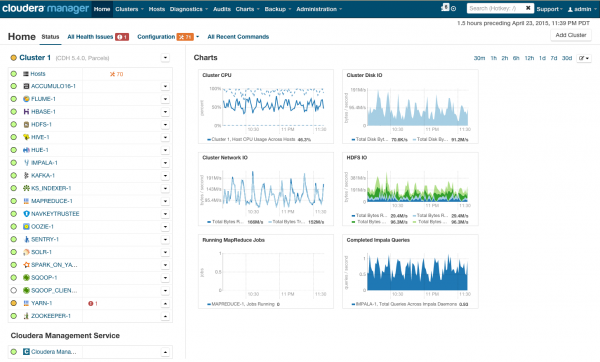
Ako výsledok pred vami stojí rozstrih tej rakety, ktorá vás vezme do jasnej budúcnosti BigData. Ale predtým ako poviete „ideme“, poďme sa pozrieť pod kapotu.
Požiadavky na hardvér
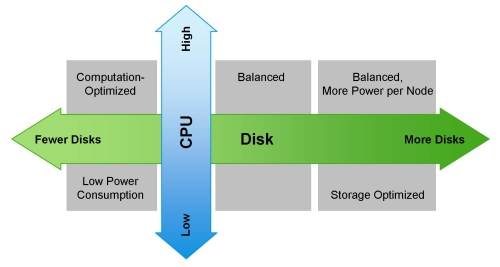
Na svojom webe Cloudera spomína rôzne možné konfigurácie. Všeobecné princípy, podľa ktorých sú postavené, sú zobrazené na ilustrácii:
Optimizmus tejto situácie môže naraziť na MapReduce. Ak sa znova pozrieme na schému z predchádzajúcej časti, je jasné, že takmer vo všetkých prípadoch sa úloha MapReduce môže stretnúť s „úzkym hrdlom“ pri čítaní údajov z disku alebo zo siete. To je tiež spomenuté na blogu Cloudera. Preto je pre akékoľvek rýchle výpočty, vrátane tých prostredníctvom Sparku, ktorý sa často používa na výpočty v reálnom čase, veľmi dôležitá rýchlosť vstupu/výstupu. Preto pri používaní Hadoopu je veľmi dôležité, aby do klastru prišli vyvážené a rýchle stroje, čo, jemne povedané, nie je vždy zabezpečené v cloudovej infraštruktúre.
Vyváženosť v rozdelení záťaže je dosiahnutá použitím virtualizácie Openstack na serveroch s výkonnými viacjadrovými CPU. Dátovým uzlom sú pridelené vlastné procesorové zdroje a určité disky. V našom riešení Atos Codex Data Lake Engine dosahujeme širokú virtualizáciu, čo nám prináša výhody ako z pohľadu výkonu (minimalizuje sa vplyv sieťovej infraštruktúry), tak aj z pohľadu TCO (vylučujú sa zbytočné fyzické servery).
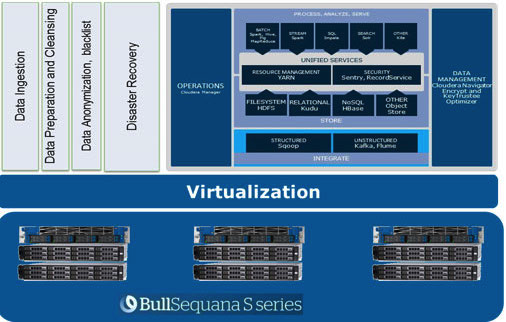
Pri použití serverov BullSequana S200 získavame veľmi rovnomerne rozloženú záťaž, zbavenú častí úzkych miest. Minimálna konfigurácia obsahuje 3 servery BullSequana S200, každý s dvoma JBOD, plus voliteľne sa pripájajú ďalšie S200, obsahujúce po štyri dátové uzly. Tu je príklad záťaže v teste TeraGen:
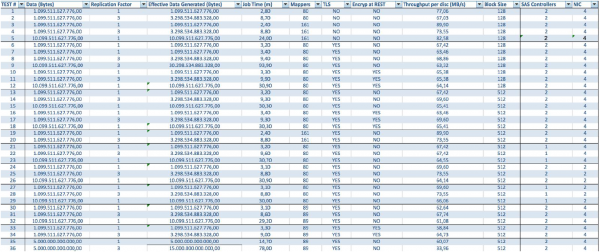
Testy s rôznymi objemami údajov a hodnotami replikácie ukazujú rovnaké výsledky z hľadiska rozdelenia záťaže medzi uzly klastru. Nižšie je uvedený graf rozdelenia prístupu na disk na základe testov výkonu.
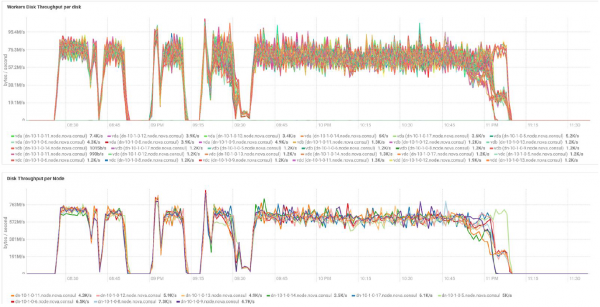
Výpočty boli vykonané na základe minimálnej konfigurácie z 3 serverov BullSequana S200. Táto konfigurácia obsahuje 9 dátových uzlov a 3 hlavné uzly, ako aj rezervované virtuálne stroje v prípade nasadenia ochrany na báze OpenStack Virtualization. Výsledok testu TeraSort: veľkosť bloku 512 MB s koeficientom replikácie tri a šifrovaním trvá 23,1 minúty.
Ako je možné rozšíriť systém? Pre Data Lake Engine sú k dispozícii rôzne druhy rozšírení:
- Úzly prenosu údajov: pre každých 40 TB užitočného priestoru
- Analytické uzly s možnosťou inštalácie grafického procesora
- Iné možnosti v závislosti od potrieb podnikania (napríklad ak potrebujete Kafka a podobne)
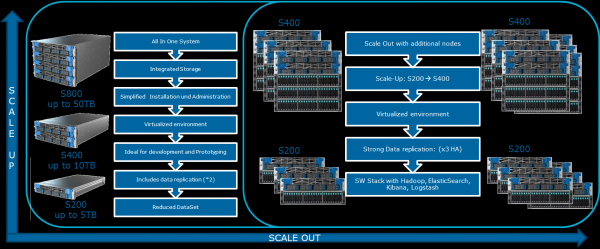
Súčasťou komplexu Atos Codex Data Lake Engine sú servery ako aj predinštalovaný softvér, vrátane balíka Cloudera s licenciou; samotný Hadoop, OpenStack s virtuálnymi strojmi založenými na jadre RedHat Enterprise Linux, systémy replikácie dát a zálohy (vrátane pomocou uzla zálohy a Cloudera BDR — Backup and Disaster Recovery). Atos Codex Data Lake Engine sa stal prvým riešením s použitím virtualizácie, ktoré bolo certifikované .
Ak máte záujem o podrobnosti, radi odpovieme na vaše otázky v komentároch.
Zdroj: habr.com
