

Rovnako ako v , objavil sa problém s distribuovanou službou, nazvime túto službu Elvin. Tentoraz som problém neobjavil sám, informovali ma chlapci z klientskej časti.
Raz ráno ma zobudil nespokojný e-mail kvôli veľkým oneskoreniam u Elvina, ktorého sme plánovali spustiť čoskoro. Konkrétne sa klient stretol s oneskorením 99. percentilu okolo 50 ms, čo je oveľa vyššie než náš rozpočet na oneskorenie. Bolo to prekvapivé, pretože som službu dôkladne testoval, najmä na oneskorenie, pretože je to predmetom častých sťažností.
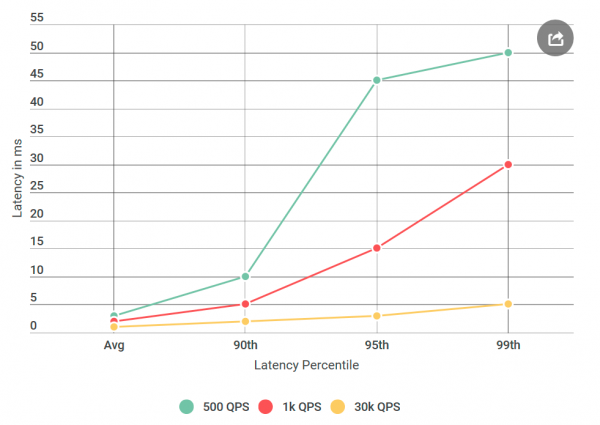
Predtým, než som dal Elvina do testovania, som vykonal veľa experimentov s 40 tisíc žiadosťami za sekundu (QPS), všetky vykázali oneskorenie menej než 10 ms. Bol som pripravený tvrdiť, že so výsledkami nesúhlasím. Ale keď som sa znova pozrel na e-mail, všimol som si niečo nové: presne som netestoval podmienky, ktoré spomenuli, ich QPS bolo omnoho nižšie než moje. Testoval som na 40k QPS, zatiaľ čo oni len na 1k. Spustil som ďalší experiment, tentoraz s nižším QPS, len aby som ich upokojil.
Keďže o tom píšem na blogu – pravdepodobne ste už pochopili: ich čísla sa ukázali byť správne. Svoj virtuálny klient som kontroloval znova a znova, vždy s rovnakým výsledkom: nízky počet požiadaviek nielen zvyšuje oneskorenie, ale tiež zvyšuje počet požiadaviek s oneskorením nad 10 ms. Inými slovami, ak pri 40k QPS približne 50 požiadaviek za sekundu prekročilo 50 ms, tak pri 1k QPS bolo každú sekundu 100 požiadaviek nad 50 ms. Paradox!
Zúžime okruh podozrivých
Pri stretnutí s problémom oneskorenia v distribuovanom systéme s mnohými komponentmi je prvým krokom zostaviť krátky zoznam podozrivých. Púšťme sa hlbšie do architektúry Elvina:
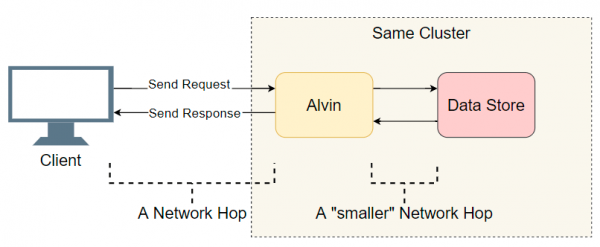
Dobrou východiskovou základňou je zoznam vykonaných prepínaní vstup-výstup (sieťové volania / vyhľadávanie na disku atď.). Pokúsme sa zistiť, kde je oneskorenie. Okrem zrejmého vstupu-výstupu s klientom, Elvin vykonáva ďalší krok: obracia sa na úložisko údajov. Avšak toto úložisko funguje v jednom klastri s Elvinom, preto by tam malo byť oneskorenie menšie než s klientom. Takže zoznam podozrivých:
- Sieťové volanie od klienta k Elvinovi.
- Sieťové volanie od Elvina k úložisku údajov.
- Hľadanie na disku v úložisku údajov.
- Sieťové volanie z úložiska dát ku Elvinovi.
- Sieťové volanie od Elvina ku klientovi.
Skúsme prečiarknuť niektoré body.
Úložisko dát nie je v tom.
V prvom rade som premenil Elvina na server ping-ping, ktorý nezpracováva požiadavky. Pri prijatí požiadavky vracia prázdnu odpoveď. Ak sa oneskorenie znižuje, potom chyba spočíva v implementácii Elvina alebo úložiska dát — nič také neobvyklé. V prvom experimente dostávame takýto graf:
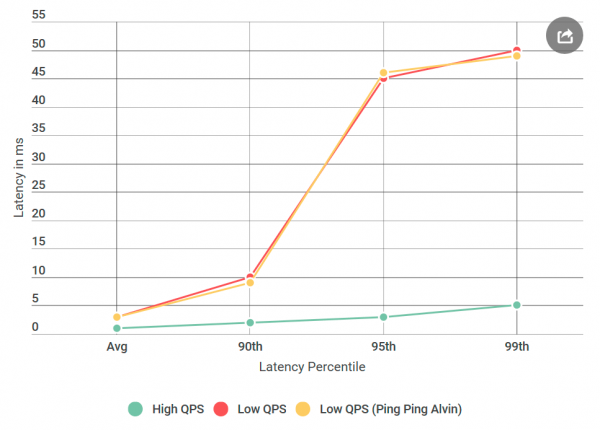
Ako vidíme, pri použití servera ping-ping sa nepozorujú žiadne zlepšenia. To znamená, že úložisko dát nezvyšuje oneskorenie, pričom zoznam podozrivých sa znižuje na polovicu:
- Sieťové volanie od klienta k Elvinovi.
- Sieťové volanie od Elvina ku klientovi.
Skvelé! Zoznam sa rýchlo zúži. myslel som si, že som takmer objavil príčinu.
gRPC
Teraz je čas predstaviť vám nového hráča: . Je to knižnica s otvoreným zdrojovým kódom od Google pre medzi-processovú komunikáciu . Hoci gRPC je dobre optimalizovaná a široko používaná, ja som ju prvýkrát použil v systéme takéhoto rozsahu, a očakával som, že moja implementácia bude neoptimálna - povedané mierne.
Prítomnosť gRPC v zásobníku vyvolalo novú otázku: môže to byť moja implementácia alebo samotná gRPC spôsobuje problém s oneskorením? Pridávame do zoznamu nového podozrivého:
- Klient volá knižnicu
gRPC - Knižnica
gRPCna klientovi vykonáva sieťové volanie knižnicegRPCna serveri - Knižnica
gRPCobráti sa na Elvina (v prípade servera ping-pong operácia neexistuje)
Aby ste pochopili, ako vyzerá kód, moja implementácia klienta/Elvina sa veľmi nelíši od príkladov klient-server .
Poznámka: uvedený vyššie zoznam je mierne zjednodušený, pretože
gRPCumožňuje použitie vlastného (šablónového?) modelu prúdenia, v ktorom sa prelínajú zásobník vykonávaniagRPCa implementácia používateľa. Pre jednoduchosť sa budeme držať tohto modelu.
Profilovanie všetko napraví
Po vyčistení úložísk dát som si pomyslel, že som skoro skončil: „Teraz je to jednoduché! Aplikujeme profilovanie a zistíme, kde vzniká oneskorenie“. Som , pretože CPU sú veľmi rýchle a najčastejšie nie sú úzkym miestom. Väčšina oneskorení sa vyskytuje, keď procesor musí zastaviť spracovanie, aby spravil niečo iné. Presné profilovanie CPU je presne na to: presne zaznamenáva všetky a poskytuje jasnosť, kde vznikajú oneskorenia.
Vzal som štyri profily: pre vysoké QPS (malá latencia) a so serverom ping-pong pri nízkom QPS (veľká latencia), ako na strane klienta, tak aj na strane servera. A pre istotu som vzal aj vzor profilu procesora. Pri porovnávaní profilov zvyčajne hľadám anomálny zásobník volaní. Napríklad na zlej strane s vysokou latenciou dochádza k oveľa väčšiemu počtu prepnutí kontextu (10 a viac krát). Ale v mojom prípade sa počet prepnutí kontextu prakticky zhodoval. K môjmu zúfalstvu sa tam nič podstatné nenašlo.
Ďalšie ladenie
Bol som v beznádeji. Nevedel som, aké ďalšie nástroje by som mohol použiť, a môj ďalší plán spočíval v podstate v opakovaní experimentov s rôznymi variáciami, namiesto presného diagnostikovania problému.
Čo ak
Hneď od začiatku ma znepokojovala konkrétna doba latencie 50 ms. To je veľmi veľká doba. Rozhodol som sa, že budem odstrihávať kusy z kódu, kým nezistím presne, ktorá časť spôsobuje túto chybu. Následoval experiment, ktorý fungoval.
Ako zvyčajne, spätne sa zdá, že všetko bolo očividné. Dal som klienta na jeden stroj s Elvinom – a poslal požiadavku do localhost. A zvýšenie latencie zmizlo!
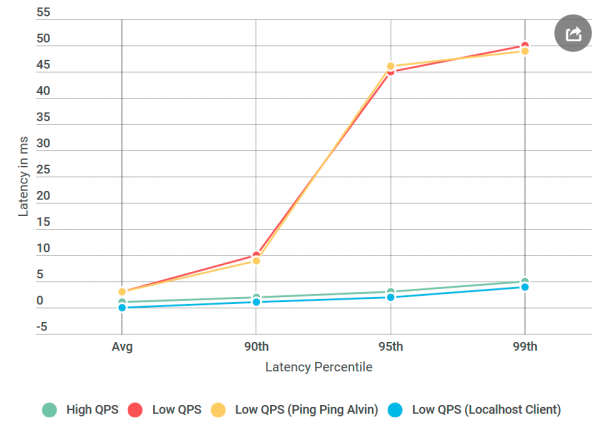
Niečo nebolo v poriadku so sieťou.
Osvojujeme si zručnosti sieťového inžiniera
Musím sa priznať: moje znalosti sieťových technológií sú hrozné, najmä s ohľadom na to, že s nimi pracujem denne. Ale sieť bola hlavným podozrivým a musel som sa naučiť, ako ju ladit.
Našťastie internet má rád tých, ktorí sa chcú učiť. Kombinácia ping a tracert sa zdala byť dostatočne dobrým začiatkom pre ladenie problémov sieťového transportu.
Najprv som spustil na TCP port Elvina. Použil som predvolené parametre – nič osobitné. Z viac ako tisíc pingov ani jeden nepresiahol 10 ms, s výnimkou prvého na zahriatie. To je v rozpore s pozorovaným zvýšením latencie na 50 ms v 99. percentile: tam na každých 100 požiadaviek sme mali vidieť okolo jedného požiadavku s latenciou 50 ms.
Potom som sa pokúsil o : možno je problém na jednom z uzlov na ceste medzi Elvinom a klientom. Ale ani tracer sa nevrátil s prázdnymi rukami.
Tým pádom, príčinou latencie nebol môj kód, nie implementácia gRPC a ani sieť. Už som začal mať obavy, že to nikdy nepochopím.
Teraz, na akej OS sa nachádzame
gRPC je široko používaný v Linuxe, ale pre Windows je to exotika. Rozhodol som sa vykonať experiment, ktorý vyšiel: vytvoril som virtuálny stroj Linux, zkompiloval Elvina pre Linux a nasadil ho.
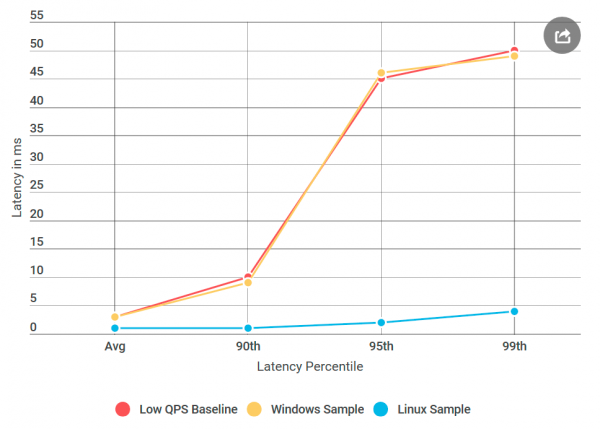
A tu je výsledok: v ping-pong serveri Linux neboli také oneskorenia ako v analogickom uzle Windows, aj keď zdroj dát sa nelíšil. Ukazuje sa, že problém je v implementácii gRPC pre Windows.
Algoritmus Nagle
Počas celého tohto času som si myslel, že mi chýba flag gRPC. Teraz som pochopil, že vlastne to je v gRPC chýba flag Windows. Našiel som internú knižnicu RPC, v ktorej som bol presvedčený, že funguje dobre pre všetky nastavené flagy . Potom som pridal všetky tieto flagy do gRPC a nasadil Elvina na Windows, v opravenom ping-pong serveri pod Windows!
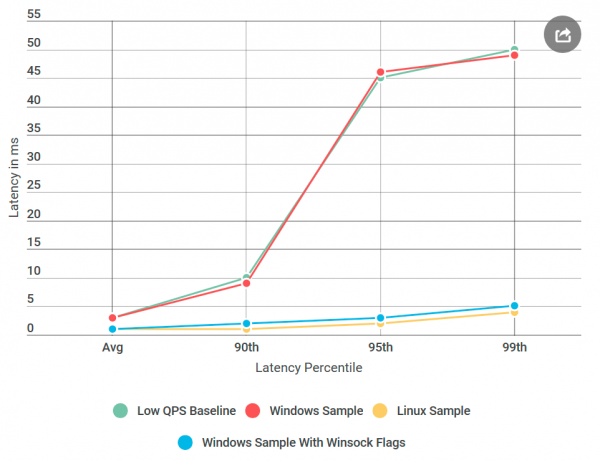
Takmer hotové: začal som odstraňovať pridané flagy jeden po druhom, kým sa regresia nevrátila, takže som mohol presne určiť jej príčinu. Bola to známa , prepínač algoritmu Nagle.
snaží sa znížiť počet paketov odoslaných po sieti tým, že oneskorí prenos správ, kým veľkosť paketu nepresiahne určené množstvo bajtov. Hoci to môže byť príjemné pre priemerného používateľa, môže to byť deštruktívne pre servery v reálnom čase, pretože OS oneskorí niektoré správy, čo spôsobí oneskorenia pri nízkom QPS. U gRPC bol tento flag nastavený v implementácii Linux pre TCP sokety, ale nie pre Windows. Opravil som to. .
Záver
užívateľskom režime. Čo sa týka experimentu localhost, pravdepodobne sa netýkal skutočného sieťového kódu a algoritmus Nagle sa nespustil, takže problémy s oneskorením zmizli, keď sa klient obrátil na Elvina cez localhost.
Pri ďalšom zvýšení oneskorenia pri znižovaní počtu požiadaviek za sekundu by mal byť algoritmus Nagle na vašom zozname podozrivých!
Ako v väčšine príspevkov, objavil sa problém s distribuovanou službou, nazvime túto službu Elvin.
Zdroj: habr.com
