

Definícia DevOps je veľmi zložitá, preto sa každý raz znova spúšťa diskusia o tom. Iba na Habre je tisíc publikácií na túto tému. Ale ak to čítate, určite viete, čo je to DevOps. Pretože ja nie. Ahoj, volám sa Alexander Titov (@), a my sa jednoducho porozprávame o DevOps a ja sa s vami podelím o svoje skúsenosti.
Dlho som uvažoval, ako spraviť svoj príbeh užitočným, preto tu bude veľa otázok - tých, ktoré si sám kladiem, a tých, ktoré kladiem klientom našej firmy. Odpovedaním na tieto otázky sa porozumenie zlepšuje. Povieme si, na čo je DevOps z môjho pohľadu, čo to vlastne je, opäť z môjho pohľadu, a ako pochopiť, či sa posúvate k DevOps, znova z môjho pohľadu. Posledný bod bude cez otázky. Odpovedaním na ne sám sebe pochopíte, či vaša spoločnosť smeruje k DevOps, alebo ak sú nejaké problémy.
Niekedy som plával po vlnách fúzií a akvizícií. Najprv som pracoval v malej startupovej firme Qik, potom ju kúpila o čosi väčšia spoločnosť Skype, ktorú neskôr kúpila ešte o čosi väčšia spoločnosť Microsoft. V tom momente som získal pohľad na to, ako sa predstava o DevOps transformuje v rôznych veľkostiach firiem. Po tom ma začalo zaujímať už z pohľadu trhu na DevOps, a s kolegami sme založili spoločnosť Express 42. Už 6 rokov sa s ňou plavíme na vlnách trhu.
Okrem všetkého ostatného som jedným z organizátorov komunity DevOps Moscow a organizátorom DevOps -Days 2017, pričom v roku 2018 som to už neorganizoval. Express 42 pracuje s mnohými spoločnosťami. Pestujeme tam DevOps, sledujeme, ako to prebieha, robíme závery, analyzujeme, zdieľame svoje závery so všetkými, a vzdelávame ľudí praktikám DevOps. V podstate rastieme v tomto smere, pokiaľ ide o skúsenosti a odborné znalosti.
Prečo DevOps
Prvá otázka, ktorá trápi každého a vždy - prečo? Mnohí si myslia, že DevOps je len automatizácia alebo niečo podobné, čo už bolo v každej spoločnosti.
- Mali sme Continuous Integration - to znamená, že už bol DevOps, a načo je všetka táto fraška potrebná? Tam v zahraničí sa zabávajú, a nám bránia v práci!
Za 9 rokov rozvoja komunity a metodológie sa už ukázalo, že to nie sú len marketingové triky, ale stále nie je úplne jasné, na čo je to potrebné. Ako pri každom nástroji a procese, aj DevOps má konkrétne cieľe, ktoré nakoniec dosahuje.
Všetko to súvisí s tým, že svet sa mení. Odchádza od prístupu enterprise, keď sa firmy pohybujú priamo k svojmu snu, ako spieval náš petrohradský klasik, z bodu A do bodu B podľa určitej stratégie, s vybudovanou pre tento účel konkrétnou štruktúrou.
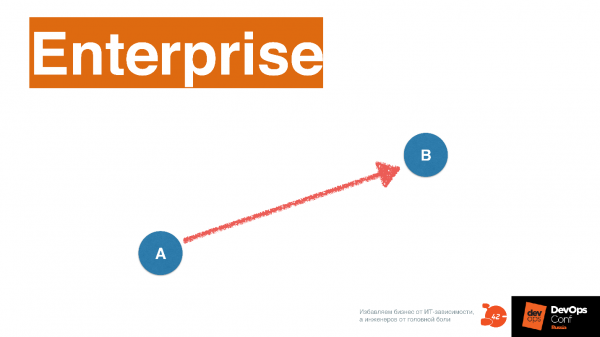
V zásade by malo byť všetko v IT postavené na tomto prístupe. Tu sa IT používa výlučne na automatizáciu procesov.
Automatizácia sa často nemení, pretože keď sa firma pohybuje po známej ceste – čo tam meniť? Funguje – nezasahuj. Teraz sa v svete prístupy menia, a ten, ktorý sa nazýva Agile, hovorí o tom, že konečná bod B nie je na prvý pohľad jasná.
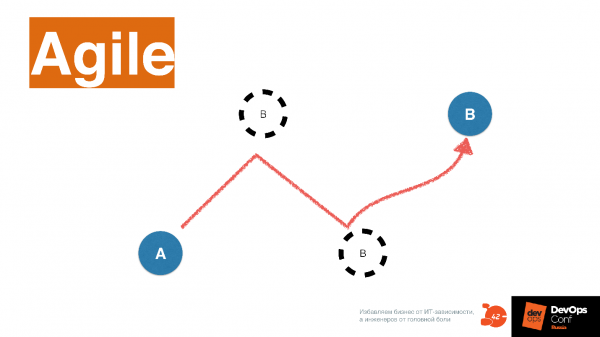
Keď firma ide po trhu a pracuje s klientom – neustále skúma trh a mení konečný bod B. A čím častejšie firma mení svoj smer, tým je napokon úspešnejšia, pretože si vyberá viac trhových nís.
Zaujímavá firma, o ktorej som sa dozvedel nedávno, ukazuje túto stratégiu. One Box Shave – služba na doručenie holiacich strojčekov a holiacich pomôcok na predplatnom v krabici. Dokážu prispôsobiť svoju "krabičku" rôznym klientom. O to sa stará špecifický softvér, ktorý potom odosiela objednávku na kórejskú továreň, ktorá vyrába tovar.
Tento produkt zakúpila spoločnosť Unilever za 1 miliardu dolárov. Teraz sú v konkurencii s Gillette a ukradli mu značnú časť spotrebiteľov na americkom trhu. One Box Shave hovorí:
— 4 čepele? Myslíte to vážne? Načo to potrebujete — to nijako nezlepšuje kvalitu holenia. Špeciálne vybraný krém, vôňa a kvalitný holiaci strojček s dvoma čepeľami vyriešia oveľa viac problémov, ako týchto hlúpych 4 čepiel Gillette! Čoskoro sa dostaneme až k 10?
Tak sa svet mení. Unilever hlásia, že majú skvelý IT systém, ktorý to umožňuje. Nakoniec to vyzerá ako koncept Time-to-market, o ktorom už len málokto nehovoril.
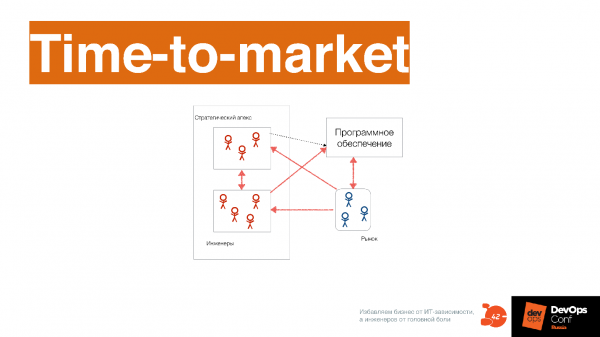
Zmysel Time-to-market nespočíva v tom, ako často nasadzujeme. Môžeme nasadzovať často, ale vydávacie cykly môžu byť dlhé. Ak na seba navážeme trojmesačné vydávacie cykly, posúvajúc ich o týždeň, vychádza nám, že sa spoločnosť akoby nasadzuje raz za týždeň. A od nápadu po konečnú realizáciu prejde 3 mesiace.
Time-to-market je o minimalizácii času od nápadu po konečnú realizáciu.
V tomto prípade sa s trhom interaguje cez softvér. Takže One Box Shave komunikuje so zákazníkom cez stránku. Nemajú predajcov - iba stránku, kde návštevník kliká a zanecháva požiadavky. Preto je potrebné na stránke neustále zverejňovať niečo nové a aktualizovať ju podľa požiadaviek. Napríklad v Južnej Kórei sa holia inak ako v Rusku a páči sa im, keď nie je vôňa borovice, ale napríklad vanilkovej mrkvy.
Keďže je potrebné rýchlo meniť obsah stránky, vývoj softvéru sa výrazne mení. Cez softvér musíme zistiť, čo chce zákazník. Predtým sme to zisťovali obchádzajúcimi spôsobmi, napríklad cez business management. Potom sme projektovali, zahrnuli požiadavky do IT systému a všetko bolo skvelé. Teraz je to iné - softvér projektujú všetci zapojení do procesu, vrátane inžinierov, pretože sa dozvedia cez technické špecifikácie, ako funguje trh, a zdieľajú s biznisom svoje poznatky.
Napríklad v spoločnosti Qik sme zrazu zistili, že ľuďom sa veľmi páči nahrávať kontaktné zoznamy na server a pridali nám aplikáciu. Pôvodne sme nad tým neuvažovali. V klasickej firme by všetci rozhodli, že je to chyba, pretože v špecifikácii nie je napísané, že by to malo funkčne dobre fungovať a vôbec to bolo realizované na kolene, vypnuli by funkciu a povedali: 'To nikomu nie je potrebné, hlavné je, že základná funkcionalita funguje.' A technologická spoločnosť v tom vidí príležitosť a začína meniť softvér v súlade s tým.
V roku 1968 brilantný chlapec Melvin Conway formuloval nasledujúcu myšlienku.
Organizácia, ktorá vytvára systém, je obmedzená dizajnom, ktorý kopíruje štruktúru komunikácie v tejto organizácii.
Ak chcete vyvinúť systémy iného typu, potrebujete mať aj komunikačnú štruktúru vo vnútri firmy iného typu. Ak máte hierarchickú komunikačnú štruktúru, nedovolí vám to vytvoriť systémy, ktoré môžu zabezpečiť veľmi vysoký ukazovateľ Time-to-market.
Prečítať možné . Je dôležitý pre pochopenie kultúry alebo filozofie DevOps, pretože jediná základná vec, ktorá sa mení v DevOps, je práve štruktúra komunikácie medzi tímami..
Z hľadiska procesu pred DevOps všetky fázy: analýza, vývoj, testovanie, prevádzka, prebiehali lineárne.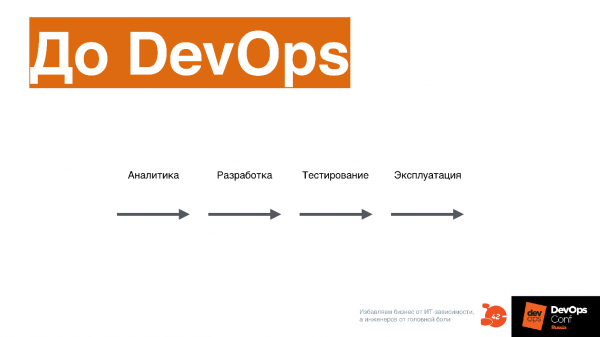
Pri DevOps prebiehajú všetky tieto procesy súčasne.
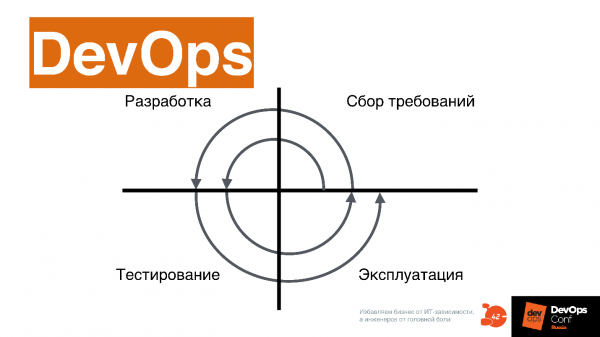
Time-to-market sa iba takto môže vykonávať. Pre ľudí, ktorí pracovali v starom procese, to vyzerá dosť futuristicky a vlastne tak nejako.
Tak na čo je DevOps potrebný?
Pre vývoj digitálnych produktov.Ak vo vašej spoločnosti nie je digitálny produkt, DevOps nie je potrebný - to je veľmi dôležité.
DevOps prekonáva časové obmedzenia sekvenčného schémy výroby softvéru.V ňom prebiehajú všetky procesy súčasne.
Zvyšuje sa zložitosti. Keď DevOps evanjelisti hovoria, že s ním bude ľahšie vydávať softvér - to je nezmysel.
S DevOps to bude len ťažšie.
Na konferencii na stánku Avito ste mohli vidieť, aké je náročné nasadiť Docker kontajner - nerealizovateľná úloha. Zložitosti dosahuje neúnosné úrovne, musíte žonglovať s mnohými balónikmi súčasne.
DevOps úplne mení proces a organizáciu v spoločnosti, presnejšie, nemení DevOps, ale digitálny produkt. Aby ste dospeli k DevOps, musíte tento proces úplne zmeniť.
Otázky pre odborníka
A čo vy? Otázky, ktoré si môžete položiť, keď pracujete v spoločnosti a vyvíjate sa ako odborník.
Máte stratégiu na vytvorenie digitálneho produktu? Ak áno - už je to dobré. To znamená, že vaša spoločnosť smeruje k DevOps.
Vaša spoločnosť už vytvára digitálny produkt? To znamená, že sa môžete posunúť ešte o stupeň vyššie, angažovať sa v zaujímavejších veciach - z hľadiska DevOps opäť. Hovorím iba z tohto hľadiska.
Je vaša spoločnosť jedným z lídrov na trhu v niku s digitálnym produktom? Spotify, Yandex, Uber — spoločnosti, ktoré sú teraz na vrchole technologického pokroku.
Zadajte si tieto otázky a ak sú všetky odpovede záporné, možno by ste sa nemali venovať DevOps v tejto spoločnosti. Ak vás téma DevOps naozaj zaujíma, možno by ste sa mali presunúť do inej spoločnosti? Ak vaša spoločnosť chce ísť do DevOps, ale na všetky otázky ste odpovedali 'Nie', potom pripomína tohto nádherného nosorožca, ktorý sa nikdy nezmení.
Organizácia
Ako som už povedal, podľa Conwayovho zákona sa organizácia vo firme mení. Začnem od toho, čo bráni DevOps preniknúť do spoločnosti z hľadiska organizácie.
Problém 'silos'
Anglické slovo 'Silo' je tu preložené ako 'sila'. Zmysel tohto problému spočíva v tom, že medzi tímami nie je výmena informácií.Každý tím sa hlboko ponára do svojej expertízy, pričom nestavia spoločnú mapu, podľa ktorej by sa dalo orientovať.
Niečím to pripomína človeka, ktorý práve prišiel do Moskvy a ešte nevie, ako sa orientovať na mape metra. Moskvičania zvyčajne dobre poznajú svoju oblasť, zatiaľ čo po celej Moskve sa orientujú podľa mapy metra. Keď prídete do Moskvy prvýkrát, nemáte tento zručnosť a proste ste dezorientovaní.
DevOps ponúka prejsť týmto momentom dezorientácie a spolu všetkým oddeleniam postaviť spoločnú mapu interakcií.
Tomu bránia dva faktory.
Dôsledok firemného riadiaceho systému. Je postavený na samostatných hierarchických 'sila'. Napríklad existujú určité KPI v spoločnostiach, ktoré tento systém podporujú. Na druhej strane, bránia mozgy človeka, ktorému sa ťažko vychádza z rámca svojej expertízy a orientuje sa v celej sústave. Je to proste nepríjemné. Predstavte si, že ste prišli na letisko v Bangkoku — tam sa rýchlo neorientujete. V DevOps je tiež ťažké sa orientovať, a preto ľudia hovoria, že je potrebné nájsť sprievodcu, aby sa tam dostali.
Ale najdôležitejšie je, že problém 'sila' pre inžiniera, ktorý sa prenikol duchom DevOps, prečítal Feylera a množstvo ďalších kníh, sa prejavuje v tom, že 'sila' nedovoľujú robiť 'zjavné' veci.Často sa stretávame po DevOps Moscow, rozprávame sa navzájom a ľudia si sťažujú:
— Chceli sme len spustiť CI, ale ukázalo sa, že manažment to nepotrebuje.
To sa deje práve preto, že CI a Proces kontinuálneho dodávania sa nachádzajú na hrane mnohých odborností. Ak sa neprekona problém „studní“ na organizačnej úrovni, nepodarí sa posunúť ďalej, nech robíte čokoľvek a akokoľvek smutné to bolo.
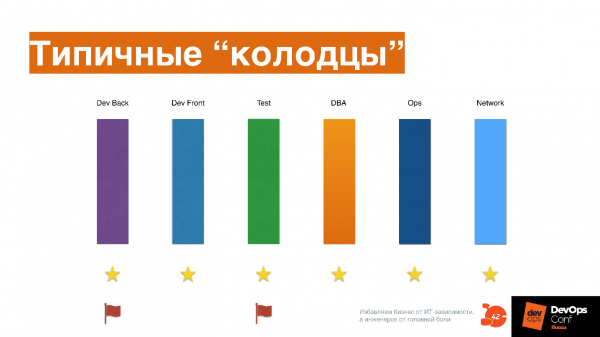
Každý účastník procesu v spoločnosti: backend a frontend vývojári, testovanie, DBA, prevádzka, sieť, kopú do svojej strany, a spoločnú mapu nemá nikto, okrem manažéra, ktorý ich nejako dohliada a riadi metódou „rozděl a panuj“.
Ľudia sa snažia získať nejaké hviezdičky alebo vlajky, každý sa snaží o svoju odbornú oblasť.
Vo výsledku, keď nastane úloha spojiť to všetko dokopy a už sa nemusí bojovať o hviezdičky a vlajky, vznikne otázka – čo vlastne robiť? Treba sa nejako dohodnúť, ale ako to urobiť, nás v škole nikto neučil. Ešte zo školy sme naučení: ôsmy ročník – wow! – v porovnaní so siedmym ročníkom! Tu je to to isté.
Je to vo vašej spoločnosti rovnako?
Aby ste to overili, môžete si položiť nasledujúce otázky.
Používajú tím spoločné nástroje, prispievajú k zmenám týchto spoločných nástrojov?
Ako často sa tímy prestavujú – čiže niektorí odborníci z jedného tímu prechádzajú do iného? Práve v prostredí DevOps sa to stáva normálnym, pretože niekedy človek jednoducho nemôže pochopiť, čomu sa iná odborná oblasť venuje. Prejde do iného oddelenia, dve týždne tam pracuje, aby si vytvoril mapu orientácie a interakcie s týmto oddelením.
Môže sa vytvoriť výbor pre zmenu a niečo zmeniť? Ale na to je potrebná silná ruka najvyššieho vedenia a príkaz? Nedávno som napísal na Facebook, ako jeden málo známy bank cez príkazy zavádza nástroje: napísali príkaz, rok zavádzame, sledujeme, čo sa deje. To, samozrejme, trvá dlho a je to smutné.
Ako je dôležité pre manažérov dosiahnuť osobné úspechy bez ohľadu na úspechy firmy?
Ak si na tieto otázky odpoviete, bude jasnejšie, či máte tento problém v spoločnosti.
Infrastruktúra ako kód
Po tom, čo prejdete touto problémou, prvou dôležitou praxou, bez ktorej je ťažké posunúť sa ďalej v DevOps, je infrastruktúra ako kód.
Najčastejšie sa infraštruktúra ako kód vníma takto:
— Poďme všetko automatizovať v bash, obalíme sa skriptami, aby administrátorky mali menej ručnej práce!
Ale to nie je tak.
Infrastruktúra ako kód znamená, že IT systém, s ktorým pracujete, opisujete vo forme kódu, aby ste neustále chápali jeho stav.
Spolu s ďalšími tímami vytvárate mapu vo forme kódu, ktorá je všetkým zrozumiteľná a podľa ktorej sa dá orientovať, navigovať. Nezáleží na tom, na čom to je urobené — Chef, Ansible, Salt alebo sa používajú YAML súbory v Kubernetes — je to jedno.
Na konferencii kolega z 2GIS rozprával, ako vytvorili svoju internú vec pre Kubernetes, ktorá opisuje zariadenie jednotlivých systémov. Aby opísali 500 systémov, potrebovali samostatný nástroj, ktorý tento popis generuje. Keď je tento popis, každý sa môže navzájom kontrolovať, sledovať zmeny, ako to zmeniť a zlepšiť, čo chýba.
Súhlasíte, že jednotlivé bash skripty zvyčajne nedávajú toto pochopenie. V jednej z firiem, kde som pracoval, bolo dokonca pomenovanie „write only“ skript — keď je skript napísaný, ale prečítať ho už nie je možné. Myslím, že vám to tiež nie je neznáme.
Infrastruktúra ako kód je kód, ktorý popisuje aktuálny stav infraštruktúry. Na tomto kóde spoločne pracuje množstvo produktových, infraštruktúrnych a servisných tímov a, čo je najdôležitejšie, všetci musia chápať, ako tento kód vlastne funguje.
Kód je spravovaný podľa najlepších praktík práce s kódom: spoločný vývoj, kódová revízia, XP-programming, testovanie, pull requesty, CI pre infraštruktúry kódu — toto všetko je kvalitné a dá sa to používať.
Kód sa stáva spoločným jazykom pre všetkých inžinierov.
Zmena infraštruktúry v kóde nezaberá veľa času. Áno, aj v infraštruktúrnom kóde môže byť technický dlh. Zvyčajne sa tímy s ním stretávajú asi po roku a pol od začiatku implementácie „infrastruktúry ako kód“ vo forme hromady skriptov alebo dokonca Ansible, ktorý píšu ako špagetový kód, a ešte tam posielajú bash skripty do pece!
Dôležité: ak ste to ešte neskúsili, zapamätajte si, že Ansible nie je bash! Pozorne si prečítajte dokumentáciu, pozrite sa, čo o tom vôbec píšu.
Infrastruktúra ako kód znamená rozdelenie infraštruktúrneho kódu do samostatných vrstiev.
U nás vo firme rozdeľujeme 3 základné vrstvy, ktoré sú veľmi jasné a jednoduché, ale môže ich byť viac. Môžete sa pozrieť na váš infraštruktúrny kód a povedať, či máte túto podmienku alebo nie. Ak sa nevyčleňuje žiadna vrstva, treba si nájsť čas a trochu refaktorovať.
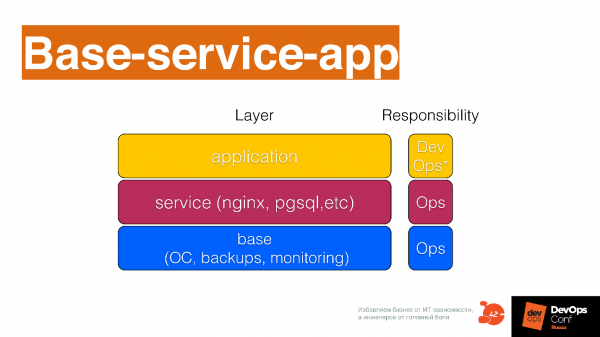
Základná vrstva je to, ako sa nastavuje OS, zálohy a iné nízkoúrovňové veci, napríklad, ako sa zavádza Kubernetes na základnej úrovni.
Úroveň služieb sú to služby, ktoré poskytujete vývojárovi: logovanie ako služba, monitoring ako služba, databáza ako služba, vyvažovač ako služba, fronta ako služba, Continuous Delivery ako služba – množstvo služieb, ktoré jednotlivé tímy môžu poskytovať vývoju. Všetko toto je potrebné opisovať samostatnými modulmi vo vašom systéme správy konfigurácie.
Vrstva, kde sa vytvárajú aplikácie a popisuje, ako sa budú zavádzať na dvoch predchádzajúcich vrstvách.
Kontrolné otázky
Máte vo firme spoločný infraštruktúrny repozitár? Kontrolujete technický dlh v infraštruktúre? Používate vývojové praktiky v infraštruktúrnom repozitári? Je vaša infraštruktúra rozdelená do vrstiev? Môžete sa porovnať so schémou Base-service-APP. Ako ťažké je urobiť zmenu?
Ak ste sa stretli s tým, že zapracovanie zmien trvalo jeden a pol dňa, znamená to, že máte technický dlh a treba s ním pracovať. Narazili ste na hranice technického dlhu v infraštruktúrnom kóde. Pamätám si veľa takých histórií, keď na zmenu nejakého CCTL museli prepisovať polovicu infraštruktúrneho kódu, pretože kreativita a túžba všetko automatizovať viedli k tomu, že všade bolo všetko zalepené, všetky rukoväte odstránené, a treba refaktorovať.
Neprerušené dodávky
Zhrnieme debet s kreditom. Najprv sa objaví popis infraštruktúry, ktorý môže byť dosť základný. Nie je potrebné všetko podrobne popisovať, ale nejaký základný popis je potrebný, aby ste s tým mohli pracovať. Inak nie je jasné, na čom by ste mali ďalej stavať kontinuálnu dodávku. Všetky tieto praktiky sa rozvíjajú súčasne, keď sa dostanete k DevOps, ale musíte začať s porozumením toho, čo máte a ako to spravovať. To je práve prax infraštruktúra ako kód.
Akonáhle sa pochopí, čo máte, ako to spravovať, začnete vymýšľať, ako kód vývojára čo najrýchlejšie odoslať do produkcie. Mám na mysli spolu s vývojárom - pamätajme na problém 'studní', teda nie jednotlivci to vymýšľajú, ale tím.
Keď sme s Ivanom Evtušovičom uvideli prvú knižku Jezza Hambla a skupiny autorov «Continuous Delivery», ktorá vyšla v roku 2009, tak sme dlho rozmýšľali, ako preložiť jej názov do slovenčiny. Chceli sme preložiť ako 'Stále dodávať', ale, žiaľ, preložili sme ako 'Nepretržitá dodávka'. Myslím, že v našom názve je niečo ruské, s náporom.
Stále dodávať znamená
Kód, ktorý leží v produktovom repozitári, je vždy pripravený byť vytiahnutý do produkcie.Môže byť aj nevytiahnutý, ale vždy je na to pripravený. Zodpovedajúco, vždy píšete kód s ťažko vysvetliteľným pocitom určitého nepokoja pod kostrčou. Ten pocit určitého nepokoja by mal byť prítomný - vyvoláva mentálne procesy, ktoré umožňujú písať kód trochu inak. To by malo byť zakotvené v pravidlách v rámci vývoja.
Aby ste mohli stále dodávať, potrebujete formát artefaktu, ktorý prechádza infraštruktúrnou platformou. Ak hádzate rôzne formáty 'odpadov' po infraštruktúrnej platforme, stáva sa neuniformnou, ťažko sa udržuje a vzniká problém technického dlhu. Formát artefaktu je potrebné zjednotiť - to je tiež kolektívna úloha: treba sa všetci spolu zhromaždiť, poškrabať mozgy a vymyslieť tento formát.
Artefakt sa nepretržite zlepšuje a mení pod produkčným prostredím počas prechodu cez dodávkový pipeline. Keď artefakt prechádza pipeline, neustále sa stretáva s nejakými prekážkami, ktoré sú podobné tým, s ktorými sa stretáva artefakt, ktorý uvádzate do produkcie. Ak sa v klasickej vývoji o to stará systémový administrátor, ktorý robí nasadenie, v DevOps procese to prebieha neustále: tu ho pritom testovali, tu ho hodili do Kubernetes klastru, ktorý je viac-menej podobný produkcii, a tu náhle spustili záťažové testy.
Niekedy to pripomína hru Pac-Man - artefakt prechádza nejakým príbehom. Pri tom je dôležité kontrolovať, či kód naozaj prechádza príbehom a súvisí s vašou produkciou. Príbehy z produkcie je možné zasadiť do procesu Continuous Delivery: bolo tak, že niečo zlyhalo, tak teraz tento scénar jednoducho naprogramujeme do systému. Každý raz kód prejde týmto scénarom tiež a nabudúce sa s touto problémou nestretnete. O ňom sa dozviete oveľa skôr, ako sa dostane k vášmu zákazníkovi.
Rôzne stratégie nasadenia. Napríklad používate AB testovanie alebo kanárske nasadenia, aby ste rôzne 'ďalej pocítili' kód na rôznych klientoch, získali informácie o tom, ako kód funguje, a oveľa skôr, ako sa dostane na 100 miliónov používateľov.
„Neustále dodávať“ vyzerá takto.
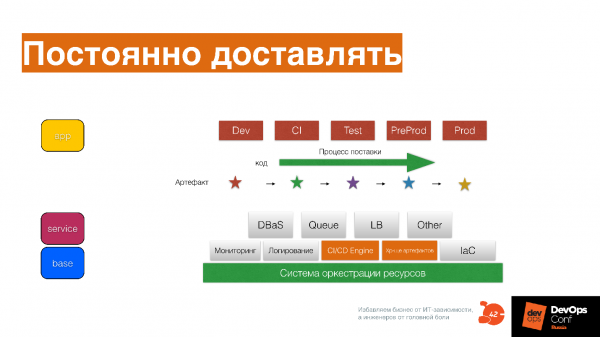
Proces dodávky Dev, CI, Test, PreProd, Prod - to nie je samostatné prostredie, to sú fázy alebo stanice s nezničiteľnými súmami, ktorými prechádza váš artefakt.
Ak máte infraštruktúrny kód, ktorý je popísaný ako Base Service APP, tak vám pomáha nezabudnúť žiadne scenáre, a zapísať ich tiež vo forme kódu pre tento artefakt, posúvať artefakt a meniť ho počas pohybu.
Otázky na sebaosvietenie
Trvá od opisu funkcie po nasadenie do produkcie v 95 % prípadov menej ako týždeň? Zlepšuje sa kvalita artefaktu na každom kroku pipeline? Existuje príbeh, ktorým prechádza? Používate rôzne stratégie nasadenia?
Ak sú všetky odpovede áno, tak ste neuveriteľne skvelí! Napíšte odpovede do komentárov - budem rád.)
Spätná väzba
Toto je najnáročnejšia prax zo všetkých. Na konferencii DevOpsConf, kolega z Infobip rozprával o tejto praxi a trochu sa zamotal do slov, pretože je to naozaj veľmi zložitá prax, kde je potrebné monitorovať naozaj všetko!
Napríklad, dávno, keď som pracoval v Qik a uvedomili sme si, že musíme monitorovať naozaj všetko. Urobili sme to a v Zabbix máme 150 000 položiek, ktoré sa neustále monitorujú. Bolo to desivé, technický riaditeľ krútil prstom pri temple:
— Chlapci, prečo zaťažujete server nejakými nezmyslami?
Ale potom sa stala vec, ktorá ukázala, že to naozaj je veľmi dobrá stratégia.
Jedna služba začala neustále padať. Zaujímavé je, že pôvodne nepadala, pretože na ňu nebol písaný kód – bola to základná brána, ktorá prakticky nemala obchodnú funkcionalitu – iba prenášala správy medzi jednotlivými službami. Služba sa nemenila 4 mesiace a zrazu začala padať s chybou „Segmentation fault“.
Boli sme v šoku, otvorili sme naše grafy v Zabbix a zistili sme, že pred 1,5 týždňom sa výrazne zmenilo správanie požiadaviek v API službe, ktorá používa túto bránu. Potom sme si všimli, že sa zmenila frekvencia posielania určitého typu správ. Potom sme zistili, že ide o android klientov. Spýtali sme sa:
— Chlapci, čo sa vám stalo pred 1,5 týždňom?
Na to sme dostali zaujímavý príbeh o tom, že prepracovali UI. Ťažko by niekto povedal, že zmenili HTTP knižnicu. Pre android klientov je to ako vymeniť mydlo v kúpeľni – oni si to jednoducho nepamätajú. Po 40 minútach rozhovoru sme zistili, že predsa len zmenili HTTP knižnicu a zmenili sa jej predvolené časovanie. To viedlo k zmene správania sa prevádzky na API serveri, čo vyvolalo situáciu, ktorá spôsobila pretekanie vnútri brány a začala padať.
Bez hlbokého monitorovania by to bolo vôbec nemožné odhaliť.. Ak v organizácii existuje problém s "studňami", keď si každý hádže zodpovednosť na druhého, môže to trvať roky. Jednoducho reštartujete server, pretože nie je možné problém vyriešiť. Keď monitorujete, sledujete a zaznamenávate všetky udalosti, ktoré máte, a používate monitoring ako testovanie — píšete kód a okamžite ukazujete, ako ho monitorovať, tiež vo forme kódu (už máme infraštruktúru ako kód), všetko sa stáva jasným ako na dlani. Aj také zložité problémy sa ľahko sledujú.
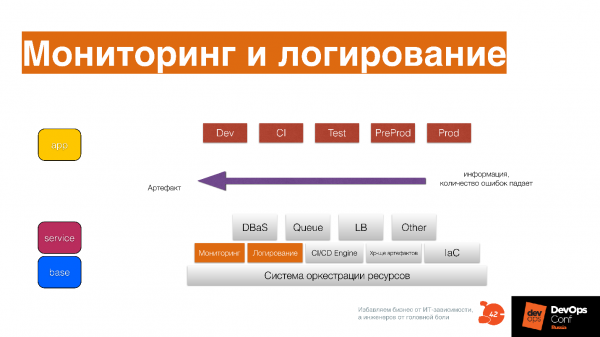
Zbierajte všetky informácie o tom, čo sa deje s artefaktom na každej fáze procesu dodávky — nie v produkcii.
Nahrajte monitoring na CI, a tam už budú viditeľné nejaké základné veci. Ďalej ich uvidíte aj v Test, aj v PredProd, aj v záťažovom testovaní. Zbierajte informácie vo všetkých fázach, a to nielen metriky, štatistiky, ale aj logy: ako bolo aplikované, anomálie — zbierajte všetko.
Inak bude ťažké sa v tom vyznať. Už som spomínal, že DevOps je väčšia zložitosť. Aby ste sa vysporiadali s touto zložitosťou, potrebujete normálnu analytiku..
Otázky pre seba-kontrolu
Je váš monitoring a logovanie nástrojom vývoja pre vás? Myslia vaši vývojári, a vy vrátane, keď píšu kód, na to, ako ho monitorovať?
Zisťujete o problémoch od klientov? Rozumiete klientovi lepšie z monitorovania a logovania? Chápete systém lepšie z monitorovania a logovania? Meníte systém len preto, že vidíte, že trend v systéme rastie a chápete, že za ďalšie 3 týždne to všetko skrachuje?
Keď máte tieto tri komponenty, môžete premýšľať o tom, akú máte v spoločnosti infraštruktúrnu platformu.
Infraštruktúrna platforma
Zmysel nespočíva v tom, že ide o súbor roztrhnutých nástrojov, ktoré sú v každej spoločnosti.
Zmysel infraštruktúrnej platformy spočíva v tom, že všetky tímy používajú tieto nástroje a rozvíjajú ich spoločne.
Je jasné, že sú samostatné tímy, ktoré sú zodpovedné za rozvoj jednotlivých častí infraštruktúrnej platformy. Ale pritom zodpovednosť za rozvoj, funkčnosť, propagáciu infraštruktúrnej platformy nesie každý inžinier. Na vnútornej úrovni sa to stáva spoločným nástrojom.
Všetky tímy rozvíjajú infraštruktúrnu platformu, starajú sa o ňu ako o svoju vlastnú IDE. Vo svojom IDE si inštalujete rôzne pluginy, aby všetko bolo pekné a rýchle, nastavujete skratky. Keď otvoríte Sublime, Atom alebo Visual Studio Code, objavia sa tam chyby kódu a vy si uvedomíte, že pracovať je takmer nemožné, rýchlo vás to sklamalo a utiekli ste opraviť svoje IDE.
Rovnako sa starajte aj o svoju infraštruktúrnu platformu. Ak chápete, že s ňou niečo nie je v poriadku, zanechajte žiadosť, ak to nemôžete opraviť sami. Ak je to niečo jednoduché - opravte to sami, pošlite pull request - chalani to zvažujú, pridávajú. Toto je trochu iný prístup k inžinierskemu nástrojovému súboru v hlave vývojára.
Infra-struktúrna platforma zabezpečuje prenos artefaktu od vývoja klientovi s neustálym zvyšovaním kvality. V IP je naprogramovaný súbor príbehov, ktoré sa vyskytujú s kódom v produkcii. Po rokoch vývoja týchto príbehov pribúda, niektoré z nich sú jedinečné a patria iba vám - nie je možné ich nájsť na internete.
V tomto momente sa infraštruktúrna platforma stáva vašou konkurenčnou výhodou, pretože v sebe obsahuje to, čo rival nemá. Čím hlbšia je vaša IP, tým väčšia je vaša konkurenčná výhoda z hľadiska Time-to-market. Tu sa objavuje problém vendor lock: môžete si vziať cudziu platformu, ale využívaním cudzieho skúsenosti nebudete rozumieť, do akej miery je relevantný pre vás. Áno, nie každá spoločnosť môže postaviť platformu ako Amazon. Je to zložitá hranica, kde sú skúsenosti firmy relevantné k jej postaveniu na trhu, a dovoliť vendor lock tam nemôžete. O tom je tiež dôležité premýšľať.
Schéma
Toto je základná schéma infraštruktúrnej platformy, ktorá vám pomôže nastaviť všetky praktiky a procesy v DevOps spoločnosti.
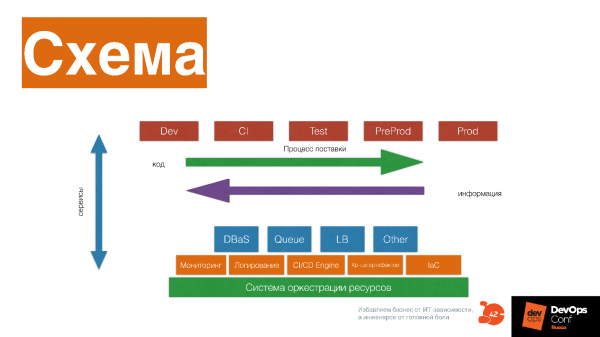
Pozrime sa, z čoho sa skladá.
Systém orchestrácie zdrojov, ktorý poskytuje CPU, pamäť, disk aplikáciám a ďalším službám. Nad týmto sú nízkoúrovňové služby: monitorovanie, logovanie, CI/CD Engine, úložisko artefaktov, infraštruktúra ako kód systémov.
Služby vyššej úrovne: databáza ako služba, fronty ako služba, Load Balance ako služba, resizing obrázkov ako služba, Big Data fabrika ako služba. Nad tým — pipeline, ktorý neustále dodáva modifikovaný kód vášmu klientovi.
Získavate informácie o tom, ako vaše softvér funguje u vášho klienta, meníte, znovu dodávate tento kód, získavate informácie — a tak neustále vyvíjate aj infrastruktúrnu platformu, aj vaše softvér.
Na schéme sa dodávací pipeline skladá z mnohých fáz. Ale to je principiálna schéma, ktorá je uvedená len ako príklad — nemusíte ju opakovať jednu k jednej. Fázy interagujú so službami ako so službami — každý blok platformy nesie svoj príbeh: ako sa prideľujú zdroje, ako sa aplikácia spúšťa, pracuje so zdrojmi, monitoruje, mení.
Je dôležité chápať, že každá časť platformy nesie príbeh, a pýtať sa seba — aký príbeh nesie tento blok, možno by ho malo vyhodiť a nahradiť externou službou. Napríklad, môže byť namiesto bloku nasadený Okmeter? Možno, že chlapci už zdokonalili túto expertízu oveľa viac ako my. Ale možno aj nie — možno máme unikátnu expertízu, musíme nasadiť Prometheus a vyvíjať to ďalej.
Vytvorenie platformy
To je zložitý komunikačný proces. Keď máte základné praktiky, spúšťate komunikáciu medzi rôznymi inžiniermi a odborníkmi, ktorí vypracovávajú požiadavky a štandardy a neustále ich menia ku rôznym nástrojom a prístupom. Tu je dôležitá kultúra, ktorá existuje v DevOps.
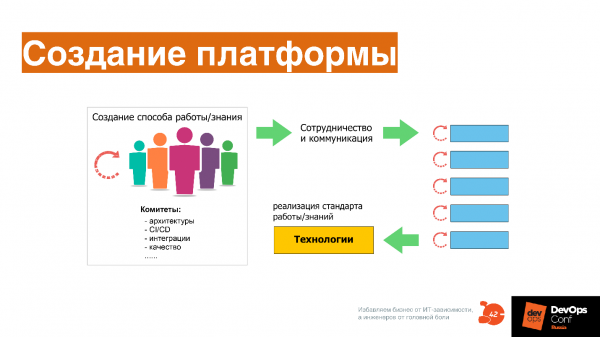
S kultúrou je všetko veľmi jednoduché — je to spolupráca a komunikácia, teda túžba pracovať spoločne v jednom poli, túžba ovládať jeden nástroj spolu. Tu nie je žiadna raketová veda — všetko je veľmi jednoduché, banálne. Napríklad, všetci žijeme vo vchode a udržiavame ho čistý — takáto úroveň kultúry.
A čo u vás?
Opäť otázky, ktoré si môžete položiť.
Je vyčlenená infrastruktúrna platforma? Kto zodpovedá za jej rozvoj? Rozumiete konkurentným výhodám svojej infrastruktúrnej platformy?
Tieto otázky si treba neustále klásť. Ak je možné niečo preniesť na externé služby - treba to preniesť, ak externá služba začne blokovať váš pokrok, je potrebné vybudovať systém vo vnútri seba.
Takže, DevOps…
… je zložitý systém, ktorý by mal obsahovať:
- Digitálny produkt.
- Obchodné moduly, ktoré tento digitálny produkt rozvíjajú.
- Produktové tímy, ktoré píšu kód.
- Praktiky Continuous Delivery.
- Platformy ako služba.
- Infrastruktúra ako služba.
- Infrastruktúra ako kód.
- Samostatné praktiky udržiavania spoľahlivosti, zabudované vo vnútri DevOps.
- Praktika spätnej väzby, ktorá toto všetko opisuje.
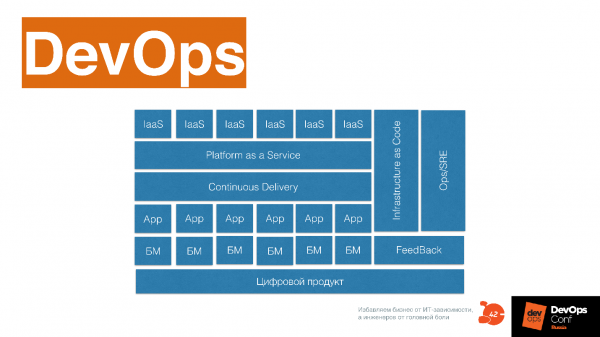
Túto schému môžete využiť a zvýrazniť v nej to, čo už vo vašej spoločnosti existuje v nejakej forme: toto sa vyvinulo alebo to ešte treba rozvinúť.
Už za pár týždňov sa uskutoční . v rámci RIT++. Príďte na konferenciu, kde vás čaká množstvo skvelých prezentácií o kontinuálnej dodávke, infraštruktúre ako kód a DevOps transformácii. , posledný termín cien 20. mája
Zdroj: habr.com
