

Prvý API MojeSkladu sa objavil pred 10 rokmi. Po celé toto obdobie pracujeme na existujúcich verziách API a vyvíjame nové. A niekoľko verzií API už stihlo skončiť v zabudnutí.
V tomto článku bude veľa vecí: ako sme vytvorili API, prečo je potrebné pre cloudovú službu, čo prináša používateľom, na aké problémy sme narazili a čo chceme robiť ďalej.
Volám sa Oleg Alexejev , som technický riaditeľ a spoluzakladateľ MojeSkladu.
Prečo robiť API pre službu
Naši klienti, a to sú desiatky tisíc podnikateľov, aktívne používajú cloudové riešenia: bankovníctvo, internetové obchody, evidovanie tovaru, CRM. Akonáhle sa pripojíte k jednému, ťažko sa zastavíte. A už je tu piata, ôsma, desiata služba, ktorá uľahčuje prácu podnikateľov, ale dáta medzi týmito cloudovými službami musia používatelia prenášať manuálne. Práca sa mení na nočnú moru.
Zjavné riešenie — dať používateľom možnosť prenášať dáta medzi cloudovými službami. Napríklad importovať a exportovať dáta ako súbory, ktoré je možné následne nahrať do požadovanej služby. Súbory sa zvyčajne upravujú podľa formátu každej služby. To je viac-menej jednoduchá manuálna práca, ale s rastom počtu týchto služieb sa to stáva čoraz zložitejším.
Preto ďalší krok — API. S ním cloudová služba vyhráva tým, že spája niekoľko služieb na jednom mieste. Vznik takej ekosystémy priťahuje nových klientov prostredníctvom dodatočných možností. Produkt s novými funkciami sa stáva výhodnejším a užitočnejším.
Ak vytvoríte vlastné programové rozhrania, priťahuje to nezávislých predajcov v podobe programátorov, ktorí poznajú váš produkt vďaka API. Začínajú budovať riešenia na základe ponúknutého API a zarábajú peniaze na automatizácii úloh svojich klientov.
Evidenčný systém MojeSkladu je založený na jednoduchých procesoch. Hlavné je pracovať s primárnymi dokumentmi, mať možnosť realizovať prijatie a odoslanie tovaru, získavať na základe primárnych dokumentov správy pre podnik. Taktiež máme prenos dát, napríklad do cloudového účtovníctva, a ich prijímanie z bankových systémov alebo maloobchodných miest. Ďalej pracujeme s internetovými obchodmi: získavame informácie o tovaroch a zasielame dáta o zásobách.
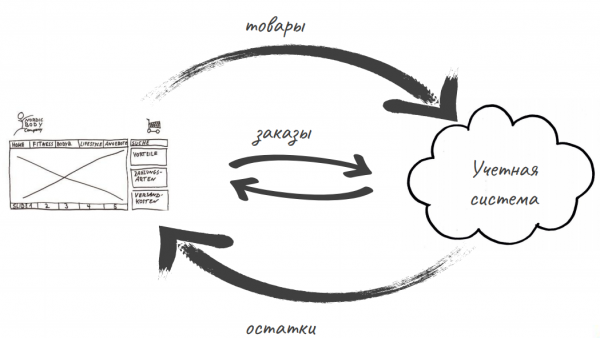
Prvý API MojeSkladu
Po desaťročnej práci MojeSkladu s API sme nadobudli rôzne integrácie, ktoré umožňujú výmenu údajov, prácu s bankami, vykonávanie platieb a využívanie externých telefónnych služieb.
V prvom roku sme umožnili exportovať akékoľvek údaje vo formáte XML. Vtedy bolo pre používateľov oveľa zrozumiteľnejšie a zvyčajnejšie mať údaje v offline režime, než v nejakom oblaku, a my sme im to poskytli. Export sa spúšťal ručným exportom z rozhrania. Takže API sa ešte nedalo nazvať.
V tom čase sme začali spolupracovať so spoločnosťou Rusagro — už používali "dospelú" ERP na plánovanie výroby a predaja, zatiaľ čo nahrávanie vagónov v továrňach automatizovali v MojeSklade. Tak sme dostali prvé základy skutočného API: výmena medzi našou službou a ERP prebiehala zasielaním veľkého súboru s údajmi o všetkých typoch dokumentov.
To bol celkom dobrý variant pre dávkovú výmenu údajov, ale spolu s dokumentmi bolo potrebné prenášať aj ich závislosti: informácie o tovaroch, obchodných partneroch a skladoch. Takúto zmes nie je ťažké vygenerovať pri exporte, ale dosť ťažké ju roztriediť pri importe, pretože v jednom balíku prichádzajú všetky informácie: a o nových dokumentoch, aj o už existujúcich.
Prvý XML API nevydržal dlho — po dvoch rokoch sme začali s jeho prestavbou. Už na začiatku jeho fungovania sme urobili niekoľko chýb pri vytváraní programového rozhrania.
Ako sa robilo XML API: ilustrácia od jedného z našich architektov. Mimochodom, čakajte jeho články.
Tu sú naše hlavné chyby:
- JAXB-označenie bolo vykonané priamo na entity beans. Na komunikáciu s databázou používame Hibernate, a na tie isté bány bolo vykonané JAXB-označenie. Táto chyba sa objavila takmer okamžite: akékoľvek aktualizácie štruktúry údajov viedli k potrebe naliehavo informovať všetkých, ktorí používajú API, alebo k vytvoreniu záplat, ktoré by zabezpečili kompatibilitu s predchádzajúcou štruktúrou údajov.
- API sa vyvinul ako určitá prídavná súčasť, a pôvodne sme nedefinovali, akú časť produktu predstavuje. Ani sme neuvažovali o tom, či je API niečím dôležitým, či by sme mali udržiavať spätnú kompatibilitu pre jeho prvých používateľov. V určitom okamihu predstavovalo množstvo používateľov API približne 5 % z celkového malého počtu, a nevenovali sme im pozornosť. Vytvorená univerzálna filtrácia viedla k tomu, že sme boli vyžívaní ako backend. Táto filtrácia rozhodne nebola GraphQL, ale niečo podobné — fungovala cez množstvo parametrov v dotazovom reťazci. S takou mocnou pomôckou bolo pre používateľov ťažké sa udržať, a nás prepojili tak, že dotazy boli odosielané priamo z UI ich internetových obchodov. Situácia sa stala nepríjemným prekvapením, pretože poskytovanie takejto služby by malo vyžadovať iné tarifné podmienky a vôbec iné pochopenie samotného API ako produktu.
- Keďže API sa nevyvíjalo ako hlavný produkt, dokumentácia k API sa tvorila a publikovala len okrajovo — prostredníctvom reverzného inžinierstva. Takýto prístup sa zdá byť dosť jednoduchý a praktický, ale je v rozpore s prácou na zmluve. To je vtedy, keď existuje nejaká súčasť s prednastaveným spôsobom fungovania. Vývojár ju implementuje podľa tejto schémy a úlohy, súčasť sa testuje, zákazník dostáva produkt, ktorý zodpovedá predstave analytika. Reverzné inžinierstvo však vyhadzuje na trh produkt, ktorý jednoducho existuje: s obmedzeniami, zvláštnymi riešeniami a 'bicyklami' namiesto potrebnej funkcionality.
- Celý prúd žiadostí prichádzajúci cez API bolo možné analyzovať maximálne ako log Nginx alebo aplikačného servera. To neumožňovalo vyčleniť predmetné oblasti, maximálne ich rozdeliť podľa používateľov a predplatiteľov. Ak nie je možné regulovať registráciu aplikácie alebo klientov, analýza situácie sa stáva nemožnou. Tento problém najmenej ovplyvnil vývoj API, viac sa týkal pochopenia jeho dopytu a naplnenia funkčností.
Pok attempt číslo dva: REST API
V roku 2010 sme sa snažili vybudovať systém výmeny s online účtovníctvom – BuchSoftom. Neúspešne. V procese integrácie sa však objavil plnohodnotný API: REST služba výmeny, kde chýbali výnimky ako volania operácií v podobe RPC. Všetka komunikácia s API bola zredukovaná na štandardný spôsob pre REST: v dopyte je názov entity a operácia, ktorá sa s ňou vykonáva, je určená pomocou http-metódy. Pridali sme filtrovanie podľa okamihu aktualizácie entít a užívatelia dostali možnosť nastaviť replikáciu so svojimi systémami.
V tom istom roku sa objavil API na export skladových a tovarových zostatkov. Pre užívateľov sa prostredníctvom API stali dostupné najcennejšie časti systému – výmena primárnych dokumentov a výpočtové údaje o zostatkoch a nákladoch na tovary.
V decembri 2015 RetailCRM zverejnil prvú externú knižnicu na prístup k nášmu API. Stala sa dosť aktívne používanou, pričom rastla popularita služby ako celku, záťaž na API rástla rýchlejšie ako záťaž na webovom rozhraní. Raz sa rast premenil na skok záťaže.
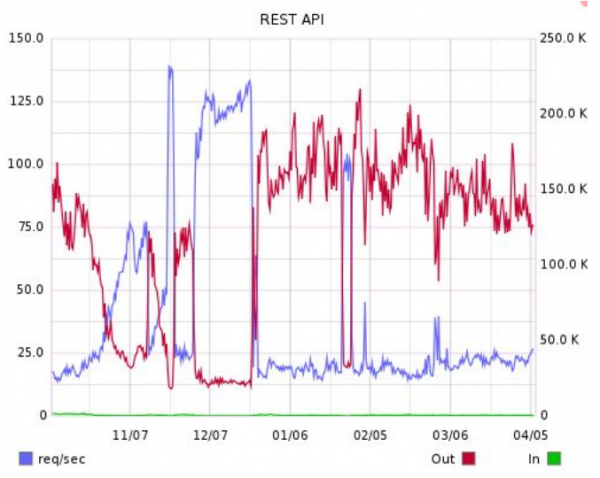
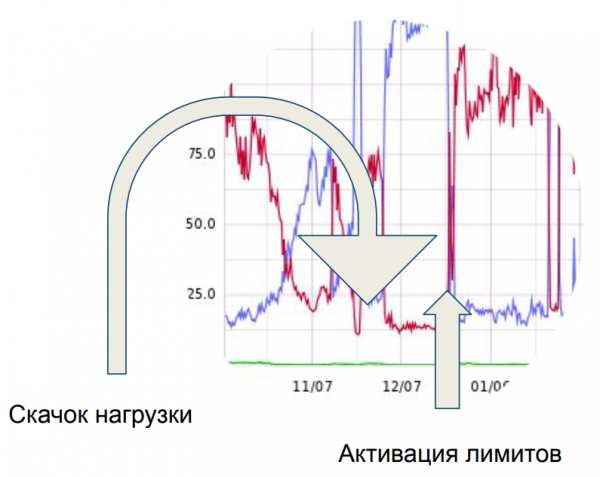
A tento skok, na ktorý ukazuje šípka vľavo, priviedol server obsluhujúci naše API do úplného úžasu. Po dobu jedného týždňa sme zisťovali, čo presne generuje túto záťaž. Ukázalo sa, že ide o tie isté požiadavky, ktoré sú prenášané na naše API z frontov klientov. Všetko to vygenerovalo asi 50 klientov. Tu sme si uvedomili jednu z našich chýb – úplnú absenciu limitov.
Nakoniec sme zaviedli limit na počet súčasných požiadaviek. Z jedného účtu je možné súčasne otvoriť maximálne dva požiadavky. To je dostatočné na prácu v replikácii pre výmenu údajov v dávkovom režime. A tí, ktorí chceli používať nás ako backend, museli od toho momentu viac zodpovedať tarifikácii, pretože sme zaviedli vo svojich programových prostriedkoch prácu s viacerými účtami.
Zarovnávame veci do poriadku
Už od roku 2014 sa dopyt po existujúcom API stal dôležitou súčasťou podnikania, pričom samotný API generoval najväčší objem údajov pri výmene údajov s klientmi. V roku 2015 sme spustili projekt na zarovnanie API do poriadku. Vybrali sme formát JSON namiesto XML a začali sme ho budovať na základe charakteristík, ktoré sme zistili pri realizácii predchádzajúcej verzie:
- Možnosť spravovať verzie. Verzionovanie umožňuje vyvinúť novú verziu bez zasahovania do existujúcej aplikácie a bez narušovania práce používateľov.
- Možnosť pre používateľa vidieť metadata priamo v odpovedi, ktorú dostáva.
- Možnosť výmeny veľkých dokumentov. Ak spracovávame dokument s počtom položiek viac ako 4-5 tisíc, stáva sa to problémom pre server: dlhá transakcia, dlhý http-žiadosť. Vybudovali sme špeciálny mechanizmus, ktorý umožňuje aktualizovať dokument po častiach a spravovať jednotlivé položky tohto dokumentu, ich odosielaním na server.
- Nástroje na replikáciu — boli aj v predchádzajúcej verzii.
- Limity pre zaťaženie — ako dedičstvo problémov, na ktoré sme narazili v predchádzajúcej verzii. Zaviedli sme limity na počet požiadaviek v určitom časovom intervale, počet paralelných požiadaviek a požiadaviek z jednej ip-adresy.
Od tej doby sme vydali dve menšie verzie API a spustili niekoľko špecializovaných API, ale celkovo prístup ostal bez zmien. Aktualizovaný formát výmeny a nová architektúra umožnili rýchlejšie opravovanie nedostatkov v API.
API MojeSkladu dnes
Dnes API MojeSkladu rieši množstvo úloh:
- výmenu dát s e-shopmi, účtovnými systémami, bankami;
- získavanie výpočtových dát, správ;
- používanie ako backend pre klientské aplikácie — naše mobilné aplikácie a desktopová pokladňa fungujú prostredníctvom API
- odosielanie oznámení o zmenách dát v MojeSklade — webhooks;
- telefónia;
- lojalitné systémy.
Na základe API náš generálny riaditeľ Askar Rakhimberdiev za štyri hodiny napísal telegramového bota, ktorý ťahá cez API zvyšky:
Teraz suché čísla.
Tu je naša štatistika k starému REST API:
- 400 spoločností;
- 600 používateľov;
- 2 milióny požiadaviek denne;
- 200 GB/deň odchádzajúcej prevádzky.
A tu je to, čo sme dosiahli so všetkými API MojeSkladu:
- viac ako 70 integrácií (časť z nich si môžete pozrieť tu );
- 8500 spoločností;
- 12 000 používateľov;
- 46 miliónov požiadaviek denne;
- 2 TB/deň odchádzajúcej prevádzky.
Čo ďalej
Plány na rozvoj API sú v aktívnej diskusii. Snažíme sa zohľadniť skúsenosti s prevádzkovaním, ktoré nám poskytujú užívatelia. Nie vždy a nie všetko môžeme urobiť hneď, ale nová verzia API s prehľadnejšími metadátami a menej zložitou štruktúrou, ako aj OAuth pre autentifikáciu, je na dosah, vrátane API pre integrované aplikácie.
Novinky môžete sledovať na špeciálnej stránke pre vývojárov integrácií s MoimSkladom: .
Zdroj: habr.com
