

Keď hovoríme o steganografii, ľudia si predstavia teroristov, pedofilov, špiónov, v najlepšom prípade kriptoanarchistov a podobných vedcov. A naozaj, komu inému by to ešte mohlo byť potrebné? skryť niečo pred vonkajším pohľadom? Aký môže mať z toho prospech obyčajný človek?
Odkazuje sa na to, že nejaký úžitok predsa je. Práve preto sa dnes budeme zaoberať kompresiou dát pomocou steganografických metód. A na konci bude môcť čitateľ dokonca využiť svoje cenné fotoarchívy vo formáte JPEG na zvýšenie voľného miesta na súborovom systéme.
Čo?
Ak si čitateľ pamätá, steganografia sú podivné algoritmy, ktoré umožňujú skryť existenciu jednej informácie vo vnútri inej. Jednoduchšie povedané: obrázok + súbor == približne ten istý obrázok, len nie celkom (môže to byť čokoľvek iné, ale zvyčajne je to jasnejšie na obrázkoch). A nemalo by byť jednoduché určiť, či je niečo vo vnútri alebo nie.
Ale ak nie je možné rozlíšiť jedno od druhého, je vôbec nejaký rozdiel? Z pohľadu spotrebiteľa používateľa ho nezaujímajú matematické presnosti (odrážajúce sa konkrétnou sadou bitov), ale len to, čo vníma.
Napríklad sa pozrime na tri obrázky roztomilého psa:
Pozor, JPEG!
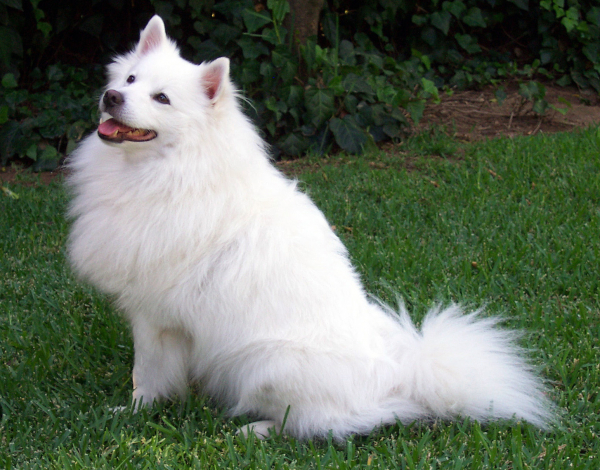
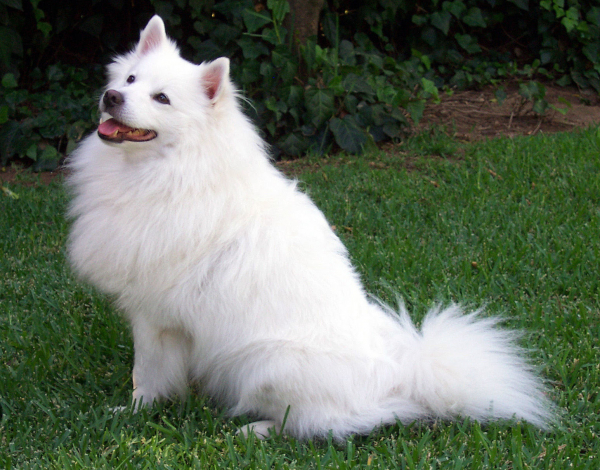
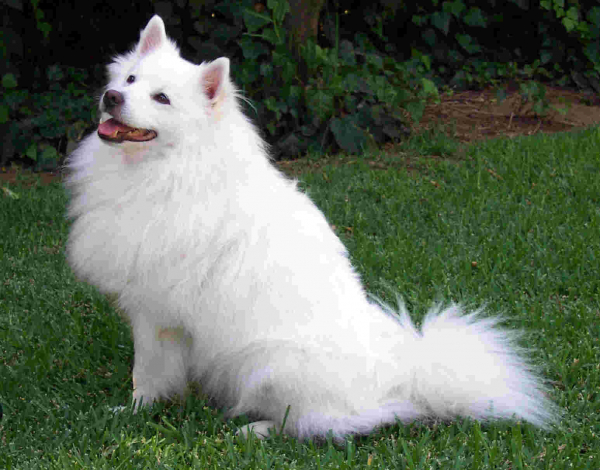
Napriek obrovskej rozdielu vo veľkosti si málokto vyberie tretiu verziu. Na druhej strane, rozdiel medzi prvými dvoma fotografiami nie je taký viditeľný, a množstvo informácií v nich (z môjho pohľadu) sa dá vyrovnať.
Sám o sebe tento princíp je už starý a roky sa aktívne využíva metódami kompresie informácií s odpadmi. Ale demolovať — nie stavať, zaujíma nás pokročilejšia strana problému. Môže sa dodatočná informácia veľkosti N vložiť do súboru tak, aby sa jeho veľkosť zvýšila o M < N, a zmeny neboli používateľovi viditeľné?
Samozrejme, že áno. Ale mali by sme hneď urobiť niekoľko rezervácií:
- Po prvé, metóda by mala byť univerzálna a mala by prinášať pozitívny výsledok pri väčšine vstupných údajov. Teda v priemere by sa malo efektívne zmenšovať uchovávané množstvo informácií. „V priemere“ znamená, že protikladné prípady sa môžu vyskytnúť, ale nemali by prevládať.
- Po prvé, veľkosť komprimovanej nádoby pred zakomponovaním informácií by mala byť väčšia než komprimovaná verzia jeho modifikácie. Jednoduché zakomponovanie hromady bitov do BMP obrázka pomocou metódy LSB nie je steganografická kompresia, pretože po spracovaní pomocou DEFLATE pravdepodobne bude pôvodný obrázok oveľa menší.
- Po tretie, výsledky by sa mali porovnávať s už komprimovanými dátami podľa klasických metód. To umožní odstrániť pravdepodobnostný efekt rozlíšení ich redundancie a vykonať efektívnejšiu kompresiu v obecných prípadoch.
Kde?
Použitie steganografie predpokladá, že okrem komprimovanej informácie budeme potrebovať nádoby, do ktorých bude zakomponovaná. Maximálne množstvo zakomponovanej informácie do značnej miery závisí od jednotlivých vlastností, ale oveľa jednoduchšie sa škáluje s ich počtom. Preto by formát nádob mal byť rozšírený, aby mal používateľ dostatočné množstvo pre získanie aspoň nejakého užitku z procesu "kompresie".
V tomto kontexte sú dobrou voľbou grafické, audio- a video súbory. Avšak, kvôli rôznym formátom, kodekom a podobne, na praktickej úrovni zostáva voľba z nie tak veľkého počtu možností.
S ohľadom na všetko toto, moja voľba padla na JPEG, ktorý má takmer každý, široko sa používa ako na osobné, tak aj na obchodné účely a je takmer de-facto formátom pre väčšinu obrázkov.
Kedy? Ako?
Ďalej nasledujú okrajové a technické schémy a opisy bez osobitných vysvetlení, takže záujemcovia ich môžu preskočiť prechádzaním na sekciu "Vysoké technológie".
Všeobecné znaky
Aby ste mohli zakomponovať dáta niekam, musíte najprv určiť, kam. Na súborovom systéme môže existovať neobmedzené množstvo rôznych fotografií, medzi ktorými si používateľ môže zvoliť len niektoré. Toto požadované množstvo nádob budeme nazývať knižnicou.
Vytvára sa v dvoch prípadoch: pred kompresiou a pred rozbalením. V prvom prípade je možné jednoducho použiť súbor názvov (alebo lepšie, regulárny výraz pre ne) súborov, ale v druhom prípade je potrebné niečo spoľahlivejšie: používateľ môže kopírovať a presúvať ich v rámci súborového systému, čo znemožňuje ich správne určenie. Preto je potrebné uchovávať ich hash (md5 by malo stačiť) po vykonaní všetkých úprav.
Pôvodné vyhľadávanie pomocou regulárneho výrazu nemá zmysel vykonávať v celom FS, stačí určiť nejaký koreňový adresár. Do neho sa uložia špeciálny archívny súbor, v ktorom sa budú nachádzať tie hashe, spolu s inými metainformáciami potrebnými pre následné obnovovanie komprimovaných informácií.
To všetko sa rovnako vzťahuje na akúkoľvek implementáciu akéhokoľvek algoritmu steganografickej kompresie dát. Samotné procesy kompresie a obnovovania dát môžeme nazývať balením a rozbalením.
F5
Teraz, keď sa stalo jasné, čo robíme a prečo, zostáva opísať samotný algoritmus dosiahnutia cieľa. Spomeňme na proces kódovania JPEG súboru (ďakujeme wiki Národnej knižnice mena Baumana):
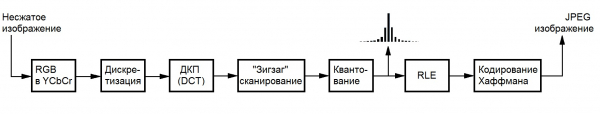
Pri pohľade na neho je lepšie hneď urobiť niekoľko poznámok:
- Veľkosť JPEG súboru môžeme považovať za optimálnu, ani nemusíme skúšať kompresiu nejakým WinRAR-om;
- Môžeme meniť iba uložené informácie (tú, ktorá je na výstupe diskrétneho kosínusového transformovania, DCT), aby sme zabezpečili aspoň akú-takú prijateľnú výkonnosť.
- Aby sme nestratili údaje v nápadných rozsahoch pre používateľa, je potrebné vykonať minimálne úpravy v každom jednotlivom obrázku;
Pre tieto podmienky vyhovuje celé rodina algoritmov, s ktorými sa môžete oboznámiť . Najpokročilejší z nich je algoritmus od Andeasa Westfelda, ktorý pracuje s koeficientmi DCT komponentu jasu (ľudské oko je najmenej citlivé práve na tieto zmeny). Jeho všeobecný diagram pri práci so existujúcim JPEG súborom sa zobrazuje nasledujúcou schémou:
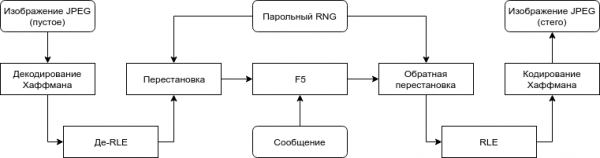
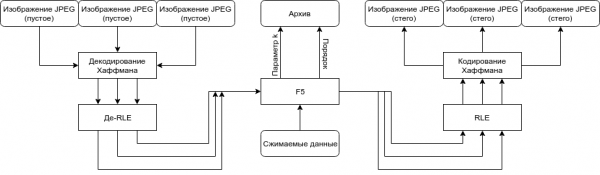
Blok F5 používa pokročilú metódu vloženia založenú na kódovaní matice. Podrobnejšie informácie o nej a o samotnom algoritme si môže čitateľ prečítať v odkaze vyššie, ale nás primárne zaujíma fakt, že s jeho pomocou je možné uskutočniť tým menej zmien pri vkladaní rovnakého množstva informácií, čím väčšia je veľkosť použitého kontajnera. Na vykonanie samotného algoritmu stačí vykonať len jednoduché operácie (de)kódovania Huffmanom a RLE.
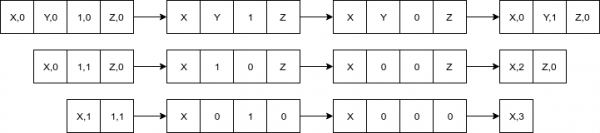
Samotné zmeny sa pritom vykonávajú na celočíselných koeficientoch a spočívajú v znížení ich absolútnej hodnoty o jednu, čo umožňuje v podstate použiť F5 na kompresiu dát. V skutočnosti znížený koeficient s menšou absolútnou hodnotou pravdepodobne zaberie menej bitov po vykonaní kódovania Huffmanom z dôvodu štatistického rozdelenia hodnôt v JPEG.
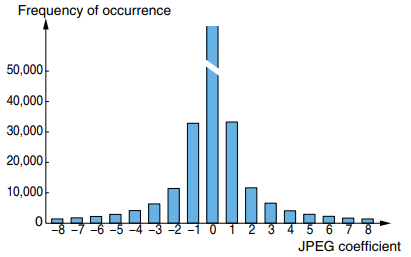
V prípade vzniku nuly (tzv. skrátenia) sa množstvo uložených informácií zníži o jej veľkosť, pretože bývalý samostatný koeficient sa stane súčasťou zakódovanej RLE sekvencie núl:
Modifikácie
Ochrana dát a ich kompresia sú ortogonálne úlohy, preto je možné zanedbať tajnú heslovú permutáciu z originálneho algoritmu. Okrem toho potrebujeme presne vedieť, ako extrahovať údaje, takže všetky potrebné informácie (aký kontajner bol použitý, v akom poradí a pod.) musia byť zaznamenané do samostatného súboru a byť otvorené na voľné čítanie archivačom.
Originálny algoritmus je navrhnutý na prenos tajných správ, a preto pracuje naraz iba s jedným kontajnerom, pričom predpokladá, že používateľ si ho rozdelí na časti podľa potreby, ak to vôbec nastane. Okrem toho pri nezávislom vkladaní do každého kontajnera bude potrebné vopred vedieť, koľko bitov dát vložiť do každého. Preto by sa koeficienty každého prvku knižnice mali spojiť do jedného abstraktného veľkého a pracovať s ním podľa pôvodného algoritmu.
Keďže originálny F5 umožňuje využiť až 12 % veľkosti kontajnera, táto modifikácia tiež zvýši maximálnu kapacitu: „až 12 %“ z veľkosti celej knižnice je väčšie alebo rovné súčtu „až 12 %“ z každého z jej prvkov.
Kodifikovaná celková schéma vyzerá nasledovne:
Samotný algoritmus
Teraz je čas opísať samotný algoritmus od začiatku do konca, aby som čitateľa nenechal v nevedomosti:
- Používateľ definuje binárne kompresibilné dáta M a knižnicu L pomocou regulárneho výrazu a koreňového adresára hľadania;
- V poradí na FS prvky knižnice tvoria MC:
- Z údajov súboru sa dekóduje séria koeficientov C;
- MC <- MC | C;
- Parametre k sa určuje na základe hrozného nerovnostného vzťahu:
|M| * 8 /(count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Po jednom sa berie
n = (1 << k) - 1najmladších bitov nez nulových prvkov z MC a zapisuje sa doa:- Počítajú sa magické hash funkcie
f, mapujúci n-bitové slovoado k-bitovéhos; - Ak
s == 0, a ak nie je potrebné nič meniť, algoritmus prechádza k nasledujúcim koeficientom; - Znížiť absolútnu hodnotu koeficientu, ktorý je zodpovedný za
s-ty bit v slovea; - Ak v dôsledku zníženia došlo k skráteniu (koeficient sa stal 0), tak zopakovať krok od začiatku;
- Počítajú sa magické hash funkcie
- Všetky koeficienty sú kódované RLE a Huffmanom, zapisujú sa do pôvodných súborov;
- Do súboru archívu sa zapisuje parameter k;
- Z každého súboru L v poradí ich pôvodného výskytu sa počíta MD5 hash a zapisuje sa do súboru archívu.
Vysoké technológie
Naivná forma algoritmu a implementácia v iných vysokoúrovňových (najmä s garbage collection) jazykoch by poskytla hrozné výkony, takže všetky tieto zložitosti som realizoval v čistom C a vykonal rad optimalizácií ako po rýchlosti vykonávania, tak aj po pamäti (nepovedali by ste, koľko tieto obrázky vážia bez kompresie aj po DCT). Ale aj tak, na začiatku rýchlosť vykonávania nechávala naozaj veľa želať, preto nebudem popisovať celý proces a použité metódy.
Kroz-platformovosť bola dosiahnutá použitím kombinácie knižníc libjpeg, pcre a tinydir, za čo im ďakujem. Predvolene sa všetko kompiluje prostredníctvom bežného make, takže používatelia Windows by si mali nainštalovať nejaký Cygwin, alebo sa vysporiadať s Visual Studio a knižnicami sami.
Realizácia je dostupná vo forme konzolovej utilitky a knižnice. O jej využití sa môžu záujemcovia dozvedieť viac v README v repozitári na GitHube, ktorého odkaz priložím na konci príspevku. Teraz prejdime k popisu a demonštrácii funkcie.
Ako použiť?
S opatrnosťou. Použité obrázky je možné presúvať, premenovávať a kopírovať podľa potreby. Je však dôležité byť mimoriadne opatrný a nijako ich nemeniť. Zmena jedného bitu povedie k narušeniu hash a nemožnosti obnoviť informácie.
Nech po kompilácii získame spustiteľný súbor f5ar. Môžeme analyzovať veľkosť knižnice na určenie možností jej využitia pomocou príznaku -a: ./f5ar -a [adresár na vyhľadávanie] [Perl-kompatibilný regulárny výraz]. Balenie sa vykonáva príkazom ./f5ar -p [adresár na vyhľadávanie] [Perl-kompatibilný regulárny výraz] [balený súbor] [názov archívu], a rozbalenie pomocou ./f5ar -u [archívový súbor] [názov obnoveného súboru].
Demonštrácia funkcie
Aby som preukázal účinnosť metódy, nahral som zbierku 225 úplne bezplatných fotografií psov zo služby . Každá z nich má o niečo vyššiu kvalitu, než bežné užívateľské fotografie, no aj tak. Každá z nich bola prekonvertovaná pomocou libjpeg, aby sa zrušil vplyv špecifík kódovania knižnice na celkovú veľkosť. Pre označenie najhoršieho príkladu komprimovaných dát bol pomocou dd vygenerovaný náhodný súbor s veľkosťou 36 metrov (niečo málo viac ako 5% z celkovej veľkosti) rovnomerne rozdelený.
Proces testovania je dosť jednoduchý:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ ./f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Načítanie komprimovacieho súboru... ok
Inicializácia archívu... ok
Analýza kapacity knižnice... hotovo za 16.8s
Zistená zhruba garantovaná kapacita 48439359 bajtov
Zistená možná kapacita až 102618787 bajtov
Komprimovanie... hotovo za 32.6s
Uloženie archívu... ok

$ ./f5ar -u dogs/dogs.f5ar unpacked
Inicializácia archívu... ok
Načítanie archívového súboru... ok
Naplnnenie archívu súbormi... hotovo za 1.2s
Rozbaľovanie... hotovo za 17.5s
Písanie extrahovaných dát... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Alebo screenshot pre milovníkov
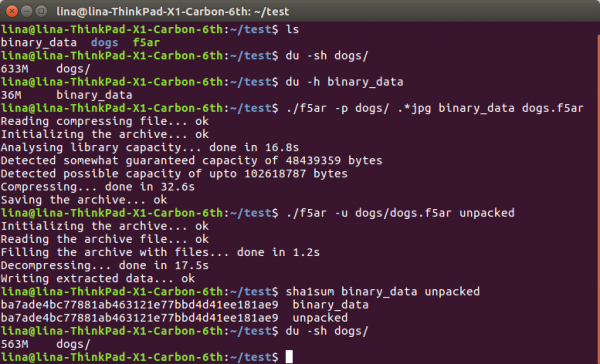
Ako vidieť, z počiatočných 633 + 36 == 669 megabajtov dát na pevnom disku sme sa dostali na prijateľnejších 563, čo nám dáva kompresný pomer ~1,188. Taká radikálna odlišnosť je vysvetlená veľmi malými stratami, podobne ako pri optimalizácii JPEG súborov klasickými metódami (ako napríklad tinyjpg). Samozrejme, pri používaní steganografickej kompresie sa informácie nielen "strácajú", ale sú využívané na kódovanie iných dát. Navyše, počet "optimalizovaných" koeficientov vďaka použitiu F5 je oveľa menší než pri tradičnej optimalizácii.
Akékoľvek modifikácie nie sú pre oko vôbec postrehnuteľné. Pod spoilerom nižšie si čitateľ môže porovnať rozdiel, ako je vidno, tak aj získaný odčítaním hodnôt modifikovanej zložky z originálnej (čím je farba menej výrazná, tým je rozdiel menší):
Odkazy na obrázky, ktoré sa nezmestili na habrastorage
Originál —
Modifikovaný —
Rozdiel —
Na záver
Dúfam, že som čitateľa presvedčil, že takéto metódy sú možné a zaslúžia si existovať. Napriek tomu môže byť kúpa pevného disku alebo dodatočného kanála (na sieťový prenos) omnoho jednoduchším riešením, než sa snažiť šetriť týmto spôsobom. Na jednej strane je to naozaj tak, extenzívny rozvoj je často jednoduchší a spoľahlivejší. Na druhej strane, nemali by sme zabúdať na intenzívne. Predsa len nie sú žiadne záruky, že zajtra si môžeme ísť do obchodu kúpiť ďalší pevný disk s tisíckou terabajtov, ale už ležiace doma sa dajú využiť vždy.
->
Zdroj: habr.com
