

V sme sa podelili o pokusy použiť Watcher a predstavili sme správu z testovania. Takéto testovanie vykonávame pravidelne pre vyvažovanie a ďalšie kritické funkcie veľkého podnikového alebo operátorského cloudu.
Vysoká zložitost úlohy môže vyžadovať niekoľko článkov na popis nášho projektu. Dnes zverejňujeme druhý článok cyklu, ktorý je venovaný vyvažovaniu virtuálnych strojov v cloude.
Trochu terminológie
Spoločnosť VmWare zaviedla nástroj DRS (Distributed Resource Scheduler) na vyvažovanie zaťaženia vo vlastnom vývoji a ponuke virtualizačného prostredia.
Ako píše
„VMware DRS (Plánovač distribuovaných zdrojov) je nástroj, ktorý vyvažuje počítačové zaťaženia s dostupnými zdrojmi vo virtuálnom prostredí. Tento nástroj je súčasťou balíka virtualizácie nazvaného VMware Infrastructure.
S pomocou VMware DRS určujú používatelia pravidlá rozdelenia fyzických zdrojov medzi virtuálne stroje (VM). Nástroj môže byť nastavený na manuálne alebo automatické riadenie. Zdroje VMware môžu byť ľahko pridávané, odstraňované alebo reorganizované. Ak je to potrebné, zdroje môžu byť oddelené medzi rôznymi obchodnými jednotkami. Ak sa pracovné zaťaženie na jednom alebo viacerých virtuálnych strojoch dramaticky mení, VMware DRS presúva virtuálne stroje medzi fyzickými servermi. Ak sa celkové pracovné zaťaženie znižuje, niektoré fyzické servery môžu byť dočasne vypnuté a pracovné zaťaženie zjednotené.“
Prečo je vyvažovanie potrebné?
Podľa nášho názoru je DRS povinnou funkciou cloudu, hoci to neznamená, že DRS je potrebné používať vždy a všade. V závislosti od účelu a potrieb cloudu môžu existovať rôzne požiadavky na DRS a metódy vyvažovania. Možno existujú situácie, keď vyvažovanie nie je vôbec potrebné. Alebo je dokonca škodlivé.
Aby sme lepšie pochopili, kde a pre akých klientov je DRS potrebné, zvážme ich ciele a úlohy. Cloudu môžeme rozdeliť na verejné a súkromné. Tu sú hlavné rozdiely týchto cloudov a cieľov klientov.
Súkromné cloudu / Veľkí korporátni klienti
Verejné cloudu / Stredný a malý biznis, jednotlivci
Hlavný kriterium a ciele operátora
Poskytovanie spoľahlivej služby alebo produktu
Zníženie nákladov na služby v súťaži na konkurenčnom trhu
Požiadavky na službu
Spoľahlivosť na všetkých úrovniach a vo všetkých prvkoch systému
Zaručený výkon
Prioritizácia virtuálnych strojov do niekoľkých kategórií
Informačná a fyzická bezpečnosť údajov
SLA a 24/7 podpora
Maximálna jednoduchost získania služby
Relatívne jednoduché služby
Zodpovednosť za údaje leží na zákazníkovi
Prioritizácia VM nie je potrebná
Informačná bezpečnosť na úrovni štandardných služieb, zodpovednosť na zákazníkovi
Môžu nastať výpadky
Žiadne SLA, kvalita nie je zaručená
Podpora cez e-mail
Zálohovanie nie je povinné
Zvláštnosti zákazníka
Veľmi široké spektrum aplikácií.
Legacy aplikácie, zdedené v spoločnosti.
Zložité prispôsobené architektúry pre každého zákazníka.
Affinity pravidlá.
Prevádzka softvéru bez prestávky v režime 7x24.
Prostriedky zálohovania „za behu“.
Predvídateľná cyklická záťaž zákazníka.
Štandardné aplikácie – vyvažovanie siete, Apache, WEB, VPN, SQL
Môže dôjsť k dočasnému zastaveniu aplikácie
Povoľuje sa náhodné rozdelenie VM v cloude
Zálohovanie silami zákazníka
Predvídateľná pri veľkom počte zákazníkov štatisticky priemerná záťaž.
Dôsledky pre architektúru
Geo-klasifikácia
Centralizovaný alebo distribuovaný úložný systém
Zálohované SRK
Lokálne ukladanie údajov na výpočtových uzloch
Ciele vyvažovania
Úmerné rozdelenie záťaže
Maximálna odozva aplikácií
Minimálna oneskorenie pri vyvažovaní
Vyvažovanie len v prípade zjavnej potreby
Vyvedenie časti vybavenia na preventívnu údržbu
Zníženie nákladov na služby a nákladov operátora
Odpojenie časti zdrojov v prípade nizkej záťaže
Úspora elektrickej energie
Zníženie nákladov na personál
Pre seba robíme nasledujúce závery:
Pre súkromné cloudu, poskytované veľkým korporátnym zákazníkom, DRS môže byť aplikované s ohľadom na obmedzenia:
- informačná bezpečnosť a zohľadnenie pravidiel affinity pri vyvažovaní;
- existencia dostatočného objemu rezervných zdrojov v prípade havárie;
- údaje virtuálnych strojov sú uložené na centralizovanej alebo distribuovanej úložnej sústave;
- rozloženie časových procedúr správy, zálohovania a vyrovnávania záťaže;
- vyrovnávanie len v rámci aglomerácie hostiteľov klienta;
- vyrovnávanie len pri výraznom nevyvážení, najúčinnejšie a najbezpečnejšie migrácie VM (migrácia môže skončiť neúspešne);
- vyrovnávanie s ohľadom na "pokojné" virtuálne stroje (migrácia "hlučných" virtuálnych strojov môže trvať veľmi dlho);
- vyrovnávanie s ohľadom na "náklady" — záťaž na úložnú sústavu a sieť (pri prispôsobených architektúrach pre veľkých klientov);
- vyrovnávanie so zohľadnením individuálnych charakteristík správania každého VM;
- vyrovnávanie je žiaduce vykonávať v nepracovnom čase (noc, víkendy, sviatky).
Pre verejné cloudu, poskytujúce služby malým zákazníkom, DRS môže byť aplikované oveľa častejšie, s rozšírenými funkciami:
- absencia obmedzení informačnej bezpečnosti a afinity pravidiel;
- vyrovnávanie v rámci cloudu;
- vyrovnávanie v akomkoľvek rozumnom čase;
- vyrovnávanie akéhokoľvek VM;
- vyrovnávanie "hlučných" virtuálnych strojov (aby sa nezabránilo ostatným);
- údaje virtuálnych strojov sa často nachádzajú na lokálnych diskoch;
- zohľadnenie priemernej výkonnosti úložnej sústavy a siete (architektúra cloudu je jednotná);
- vyrovnávanie podľa zovšeobecnených pravidiel a dostupnej štatistiky správania dátových centier.
Zložitost problému
Zložitost vyrovnávania spočíva v tom, že DRS musí pracovať s veľkým množstvom nejasných faktorov:
- správanie používateľov každého z informačných systémov klientov;
- algoritmy fungovania serverov informačných systémov;
- správanie serverov databázových systémov;
- záťaž na výpočtové zdroje, úložnú sústavu, sieť;
- interakcia serverov navzájom v boji o zdroje cloudu.
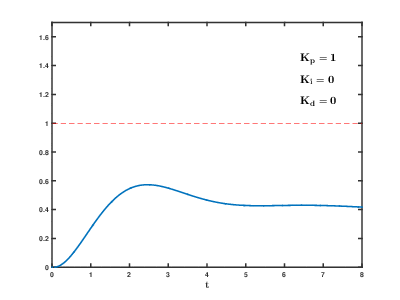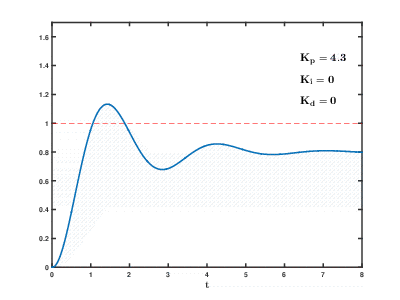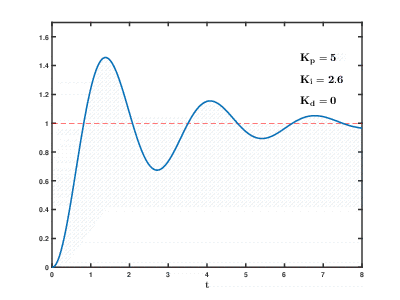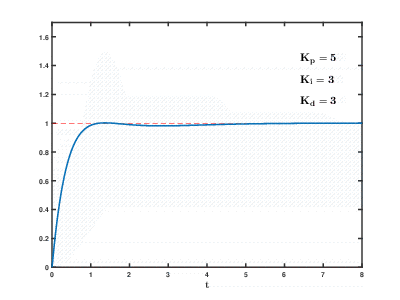
Záťaž veľkého počtu virtuálnych aplikácií a databázových serverov na zdroje cloudu sa vyvíja v čase, následky môžu byť prejavované a prekryté vzájomne s nepredvídateľným efektom v nepredvídateľnom čase. Aj pri riadení relatívne jednoduchých procesov (napríklad riadenie motora, systém vodného vykurovania domu) je potrebné, aby systémy automatického regulovania používali zložité. algoritmy s spätnou väzbou.
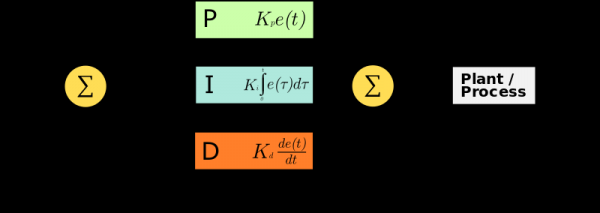
Naša úloha je o mnoho poriadkov zložitejšia a existuje riziko, že systém nebude schopný vyvážiť záťaž na stabilné hodnoty v rozumnom čase, aj keď nebudú existovať vonkajšie podnety zo strany používateľov.
História našich vývojov
Na vyriešenie tohto problému sme sa rozhodli nezačať od nuly, ale vychádzať z existujúcich skúseností a začali sme spolupracovať s odborníkmi, ktorí majú v tejto oblasti skúsenosti. Našťastie sa naše pochopenie problematiky úplne zhodovalo.
Fáza 1
Využili sme systém založený na technológii neurónových sietí a pokúsili sme sa na jeho základe optimalizovať naše zdroje.
Záujem tejto fázy spočíval v overovaní novej technológie a jeho dôležitosť v aplikácii netradičného prístupu k riešeniu úlohy, kde pri iných rovnakých podmienkach štandardné prístupy takmer vyčerpali sami seba.
Spustili sme systém a skutočne sa začala vyváženosť. Veľkosť našej cloudu nám neumožnila dosiahnuť optimistické výsledky, ktoré uvádzali vývojári, ale bolo jasné, že vyváženie funguje.
Pri tom sme mali aj dostatočne vážne obmedzenia:
- Na školenie neurónovej siete je potrebné, aby virtuálne stroje pracovali bez podstatných zmien po týždne alebo mesiace.
- Algoritmus je navrhnutý na optimalizáciu na základe analýzy skôr získaných "historických" údajov.
- Na školenie neurónovej siete je potrebný dostatočne veľký objem údajov a výpočtových zdrojov.
- Optimalizáciu a vyváženie je možné robiť relatívne zriedka – raz za niekoľko hodín, čo je zjavne nedostatočné.
Fáza 2
Keďže nás nezaujímalo súčasné postavenie, rozhodli sme sa modifikovať systém a na to, aby sme odpovedali na hlavnú otázku – pre koho to robíme?
Najskôr – pre firemných klientov. Znamená to, že potrebujeme systém, ktorý funguje rýchlo, s tými firemnými obmedzeniami, ktoré iba zjednodušujú implementáciu.
Druhá otázka – čo chápať pod pojmom "rýchlo"? Po krátkych debatách sme sa rozhodli, že môžeme vychádzať z doby odozvy 5 – 10 minút, aby krátkodobé výkyvy neviedli systém do rezonancie.
Tretia otázka – akú veľkosť vyváženého počtu serverov si vybrať?
Toto otázka sa vyriešila sama. Zvyčajne klienti nevytvárajú veľmi veľké agregáty serverov, čo zodpovedá odporúčaniam z článku obmedziť agregáty na 30-40 serverov.
Okrem toho segmentovaním serverového poolu zjednodušujeme úlohu vyvažovacieho algoritmu.
Štvrtá otázka – ako veľmi nám vyhovuje neurónová sieť s jej dlhým procesom učenia a zriedkavým vyvažovaním? Rozhodli sme sa vzdať sa jej v prospech jednoduchších operatívnych algoritmov, aby sme dosahovali výsledky za sekundy.
S popisom systému, ktorý využíva také algoritmy a jeho nevýhodami, sa môžete oboznámiť
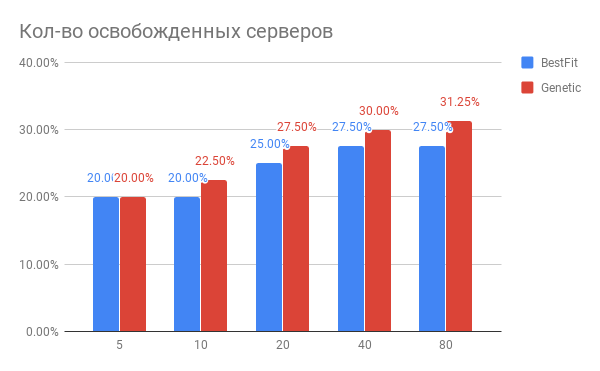
Implementovali sme a spustili tento systém a dosiahli sme povzbudzujúce výsledky – teraz pravidelne analyzuje záťaž cloudu a dáva odporúčania na presun virtuálnych strojov, ktoré sú do značnej miery správne. Už teraz je jasné, že môžeme dosiahnuť 10-15% uvoľnenia zdrojov pre nové virtuálne stroje s zlepšením kvality práce existujúcich.
Pri zistení nerovnováhy v RAM alebo CPU systém dáva príkazy plánovaču Tionix na vykonanie živého migrácie požadovaných virtuálnych strojov. Ako je vidieť zo systému monitorovania, virtuálny stroj sa presunul z jedného (horného) na druhý (dolný) hostiteľ a uvoľnil pamäť na hornom hostiteľovi (vyznačené žltými kruhmi), pričom ju obsadil na dolnom (vyznačené bielymi kruhmi).
Teraz sa snažíme presnejšie posúdiť efektívnosť fungujúceho algoritmu a snažíme sa nájsť v ňom možné chyby.
Fáza 3
Na prvý pohľad sa zdá, že sa môžeme upokojiť, počkať na preukázanú efektívnosť a uzavrieť tému.
Ale k novému kroku nás podnecujú nasledujúce zjavné možnosti optimalizácie
- Štatistiky, napríklad, a ukazujú, že dvoj- a štvorprocesorové systémy sú svojím výkonom zásadne nižšie ako jednoprosesorové. To znamená, že všetci používatelia majú z kúpenej viacprocesorovej CPU, RAM, SSD, LAN, FC podstatne menší výkon v porovnaní s jednoprosesorovými.
- Sami plánovači zdrojov môžu pracovať s vážnymi chybami, na túto tému.
- Technológie monitorovania RAM a cache, ktoré ponúkajú spoločnosti Intel a AMD, umožňujú skúmať správanie virtuálnych strojov a umiestňovať ich tak, aby „hlasití“ susedia neprekážali „pokojným“ virtuálnym strojom.
- Rozšírenie súboru parametrov (sieť, úložisko, priorita virtuálneho stroja, náklady na migráciu, jej pripravenosť na migráciu).
Spolu
Výsledkom našej práce na zlepšení algoritmov vyvažovania je jednoznačný záver, že pomocou moderných algoritmov môžete dosiahnuť významnú optimalizáciu zdrojov (25-30%) dátových centier a zvýšiť tým kvalitu služieb pre zákazníkov.
Algoritmus založený na neurónových sieťach je bezpochyby zaujímavým, ale potrebujúcim ďalší rozvoj riešením, a vzhľadom na existujúce obmedzenia nie je vhodným pre riešenie takýchto úloh na objemoch typických pre privátne cloudy. V súkromných cloudoch však algoritmus dosiahol naozaj dobré výsledky.
Podrobnejšie o možnostiach procesorov, plánovačov a vysokoúrovňového vyvažovania sa dozviete v ďalších článkoch.
Zdroj: habr.com
