

Zdroj:
Lineárna regresia je jedným z základných algoritmov pre mnohé oblasti súvisiace s analýzou dát. Dôvod je zrejmý. Je to veľmi jednoduchý a zrozumiteľný algoritmus, čo podporuje jeho široké použitie už celé desaťročia, ak nie storočia. Myšlienka spočíva v tom, že predpokladáme lineárnu závislosť jednej premennej od súboru ďalších premenných a následne sa snažíme túto závislosť obnoviť.
Ale v tomto článku sa nebude hovoriť o použití lineárnej regresie na riešenie praktických úloh. Tu budú preskúmané zaujímavé vlastnosti implementácie distribuovaných algoritmov jej obnovy, s ktorými sme sa stretli pri písaní modulu strojového učenia v . Trochu základnej matematiky, základov strojového učenia a distribuovaných výpočtov pomôže pochopiť, ako obnoviť lineárnu regresiu, aj keď sú dáta rozdelené medzi tisíckami uzlov.
O čom je reč?
Máme pred sebou úlohu obnovy lineárnej závislosti. Ako vstupné údaje sa poskytuje množstvo vektorov predpokladane nezávislých premenných, ktorým je priradená nejaká hodnota závislej premennej. Tieto údaje môžeme predstaviť vo forme dvoch matíc:

Teraz, keď predpokladáme závislosť, a navyše aj lineárnu, zapíšeme naše predpoklady vo forme súčinu matíc (pre zjednodušenie zápisu sa tu a ďalej predpokladá, že voľný člen rovnice je skrytý za  , a posledný stĺpec matice
 obsahuje jedničky):

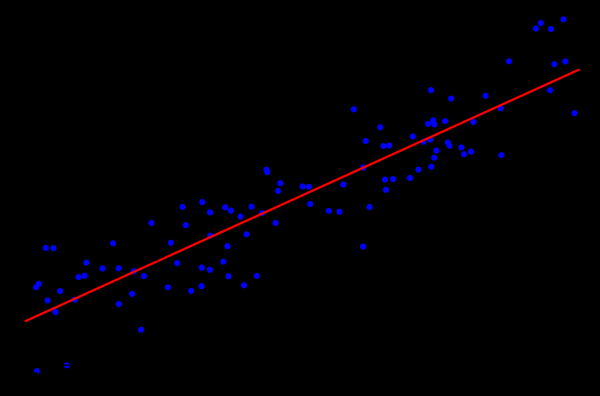
Veľmi podobné systému lineárnych rovníc, že? Vyzerá to tak, ale riešení tohto systému rovníc pravdepodobne nebude. Príčinou je šum, ktorý sa vyskytuje prakticky v akýchkoľvek reálnych dátach. Ďalšou príčinou môže byť absencia lineárnej závislosti ako takej, s ktorou sa snažíme bojovať zavedením ďalších premenných, ktoré sú nelineárne závislé od pôvodných. Pozrime sa na nasledovný príklad:
Zdroj:
Toto je jednoduchý príklad lineárnej regresie, ktorý demonštruje závislosť jednej premennej (po osi  ) od druhej premennej (po osi
 ). Aby systém lineárnych rovníc zodpovedajúci tomuto príkladu mal riešenie, všetky body musia ležať presne na jednej priamke. Ale to nie je tak. A nelezú na jednej priamke práve kvôli šumu (alebo preto, že predpoklad o existencii lineárnej závislosti bol chybný). Aby sa teda obnovila lineárna závislosť z reálnych údajov, zvyčajne je potrebné zaviesť ešte jedno predpoklad: vstupné údaje obsahujú šum a tento šum má . Môžeme robiť predpoklady aj o iných typoch rozdelenia šumu, ale vo väčšine prípadov sa zvažuje práve normálne rozdelenie, o ktorom bude ďalej reč.
Metóda maximálnej pravdepodobnosti
Takže sme predpokladali existenciu náhodne normálne rozdeleného šumu. Ako sa teda máme v tejto situácii? Na tento prípad v matematike existuje a široko sa používa . Ak to zhrnieme, jej podstata spočíva vo výbere a jej následnej maximalizácii.
Vráťme sa k obnoveniu lineárnej závislosti z dát s normálnym šumom. Poznamenajme, že predpokladaná lineárna závislosť je matematickým očakávaním  existujúceho normálneho rozdelenia. Zároveň pravdepodobnosť toho, že
 berie určitú hodnotu, za podmienky existencie pozorovaných
 , vyzerá nasledovne:

Teraz dosadíme nami potrebné premenné:  a
 Zostáva len nájsť vektor

, pri ktorom je táto pravdepodobnosť maximálna. Aby sme maximalizovali takú funkciu, je pohodlné najprv ju prilogaritmizovať (logaritmus funkcie dosiahne maximum v tom istom bode, ako sama funkcia):  Čo sa zase zredukuje na minimalizáciu nasledujúcej funkcie:

Mimochodom, toto sa nazýva metóda

najmenších štvorcov QR rozklad
Minimum uvedenej funkcie môžeme nájsť, ak nájdeme bod, v ktorom gradient tejto funkcie je rovný nule. A gradient bude zapísaný nasledujúcim spôsobom:
je maticovou metódou riešenia problému minimalizácie používanou v metóde najmenších štvorcov. V tejto súvislosti prepíšeme rovnicu v maticovej forme:

Takže rozkladáme maticu

na matice  na matrici
 a
 a vykonávame rad transformácií (samotný algoritmus QR rozkladu sa tu nebude posudzovať, iba jeho využitie v súvislosti s danou úlohou):

Matica  je ortogonálna. To nám umožňuje zbaviť sa súčinu
 :

A ak nahradíme  na
 , dostaneme
 . Keďže
 je horná trojuholníková matica, vyzerá to nasledovne:

Toto možno riešiť metódou substitúcie. Prvok  sa nachádza ako
 , predchádzajúci prvok
 sa nachádza ako
 a tak ďalej.
Tu treba poznamenať, že zložitosti získaného algoritmu vďaka použitiu QR rozkladu je rovnák  . Napriek tomu, že operácia násobenia matíc sa dobre paralelizuje, napísať efektívnu distribuovanú verziu tohto algoritmu sa nezdá možné.
Gradientný pokles
Keď hovoríme o minimalizácii nejakej funkcie, vždy by sme mali spomenúť metódu (stochastického) gradientného poklesu. Je to jednoduchá a efektívna metóda minimalizácie založená na iteratívnom výpočte gradientu funkcie v bode a následnom posune v smere opačnom k gradientu. Každý taký krok približuje riešenie k minimu. Gradient pritom vyzerá stále rovnako:

Taktiež je táto metóda dobre paralelizovateľná a distribuovateľná vďaka lineárnym vlastnostiam operátora gradientu. Poznamenajme, že vo vyššie uvedenom vzorci pod znamienkom sumy sú nezávislé sčítance. Inými slovami, môžeme vypočítať gradient nezávisle pre všetky indexy  od prvého po
 , paralelne s tým vypočítať gradient pre indexy od
 do
 . Potom zahrnieme vzniknuté gradienty. Výsledok sčítania bude rovnaký, akoby sme vypočítali hneď gradient pre indexy od prvého po
 . Takto, ak sú dáta rozdelené medzi viaceré časti dát, gradient môže byť vypočítaný nezávisle na každej časti, a potom môžu byť výsledky týchto výpočtov sčítané na získanie konečného výsledku:

Z hľadiska realizácie sa to zmestí do paradigmy . Na každom kroku gradientného poklesu je každému uzlu dát odoslaná úloha na výpočet gradientu, potom sa vypočítané gradienty zhromažďujú spolu a výsledok ich sčítania sa používa na zlepšenie výsledku.
Napriek jednoduchej implementácii a možnosti realizácie v paradigme MapReduce má gradientný zostup aj svoje nedostatky. Konkrétne, počet krokov potrebných na dosiahnutie konvergencie je podstatne vyšší v porovnaní s inými, viac špecializovanými metódami.
LSQR
je ďalšou metódou riešenia predloženej úlohy, ktorá je vhodná ako na obnovu lineárnej regresie, tak na riešenie systémov lineárnych rovníc. Jeho hlavná vlastnosť spočíva v tom, že kombinuje výhody maticových metód a iteratívneho prístupu. Implementácie tejto metódy je možné nájsť ako v knižnici , tak aj v . Opis tejto metódy nebude uvedený (možno ho nájsť v článku ). Namiesto toho bude demonštrovaný prístup, ktorý umožňuje prispôsobiť LSQR pre vykonávanie v distribuovanom prostredí.
Základom metódy LSQR je . Ide o iteratívnu procedúru, ktorej každá iterácia pozostáva z nasledujúcich krokov:
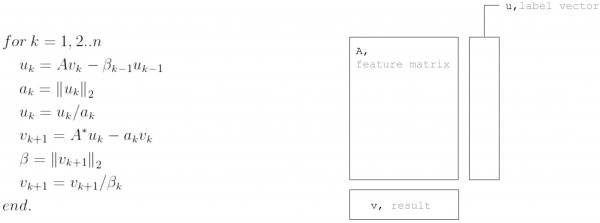
Ale ak vychádzame z toho, že matica  je horizontálne partíciovaná, každú iteráciu je možné predstaviť vo forme dvoch krokov MapReduce. Týmto spôsobom sa podarí minimalizovať prenosy dát počas každej iterácie (iba vektory dĺžky rovnej počtu neznámych):
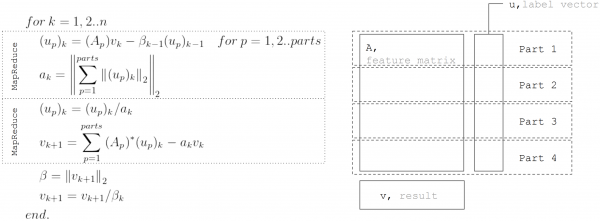
Tento prístup sa používa pri implementácii lineárnej regresie v .
Záver
Existuje mnoho algoritmov na obnovu lineárnej regresie, ale nie všetky môžu byť aplikované za akýchkoľvek podmienok. Tak QR rozklad je vynikajúci pre presné riešenia na malých množstvách údajov. Gradientný zostup je jednoducho realizovateľný a umožňuje rýchlo nájsť priblížené riešenie. A LSQR kombinuje najlepšie vlastnosti predchádzajúcich dvoch algoritmov, keďže môže byť distribuovaný, rýchlejšie konverguje v porovnaní s gradientným zostupom, a tiež umožňuje predčasné zastavenie algoritmu na rozdiel od QR rozkladu pri hľadaní priblíženého riešenia.
Zdroj: habr.com
