

Vyvinuli sme dizajn dátových centier, ktorý umožňuje nasadzovať výpočtové klastry s viac ako 100 000 servermi a s vrcholovou šírkou pásma (bisection bandwidth) nad jeden petabajt za sekundu.
Z prednášky Dmitrija Afanaseva sa dozviete o základných princípoch nového dizajnu, o škálovaní topológií, o problémoch, ktoré pri tom vznikajú, o variantách ich riešenia, o špecifikách routovania a škálovania funkcií forwarding plane moderných sieťových zariadení v „hustých“ (densely connected) topológiách s veľkým počtom ECMP routov. Okrem toho Dima stručne hovoril o organizácii vonkajšej konektivity, fyzickej úrovni, káblovom systéme a spôsoboch ďalšieho zvýšenia kapacity.
— Dobrý deň všetkým! Volám sa Dmitrij Afanasev, som sieťový architekt Yandexu a prevažne sa zaoberám dizajnom sietí dátových centier.
Môj prejav bude o aktualizovanej sieti dátových centier Yandexu. To je do značnej miery evolúcia dizajnu, ktorý sme mali, ale zároveň sú tu aj niektoré nové prvky. Je to prehľadná prezentácia, keďže bolo potrebné vmestiť dosť veľa informácií do malého času. Začneme výberom logickej topológie. Potom bude prehľad control plane a problémy so škálovateľnosťou data plane, výber toho, čo sa bude diať na fyzickej úrovni, a pozrieme sa na niektoré špecifiká zariadení. Trochu sa dotkneme aj toho, čo sa deje v dátovom centre s MPLS, o ktorom sme hovorili pred nejakým časom.
Takže, čo vlastne Yandex predstavuje z hľadiska záťaže a služieb? Yandex je typický hyperscaler. Ak sa pozrieme na používateľov, najprv spracovávame používateľské požiadavky. Sú tu aj rôzne streamingové služby a dodávanie dát, pretože máme aj storage služby. Ak sa priblížime k backendu, objavia sa tam infraštrukturálne záťaže a služby, ako sú distribuované objektové úložiská, replikácia dát a samozrejme persistent queues. Jedným z hlavných typov záťaže sú MapReduce a podobné systémy, streamové spracovanie, machine learning a pod.
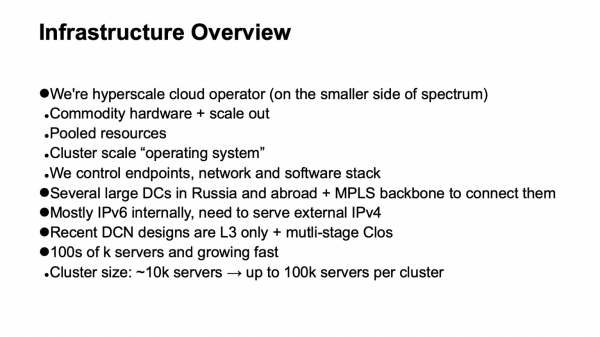
Ako funguje infraštruktúra, na ktorej sa to všetko odohráva? Znovu, sme celkom typický hyperscaler, aj keď sa možno nachádzame o niečo bližšie k tej strane spektra, kde sú menší hyperscaleri. Ale máme všetky atribúty. Používame spotrebný hardvér a horizontálne škálovanie tam, kde je to možné. Máme plné využitie poolingových zdrojov: nepracujeme so samostatnými strojmi ani s inými rackmi, ale spájame ich do veľkého poolu vzájomne zameniteľných zdrojov s niektorými dodatočnými službami, ktoré sa zaoberajú plánovaním a alokáciou, a pracujeme s týmto celým poolom.
Takže sa nám objavuje ďalšia úroveň – operačný systém na úrovni výpočtového klastera. Je veľmi dôležité, že úplne kontrolujeme technologický stack, ktorý používame. Kontrolujeme koncové body (hostiteľov), sieť a softvérový stack.
Máme niekoľko veľkých dátových centier v Rusku a v zahraničí. Spojuje ich backbone využívajúci technológiu MPLS. Naša vnútorná infraštruktúra je takmer úplne postavená na IPv6, ale pretože musíme obsluhovať vonkajší prenos, ktorý stále prichádza prevažne prostredníctvom IPv4, musíme nejakým spôsobom doručovať požiadavky prichádzajúce prostredníctvom IPv4 do frontend-u,serverov, a trochu sa prejsť do vonkajšieho IPv4 internetu – napríklad na indexovanie.
Posledné niekoľko iterácií dizajnu sietí dátových centier využíva viacúrovňové Clos topológie a v nich sa uplatňuje len L3. Od L2 sme sa vzdialili pred nejakým časom a s úľavou sme si vydýchli. Nakoniec, naša infraštruktúra zahŕňa stovky tisíc výpočtových (serverových) instancií. Maximálna veľkosť klastera bola pred nejakým časom približne 10 tisíc serverov. To je do značnej miery dané tým, ako môžu fungovať tie operčné systémy na úrovni klastera, plánovače, alokácia zdrojov a podobne. Keďže na strane infraštruktúrneho softvéru došlo k pokroku, cieľový rozsah teraz predstavuje približne 100 tisíc serverov v jednom výpočtovom klastri a my máme úlohu – vedieť vybudovať sieťové fabriky, ktoré umožňujú efektívne realizovanie poolingu zdrojov v takom klasteri.
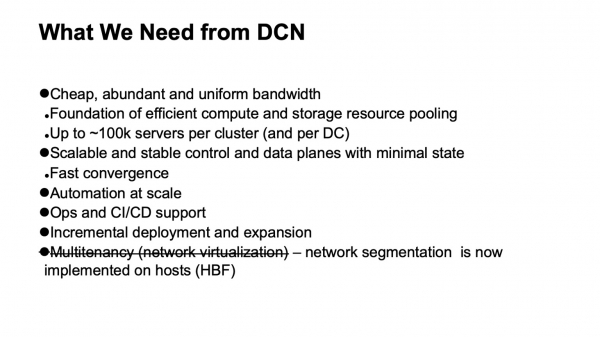
Čo teda od siete dátového centra očakávame? Predovšetkým veľa lacnej a dostatočne rovnomerne rozloženej šírky pásma. Pretože sieť je to pozadie, vďaka ktorému môžeme robiť pooling zdrojov. Nová cieľová veľkosť je okolo 100 tisíc serverov v jednom klustri.
Rovnako, samozrejme, chceme škálovateľný a stabilný control plane, pretože na takej veľkej infraštruktúre vzniká dosť bolesti hlavy aj z náhodných udalostí, a nechceme, aby nám ešte pridával control plane ďalšie problémy. Chceme minimalizovať stav v ňom. Čím menej stavu, tým lepšie a stabilnejšie všetko funguje, jednoducho sa diagnostikuje.
Samozrejme, potrebujeme automatizáciu, pretože ručné riadenie takej infraštruktúry už nie je možné a nie je to možné už nejaký čas. Potrebujeme, ak je to možné, podporu prevádzkových činností a podporu CI/CD, pokiaľ je to možné zabezpečiť.
Pri takých veľkostiach dátových centier a klastrov sa už dosť ostro ukázala úloha podpory inkrementálneho nasadenia a rozšírenia bez prerušenia služby. Ak na klastroch s veľkosťou tisíc strojov, možno blízko desiatich tisíc strojov, ich ešte možno nasadiť ako jednu operáciu — to znamená, plánujeme rozšírenie infraštruktúry, a niekoľko tisíc strojov sa pridá ako jedna operácia, tak klaster s veľkosťou pod sto tisíc strojmi nevzniká okamžite, buduje sa počas určitého času. A je žiaduce, aby počas celého tohto obdobia bola už vyexponovaná, tá infraštruktúra, ktorá bola nasadená, dostupná.
A jedno požiadavka, ktorú sme mali a už ju nemáme: to je podpora multitenancy, t.j. virtualizácie alebo segmentovania siete. Teraz to nemusíme robiť na úrovni sieťovej fabriky, pretože segmentácia sa presunula na hostiteľské systémy, a to nám veľmi uľahčilo škálovanie. Vďaka IPv6 a veľkému adresnému priestoru sme nemuseli vo vnútornej infraštruktúre používať duplikované adresy, celá adresácia bola už tak unikátna. A vďaka tomu, že sme filtráciu a segmentovanie siete preniesli na hostiteľské systémy, nemusíme vytvárať žiadne virtuálne sieťové entity v dátových centrách.
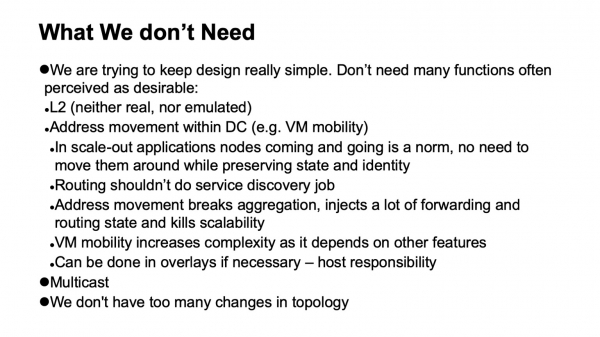
Veľmi dôležitá vec je to, čo nepotrebujeme. Ak môžeme nejaké funkcie odstrániť zo siete, veľmi to uľahčuje život a spravidla rozširuje výber dostupného hardvéru a softvéru, čo veľmi uľahčuje diagnostiku.
Takže, čo presne nepotrebujeme, od čoho sme sa mohli vzdať, nie vždy s radosťou v okamihu, keď sa to dialo, ale s veľkým uvoľnením, keď bol proces dokončený?
V prvom rade, vzdanie sa L2. L2 nepotrebujeme, ani reálny, ani emulovaný. V značnej miere sa nepoužíva, pretože kontrolujeme aplikačný stack. Naše aplikácie sú horizontálne škálovateľné, pracujú s adresovaním L3, príliš sa nestresujú, keď niektorý konkrétny inštancia zhasne, jednoducho sa vyroluje nová, nemusí sa vyrolovať na starej adrese, pretože existuje samostatná úroveň objavovania služieb a monitorovania strojov v klastri. Túto úlohu nepresúvame na sieť. Úlohou siete je doručovať pakety z bodu A do bodu B.
Taktiež nemáme situácie, kedy sa adresy presúvajú v rámci siete a je potrebné to sledovať. V mnohých dizajnoch je to zvyčajne potrebné na podporu mobility VM. Nepoužívame mobilitu virtuálnych strojov vo vnútornej infraštruktúre veľkého Yandexu, a okrem toho považujeme, že aj keby sa to robilo, nemalo by sa to diať so spoluprácou siete. Ak je to veľmi potrebné, má sa to vykonávať na úrovni hostiteľov a adresy, ktoré môžu migrovať, dať do overlay, aby sa príliš nenarúšalo a nevykonávali sa príliš veľa dynamických zmien v systéme smerovania samotnej underlay (transportnej siete).
Ďalšia technológia, ktorú nepoužívame, je multicast. Rád o tom poviem podrobnosti pre záujemcov. Veľmi to uľahčuje život, pretože ak niekto s tým mal skúsenosť a videl, ako vyzerá presne control plane multicastu — vo všetkých inštaláciách, okrem najjednoduchších, je to veľká bolesť hlavy. A navyše je ťažké nájsť dobre fungujúcu otvorenú implementáciu, napríklad.
A nakoniec, navrhujeme naše siete tak, aby v nich neprebiehalo príliš veľa zmien. Môžeme sa spoľahnúť na to, že tok externých udalostí v smere routovania je malý.
Aké problémy vznikajú a aké obmedzenia je potrebné zvážiť pri návrhu dátového centra? Náklady, samozrejme. Škálovateľnosť, do akej úrovne chceme rásť. Nevyhnutnosť rozšírenia bez prerušenia služby. Prenosová kapacita, dostupnosť. Viditeľnosť toho, čo sa deje v sieti, pre monitorovacie systémy, pre operačné tímy. Podpora automatizácie — opäť, tak veľmi, ako je to možné, pretože rôzne úlohy môžu byť riešené na rôznych úrovniach, vrátane zavedenia ďalších vrstiev. A nezávislosť od dodávateľov, ak je to možné. Aj keď v rôznych historických obdobiach, v závislosti od toho, na akú časť sa pozeráme, bola táto nezávislosť ľahšie alebo ťažšie dosiahnuteľná. Ak vezmeme napríklad čipy sieťových zariadení, až do nedávna sa dalo ťažko hovoriť o nezávislosti od dodávateľov, ak sme chceli aj čipy s vysokou prenosovou kapacitou.
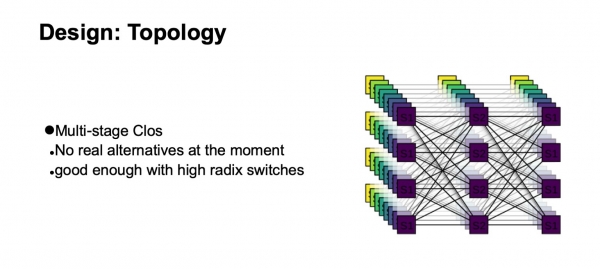
Akú logickú topológiu teda postavíme v našej sieti? Bude to viacúrovňový Clos. V skutočnosti v súčasnosti neexistujú žiadne reálne alternatívy. A Clos-topológia je dosť dobrá, aj keď ju porovnáme s rôznymi pokročilými topológiami, ktoré sú teraz skôr predmetom akademického záujmu, ak máme prepínače s veľkým radixom.
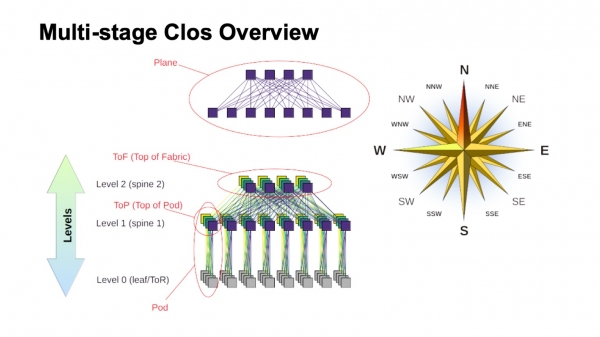
Ako je zhruba usporiadaná viacúrovňová Clos-sieť a ako sa nazývajú rôzne prvky v nej? Predovšetkým, ružica vetrov, aby sme sa zorientovali, kde je sever, kde juh, kde východ, kde západ. Siete tohto typu zvyčajne stavajú tí, ktorí majú veľmi veľký traffic zo západu na východ. Čo sa týka ostatných prvkov, hore je zobrazený virtuálny prepínač zložený z menších prepínačov. To je základná myšlienka rekurzívneho budovania Clos-sietí. Berieme prvky s nejakým radixom a spájame ich tak, aby to, čo vzniklo, mohlo byť považované za prepínač s väčším radixom. Ak potrebujeme ešte viac, proces môžeme zopakovať.
V prípadoch, ako sú dvojúrovňové Clos, keď je možné jasne vyčleniť komponenty, ktoré sú na mojej schéme vertikálne, sa zvyčajne nazývajú rovinami. Keby sme stavali Clos so žiadnym trojúrovňovým spine switchom (všetky, ktoré nie sú okrajové a nie sú switche ToR a ktoré sa používajú len na tranzit), roviny by vyzerali komplikovanejšie, dvojúrovňové vyzerajú presne takto. Blok ToR- alebo leaf switchov a s nimi súvisiace spine switche prvej úrovne nazývame Pod. Spine switche úrovne spine-1 na vrchu Pod sú top of Pod, vrchol Pod. Switche, ktoré sa nachádzajú na vrchu celej fabric, sú horná vrstva fabric, Top of fabric.
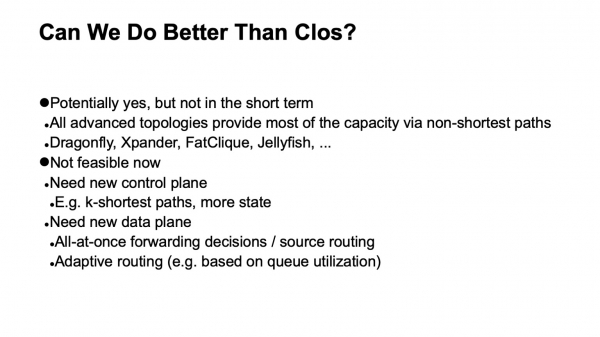
Samozrejme, vzniká otázka: Clos siete sa budujú už nejaký čas, samotná myšlienka vôbec pochádza z čias klasickej telefónie, TDM sietí. Možno vzniklo niečo lepšie, možno sa to dá nejako urobiť lepšie? A áno, aj nie. Teoreticky áno, prakticky v blízkej dobe určite nie. Pretože existuje určité množstvo zaujímavých topológií, niektoré z nich sa dokonca používajú v produkcii, napríklad Dragonfly sa používa v HPC aplikáciách; existujú aj zaujímavé topológie ako Xpander, FatClique, Jellyfish. Ak sa pozriete na prednášky na konferenciách ako SIGCOMM alebo NSDI za poslednú dobu, môžete objaviť celkom veľké množstvo prác na alternatívnych topológiách, ktoré majú lepšie vlastnosti (tie alebo iné) ako Clos.
Ale všetky tieto topológie majú jednu zaujímavú vlastnosť. Bráni ich zavádzaniu v sieťach dátových centier, ktoré sa snažíme budovať na commodity hardware a ktoré sú dostatočne rozumné cenovo. Vo všetkých týchto alternatívnych topológiách je veľká časť šírky pásma, žiaľ, dostupná nie cez najkratšie cesty. Preto sa okamžite zbavujeme možnosti používať tradičný control plane.
Teoreticky je riešenie úlohy známe. To sú napríklad modifikácie link state s použitím k-shortest path, ale opäť, neexistujú také protokoly, ktoré by boli implementované v produkcii a masovo dostupné na hardvéri.
Navyše, keďže väčšina kapacity nie je dostupná po najkratších cestách, musíme modifikovať nielen riadiacu rovinu, aby si vyberala všetky tieto cesty (a btw, je to oveľa väčší stav v riadiacej rovine). Takisto musíme modifikovať prenosovú rovinu a zvyčajne sú potrebné aspoň dve ďalšie funkcie. Je to schopnosť prijímať všetky rozhodnutia o prenose paketov naraz, napríklad na hostiteľovi. V skutočnosti ide o source routing, ktorý sa v literatúre o interkonexných sieťach niekedy nazýva all-at-once forwarding decisions. A ešte adaptívne smerovanie — to už je funkcia potrebná na sieťových prvkoch, ktorá sa týka napríklad toho, že vyberáme ďalší hop na základe informácií o najmenšej záťaži fronty. Ako príklad sú možné iné možnosti.
Takže smerovanie je zaujímavé, ale, bohužiaľ, momentálne ho nemôžeme aplikovať.
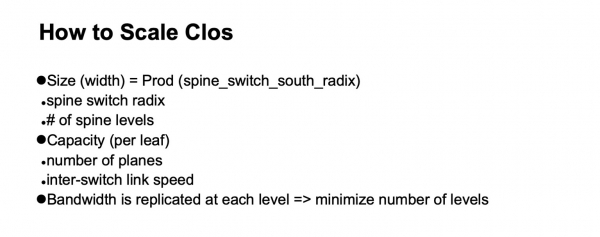
OK, zastavili sme sa na logickej topológii Clos. Ako ju budeme škálovať? Pozrime sa, ako je koncipovaná a čo môžeme urobiť.
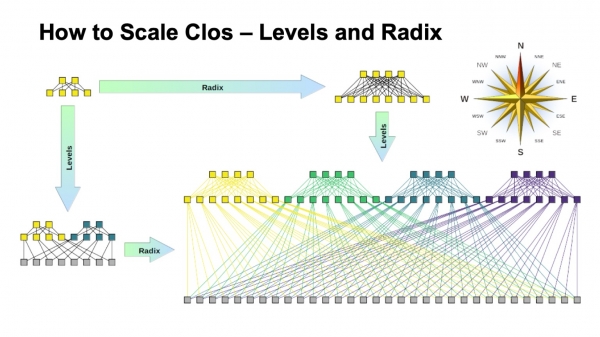
V Clos sieti sú dva hlavné parametre, ktoré môžeme nejako variabilizovať a získať rôzne výsledky: radix prvkov a počet úrovní v sieti. Mám schematicky zobrazené, ako jedno aj druhé vplýva na veľkosť. Ideálne kombinujeme oboje.
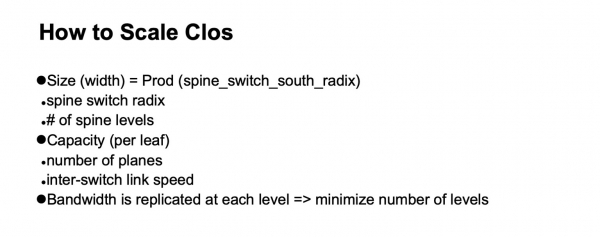
Je vidno, že konečná šírka Clos siete je súčin všetkých úrovní spine switchov južného radixu, to, koľko liniek máme smerom nadol, ako sa rozvetvuje. Takto škálujeme veľkosť siete.
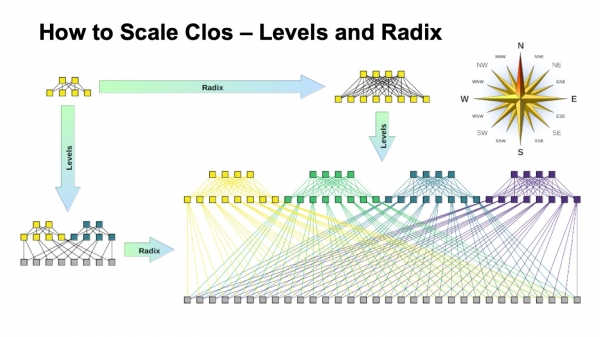
Pokiaľ ide o kapacitu, najmä na ToR switchoch, sú tu dve možnosti škálovania. Buď môžeme, pri zachovaní celej topológie, používať rýchlejšie linky, alebo môžeme pridávať väčšie množstvo rovin.
Ak sa pozrieme na rozvinutú verziu Clos siete (v pravom dolnom rohu) a vrátime sa k tomuto obrázku s Clos sieťou dole...
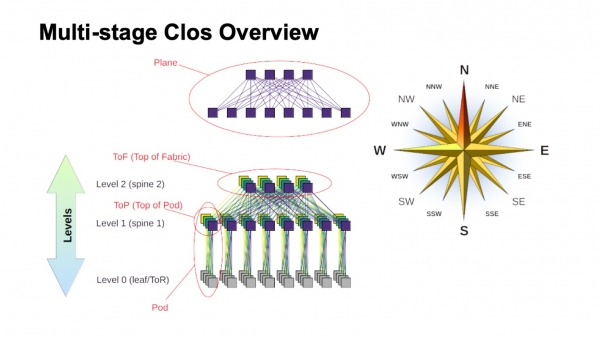
…tak to je jedna a tá istá topológia, ale na tomto slide je skomprimovaná kompaktnnejšie a roviny fabriky sa prekrývajú. To je to isté.
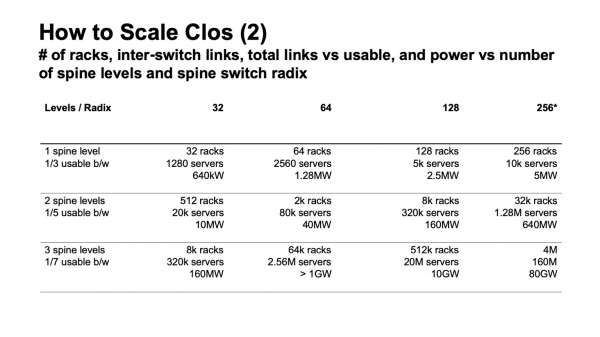
Ako vyzerá škálovanie Clos siete v číslach? Tieto údaje ukazujú, akú maximálnu šírku môže sieť dosiahnuť, aké maximálne množstvo rackov, ToR switchov alebo leaf switchov, ak nie sú umiestnené v rackoch, môžeme získať v závislosti od toho, aký máme radix switchov používaných pre spine úrovne a koľko úrovní používame.
Tu sú uvedené, koľko máme rackov, koľko serverov a približne koľko to všetko môže spotrebovať na základe 20 kW na rack. Predtým som spomenul, že naším cieľom je veľkosť clustra okolo 100 tisíc serverov.
Vidno, že v celej tejto konštrukcii predstavujú záujem dva a pol variantu. Je tu variant s dvoma vrstvami spine a 64-portovými prepínačmi, ktorý trochu zaostáva. Potom sú skvele vyhovujúce varianty pre 128-portové (s radixom 128) spine prepínače so dvoma úrovňami, alebo prepínače s radixom 32 s tromi úrovňami. A vo všetkých prípadoch, kde je väčší radix a viac úrovní, je možné vytvoriť veľmi veľkú sieť, ale ak sa pozriete na očakávanú spotrebu, vo väčšine prípadov tam sú gigawatty. Kábel môžeme natiahnuť, ale toľko elektriny na jednom mieste pravdepodobne nezískame. Ak sa pozriete na štatistiky, verejné údaje o dátových centrách — veľmi málo nájdete dátových centier s vypočítaným výkonom nad 150 MW. To, čo je viac, sú zvyčajne dátové centrá svojej kategórie, niekoľko veľkých dátových centier umiestnených dosť blízko seba.
Existuje ešte jeden dôležitý parameter. Ak sa pozriete na ľavý stĺpec, tam je uvedená použiteľná šírka pásma. Nie je ťažké si všimnúť, že v Clos sieti značná časť portov ide na spájanie prepínačov navzájom. Použiteľná šírka pásma je to, čo môžeme odovzdať von, smerom k serverom. Samozrejme, hovorím o podmienečných portoch a práve o šírke pásma. Spravidla sú linky vo vnútri siete rýchlejšie než linky smerom k serverom, ale na jednotku šírky pásma, koľko môžeme poskytnúť von k našim serverovým zariadeniam, prichádza ešte nejaká šírka pásma vo vnútri samotnej siete. A čím viac úrovní vytvárame, tým väčšie sú individuálne náklady na to, aby sme túto šírku pásma poskytli von.
Navyše, aj táto dodatočná šírka pásma nie je úplne rovnaká. Zatiaľ čo sú medzi nimi krátke vzdialenosti, môžeme použiť niečo ako DAC (direct attach copper, teda twinax káble) alebo multimodálnu optiku, ktorá je ešte stále cenovo rozumne dostupná. Hneď ako prejdeme na dlhšie vzdialenosti — zvyčajne ide o single mode optiku, a cena tejto dodatočnej šírky pásma sa výrazne zvyšuje.
A opäť, keď sa vrátim k predchádzajúcemu snímku, ak budujeme Clos-sieť bez prepisovania, nie je ťažké pozrieť sa na schému a vidieť, ako sa sieť buduje - pridávaním každého levelu spine prepínačov opakujeme celý ten pás, ktorý bol dole. Plus level - plus celá tá istá páska, ešte toľko, koľko bolo na predchádzajúcom leveli, porty na prepínačoch, ešte toľko transceiverov. Preto je veľmi žiaduce minimalizovať počet úrovní spine prepínačov.
Na základe tohto obrázka je jasné, že veľmi túžime budovať na niečom ako sú prepínače s radixom 128.
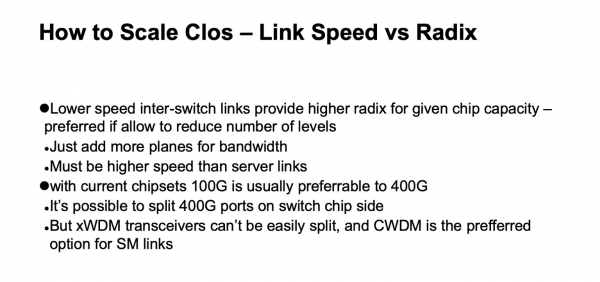
Tu je v podstate všetko to isté, čo som teraz povedal, tento snímok je skôr na zohľadnenie neskôr.
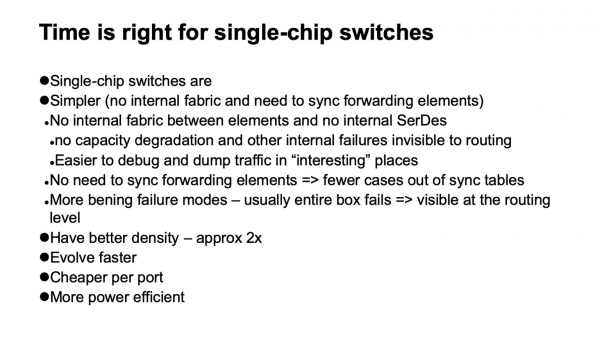
Aké sú možnosti, ktoré si môžeme vybrať ako také prepínače? Veľmi príjemná správa pre nás je, že v súčasnosti je možné konečne budovať také siete na jednočipových prepínačoch. A to je naozaj skvelé, majú množstvo príjemných vlastností. Napríklad takmer nemajú vnútornú štruktúru. To znamená, že sa ľahšie porušujú. Porušujú sa, bez toho by to nešlo, ale našťastie sa porušujú celé. V modulárnych zariadeniach je veľké množstvo porúch (veľmi nepríjemných), keď vzhľadom na susedov a riadiacu rovinu to akoby fungovalo, ale napríklad mu zmizla časť fabriky a nefunguje na plnú kapacitu. A prevádzka naň sa vyrovnáva s ohľadom na to, že je to plne funkčné, a môžeme tak získať preťaženie.
Alebo napríklad vznikajú problémy s backplane, pretože aj vnútri modulárneho zariadenia sú tiež vysokorýchlostné SerDes - je vo vnútri skutočne komplikovane usporiadané. Alebo sa mu synchronizujú alebo nesynchronizujú tabuľky medzi forwarding elementmi. V podstate akékoľvek výkonné modulárne zariadenie, ktoré pozostáva z veľkého množstva prvkov, vo vnútri seba väčšinou obsahuje tú istú Clos-sieť, len ju veľmi ťažko diagnostikovať. Často je ťažké diagnostikovať to aj samotnému dodávateľovi.
Má to veľa scenárov porúch, pri ktorých zariadenie degraduje, ale úplne nevypadne z topológie. Keďže naša sieť je veľká, aktívne sa využíva vyvažovanie medzi identickými prvkami a sieť je veľmi pravidelná, to znamená, že jeden priechod, na ktorom je všetko v poriadku, sa nijako nelíši od druhého, je pre nás výhodnejšie jednoducho stratiť časť zariadení z topológie, než sa ocitnúť v situácii, keď niektoré z nich sa zdajú fungovať, ale nie úplne.
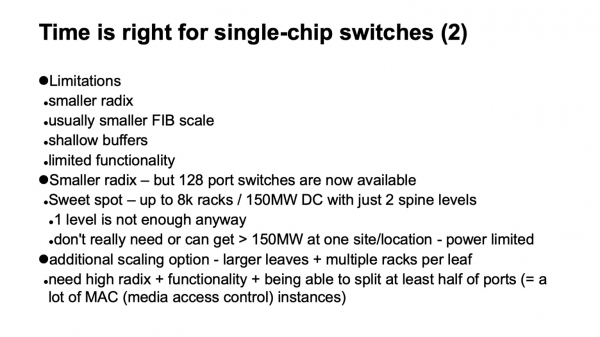
Ďalšou príjemnou vlastnosťou jednočipových zariadení je, že sa lepšie a rýchlejšie vyvíjajú. Taktiež zvyčajne majú lepšiu kapacitu. Ak berieme veľké zostavy, ktoré máme, na celkový výkon, kapacita na rack-jednotku podľa portov tej istej rýchlosti je takmer dvakrát lepšia ako u modulárnych zariadení. Zariadenia postavené okolo jedného čipu sú významne lacnejšie ako modulárne a spotrebujú menej energie.
Ale samozrejme, to všetko nie je bez nevýhod. Po prvé, prakticky vždy majú menší radikál ako modulárne zariadenia. Ak dokážeme zariadenie, postavené okolo jedného čipu, získať pre 128 portov, modulárne dokážeme získať pre niekoľko sto portov bez väčších problémov.
To znamená výrazne menšiu veľkosť forwarding tabuliek a vo všeobecnosti všetkého, čo sa týka škálovateľnosti dátovej roviny. Nízke buffery. A vo všeobecnosti pomerne obmedzená funkcionalita. Ukazuje sa, že ak poznáme tieto obmedzenia a včas sa postaráme o to, aby sme ich obchádzali alebo jednoducho zohľadnili, nie je to také hrozné. To, že je radikál menší, na nedávno objavených zariadeniach s radikálom 128 už nie je problémom, môžeme sa rozložiť do dvoch vrstiev spine switchov. A menej ako dve vrstvy nezaujímavé veľkosti pre nás postaviť aj tak nemožno. S jednou vrstvou sú výsledkom veľmi malá klastre. Dokonca aj naše predchádzajúce návrhy a požiadavky ich aj tak prevyšovali.
Ak skutočne existuje nejaké hraničné riešenie, je tu ďalší spôsob, ako sa rozšíriť. Keďže posledná (alebo prvá), najnižšia úroveň, na ktorú sú pripojené servery, sú ToR prepínače alebo leaf prepínače, nie sme povinní ich pripojiť k jedinému racku. Preto ak riešenie nie je dostatočné, môžeme zvážiť možnosť jednoducho použiť prepínač s väčším radixom na najnižšej úrovni a pripojiť napríklad dve-tri racky k jednému prepínaču. To je tiež možnosť, má svoje náklady, ale funguje a môže sa ukázať ako dobré riešenie, keď potrebujeme zväčšiť rozmery o dvojnásobok.
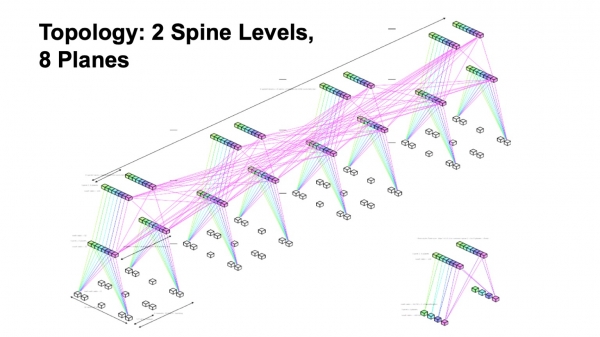
Zhrňujúc, budujeme podľa topológie s dvoma úrovňami spine, s ôsmimi vrstvami fabriky.
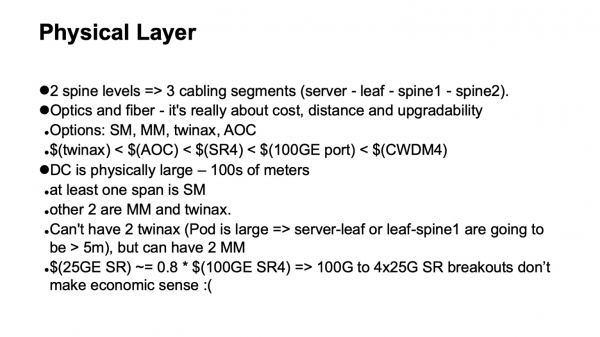
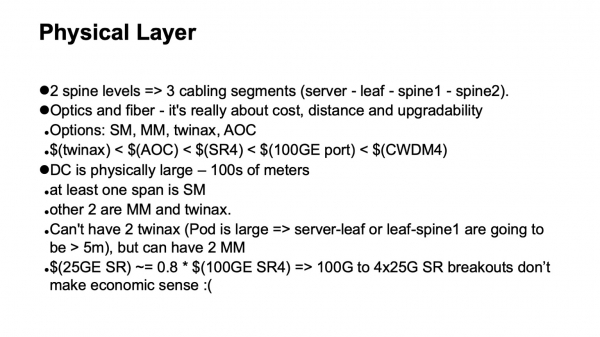
Čo bude s fyzikou? Veľmi jednoduché výpočty. Ak máme dva úrovne spine, znamená to, že máme celkovo tri úrovne prepínačov a očakávame, že v sieti budú tri káblové segmenty: od serverov k leaf prepínačom, k spine 1, k spine 2. Možnosti, ktoré môžeme použiť, sú twinax, multimódový, single mód. A tu je potrebné zohľadniť, aká šírka pásma je dostupná, koľko to bude stáť, aké sú fyzické rozmeru, aké spaní môžeme prejsť a ako sa budeme upgradovať.
Pok pokiaľ ide o náklady, všetko môžeme usporiadať v rade. Twinaxy sú výrazne lacnejšie než aktívna optika, lacnejšie než multimódové transceivery, ak vezmeme od konca, trochu lacnejšie než 100-gigabitový port prepínača. A pozor, stojí to lacnejšie než single mód optika, pretože na spaní, kde je potrebný single mód, je v dátových centrách z rôznych dôvodov rozumné použiť CWDM, s paralelným single mód (PSM) sa veľmi pohodlne nepracuje, vznikajú veľmi veľké zväzky vlákna a ak sa zastavíme pri týchto technológiách, vznikne približne takáto hierarchia cien.
Ďalšia poznámka: žiaľ, nie je veľmi efektívne používať rozobrané 100 na 4x25 multimódové porty. Vzhľadom na konštrukčné vlastnosti transceiverov SFP28 nie je o mnoho lacnejšie než QSFP28 na 100 Gbit. A toto rozdelenie pre multimód nefunguje veľmi dobre.
Ďalšie obmedzenie spočíva v tom, že kvôli veľkosti výpočtových klastrov a počtu serverov sú naše dátové centrá fyzicky veľké. To znamená, že minimálne jeden prelet bude musieť byť uskutočnený s jedným módom. Opäť, z dôvodu fyzickej veľkosti podsystémov nebude možné realizovať dva prelety twinaxom (medenými káblami).
Konečne, ak optimalizujeme podľa ceny a zohľadníme geometriu tejto konštrukcie, získame jeden prelet twinaxom, jeden prelet multimódom a jeden prelet s jedným módom pri použití CWDM. To zohľadňuje možné trasy pre upgrady.
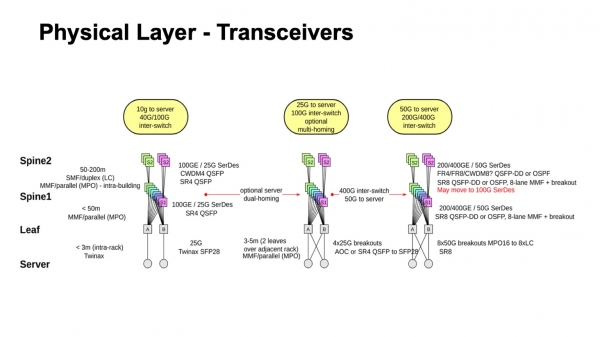
Takto vyzerá to, čo bolo nedávno, kam smerujeme a čo je možné. Je jasné, aspoň ako sa posunúť smerom k 50-gigabitovým SerDes pre multimód i pre jedinomód. Navyše, ak sa pozrieme na to, čo je v súčasnosti dostupné v transceiveroch s jedným módom a z pohľadu na 400G, mnohokrát, aj keď prichádzajú 50G SerDes z elektrickej strany, do optiky môžu preniknúť už 100 Gbps na kanál. Preto je veľmi pravdepodobné, že namiesto prechodu na 50 sa uskutoční prechod na 100-gigabitové SerDes a 100 Gbps na kanál, pretože podľa sľubov mnohých dodávateľov sa očakáva, že ich dostupnosť bude čoskoro. Obdobie, keď boli 50G SerDes najrýchlejšie, sa zdá, že nebude veľmi dlhé, pretože v budúcom roku budú uvedené na trh prvé kusy 100G SerDes. A po nejakom čase po tom pravdepodobne budú stáť rozumné peniaze.
Ešte jedna nuansa ohľadom výberu fyziky. V zásade už teraz môžeme používať 400- alebo 200-gigabitové porty s použitím 50G SerDes. Ale ukazuje sa, že v tom nie je veľký zmysel, pretože, ako som už spomínal, chceme dostatočne veľký radix na prepínačoch, v rozumných medziach, samozrejme. Chceme 128. Ak je kapacita čipu obmedzená a zvyšujeme rýchlosť linky, potom sa radix prirodzene znižuje, žiadne zázraky.
Celkovú kapacitu môžeme zvýšiť pridaním ploch, pričom nie sú žiadne výrazné náklady, môžeme pridať počet ploch. Ak stratíme radix, budeme musieť zaviesť ďalšiu úroveň, preto pri súčasných podmienkach a maximálnej dostupnej kapacite na jeden čip sa ukazuje, že efektívnejšie je využívať 100-gigabitové porty, pretože umožňujú dosiahnuť väčší radix.
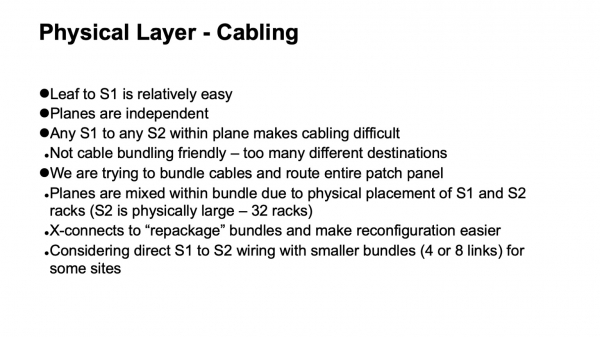
Ďalšia otázka sa týka organizácie fyziky, ale už z pohľadu káblovej infraštruktúry. Zistilo sa, že je organizovaná celkom zaujímavo. Kabeláž medzi leaf switchmi a prvími úrovňami spine switchov - nie je tam veľa linkov, všetko je postavené relatívne jednoducho. Ak však vezmeme jednu úroveň, to, čo sa deje vo vnútri - je potrebné spojiť všetky spine switchy prvej úrovne so všetkými spine switchami druhej úrovne.
Navyše, zvyčajne existujú určité požiadavky na to, ako to má vyzerať vo vnútri dátového centra. Napríklad sme veľmi chceli skombinovať káble do zväzku a ťahať ich tak, aby jedna vysokodenzitná patch panel úplne zapadala do jednej patch panel, aby nebol chaos v dĺžkach. Podarilo sa nám túto úlohu vyriešiť. Ak sa pôvodne pozrieme na logickú topológiu, je zrejmé, že úrovne sú nezávislé, každá úroveň sa môže stavať sama o sebe. Ale keď pridáme taký bundling a chceme ťahať úplne patch panel do patch panel, musíme v rámci jedného zväzku zmiešať rôzne úrovne a zavádzať medzičasové konštrukcie vo forme optických prepojení, aby sme ich prebalili od toho, ako boli zmontované na jednom segmente, do toho, ako budú zmontované na inom segmente. Vďaka tomu získavame príjemnú vlastnosť: celá zložitá komutácia sa nevymyká z rámca skríň. Keď je potrebné niečo veľmi preplietať, "rozprestrieť úrovne", ako to niekedy nazývajú v Clos sieťach, všetko je sústredené vo vnútri jednej skrine. Nemáme výrazne rozobrané, až po individuálne linky, komutácie medzi skriňami.
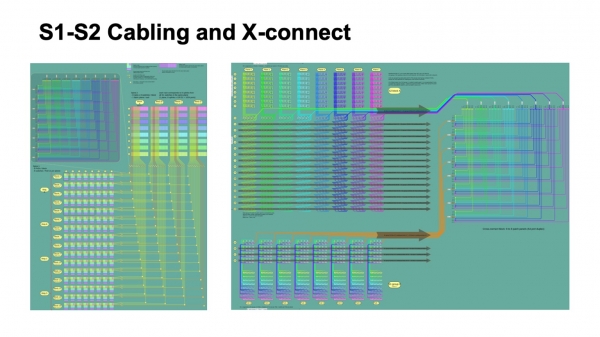
Takto to vyzerá z pohľadu logickej organizácie káblovej infraštruktúry. Na obrázku vľavo rôznofarebné bloky znázorňujú bloky spine switchov prvej úrovne, po osem kusov, a idúce od nich štyri zväzky káblov, ktoré idú a prekračujú zväzky idúce od blokov spine-2 switchov.
Malé štvorce označujú prepojenia. Vľavo hore je rozloženie každého takého prepojenia, to je v skutočnosti modul krížového prepojenia 512 na 512 portov, ktoré prebalí káble tak, aby sa dostali úplne do jednej skrinky, kde je len jedna rovina spine-2. A vpravo je rozloženie tohoto obrázka trochu detailnejšie týkajúce sa niekoľkých Pods na úrovni spine-1 a ako to je zabalené v krížovom prepojení, ako to prichádza na úroveň spine-2.
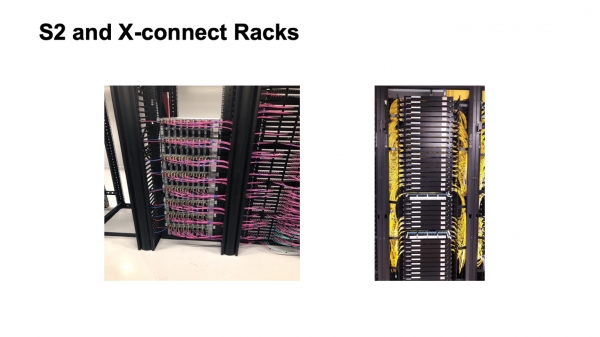
Takto to vyzerá. Nie úplne zostavená skriňa spine-2 (vľavo) a skriňa krížového prepojenia. Žiaľ, nie je tam veľa vidieť. Celá táto konštrukcia sa momentálne rozvíja v jednom z našich veľkých dátových centier, ktoré sa rozširuje. Je to práca v procese, bude to vyzerať lepšie, bude to lepšie zaplnené.
Dôležitá otázka: vybrali sme logickú topológiu, postavili fyziku. Čo bude s control plane-om? Z praxe je dosť dobre známe, že existuje určitý počet prezentácií, že protokoly založené na stave linku sú dobré, s nimi sa príjemne pracuje, ale žiaľ, na hustých topológiách sa zle škálujú. A je tu jeden základný faktor, ktorý tomu bráni — to, ako funguje flooding v protokoloch založených na stave linku. Ak vezmeme jednoducho algoritmus flooding, a pozrieme sa, ako je usporiadaná naša sieť, je jasné, že na každom kroku bude veľmi veľký fan-out, a jednoducho zaplaví control plane aktualizáciami. Konkrétne takéto topológie s tradičným algoritmom flooding v protokoloch založených na stave linku sa zle mixujú.
Voľba — použiť BGP. Ako ho správne pripravovať, je popísané v RFC 7938 o použití BGP vo veľkých dátových centrách. Základné myšlienky sú jednoduché: minimálny počet prefixov na hostiteľovi a vo všeobecnosti minimálny počet prefixov v sieti, používať agregáciu, ak je to možné, a potláčať path hunting. Chceme veľmi opatrné, veľmi kontrolované rozšírenie aktualizácií, to, čo sa nazýva valley free. Chceme, aby sa aktualizácie pri prechode sieťou rozvinuli presne raz. Ak sú pôvodné nižšie, idú vyššie, rozvinú sa nie viac ako raz. Nemajú byť žiadne zigzagy. Zigzagy sú veľmi zlé.
Na dosiahnutie tohto cieľa používame dosť jednoduchú schému, aby sme využili základné mechanizmy BGP. To znamená, že máme eBGP, ktorý funguje na link local, a autonómne systémy sa priraďujú nasledovne: autonómny systém na ToR, autonómny systém na celý blok spine-1-switche jedného Podu a spoločný autonómny systém na celý Top of Fabric. Není ťažké sa pozrieť a uistiť sa, že aj normálne správanie BGP nám poskytuje to rozšírenie aktualizácií, ktoré chceme.
Samozrejme, je potrebné navrhovať adresovanie a agregáciu adries tak, aby to bolo kompatibilné s tým, ako je postavené smerovanie, aby to zabezpečilo stabilitu control plane. L3 adresovanie v transporte je viazané na topológiu, pretože bez toho nemožno dosiahnuť agregáciu, inak jednotlivé adresy preniknú do smerovacieho systému. A ešte jedna vec — agregácia sa, žiaľ, veľmi dobre nezlučuje s multi-path, pretože keď máme multi-path a agregáciu, všetko je v poriadku, keď je celá sieť funkčná, nemá žiadne poruchy. Bohužiaľ, akonáhle sa v sieti objavia poruchy a strata symetrie topológie, môžeme prísť k bodu, z ktorého bol oznámený agregát, z ktorého sa nedá ďalej prejsť tam, kam potrebujeme. Preto je najlepšie agregovať tam, kde ďalej nie je multi-path, v našom prípade to sú ToR-switche.
V skutočnosti je možné agregovať, ale opatrne. Ak môžeme vykonať kontrolovanú de-agregáciu pri objavení sa porúch v sieti. Ale je to dosť zložitá úloha, dokonca sme sa zamýšľali, či sa to dá urobiť, či je možné pridať ďalšiu automatizáciu a konečné automaty, ktoré by správne riadili BGP, aby dosiahli požadované správanie. Bohužiaľ, spracovanie corner cases je veľmi nejasné a zložité a pripojením sa k BGP externého prídavného zariadenia sa táto úloha veľmi dobre nevyrieši.
Veľmi zaujímavá práca v tomto ohľade bola vykonaná v rámci protokolu RIFT, o ktorom bude reč v nasledujúcom príspevku.
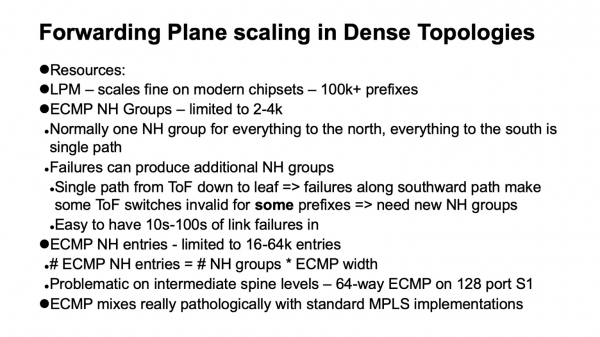
Ďalšou dôležitou vecou je, ako sa škálujú data plane v hustých topológiách, kde máme veľké množstvo alternatívnych ciest. Pri tom sa používajú niekoľko ďalších štruktúr údajov: ECMP skupiny, ktoré popisujú zase skupiny Next Hop.
V normálne fungujúcej sieti, bez výpadkov, keď ideme po Clos-topológii nahor, stačí použiť len jednu skupinu, pretože všetko, čo nie je lokálne, je opisované predvoleným nastavením a môžeme ísť nahor. Keď ideme zhora nadol na juh, všetky cesty nie sú ECMP, sú to jediné cesty. Všetko je v poriadku. Problém je v tom a špecifickosť klasickej Clos-topológie spočíva v tom, že ak sa pozrieme na Top of fabric, k akémukoľvek prvku, doprava do akéhokoľvek prvku na spodku má jednu cestu. Ak sa na tejto ceste vyskytnú výpadky, tento konkrétny prvok na vrchu fabriky sa stáva neplatným práve pre tie prefixy, ktoré sú za poškodenou cestou. A pre ostatné je platný, a musíme rozoberať ECMP skupiny a zaviesť nový stav.
Ako vyzerá škálovateľnosť dátového plánu na moderných zariadeniach? Ak robíme LPM (najdlhšie zodpovedajúce prefixy), všetko je dosť dobré, nad 100 tisíc prefixov. Ak sa hovorí o Next Hop skupinách, tak to nie je tak dobré, 2-4 tisíc. Ak hovoríme o tabuľke, ktorá obsahuje popis Next Hops (alebo priesečníkov), tak to je niekde od 16 tisíc do 64 tisíc. A to môže byť problém. A tu sa dostávame k zaujímavému odbočeniu: čo sa vlastne stalo s MPLS v dátových centrách? V podstate, chceli sme to urobiť.
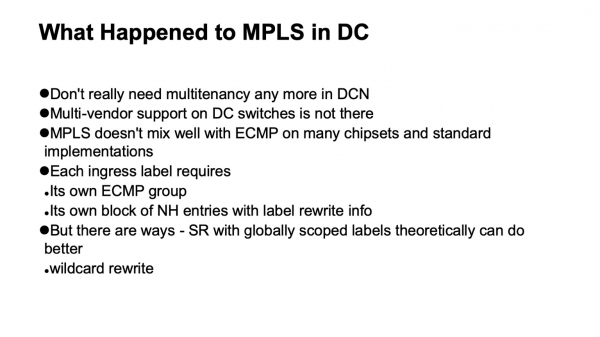
Stalo sa dve veci. Urobili sme mikrosemunetáciu na hostiteľoch, nepotrebovali sme to robiť na sieti. Nebolo to veľmi dobré s podporou od rôznych dodávateľov a obzvlášť s otvorenými realizáciami na bielych boxoch s MPLS. A ešte MPLS, aspoň jeho tradičné realizácie, bohužiaľ, veľmi zle spolupracuje s ECMP. A práve preto.
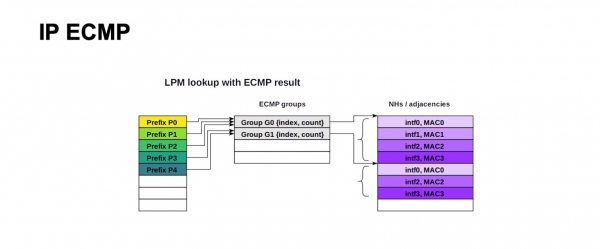
Takto vyzerá štruktúra ECMP-forwardingu pre IP. Veľké množstvo prefixov môže používať jednu a tú istú skupinu a ten istý blok Next Hops (alebo priesečníkov, v rôznej dokumentácii na rôzne zariadenia to môže byť označované rôzne). Zmyslom je, že je to popisované ako výstupný port a na čo prepísať MAC adresu, aby sme sa dostali na správny Next Hop. Pre IP to všetko vyzerá jednoducho, môžeme použiť na veľmi veľké množstvo prefixov jednu a tú istú skupinu, ten istý blok Next Hops.
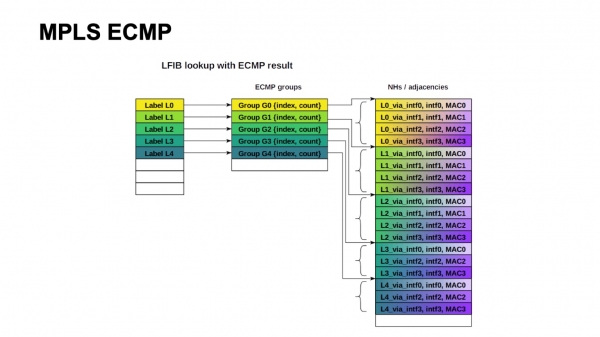
Klasická architektúra MPLS predpokladá — v závislosti od výstupného rozhrania, môže byť značka prepísaná na rôzne hodnoty. Preto musíme udržiavať po skupine a po bloku Next Hops pre každú vstupnú značku. A to, žiaľ, nie je škálovateľné.
Nie je ťažké vidieť, že naša konštrukcia potrebovala približne 4000 ToR prepínačov, maximálna šírka — 64 ciest ECMP, ak prejdeme od spine-1 k spine-2. Tiesnieme sa, na hrane, do jednej tabuľky ECMP skupín, len ak sa jeden prefix s ToR odkloní, a vôbec sa nepremiestnime do tabuľky Next Hops.
Nič nie je beznádejne, pretože architektúry ako Segment Routing predpokladajú globálne značky. Formálne by bolo možné opäť zúžiť všetky tieto bloky Next Hops. Na to je potrebná operácia typu wild card: vziať značku a prepísať ju na tú istú bez konkrétnej hodnoty. Bohužiaľ, v dostupných realizáciách to nie je veľmi prítomné.
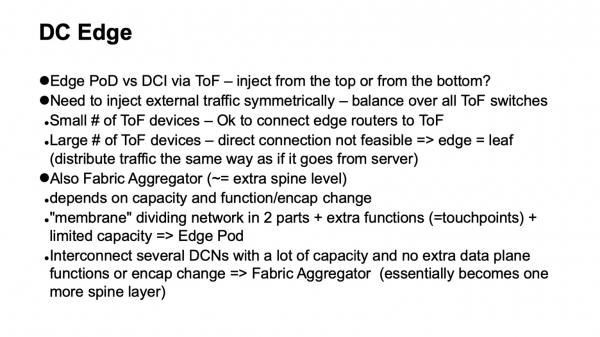
A nakoniec, musíme do dátového centra privezť externý traffic. Ako to spraviť? Kedysi sa traffic zavádzal do Clos sietí zhora. Teda existovali hraniční smerovače, ktoré sa pripájali ku všetkým zariadeniam na vrchole fabric. Toto riešenie funguje celkom dobre pri malých a stredných veľkostiach. Bohužiaľ, aby sa traffic takto symetricky zavádzal do celej siete, musíme prichádzať súčasne na všetky prvky Top of fabric, a keď sa ich stane viac ako sto, zistí sa, že potrebujeme veľký radix aj na hraničných smerovačoch. V skutočnosti to stojí peniaze, pretože hraničné smerovače sú funkčnejšie, porty na nich budú drahšie a vzniká nevzhľadná konštrukcia.
Ďalšou možnosťou je zavádzať taký traffic zo spodu. Nie je ťažké sa presvedčiť, že Clos topológia je postavená tak, že traffic vstupujúci zospodu, teda zo strany ToR, sa rovnomerne rozdeľuje po úrovniach na celý Top of fabric za dve iterácie, čím sa zatížia všetky siete. Preto zavádzame špeciálny typ Pod, Edge Pod, ktoré zabezpečujú externú konektivitu.
Existuje ešte jedna možnosť. Napríklad, takto to robí Facebook. U nich sa to nazýva Fabric Aggregator alebo HGRID. Zavádza sa dodatočná spine úroveň na prepojenie viacerých dátových centier. Takáto konštrukcia je možná, ak nemáme na prechodoch dodatočné funkcie alebo zmenu enkapsulácie. Ak existujú, sú to dodatočné touch points, čo je komplikované. Zvyčajne vzniká viac funkcií a akási membrána, ktorá oddeľuje rôzne časti dátového centra. Nemať túto membránu veľkú nie je rozumné, ale ak je veľmi potrebná, má zmysel zvážiť jej prenesenie, urobiť čo najširšiu a preniesť ju na hostiteľov. Tak to robí napríklad mnoho cloud operátorov. Majú overlaye, ktoré sa začínajú od hostiteľov.
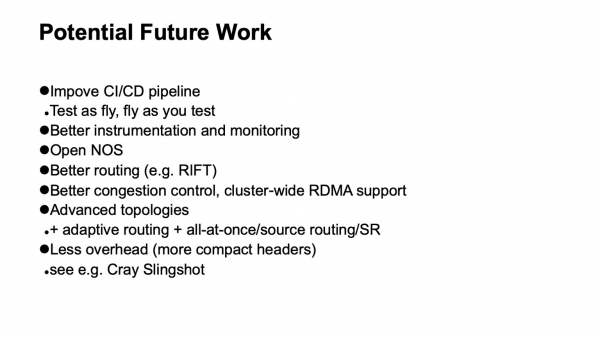
Aké možnosti rozvoja vidíme? Predovšetkým zlepšenie podpory CI/CD pipeline. Chceme lietať tak, ako testujeme, a testovať tak, ako lietame. To sa nám však veľmi nedarí, pretože infraštruktúra je veľká a nie je možné ju duplicovať na účely testovania. Musíme pochopiť, ako začleniť prvky testovania do pracovnej infraštruktúry, pričom ju neochromíme.
Najlepšie nástroje, najlepší monitoring sú takmer vždy nevyhnutné. Celý problém spočíva v rovnováhe medzi úsilím a výkonom. Ak je možné rozumne pridať — je to veľmi dobré.
Otvorené operačné systémy pre sieťové zariadenia. Najlepšie protokoly a najlepšie systémom smerovania, napríklad RIFT. Tiež sú potrebné výskumy na aplikáciu najlepších schém congestion control a možno zavedenie, aspoň na niektorých miestach, podpory RDMA v rámci klastrov.
Ak sa pozrieme do vzdialenejšej budúcnosti, potrebné sú pokročilé topológie a možno aj siete s nižším overheadom. Z noviniek — nedávno boli publikácie o technológii fabrík pre HPC Cray Slingshot, ktorej základom je commodity Ethernet, ale s možnosťou použitia omnoho kratších hlavičiek. V dôsledku toho sa znižuje overhead.
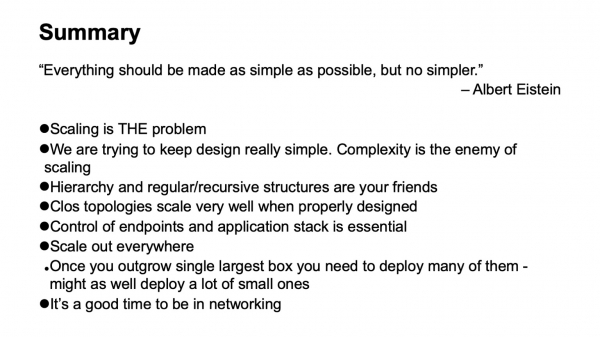
Všetko by sa malo robiť tak jednoducho, ako je to možné, ale nie jednoduchšie. Zložitosti sú nepriateľom škálovateľnosti. Jednoduchosť a pravidelné štruktúry sú našimi priateľmi. Ak je možné robiť scale out — robte to. A vôbec, teraz je skvelé sa zaoberať sieťovými technológiami. Deje sa veľa zaujímavého. Ďakujem.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish