

Obávajte sa operácií, buffers prinášajúcich…
Na príklade malej žiadosti si predstavíme niektoré univerzálne prístupy k optimalizácii dopytov v PostgreSQL. Používať ich alebo nie — je na vás, ale mali by ste o nich vedieť.
V nasledujúcich verziách PG sa situácia môže zmeniť s „inteligentnejším“ plánovačom, ale pre 9.4/9.6 to vyzerá zhruba rovnako, ako tu uvedené príklady.
Vezmem si celkom reálny dopyt:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentRozšírenie" doc_ex
    USING("@Dokument")
INNER JOIN
  "TypDokumentu" t_doc ON
    t_doc."@TypDokumentu" = d."TypDokumentu"
WHERE
  (d."Osoba3" = 19091 or d."Zamestnanec" = 19091) AND
  d."$Návrh" IS NULL AND
  d."Vymazaný" IS NOT TRUE AND
  doc_ex."Stav"[1] IS TRUE AND
  t_doc."TypDokumentu" = 'PlánPrác'
LIMIT 1;
o menách tabuliek a políNa „ruské“ názvy polí a tabuliek sa dá pozerať rôzne, ale to je vec vkusu. Keďže nie sú žiadni zahraniční vývojári a PostgreSQL nám umožňuje dávať názvy aj hieroglifmi, ak sú uzavreté v úvodzovkách, preferujeme pomenovávať objekty jednoznačne a zrozumiteľne, aby nevznikali nejasnosti.
Pozrime sa na výsledný plán:
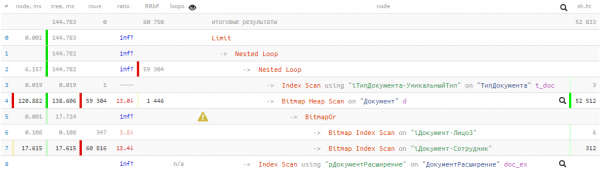
144ms a takmer 53K buffers — teda viac ako 400MB dát! A budeme šťastní, ak sa všetky dostanú do cache v momente našej žiadosti, inak sa predlží niekoľkokrát pri čítaní z disku.
Algoritmus je najdôležitejší!
Aby sme mohli optimalizovať akýkoľvek dopyt, musíme najprv pochopiť, čo by mal vôbec robiť.
Necháme zatiaľ mimo rámca tohto článku vývoj samotnej štruktúry DB a dohodneme sa, že môžeme relatívne „lacno“ prepisovať dopyt a/alebo aplikovať na databázu nejaké potrebné indexy.
Takže dopyt:
— kontroluje existenciu akéhokoľvek dokumentu
— v požadovanom stave a určitého typu
— kde autorom alebo vykonávateľom je náš požadovaný zamestnanec
JOIN + LIMIT 1
Dosť často je pre vývojára jednoduchšie napísať dopyt, kde sa najprv robí spojenie veľkého počtu tabuliek, a potom z tohto množstva ostane jedna jediná záznam. Ale jednoduchšie pre vývojára neznamená efektívnejšie pre DB.
V našom prípade bolo tabuliek iba 3 — a aký efekt…
Poďme najprv odstrániť spojenie s tabuľkou „TypDokumentu“ a pri tom naznačíme databáze, že typ záznamu máme unikátny (my to vieme, ale plánovač to zatiaľ netuší):
WITH T AS (
  SELECT
    "@TypDokumentu"
  FROM
    "TypDokumentu"
  WHERE
    "TypDokumentu" = 'PlánPrác'
  LIMIT 1
)
...
WHERE
  d."TypDokumentu" = (TABLE T)
...
Áno, ak tabuľka/CTE pozostáva z jedného jediného poľa jediného zápisu, tak v PG môžete písať dokonca takto, namiesto
d."TypDokumentu" = (SELECT "@TypDokumentu" FROM T LIMIT 1)„Lenivé“ výpočty v dopytoch PostgreSQL
BitmapOr vs UNION
V niektorých prípadoch môže Bitmap Heap Scan stáť veľmi veľa — napríklad v našej situácii, keď veľa záznamov spadá pod požadovanú podmienku. Získali sme ho kvôli OR-podmienke, ktorá sa premenila na BitmapOr-operáciu v pláne.
Vráťme sa k pôvodnej úlohe — je potrebné nájsť záznam, ktorý vyhovuje akéhokoľvek z podmienok — teda nie je potrebné prekonávať všetkých 59K záznamov podľa oboch podmienok. Existuje spôsob, ako spracovať jednu podmienku, a na druhú prejsť iba vtedy, keď pri prvej nič nebolo nájdené.Pomôže nám taká konštrukcia:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
„Externý“ LIMIT 1 zaručuje, že vyhľadávanie sa skončí, keď sa nájde prvý záznam. A ak sa nájde už v prvom bloku, vykonanie druhého prebiehať nebude (never executed v pláne).
„Schovávame pod CASE“ zložité podmienky
V pôvodnom dopyte je veľmi nepríjemný moment — kontrola stavu podľa súvisiacej tabuľky „DokumentRozšírenie“. Bez ohľadu na pravdivosť ostatných podmienok vo výraze (napríklad, d. „Odstránené“ IS NOT TRUE), toto spojenie sa vykonáva vždy a „stojí zdroje“. Viac alebo menej ich bude vynaložených — závisí od objemu tejto tabuľky.
Ale môžeme dopyt modifikovať tak, aby sa vyhľadávanie súvisiaceho záznamu vykonávalo iba vtedy, keď je to skutočne potrebné:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ...
/*index cond*/ AND
  CASE
    WHEN "$Čiernokopírovať" IS NULL AND "Odstránené" IS NOT TRUE THEN (
      SELECT
        "Stav"[1] IS TRUE
      FROM
        "DokumentRozšírenie"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Keďže z pripojenej tabuľky nám nie je potrebné pre výsledok ani jedno z polí, môžeme premeniť JOIN na podmienku podľa podzáznamu.
Necháme indexovateľné polia „za zátvorkami“ CASE, jednoduché podmienky od záznamu vkladáme do bloku WHEN — a teraz sa „ťažký“ dopyt vykoná iba pri prechode do THEN.
Moje priezvisko je „Všetko“
Skladáme výsledný dopyt so všetkými vyššie popísanými mechanikami:
S T AS (
  SELECT
    "@DocumentType"
  FROM
    "DocumentType"
  WHERE
    "DocumentType" = 'WorkPlan'
)
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("Person3", "DocumentType") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Draft" IS NULL AND "Deleted" IS NOT TRUE THEN (
          SELECT
            "Status"[1] IS TRUE
          FROM
            "DocumentExtension"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("DocumentType", "Employee") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Draft" IS NULL AND "Deleted" IS NOT TRUE THEN (
          SELECT
            "Status"[1] IS TRUE
          FROM
            "DocumentExtension"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Prispôsobujeme [pod] indexy
Okom praxe som si všimol, že indexované podmienky v podblokoch UNION sa trocha líšia — je to preto, že už máme vhodné indexy na tabuľke. A keby ich nebolo — malo by zmysel ich vytvoriť: Dokument(Person3, DocumentType) a Dokument(DocumentType, Employee).
o poradí polí v ROW-podmienkachZ pohľadu plánovača, samozrejme, sa to dá napísať aj takto (A, B) = (constA, constB), a (B, A) = (constB, constA). Ale pri zápise v poradí polí v indexe, takýto dotaz je jednoducho pohodlnejšie potom odladit.
Čo je v pláne?
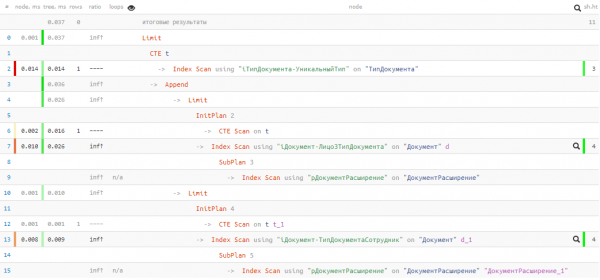
Bohužiaľ, nemali sme šťastie a v prvom UNION-bloku nič nenašli, preto bol druhý predsa len vykonaný. Ale aj tak — len 0.037ms a 11 buffers!
Úspešne sme urýchlili dotaz a znížili „prenos“ dát v pamäti niekoľko tisíckrát, pričom sme využili dosť jednoduché metódy — dobrý výsledok pri malom kopírovaní. 🙂
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish