

Pri vývoji sa občas objaví potreba poslať v požiadavke súbor parametrov alebo dokonca celú výberovú sadu „na vstup“. Niekedy sa objavia veľmi zvláštne riešenia tejto úlohy.
Pristúpme „od opačného“ a pozrime sa, ako to robiť nemáme, prečo a ako to môžeme urobiť lepšie.
Priame „zápustenie“ hodnôt do tela požiadavky
Vyzerá obvykle približne takto:
query = "SELECT * FROM tbl WHERE id = " + value… alebo takto:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)O tomto spôsobe sa už povedalo, napísalo a dosť:
Takmer vždy to je — priamy cestou k SQL-injekciám a zbytočnej záťaži na biznis logiku, ktorá musí „lepíť“ reťazec vašej požiadavky.
Čiastočne je taký prístup oprávnený len v prípade potreby používania partície v verziách PostgreSQL 10 a nižších na dosiahnutie efektívnejšieho plánu. V týchto verziách je zoznam skenovaných častí určený ešte bez ohľadu na posielané parametre, len na základe tela požiadavky.
$n-argumenty
Použitie parametrov – to je dobré, umožňuje to používať , znižujúc záťaž ako na biznis logiku (reťazec požiadavky sa formuje a posiela iba raz), tak aj na server DB (nevyžaduje sa opakované rozparsovanie a plánovanie pre každý inštancie požiadavky).
Premenné množstvo argumentov
Problémy na nás čakajú, keď sa pokúsime poslať vopred neznáme množstvo argumentov:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Ak necháme požiadavku v takomto stave, aj keď nás to ochráni pred potenciálnymi injekciami, stále to povedie k potrebe spájania/rozparsovania požiadavky pre každú variantu počtu argumentov. Už je to lepšie, ako to robiť zakaždým, ale dá sa to urobiť aj bez toho.
Stačí poslať len jeden parameter, ktorý obsahuje serializované zobrazenie poľa:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Jediný rozdiel — nutnosť explicitne premeniť argument na požadovaný typ poľa. Ale to nespôsobuje problémy, pretože už vopred vieme, kam smerujeme.
Prenos výberu (matice)
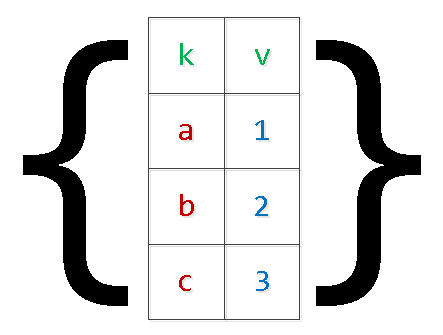
Obvykle ide o rôzne možnosti prenosu súborov údajov na vloženie do databázy „za jeden požiadavku“:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Okrem popísaných vyššie problémov s „lepéním“ požiadavky, to môže viesť aj k out of memory a pádu servera. Dôvod je jednoduchý — pri argumentoch PG si rezervuje dodatočnú pamäť a počet záznamov v súbore je obmedzený len aplikovanými požiadavkami obchodnej logiky. V zvlášť ťažkých prípadoch sme mohli vidieť „číselné“ argumenty presahujúce $9000 — nerobte to.
Prepíšeme dopyt, pričom už použijeme „dvojúrovňovú“ serializáciu:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Áno, v prípade „zložitých“ hodnôt vo vnútri poľa, ich treba obalovať úvodzovkami.
Je jasné, že takýmto spôsobom môžeme „rozložiť“ výber s ľubovoľným počtom polí.
unnest, unnest, …
Pravidelne sa objavujú varianty predávania namiesto „poľa pole“ viacerých „polí stĺpcov“, o ktorých som sa zmienil :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Pri takomto spôsobe, ak sa pomýlite pri generovaní zoznamov hodnôt pre rôzne stĺpce, veľmi ľahko môžete získať úplne neočakávané výsledky, závislé aj od verzie servera:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Od verzie 9.3 sa v PostgreSQL objavili plnohodnotné funkcie na prácu s typom json. Preto, ak sa definovanie vstupných parametrov deje vo vašom prehliadači, môžete priamo tam aj vytvoriť json-objekt pre SQL-dopyt:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Pre predchádzajúce verzie je rovnaký spôsob možné použiť pre each(hstore), ale správna „kompresia“ s escapovaním zložitých objektov v hstore môže spôsobiť problémy.
json_populate_recordset
Ak vopred viete, že údaje z „vstupného“ json-poľa pôjdu na vyplnenie nejakej tabuľky, môžete výrazne ušetriť na „de-referencovaní“ polí a prevádzaní na požadované typy, pričom využijete funkciu json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
A táto funkcia jednoducho „rozloží“ odovzdané pole objektov na výberku, bez ohľadu na formát tabuľky:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
Tŕný STÔL
Ale ak objem údajov v odovzdanej výberke je veľmi veľký, tak ho vložiť do jedného serializovaného parametra — ťažké, a niekedy aj nemožné, pretože to si vyžaduje jednorazové pridelenie veľkého objemu pamätiNapríklad, potrebujete dlhodobo zbierať veľký balík údajov o udalostiach z vonkajšieho systému a potom ich jednorazovo spracovať na strane databázy.
V tomto prípade bude najlepším riešením použitie :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- opakovať mnohokrát
...
-- tu robíme niečo užitočné so všetkými týmito tabuľkami naraz
Tento spôsob je dobrý práve pre zriedkavý prenos veľkých objemov dát.
Z hľadiska opisu štruktúry svojich údajov sa dočasná tabuľka od "obvyklej" líši len jedným znakom v systémovej tabuľke pg_class, a v pg_type, pg_depend, pg_attribute, pg_attrdef, … — tak to vlastne nie je ničím.
Preto v webových systémoch s veľkým množstvom krátkodobých pripojení pre každé z nich taká tabuľka bude každýkrát generovať nové systémové záznamy, ktoré sú odstránené pri uzavretí pripojenia k databáze. V konečnom dôsledku, nekontrolované používanie TEMP TABLE vedie k "nafukovaniu" tabuliek v pg_catalog a spomaľovaniu mnohých operácií, ktoré ich používajú.
Samozrejme, s tým sa dá bojovať pomocou periodického prechodu VACUUM FULL cez tabuľky systémového katalogu.
Premenné relácie
Predpokladajme, že spracovanie dát z predchádzajúceho prípadu je dostatočne zložitá pre jeden SQL dotaz, ale chceme ju vykonávať dosť často. Teda chceme použiť procedurálne spracovanie v , ale používanie prenosu údajov cez dočasné tabuľky by bolo príliš nákladné.
Použiť $n-parametre na prenos do anonymného bloku tiež nemôžeme. Vyriešiť situáciu nám pomôžu premenné relácie a funkcia current_setting.
Pred verziou 9.2 bolo potrebné vopred nakonfigurovať custom_variable_classes pre "svoje" premenné relácie. V súčasných verziách je možné napísať asi takto:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
V iných podporovaných procedurálnych jazykoch možno nájsť aj iné riešenia.
Poznáte ďalšie spôsoby? Podeľte sa o ne v komentároch!
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish