

Ahoj, Habráci. Dnes začínají lekce první skupiny kurzu . V souvislosti s tím bychom vám chtěli říct, jak probíhal otevřený webinář o tomto kurzu.
V pohovořili jsme o tom, s jakými výzvami se SQL databáze potýkají v éře cloudů a Kubernetes. Také jsme se podívali na to, jak se SQL databáze přizpůsobují a vyvíjejí pod vlivem těchto výzev.
Webinář vedl , Google Cloud Practice Delivery Manager ve společnosti EPAM Systems.
Když byly stromy malé...
Nejprve si připomeňme, jak začínal výběr DBMS na konci minulého století. A není to zase tak těžké, protože výběr DBMS v těch dobách začínal a končil Oracle.
Na konci 90. let - na začátku nul se v podstatě neobjevovalo nic jiného, pokud jde o průmyslově škálovatelné databáze. Ano, existovaly IBM DB2, Sybase a nějaké další databáze, které přicházely a odcházely, ale celkově nebyly tak nápadné na pozadí Oracle. Odpovídající tomu byly dovednosti inženýrů té doby vázány na jediný výběr, který existoval.
Oracle DBA měl umět:
- instalovat Oracle Server z distribuce;
- nastavovat Oracle Server:
- init.ora;
- listener.ora;
— vytvářet:
- tabulková prostory;
- schémata;
- uživatele;
— provádět zálohování a obnovu;
— provádět monitorování;
— řešit neoptimální dotazy.
Přitom se od Oracle DBA zejména neočekávalo:
- umět vybírat optimální DBMS nebo jinou technologii pro ukládání a zpracování dat;
- zajišťovat vysokou dostupnost a horizontální škálovatelnost (to nebyla vždy otázka pro DBA);
- dobře znát předmět, infrastrukturu, aplikační architekturu, OS;
- provádět načítání a ukládání dat, migraci dat mezi různými DBMS.
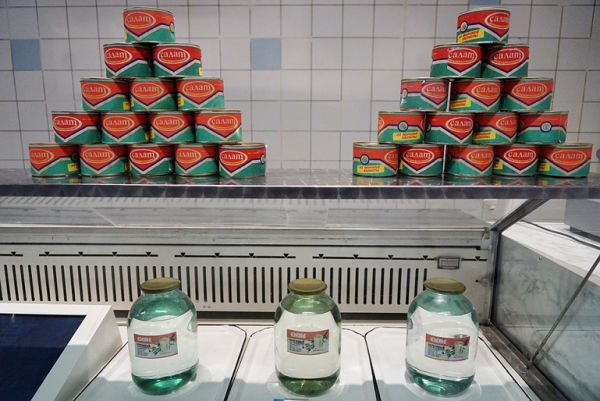
Obecně platí, že pokud se mluví o výběru v těch dobách, připomínal výběr v sovětském obchodě na konci 80. let:
Naše doba
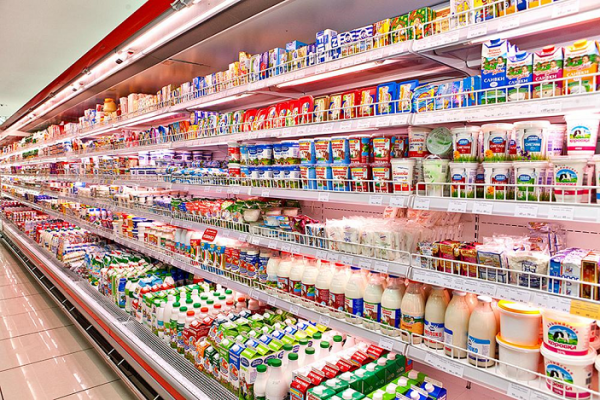
Od té doby se samozřejmě stromy vyrostly, svět se změnil a nějak to vypadá takto:
Také se změnil trh DBMS, což je dobře vidět na čerstvé zprávě společnosti Gartner:
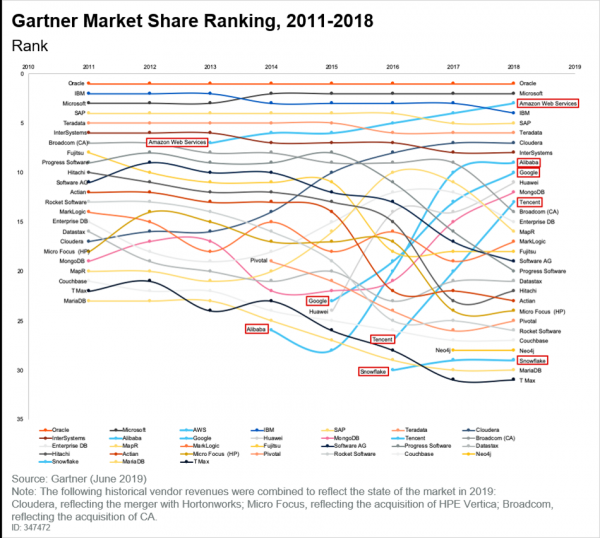
A zde nelze opomenout, že svou niku si našly cloudy, jejichž popularita roste. Pokud si přečtete stejnou zprávu společnosti Gartner, uvidíme následující závěry:
- Mnoho zákazníků je na cestě k převodu aplikací do cloudu.
- Nové technológie sa najprv objavujú v cloude a nie je isté, či sa niekedy presunú do neoblakovej infraštruktúry.
- Model cenotvorby podľa princípu pay-as-you-go sa stal bežným. Všetci chcú platiť len za to, čo využívajú, a to už nie je len trend, ale jednoducho konštatovanie faktu.
Čo teraz?
Dnes sme všetci v cloude. Otázky, ktoré máme, sú otázkami výberu. A ten je obrovský, aj keď hovoríme len o výbere technológií DBMS formátu On-premises. A máme aj spravované služby a SaaS. Týmto sa výber každým rokom len komplikuje.
Okrem otázok výberu pôsobia aj obmedzujúce faktory:
- cena. Mnohé technológie stále niečo stoja;
- zručnosti. Ak hovoríme o slobodnom softvéri, objavuje sa otázka zručností, keďže bezplatný softvér vyžaduje od ľudí, ktorí ho nasadzujú a prevádzkujú, dostatočnú kompetenciu;
- funkcionalita. Nie všetky služby, ktoré sú k dispozícii v cloude a postavené napríklad na základe PostgreSQL, majú rovnaké funkcie ako PostgreSQL On-premises. To je podstatný faktor, ktorý je potrebné poznať a chápať. Navyše, tento faktor nadobúda väčší význam než poznanie nejakých skrytých možností konkrétneho DBMS.
Čo sa teraz očakáva od DA/DE:
- dobré porozumenie predmetnej oblasti a aplikačnej architektúry;
- schopnosť správne vybrať vhodnú technológiu DBMS s ohľadom na stanovenú úlohu;
- schopnosť zvoliť optimálny spôsob realizácie zvolenej technológie v súvislosti s existujúcimi obmedzeniami;
- schopnosť vykonávať prenos a migráciu dát;
- schopnosť realizovať a prevádzkovať vybrané riešenia.
Nasledujúci príklad na báze GCP demonstrates how the choice of a specific technology for data processing is determined by its structure:
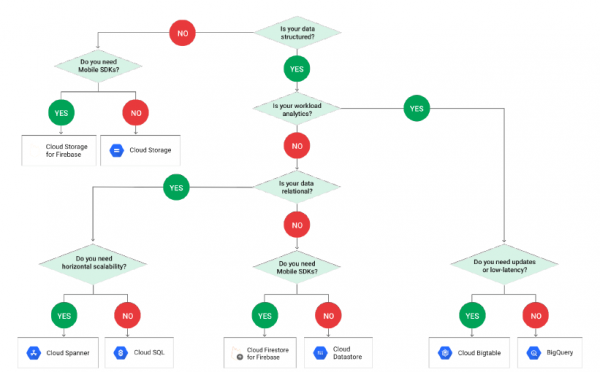
Všimnite si, že v schéme chýba PostgreSQL, a to preto, že sa skrýva pod terminológiou Cloud SQL. A keď sa dostaneme do Cloud SQL, musíme opäť urobiť výber:
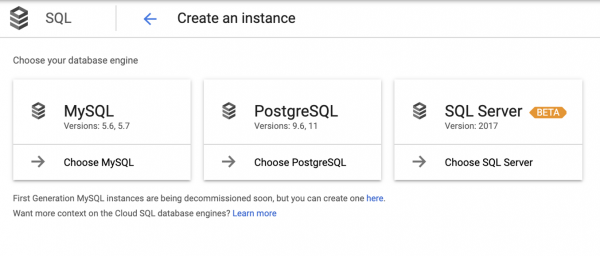
Je potrebné poznamenať, že tento výber nie je vždy zrozumiteľný, a preto sa vývojári aplikácií často riadia intuíciou.
Celkovo:
- Čím ďalej, tým aktuálnejšia sa stáva otázka výberu. A aj keď sa pozrieme len na GCP, managed services a SaaS, nejaké zmienky o RDBMS sa objavujú až na 4. kroku (a vedľa je Spanner). Plus, výber PostgreSQL sa objaví vôbec až na 5. kroku, a vedľa sú ešte MySQL a SQL Server, takže toho je veľa, ale treba si vybrať.
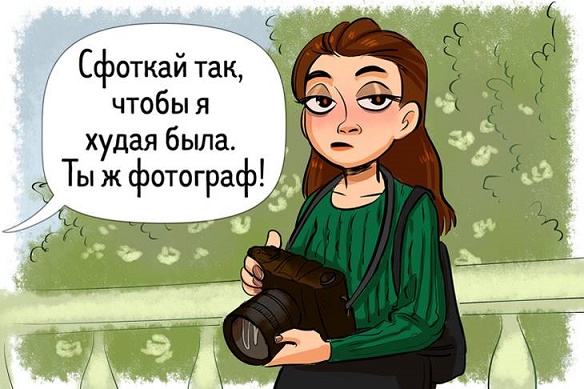
- Nesmú sa zabúdať ani na obmedzenia vzhľadom na pokušenia. Väčšinou všetci chcú Spanner, ale je drahý. Výsledkom je, že typický dopyt vyzerá približne takto: „Urobte nám, prosím, Spanner, ale za cenu Cloud SQL, veď ste profesionáli!“
A čo robiť?
Bez nároku na konečnú pravdu môžeme povedať nasledovné:
Je potrebné zmeniť prístup k vzdelávaniu:
- učiť tak, ako sa učilo predtým DBA, nemá zmysel;
- znalosti jedného produktu sú dnes už nedostatočné;
- a poznať desiatky na úrovni jedného — nemožné.
Je potrebné poznať nielen produkt, ale aj:
- prípad jeho použitia;
- rôzne metódy nasadenia;
- výhody a nevýhody každej z metód;
- podobné a alternatívne produkty, aby bolo možné robiť uvedomelý a optimálny výber, nie vždy v prospech známeho produktu.
A ešte treba vedieť migrovať dáta a rozumieť základným princípom integrácie s ETL.
Skutočný prípad
V nedávnej minulosti bolo potrebné vyrobiť backend pre mobilnú aplikáciu. V čase začatia práce na ňom bol backend už vyvinutý a pripravený na nasadenie a tím vývojárov strávil na tomto projekte asi dva roky. Pri tom boli stanovené nasledovné úlohy:
- vybudovať CI/CD;
- vykonať revíziu architektúry;
- spustiť toto celé do prevádzky.
Aplikácia bola mikroslužbová a kód na Python/Django bol vyvinutý od nuly a hneď v GCP. Pokiaľ ide o cieľovú skupinu, predpokladalo sa, že budú dve regióny — USA a EÚ, a premávka sa rozdeľovala cez globálny load balancer. Všetky pracovné náklady a výpočtová záťaž fungovali v Google Kubernetes Engine.
Pokiaľ ide o údaje, existovali 3 štruktúry:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
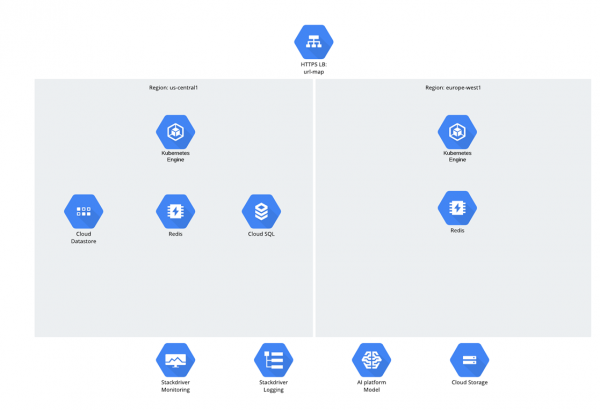
Môže vzniknúť otázka, prečo bol vybraný Cloud SQL? Pravdupovediac, takáto otázka v posledných rokoch vyvoláva akúsi nepríjemnú pauzu — zdá sa, že sa ľudia začali hanbiť za relačné databázy, ale napriek tomu ich naďalej aktívne používajú ;-).
Pokiaľ ide o náš prípad, Cloud SQL bol vybraný z nasledujúcich dôvodov:
- Ako bolo spomenuté, aplikácia bola vyvinutá pomocou Django a obsahuje model, ktorý zobrazuje trvalé dáta z SQL databázy ako objekty Python (Django ORM).
- Samotný framework podporoval dosť obmedzený zoznam SDB:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Na základe toho sme intuitívne vybrali PostgreSQL z tohto zoznamu (predsa len nie Oracle, že?).
Čo chýbalo:
- aplikácia bola nasadená len v dvoch regiónoch a v plánoch bol pridaný tretí (Ázia);
- DB sa nachádzala v severoamerickom regióne (Iowa);
- z pohľadu klienta boli obavy o možné oneskorenia v prístupe z Európy a Ázie a výpadky v prevádzke v prípade výpadku SDB.
Hoci samotné Django môže pracovať s viacerými DB paralelne a deliť ich na čítanie a zápis, zápisov v aplikácii nebolo až tak veľa (viac ako 90 % — čítanie). V celku, ak by sa dalo spraviť read-repliku hlavnej databázy v Európe a Ázii, bolo by to kompromisné riešenie. A čo je na tom také zložité?
Zložitost spočívala v tom, že klient nechcel ustúpiť od používania spravovaných služieb a Cloud SQL. Možnosti Cloud SQL sú momentálne obmedzené. Cloud SQL podporuje vysokú dostupnosť (HA) a read repliku (RR), ale táto RR je podporovaná len v jednom regióne. Vytvorením DB v americkom regióne nie je možné spraviť read-repliku v európskom regióne pomocou Cloud SQL, hoci PostgreSQL to nebráni. Korespondencia so zamestnancami Google nepriniesla výsledky a skončila prísľubmi typu "poznáme problém a pracujeme na ňom, niekedy sa to vyrieši".
Ak by sme zhrnuli možnosti Cloud SQL v bodoch, vyzeralo by to približne takto:
1. Vysoká dostupnosť (HA):
- v rámci jedného regiónu;
- prostredníctvom diskovej replikácie;
- nepoužívajú sa mechanizmy PostgreSQL;
- možné automatické a ručné spravovanie — failover/failback;
- pri prepnutí SDB nie je k dispozícii počas niekoľkých minút.
2. Read replika (RR):
- v rámci jedného regiónu;
- hot standby;
- PostgreSQL streaming replication.
Navyše, ako je to obvyklé, pri výbere technológie sa vždy stretávaš s nejakými obmedzeniami,:
- klient nechcel vytvárať entity a používať IaaS, okrem GKE;
- klient by nechcel nasadzovať self service PostgreSQL/MySQL;
- A Google Spanner would actually be suitable if not for its price, but Django ORM cannot work with it; otherwise, it's a good tool.
Given the situation, the client posed a tricky question: “Can you create something similar that behaves like Google Spanner but also works with Django ORM?”
Solution Option #0
The first thought that came to mind was:
- to stick with CloudSQL;
- there will be no built-in replication between regions in any form;
- to try to connect a replica to the existing Cloud SQL by PostgreSQL;
- to somehow launch a PostgreSQL instance without touching the master.
Unfortunately, it turned out that this approach isn’t possible since there is no access to the host (it is in another project)—pg_hba, etc., and there is no superuser access either.
Solution Option #1
After further reflection and considering the previous circumstances, the thought process shifted somewhat:
- we still try to stay within the framework of CloudSQL, but switch to MySQL, since Cloud SQL by MySQL has an external master, which:
— acts as a proxy for an external MySQL;
— appears as a MySQL instance;
— is designed for migrating data from other clouds or on-premises.
Since setting up MySQL replication does not require access to the host, it generally worked, but it was very unstable and inconvenient. As we pushed forward, it became quite scary, since we were deploying the entire structure using Terraform, and it turned out that the external master is not supported by Terraform. Yes, Google has a CLI, but for some reason, it only worked intermittently—sometimes it would create it, sometimes it wouldn't. Perhaps this is because the CLI was designed for external data migration, not for replicas.
It became clear that Cloud SQL is completely unsuitable. As they say, we did all we could.
Solution Option #2
As we couldn't stay within the bounds of Cloud SQL, we tried to articulate the requirements for a compromise solution. The requirements turned out to be as follows:
- operating in Kubernetes, maximizing the resources and capabilities of Kubernetes (DCS, …) and GCP (LB, …);
- eliminating clutter from a bunch of unnecessary things in the cloud like HA proxy;
- the ability to run HA PostgreSQL or MySQL in the main region; in other regions—HA from the main region's RR plus its copy (for reliability);
- multi-master (we didn't want to interface with it, but this wasn’t very critical)
.
As a result of these requirements, a potential solution finally appeared on the horizon.vhodné možnosti SDB a obvazov:
- MySQL Galera;
- CockroachDB;
- nástroje PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
Technológia MySQL Galera bola vyvinutá spoločnosťou Codership a predstavuje plugin pre InnoDB. Vlastnosti:
- multi master;
- synchronná replikácia;
- čítať z akéhokoľvek uzla;
- zapisovať na akýkoľvek uzol;
- vstavaný mechanizmus HA;
- existuje Helm chart od Bitnami.
CockroachDB
Podľa opisu je to úplne úžasná vec a predstavuje open source projekt napísaný v Go. Hlavným účastníkom je Cockroach Labs (založená bývalými zamestnancami z Googlu). Táto relačná SDB bola od začiatku vytvorená ako rozdelená (s horizontálnym škálovaním "z krabice") a odolná voči zlyhaniu. Jej autori zo spoločnosti si stanovili cieľ "kombinovať bohatstvo funkčnosti SQL s horizontálnou dostupnosťou bežnou pre riešenia NoSQL."
Z príjemného bonusu — podpora postgres protokolu pripojenia.
Pgpool
Je to nadstavba nad PostgreSQL, v skutočnosti nová entita, ktorá preberá všetky pripojenia a spracováva ich. Má svoj load balancer a parser, licencia je BSD. Poskytuje široké možnosti, ale vyzerá trochu desivo, pretože existencia novej entity by mohla byť zdrojom niektorých dodatočných dobrodružstiev.
Patroni
To je posledné, na čo padol pohľad, a ako sa ukázalo, nie nadarmo. Patroni je open source nástroj, ktorý v podstate predstavuje daemon na Pythone, umožňujúci automaticky spravovať klastre PostgreSQL s rôznymi typmi replikácie a automatickým prepínaním rolí. Zariadenie sa ukázalo byť veľmi zaujímavé, pretože je dobre integrované s K8s a neprináša žiadne nové entity.
Čo sme nakoniec vybrali
Výber nebol jednoduchý:
- CockroachDB — skvelé, ale riskantné;
- MySQL Galera — tiež celkom dobré, používa sa na viacerých miestach, ale MySQL;
- Pgpool — príliš veľa zbytočných entít, taká si integrovanosť s cloudom a K8s;
- Patroni — vynikajúca integrácia s K8s, žiadne zbytočné entity, dobre sa integruje s GCP LB.
Takže výber padol na Patroni.
Zhrnutie
Nastal čas zhrnúť krátke výsledky. Áno, svet IT infraštruktúry sa zásadne zmenil a toto je len začiatok. A ak kedysi boli cloudové riešenia len iným typom infraštruktúry, teraz je to iné. Navyše, inovácií v cloude sa neustále objavujú a mohli by sa objavovať len v cloude a až neskôr, pomocou startupov, prenášať do on-premises.
Pokiaľ ide o SQL, SQL tu zostane. To znamená, že je dôležité poznať PostgreSQL a MySQL a vedieť s nimi pracovať, no ešte dôležitejšie je vedieť ich správne aplikovať.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish