

Článok sa skladá z dvoch častí:
- Krátky popis niektorých architektúr sietí na detekciu objektov na obrázkoch a segmentáciu obrázkov s najzrozumiteľnejšími odkazmi na zdroje. Snažil som sa vyberať video vysvetlenia a ideálne v ruštine.
- Druhá časť spočíva v pokuse pochopiť smer vývoja architektúr neurónových sietí a technológií na ich základe.
Obrázok 1 – Pochopiť architektúry neurónových sietí nie je jednoduché
Všetko začalo tým, že som vytvoril dve demonštračné aplikácie na klasifikáciu a detekciu objektov na telefóne Android:
- , keď sa údaje spracúvajú na serveri a prenášajú na telefón. Klasifikácia obrázkov (image classification) troch typov medveďov: hnedého, čierneho a plyšového.
- , keď sa údaje spracúvajú priamo na telefóne. Detekcia objektov (object detection) troch typov: lieskový orech, figy a datle.
Existuje rozdiel medzi úlohami klasifikácie obrázkov, detekciou objektov na obrázku a . Preto vznikla potreba zistiť, ktoré architektúry neurónových sietí detegujú objekty na obrázkoch a ktoré môžu segmentovať. Našiel som nasledujúce príklady architektúr s najzrozumiteľnejšími odkazmi na zdroje:
- Séria architektúr na báze R-CNN (Rregióny s Ckonvolučnými Nneurónovými Nsieťami): R-CNN, Fast R-CNN, , . Na detekciu objektu na obrázku sa pomocou mechanizmu Region Proposal Network (RPN) vyberajú obmedzené regióny (bounding boxes). Pôvodne sa namiesto RPN používal pomalší mechanizmus Selective Search. Potom vybrané obmedzené regióny sa posielajú na vstup bežnej neurónovej siete na klasifikáciu. V architektúre R-CNN sú jasné cykly „for“ prechádzania cez obmedzené regióny, celkovo až 2000 prechodov cez internú sieť AlexNet. V dôsledku jasných cyklov „for“ sa spomaľuje rýchlosť spracovania obrázkov. Počet jasných cyklov, prechodov cez internú neurónovú sieť, sa znižuje s každou novou verziou architektúry, pričom sa vykonáva desiatky ďalších zmien na zvýšenie rýchlosti a na nahradenie úlohy detekcie objektov segmentáciou objektov v Mask R-CNN.
- (Ylen Opozrite Lkniha Once) – prvá neurónová sieť, ktorá rozpoznávala objekty v reálnom čase na mobilných zariadeniach. Vyznačuje sa schopnosťou rozlišovať objekty na jeden prechod (stačí sa pozrieť raz). To znamená, že v architektúre YOLO nie sú žiadne jasné cykly „for“, čo umožňuje rýchlu prácu siete. Napríklad taká analógia: pri operáciách s maticami v NumPy nie sú taktiež žiadne jasné cykly „for“, ktoré sú realizované na nižších úrovniach architektúry prostredníctvom programovacieho jazyka C. YOLO používa mriežku z vopred určených okien. Aby sa ten istý objekt neidentifikoval viackrát, používa sa koeficient prekrytia okien (IoU, Intersection over Union). Táto architektúra funguje v širokom rozsahu a má vysokú : model môže byť trénovaný na fotografiách, ale pritom dobre fungovať aj na kreslených obrazcoch.
- (Single Shot MultiBox Detector) – využíva najúspešnejšie „hacky“ architektúry YOLO (napríklad non-maximum suppression) a pridáva nové, aby neurová sieť pracovala rýchlejšie a presnejšie. Vyznačuje sa schopnosťou rozlišovať objekty na jeden prechod za pomoci vopred nastavenej mriežky okien (default box) na pyramídach obrázkov. Pyramída obrázkov je zakódovaná v konvolučných tenzoroch pri sekvenčných operáciách konvolúcie a pooling. (pri operácii max-pooling sa priestorová dimenzia zmenšuje). Týmto spôsobom sú rozpoznávané veľké aj malé objekty na jeden prechod siete.
- MobileSSD (MobilnéNetV2 + SSD) – kombinácia dvoch architektúr neurónových sietí. Prvá sieť pracuje rýchlo a zvyšuje presnosť rozpoznávania. MobileNetV2 sa používa namiesto VGG-16, ktorá bola pôvodne používaná v . Druhá sieť SSD určuje polohu objektov na obrázku.
- – veľmi malá, ale presná neurónová sieť. Sama o sebe nerieši problém detekcie objektov. Avšak môže byť použitá v kombinácii rôznych architektúr. A používať sa môže v mobilných zariadeniach. Vyznačuje sa tým, že najprv sú dáta komprimované na štyri 1×1 konvolučné filtre a potom rozšírené na štyri 1×1 a štyri 3×3 konvolučné filtre. Jedna taká iterácia kompresie-rozšírenia dát sa nazýva „Fire Module“.
- (Semantic Image Segmentation with Deep Convolutional Nets) – segmentácia objektov na obrázku. Hlavnou črtou architektúry je rozptýlená (dilated convolution) konvolúcia, ktorá zachováva priestorové rozlíšenie. Nasleduje fáza postprocessing výsledkov s použitím grafického pravdepodobnostného modelu (conditional random field), čo umožňuje odstrániť malé šumy v segmentácii a zlepšiť kvalitu segmentovaného obrázka. Pod hrozivým názvom „grafický pravdepodobnostný model“ sa skrýva bežný Gaussov filter, ktorý je aproximovaný podľa piatich bodov.
- Snažil som sa pochopiť zariadenie (Single-Shot Refinement Neural Network for Object Detection), ale málo som pochopil.
- Tiež som sa pozrel, ako funguje technológia „pozornosť“ (attention): , , . Hlavnou črtou architektúry „pozornosť“ je automatické vyčlenenie regiónov zvýšenej pozornosti na obrázku (RoI, Regions of Interest) pomocou neurónovej siete nazvanej Attention Unit. Regióny zvýšenej pozornosti sú podobné obmedzeným regiónom (bounding boxes), ale na rozdiel od nich nie sú fixované na obrázku a môžu mať rozmazané hranice. Následne sa z regiónov zvýšenej pozornosti vyberajú znaky (features), ktoré sa „napájajú“ do rekurentných neurónových sietí s architektúrami . Rekurentné neurónové siete dokážu analyzovať vzťah znakov v sekvencii. Rekurentné neurónové siete sa pôvodne používali na preklady textu do iných jazykov, a teraz aj na preklad a .
Počas štúdia týchto architektúr som pochopil, že ničomu nerozumiem. A nejde o to, že by moja neurónová sieť mala problémy s mechanizmom pozornosti. Tvorenie všetkých týchto architektúr sa zdá ako nejaký obrovský hackathon, kde autori súťažia v hackoch. Hack (hack) – rýchle riešenie ťažkej programovej úlohy. To znamená, že medzi všetkými týmito architektúrami nie je viditeľná a zrozumiteľná logická súvislosť. Všetko, čo ich spája – je súbor najúspešnejších hackov, ktoré si navzájom požičiavajú, plus spoločná pre všetkých (spätné šírenie chyby, backpropagation). Nie je ! Nie je jasné, čo meniť a ako optimalizovať existujúce dosiahnutia.
V dôsledku absencie logickej väzby medzi hackmi je mimoriadne ťažké si ich zapamätať a prakticky ich uplatniť. Ide o fragmentované znalosti. V tom najlepšom prípade si zapamätáme niekoľko zaujímavých a neočakávaných momentov, ale väčšina z toho, čo bolo pochopené a nepochopené, sa už o niekoľko dní vytratí z pamäti. Bolo by dobré, keby sa aspoň názov architektúry pripomenul za týždeň. A to pritom bolo na čítanie článkov a pozeranie prehľadových videí vynaložené niekoľko hodín a dokonca dní pracovného času!
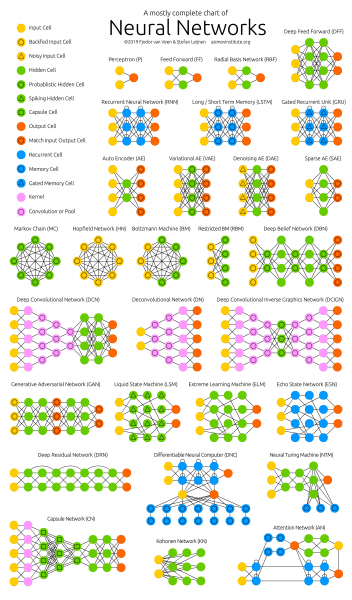
Obrázok 2 –
Väčšina autorov vedeckých článkov, podľa môjho osobného názoru, robí všetko pre to, aby aj tieto fragmentované znalosti neboli čitateľom pochopené. Ale gerundívne konštrukcie v desiatich riadkových vetách s formulami, ktoré sú prevzaté 'zo stropu' – to je téma na samostatný článok (problém ).
Z tohto dôvodu vznikla potreba systematizovať informácie o neurónových sieťach a tým zvýšiť kvalitu pochopenia a zapamätania. Hlavnou témou analýzy jednotlivých technológií a architektúr umelých neurónových sietí sa stala táto úloha: zistiť, kam to všetko smeruje, a nie usporiadanie nejakej konkrétnej neurónovej siete samostatne.
Kam všetko to smeruje. Hlavné výsledky:
- Počet startupov v oblasti strojového učenia v posledných dvoch rokoch . Možná príčina: 'neurónové siete prestali byť niečím novým'.
- Každý bude schopný vytvoriť fungujúcu neurónovú sieť na riešenie jednoduchého problému. Na to si vezme hotový model z 'zoo modelov' (model zoo) a natrénuje poslednú vrstvu neurónovej siete () na hotových dátach z alebo z v bezplatnom .
- Veľkí výrobcovia neurónových sietí začali vytvárať 'zoo modelov' (model zoo). S ich pomocou je možné rýchlo vytvoriť komerčnú aplikáciu: pre TensorFlow, pre PyTorch, pre Caffe2, pre Chainer a .
- Neurónové siete fungujúce v reálnom čase na mobilných zariadeniach. Od 10 do 50 snímok za sekundu.
- Použitie neurónových sietí v telefónoch (TF Lite), v prehliadačoch (TF.js) a v (IoT, Iinternet of Tvecí). Obzvlášť v telefónoch, ktoré už podporujú neurónové siete na úrovni 'hardvéru' (neuróny akcelerátory).
- Každé zariadenie, oblečenie a možno aj jedlo budú mať IP-v6 adresu a budú si medzi sebou komunikovať" - .
- Rast počtu publikácií o strojovom učení začal (zdvojenie každé dva roky) od roku 2015. Zjavne sú potrebné neurónové siete na analýzu článkov.
- Nasledujúce technológie získavajú popularitu:
- PyTorch – popularita rastie rýchlo a zdá sa, že predbehne TensorFlow.
- Automatická optimalizácia hyperparametrov AutoML – popularita rastie postupne.
- Postupné znižovanie presnosti a zvyšovanie rýchlosti výpočtov: , algoritmy , nepresné (približné) výpočty, kvantizácia (keď sú váhy neurónových sietí prevádzané na celé čísla a kvantizované), neuroakcelerátory.
- Preklad a .
- Vytvorenie , teraz už v reálnom čase.
- Hlavné v DL - to sú veľké dáta, ale ich zber a označovanie nie je jednoduché. Preto sa rozvíja automatizácia označovania () pre neurónové siete za pomoci neurónových sietí.
- S neurónovými sieťami sa Computer Science náhle stala experimentálnou vedou a objavil sa .
- IT peniaze a popularita neurónových sietí sa objavili zároveň, keď sa výpočty stali trhovou hodnotou. Ekonomika zo zlatokošového typu prechádza na zlato-peniazo-výpočtový typ.Pozrite sa na môj článok o a dôvodoch vzniku IT peňazí.
Postupne sa objavuje nová (Strojové učenie & Hlboké učenie), ktorá je založená na predstavení programu ako súboru trénovaných neurónových modelov.
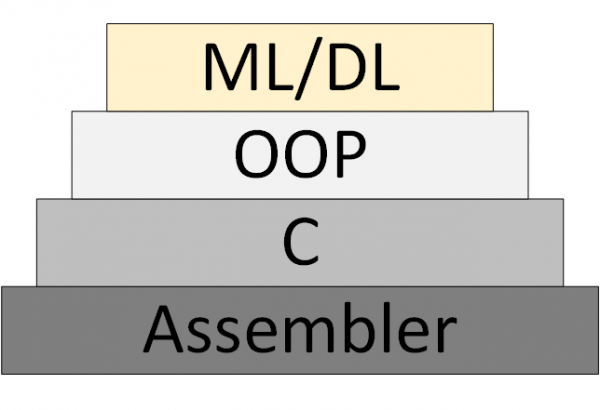
Obrázok 3 – ML/DL ako nová metodológia programovania.
Avšak dodnes sa neobjavila "teória neurónových sietí", v rámci ktorej je možné myslieť a pracovať systémovo. To, čo sa dnes nazýva "teóriou", sú v skutočnosti experimentálne, heuritické algoritmy.
Odkazy na moje a nielen moje zdroje:
- Newsletter o Data Science. Hlavne o spracovaní obrazov. Kto chce dostávať, nech pošle e-mail (foobar167<gaff-gaff>gmail<dot>com). Odkazy na články a videá posielam podľa toho, ako sa hromadia materiály.
- Celkový , ktoré som naštudoval a ktoré by som chcel absolvovať.
- , s ktorými by sa malo začať pri učení neurónových sietí. Plus brožúra .
- , kde si každý nájde niečo zaujímavé pre seba.
- Extrémne užitočné sa ukázali videokanály o analýze vedeckých článkov o Data Science. Nájdite ich, prihláste sa na odber a pošlite odkazy svojim kolegom a mne tiež. Príklady:
- ako s podrobnými pokynmi a otvoreným zdrojovým kódom.
Ďakujem za pozornosť!
Zdroj: habr.com
