

V súčasnosti existujú hotové (proprietárne) riešenia na monitorovanie IP (TS) tokov, napríklad a , majú pomerne bohatú sadu funkcií a zvyčajne takéto riešenia majú veľkí operátori, ktorí sa zaoberajú TV službami. V tomto článku sa popisuje riešenie na báze open source projektu , určené na minimálnu kontrolu IP (TS) tokov prostredníctvom počítadla CC (continuity counter) a bitrate. Možná varianta použitia — kontrola straty paketov alebo celého toku prostredníctvom prenajatej L2 linky (ktorú nie je možné normálne monitorovať, napríklad načítaním počítadiel strát v frontoch).
Veľmi stručne o TSDuck
TSDuck je open source (licencia 2-Clause BSD) softvér (sada konzolových nástrojov a knižnica na vývoj vlastných nástrojov alebo pluginov) na manipuláciu s TS tokmi. Ako vstup dokáže pracovať s IP (multicast/unicast), http, hls, DVB tunermi, dektec DVB-ASI demodulátorom, je vybavený interným generátorom TS toku a čítaním z súborov. Ako výstup môže byť zápis do súboru, IP (multicast/unicast), hls, dektec DVB-ASI a HiDes modulátorov, prehrávačov (mplayer, vlc, xine) a drop. Medzi vstupom a výstupom je možné zahrnúť rôzne procesory prevádzky, napríklad premapovanie PID, skrývanie/odkrývanie, analýzu CC počítadiel, počítanie bitrate a iné typové operácie pre TS toky.
V tomto článku sa ako vstup použijú IP toky (multicast), procesory bitrate_monitor (z názvu je jasné, čo to je) a continuity (analýza CC počítadiel). Bez väčších problémov je možné nahradiť IP multicast iným typom vstupu, ktorý podporuje TSDuck.
Existujú TSDuck pre väčšinu aktuálnych operačných systémov. Pre Debian nie sú dostupné, ale podarilo sa ich bez problémov zostaviť pre Debian 8 a Debian 10.
Ďalej sa používa verzia TSDuck 3.19-1520, ako operačný systém sa používa Linux (na prípravu riešenia sa použil Debian 10, pre reálne použitie — CentOS 7)
Príprava TSDuck a OS
Pred monitorovaním reálnych tokov je potrebné sa uistiť, že TSDuck správne funguje a nedochádza k stratám na úrovni sieťovej karty alebo OS (soketu). To je potrebné, aby sa neskôr nemuselo hádať, kde došlo k stratám — na sieti alebo „vnútri servera“. Straty na úrovni sieťovej karty môžete skontrolovať príkazom ethtool -S ethX, ladenie sa vykonáva rovnakým ethtool (zvyčajne je potrebné zvýšiť RX-buffer (-G) a niekedy vypnúť niektoré offloads (-K)). Ako všeobecné odporúčanie je možné poradiť použiť samostatný port na prijímanie analyzovaného prenosu, ak je to možné; to minimalizuje falošné alarmy spojené s tým, že strata sa stala práve na porte analyzátora kvôli prítomnosti iného prenosu. Ak takáto možnosť nie je (používa sa mini-počítač/NUC s jedným portom), je veľmi žiaduce nastaviť prioritu analyzovaného prenosu vo vzťahu k ostatnému na zariadení, do ktorého je pripojený analyzátor. Pokiaľ ide o virtuálne prostredia, tu treba byť opatrný a vedieť nájsť straty paketov od fyzického portu až po aplikáciu vo vnútri virtuálneho stroja.
Generovanie a prijímanie toku v rámci hostiteľa
Ako prvý krok prípravy TSDuck budeme generovať a prijímať prenos v rámci jedného hostiteľa pomocou netns.
Pripravujeme prostredie:
ip netns add P #vytvoríme netns P, v ktorom sa bude analyzovať prenos
ip link add type veth #vytvoríme veth-pár - veth0 zostáva v netns predvolene (do tohto rozhrania sa bude generovať prenos)
ip link set dev veth1 netns P #veth1 - umiestnime do netns P (na tomto rozhraní sa bude prijímať prenos)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #zdvíhame IP na veth1, nezáleží na tom, aké presne
ip netns exec P ip ro add default via 192.0.2.2 #nastavíme predvolenú trasu v rámci nents P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #vypíname IPv6 na veth0 - robí sa to, aby sa do počítača TX nedostávalo cudzí odpad
ifconfig veth0 up #zdvíhame rozhranie veth0
ip route add 239.0.0.1 dev veth0 #vytvárame trasu, aby OS smerovalo prenos k 239.0.0.1 v smere k veth0
Prostredie je pripravené. Spúšťame analyzátor prenosu:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
kde „-p 1 -t 1“ znamená, že je potrebné počítať bitrate každú sekundu a zobrazovať informácie o bitrate každú sekundu
Spúšťame generátor prenosu so rýchlosťou 10 Mbit/s:
tsp -I craft
 -P regulate -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
kde "-p 7 -e" znamená, že treba zabalit 7 TS paketov do 1 IP paketu a robiť to striktne (-e), t.j. vždy čakať na 7 TS paketov od posledného procesora pred odoslaním vytvorením IP paketu.
Analizátor začína vypisovať očakávané správy:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, TS bitrate: 9,970,016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, TS bitrate: 10,022,656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, TS bitrate: 9,980,544 bits/s
Teraz pridáme pár dropov:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPa objavia sa správy tohto typu:
* 2020/01/03 14:57:11 - continuity: packet index: 80,745, PID: 0x0000, missing 7 packets
* 2020/01/03 14:57:11 - continuity: packet index: 83,342, PID: 0x0000, missing 7 packets
čo je očakávané. Vypneme stratu paketov (ip netns exec P iptables -F) a pokúsime sa zvýšiť bitrate generátora na 100 Mbit/s. Analizátor hlási kopu CC-chýb a okolo 75 Mbit/s namiesto 100. Snažíme sa zistiť, kto je zodpovedný — či generátor nestíha, alebo je problém inde, za týmto účelom spustíme generáciu fixného počtu paketov (700000 TS-paketov = 100000 IP-paketov):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Ako je zrejmé, bolo vygenerovaných presne 100000 IP-paketov (151925460-151825460). To znamená, že zisťujeme, čo sa deje s analyzátorom, za týmto účelom porovnávame so súčtom RX na veth1, ktorý presne zodpovedá súčtu TX na veth0, ďalej sa pozrieme, čo sa deje na úrovni soketu:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Tu je viditeľný počet dropov = 24355. V TS-paketoch to predstavuje 170485 alebo 24.36% z 700000, takže vidíme, že tých 25% strateného bitrate je spôsobené dropmi v UDP sokete. Dropy v UDP sokete obvykle vznikajú z dôvodu nedostatku buffera, pozrieme sa, aká je veľkosť buffera soketu podľa predvolených hodnôt a maximálna veľkosť buffera soketu:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Takže ak aplikácie explicitne nepožadujú veľkosť buffera, sokety sa vytvárajú s bufferom veľkosti 208 kB, ale ak požadujú viac, aj tak nedostanú požadované. Keďže v tsp pre IP-vstup môžeme nastaviť veľkosť buffera (—buffer-size), veľkosť soketu podľa predvolených hodnôt sa nebude meniť, iba nastavíme maximálnu veľkosť buffera soketu a uvedieme veľkosť buffera explicitne cez argumenty tsp:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
S takým ladením buffera soketu teraz vykazovaný bitrate predstavuje približne 100 Mbit/s, CC-chýb nie je.
Pri spotrebe CPU samotnou aplikáciou tsp. V prípade jedného jadra i5-4260U CPU @ 1.40GHz na analýzu prúdu 10Mbit/s bude potrebné 3-4% CPU, pri 100 Mbit/s — 25%, 200Mbit/s — 46%. Pri nastavení % straty paketov sa zaťaženie CPU prakticky nezvyšuje (ale môže klesať).
Na výkonnejšom hardvéri sa podarilo bez problémov generovať a analyzovať toky nad 1Gb/s.
Testovanie na reálnych sieťových kartách
Po testovaní na veth páre je potrebné zobrať dva hosty alebo dva porty jedného hosta, spojiť porty medzi sebou, na jednom spustiť generátor, na druhom analytik. Tu sa nečakali žiadne prekvapenia, ale v skutočnosti všetko závisí od hardvéru, čím slabšie, tým zaujímavejšie to tu bude.
Použitie získaných údajov systémom monitorovania (Zabbix)
tsp nemá žiadne machine-readable API ako SNMP alebo podobné. Správy CC je potrebné agregovať aspoň po 1 sekunde (pri vysokom percentu straty paketov ich môže byť stovky/tisíce/desiatky tisíc za sekundu, závisí od bitrate).
Týmto spôsobom, aby sa zachovala aj informácia a nakreslili grafy podľa CC-chýb a bitrate a spravili nejaké havárie, môžu byť nasledujúce možnosti:
- Rozparsovať a agregovať (podľa CC) výstup tsp, t.j. transformovať ho do požadovanej podoby.
- Prispôsobiť samotný tsp a/alebo procesorové pluginy bitrate_monitor a continuity, aby sa výsledok poskytoval v machine-readable forme, vhodnej pre systém monitorovania.
- Napísať svoju aplikáciu nad knižnicou tsduck.
Je zrejmé, že z hľadiska pracovného zaťaženia je variant 1 najjednoduchší, najmä vzhľadom na to, že samotný tsduck je napísaný v nízkoúrovňovom (podľa moderných štandardov) jazyku (C++).
Jednoduchý prototyp parsera+agregátora na bash ukázal, že pri prúde 10Mbit/s a 50% strate paketov (najhorší variant) proces bash spotreboval 3-4 krát viac CPU, než samotný proces tsp. Takýto variant vývoja situácie je neprijateľný. Vlastne kúsok tohto prototypu je nižšie.
Nudle na bashi
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Okrem toho, že to funguje neprijateľne pomaly, bash nemá poriadne vlákna, bash úlohy sú samostatné procesy a musel som vykonať zápis raz za sekundu hodnoty missingPackets na vedľajšom efekte (pri prijímaní správy o bitrate, ktoré prichádzajú každú sekundu). Nakoniec bol bash ponechaný na pokoji a rozhodlo sa napísať obal (parser+agregátor) v golang. Spotreba CPU podobného kódu na golang je 4-5 krát menšia než samotného procesu tsp. Zrýchlenie obalu nahradením bash za golang sa podarilo asi 16-násobne a celkový výsledok je prijateľný (overhead pri CPU v najhoršom prípade 25%). Zdrojový súbor na golang sa nachádza .
Spustenie obalu
Na spustenie obalu bol vytvorený najjednoduchší šablónový servis pre systemd (). Predpokladá sa, že samotný obal bol skompilovaný do binárneho súboru (go build tsduck-stat.go), umiestneného v /opt/tsduck-stat/. Predpokladá sa, že sa používa golang s podporou monotonic clock (>=1.9).
Aby ste vytvorili inštanciu služby, musíte vykonať príkaz systemctl enable tsduck-stat@239.0.0.1:1234, potom spustiť pomocou systemctl start tsduck-stat@239.0.0.1:1234.
Discovery zo Zabbixu
Aby zabbix mohol robiť discovery spustených služieb, bol vytvorený (discovery.sh), vo formáte potrebnom pre Zabbix discovery, predpokladá sa, že je umiestnený tam istom — v /opt/tsduck-stat. Na spúšťanie discovery cez zabbix-agent je potrebné pridať do adresára s konfiguráciami zabbix-agenta na pridanie užívateľského parametra.
Zabbix šablóna
(tsduck_stat_template.xml) obsahuje pravidlo autoobnovy, prototypy prvkov dát, grafov a spúšťačov.
Stručný kontrolný zoznam (nuž a keby sa niekto rozhodol využiť)
- Uistite sa, že tsp nedropuje pakety v "ideálnych" podmienkach (generátor a analyzátor sú pripojené priamo), ak sú tam dropy, pozri bod 2 alebo text článku o tom.
- Urobiť ladenie maximálneho buffera socketu (net.core.rmem_max=8388608).
- Skorpilovať tsduck-stat.go (go build tsduck-stat.go).
- Umiestniť šablónu služby do /lib/systemd/system.
- Spustiť služby pomocou systemctl, skontrolovať, že začali objavovať sa počítadlami (grep "" /dev/shm/tsduck-stat/*). Počet služieb podľa počtu multicastových tokov. Tu môže byť potrebné vytvoriť trasu do multicastovej skupiny, možno vypnúť rp_filter alebo vytvoriť trasu do zdrojovej IP.
- Spustiť discovery.sh, uistiť sa, že generuje json.
- Prilohovať konfiguráciu zabbix-agenta, reštartovať zabbix-agenta.
- Nahrajte šablónu do Zabbixu, aplikujte ju na hostiteľský stroj, na ktorom prebieha monitoring a je nainštalovaný Zabbix-agent, počkajte asi 5 minút, a skontrolujte, či sa objavili nové prvky dát, grafy a spúšťače.
Výsledok
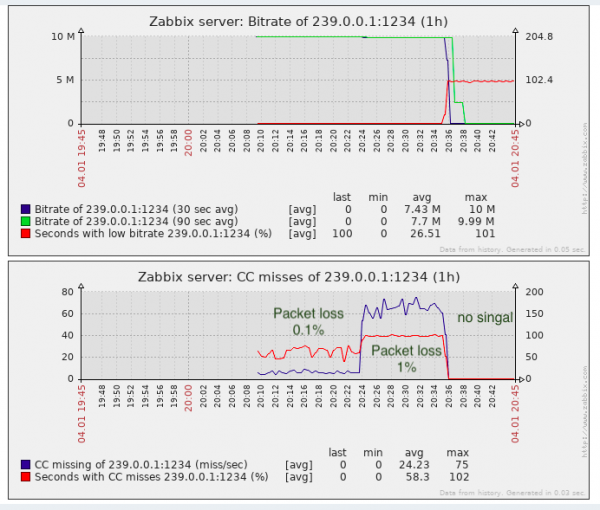
Na identifikáciu straty paketov je to takmer dostatočné, aspoň je to lepšie, než nemonitorovať vôbec.
V skutočnosti môžu CC-„straty“ vzniknúť pri spojovaní video fragmentov (aspoň z toho, čo viem, takto sa robia vkladania v miestnych televíznych centrách v Rusku, t.j. bez prepočítavania CC-sčítatela), na to treba pamätať. V proprietárnych riešeniach sa tento problém čiastočne obchádza detekciou značiek SCTE-35 (ak sú pridávané generátorom toku).
Z hľadiska monitorovania kvality prenosu chýba monitorovanie jitteru (IAT), pretože televízne zariadenia (či už modulátory alebo koncové zariadenia) majú na tento parameter požiadavky a nie vždy je možné zväčšiť jitbuffer do nekonečna. A jitter môže začať kolísať, keď sa na tranzite používa zariadenie s veľkými buffermi a QoS pre prenos takého realtime toku nie je nastavený, alebo nie je dostatočne dobre nastavený.
Zdroj: habr.com
