

Čas na reporting v Excela sa rýchlo kráti - trend smerom k pohodlným nástrojom na prezentáciu a analýzu informácií je viditeľný vo všetkých oblastiach. Interně sme už dlho diskutovali o digitalizácii reportingu a vybrali sme systém vizualizácie a self-service analytiky Tableau. Alexander Bezuglyj, vedúci oddelenia analytických riešení a reportingu skupiny „M.Video-Eldorado“, sa podelil o skúsenosti a výsledky pri vytváraní produkčného dashboardu.
Poviem hneď, nie všetko, čo sme zamýšľali, sa podarilo realizovať, no skúsenosť bola zaujímavá a dúfam, že bude užitočná aj pre vás. A ak niekto má nápady, ako to mohlo byť lepšie - budem veľmi vďačný za rady a nápady.
Pod katom sa dozviete, s čím sme sa stretli a čo sme sa naučili.
Odkiaľ sme začínali
V „M.Video-Eldorado“ máme dobre vypracovaný model dát: štruktúrované informácie s požadovanou hĺbkou ukladania a obrovské množstvo reportov v pevnej forme (pozri podrobnejšie ). Z nich analytici vytvárajú buď kontingenčné tabuľky alebo formátované rozosielky v Excela, alebo pekné prezentácie v PowerPointe pre koncových používateľov.
Približne pred dvoma rokmi sme namiesto reportov v pevnej forme začali vytvárať analytické reporty v SAP Analysis (doplnenie pre Excel, v podstate kontingenčná tabuľka nad OLAP motorom). Avšak tento nástroj nedokázal pokryť potreby všetkých používateľov, väčšina pokračovala v používaní informácií, ktoré analytici dodatočne spracovali.
Naši koncoví používatelia sú rozdelení do troch kategórií:
Top manažment. Žiadajú informácie v dobre prezentovanom a prehľadne pochopiteľnom formáte.
Middle-manažment, pokročilí používatelia. Zaujímajú sa o analýzu dát a sú schopní samostatne vytvárať reporty, ak majú k dispozícii nástroje. Práve oni sa stali kľúčovými používateľmi analytických reportov v SAP Analysis.
Masy používateľov. Nie sú zainteresovaní v samostatnej analýze dát, používajú reporty s obmedzenou voľnosťou, vo forme rozosielok a kontingenčných tabuliek v Excela.
Náš cieľ bol pokryť potreby všetkých používateľov a poskytnúť im jeden pohodlný nástroj. Rozhodli sme sa začať u vrcholového manažmentu. Potrebovali pohodlné panely na analýzu kľúčových obchodných výsledkov. Tak sme začali s Tableau a na úvod sme vybrali dve oblasti: predajné ukazovatele v maloobchode a online s obmedzenou hĺbkou a šírkou analýzy, ktoré pokryli približne 80% údajov, ktoré vrcholový manažment požadoval.
Keďže používateľmi palubných dosiek bol vrcholový manažment, objavil sa ďalší doplnkový KPI produktu – rýchlosť odozvy. Nikto nebude čakať 20-30 sekúnd, kým sa údaje aktualizujú. Navigácia by mala trvať 4-5 sekúnd, a ešte lepšie, aby bola okamžitá. A to sa nám, žiaľ, nepodarilo dosiahnuť.
Takto vyzeral návrh našej hlavnej palubnej dosky:
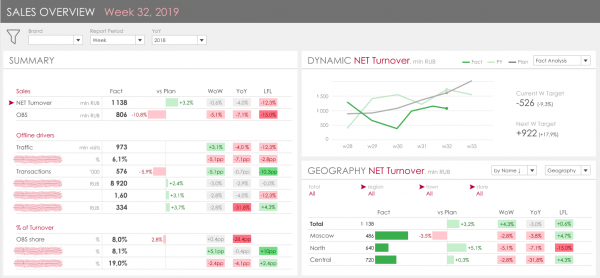
Kľúčová myšlienka – spojiť hlavné KPI-drivers, ktorých sa nakoniec nazbieralo 19, zľava a zobrazovať ich dynamiku a rozdelenie podľa hlavných atribútov vpravo. Úloha sa zdá byť jednoduchá, vizualizácia logická a zrozumiteľná, kým sa nezanoříte do detailov.
Detail 1. Objem údajov
Hlavná tabuľka predaja za rok obsahuje približne 300 miliónov riadkov. Pretože je potrebné odraziť aj dynamiku v porovnaní s predchádzajúcim a predpredchádzajúcim rokom, objem údajov týkajúcich sa skutočných predajov je približne 1 miliarda riadkov. A navyše sú samostatne uchovávané informácie o plánovaných údajoch a blok internetového predaja. Preto, aj keď sme použili stĺpcovú in-memory DB SAP HANA, rýchlosť vykonania dopytu na výber všetkých ukazovateľov za jeden týždeň z aktuálnych úložných priestorov bola okolo 15-20 sekúnd. Riešenie tohto problému je samozrejmé – dodatočná materializácia údajov. Ale aj v nej sú podvodné kamene, o ktorých budem hovoriť nižšie.
Detail 2. Neaditívne ukazovatele
Mnohé z našich KPI sú viazané na počet účteniek. Tento ukazovateľ predstavuje COUNT DISTINCT počtu riadkov (hlavičiek účteniek) a ukazuje rôzne sumy v závislosti od vybraných atribútov. Pre príklad, ako by sa tento ukazovateľ a odvodené od neho mali počítať:
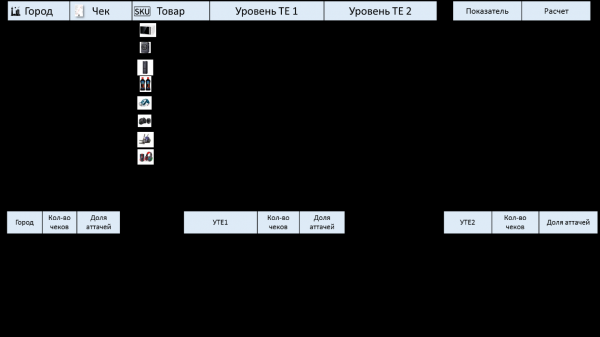
Pre správnosť výpočtov je možné:
- Vykonávať výpočty podobných ukazovateľov naživo v úložisku;
- Vykonávať výpočet na celom objeme údajov v Tableau, t.j. na požiadanie v Tableau odovzdávať všetky údaje podľa vybraných filtrov na úrovni pozície účteniek;
- Vytvoriť materializovaný pohľad, v ktorom budú vypočítané všetky ukazovatele vo všetkých variantoch výberov, poskytujúcich rôzne neaditívne výsledky.
Je jasné, že v príklade UTE1 a UTE2 – to sú atribúty materiálu, ktoré predstavujú tovarovú hierarchiu. Nie je to statická vec, cez ňu prebieha riadenie v rámci spoločnosti, keďže za rôzne tovarové skupiny zodpovedajú rôzni manažéri. Mali sme mnoho globálnych revízií tejto hierarchie, keď sa menili všetky úrovne, preskúmavali sa vzťahy, ako aj neustále drobné zmeny, keď jedna skupina prechádza z jedného uzla do druhého. V bežnej správe sa to všetko počíta na fly z atribútov materiálu, v prípade materializácie týchto údajov je potrebné vyvinúť mechanizmus na sledovanie takýchto zmien a automatického nahrávania historických dát. Je to veľmi netriviálna úloha.
Detail 3. Porovnanie dát
Tento bod je podobný predchádzajúcemu. Podstata je v tom, že v spoločnosti je pri analýze zvykom vytvárať niekoľko úrovní porovnania s predchádzajúcim obdobím:
Porovnanie s predchádzajúcim obdobím (deň k dňu, týždeň k týždňu, mesiac k mesiacu)
V tomto porovnaní sa predpokladá, že v závislosti od zvoleného používateľského obdobia (napríklad 33. týždeň roka) musíme ukázať dynamiku k 32. týždňu. Ak by sme vybrali dáta za mesiac, napríklad máj, toto porovnanie by ukázalo dynamiku k aprílu.
Porovnanie s predchádzajúcim rokom
Hlavný aspekt spočíva v tom, že pri porovnávaní po dňoch a týždňoch nezohľadňujete rovnaký deň minulého roka, t.j. nemôžete len vziať aktuálny rok mínus jeden. Musíte sa pozrieť na porovnávaný deň v týždni. Pri porovnávaní mesiacov je to naopak, treba zohľadniť presne ten istý kalendárny deň minulého roka. Existujú aj nuansy s prestupnými rokmi. Vo vstupných úložiskách je všetka informácia rozdelená po dňoch, nie sú tam samostatné polia s týždňami, mesiacmi alebo rokmi. Preto na získanie úplného analytického prehľadu v paneli, musíme počítať nie jeden časový úsek, napríklad týždeň, ale 4 týždne a potom tieto údaje porovnať, odrážať dynamiku a odchýlky. Samozrejme, túto logiku porovnávania v dynamike môžeme realizovať buď v Tableau, alebo na strane výkladnej skrine. Áno, o týchto detailoch sme samozrejme vedeli a rozmýšľali už v štádiu projektovania, ale ich vplyv na výkon konečného dashboards bolo ťažké predvídať.
Pri implementácii dashboardu sme išli dlhým Agile spôsobom. Našou úlohou bolo čo najrýchlejšie poskytnúť na testovanie funkčný nástroj s potrebnými údajmi. Preto sme postupovali cez sprinty a sústredili sa na minimalizáciu prác na strane aktuálneho úložiska.
Časť 1. Viera v Tableau
Na zjednodušenie IT podpory a rýchle prijatie zmien sme sa rozhodli implementovať logiku výpočtu neaditívnych ukazovateľov a porovnanie predchádzajúcich období v Tableau.
Etapa 1. Všetko naživo, žiadne úpravy výkladných skrín.
V tejto etape sme prepojili Tableau s aktuálnymi výkladnými skrinkami a rozhodli sme sa zistiť, ako sa bude počítať počet pokladníc za jeden rok.
Výsledok:
Odpoveď bola sklamaním – 20 minút. Prenos dát cez sieť, vysoké zaťaženie Tableau. Uvedomili sme si, že logiku s neaditívnymi ukazovateľmi musíme realizovať na HANA. To nás veľmi nevyľakalo, už sme mali podobné skúsenosti s BO a Analysis a vedeli sme, ako vytvoriť rýchle výkladné skrinky v HANA, ktoré správne počítajú neaditívne ukazovatele. Teraz ostávalo ich prispôsobiť pre Tableau.
Etapa 2. Optimalizujeme výkladné skrinky, žiadna materializácia, všetko naživo.
Vytvorili sme novú prezentáciu, ktorá na vyžiadanie poskytovala potrebné údaje pre TABLEAU. Vzhľadom na to sme dosiahli dobrý výsledok, keď sme skrátili čas na vytvorenie všetkých ukazovateľov na 9-10 sekúnd za týždeň. Úprimne sme očakávali, že čas odozvy dashboardu v Tableau bude na prvom otvorení 20-30 sekúnd a potom vďaka cache 10-12 sekúnd, čo by nás celkovo uspokojilo.
Výsledok:
Prvé otvorenie dashboardov: 4-5 minút
Každý klik: 3-4 minúty
Takúto dodatočnú zmenu v práci prezentácie nikto neočakával.
Časť 2. Hlbšie prenikanie do Tableau
Krok 1. Analýza výkonu Tableau a rýchly tuning
Začali sme analyzovať, na čo Tableau spotrebováva najviac času. Na to existujú veľmi dobré nástroje, čo je určite plus pre Tableau. Hlavným problémom, ktorý sme zistili, boli veľmi zložité SQL dopyty, ktoré Tableau konštruovalo. Tieto dopyty sa týkali predovšetkým:
— transponovaním údajov. Keďže Tableau nemá nástroje na transponovanie datasetov, aby sme mohli vytvoriť ľavú časť dashboardu s podrobným zobrazením všetkých KPI, museli sme vytvoriť tabuľku cez case. Veľkosť SQL dopytov v DB dosiahla 120 000 znakov.
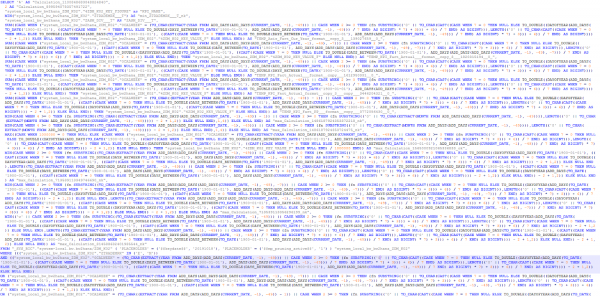
— výberom časového obdobia. Takýto dopyt na úrovni DB trval dlhšie na kompiláciu než na vykonanie:
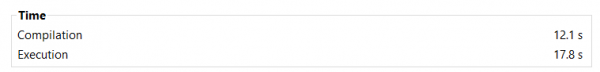
T.j. spracovanie dopytu 12 sekúnd + 5 sekúnd vykonanie.
Rozhodli sme sa zjednodušiť logiku výpočtov na strane Tableau a presunúť ďalšiu časť výpočtov na prezentáciu a úroveň DB. To prinieslo dobré výsledky.
Najprv sme transponovanie vyriešili na vyžiadanie, urobili sme ho cez full outer join na finálnom kroku výpočtu VIEW, podľa takéhoto prístupu, popísaného na wiki a .
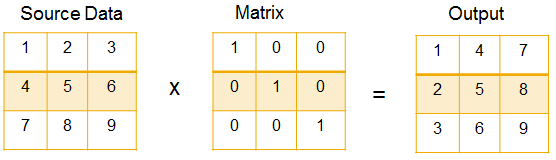
To znamená, že sme vytvorili nastavovaciu tabuľku – maticu transponovania (21x21) a získali všetky ukazovatele v riadkovej štruktúre.
Bolo:
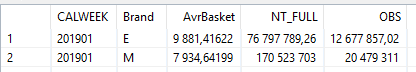
Stalo sa:
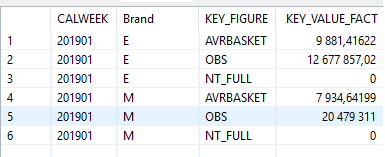
Transponovanie databázy si takmer nevyžaduje žiadny čas. Dotaz na všetky ukazovatele za týždeň stále prebiehal približne za 10 sekúnd. Ale stratila sa flexibilita pri zostavovaní dashboardu pre konkrétny ukazovateľ, t. j. pre pravú časť dashboardu, kde je prezentovaná dynamika a podrobný rozpis konkrétneho ukazovateľa, predtým vitrína reagovala za 1-3 sekundy, pretože dotaz sa týkal jedného ukazovateľa, ale teraz databáza vždy vyberala všetky ukazovatele a filtrovala výsledok až pred jeho vrátením do Tableau.
Výsledkom je, že rýchlosť fungovania dashboardu sa znížila takmer na tretinu.
Výsledok:
- 5 sekúnd — parsovanie dashboardu, vizualizácií
- 15-20 sekúnd — príprava na kompiláciu dotazov s vykonaním predpočtov v Tableau
- 35-45 sekúnd — kompilácia SQL dotazov a ich súbežné po sebe idúce vykonávanie v Hana
- 5 sekúnd — spracovanie výsledkov, triedenie, prepočítavanie vizualizácií v Tableau
- Samozrejme, takéto výsledky nespokojili podnik, a my sme pokračovali v optimalizácii.
Fáza 2. Minimum logiky v Tableau, úplná materializácia
Chápali sme, že vytvoriť dashboard s časom odozvy niekoľkých sekúnd na vitríne, ktorá funguje 10 sekúnd, nie je možné, a zvažovali sme možnosti materializácie dát na strane databázy presne pod požadovaný dashboard. Ale narazili sme na globálny problém, opísaný vyššie – neaditívne ukazovatele. Nedokázali sme dosiahnuť, aby pri zmene filtrov alebo rozloženiach Tableau flexibilne prechádzal medzi rôznymi vitrínami a úrovňami, ktoré boli predpočítané pre rôzne hierarchie produktov (v príklade tri dotazy bez UTE, s UTE1 a UTE2 tvoria rôzne výsledky). Preto sme sa rozhodli zjednodušiť dashboard, vzdať sa hierarchie produktov v dashboarde a pozrieť sa, aký rýchly môže byť v zjednodušenej verzii.
Takže na tejto poslednej fáze sme zhromaždili samostatný sklad, v ktorom sme uložili všetky KPI v transponovanej podobe. Na strane databázy akýkoľvek dotaz na takýto sklad trvá 0,1 – 0,3 sekundy. V dashboarde sme dosiahli nasledujúce výsledky:
Prvé otvorenie: 8-10 sekúnd
Akýkoľvek klik: 6-7 sekúnd
Čas, ktorý Tableau potrebuje, sa skladá z:
- 0,3 sekundy — parsovanie dashboardu a kompilácia SQL dotazov
- 1,5-3 sekundy — vykonávanie SQL dotazov v Hana pre hlavné vizualizácie (spúšťa sa súbežne s bodom 1)
- 1,5-2 sek. — renderovanie, prepočítavanie vizualizácií
- 1,3 sek. — vykonávanie dodatočných SQL dotazov na získanie relevantných hodnôt filtrov (Značka, Divízia, Mesto, Obchod), parcing výsledkov
Ak by sme mali zhrnúť
Nástroj Tableau sa nám páčil z pohľadu vizualizácie. Počas fázy návrhu sme zvažovali rôzne vizualizačné prvky a všetky sme ich našli v knižniciach, vrátane zložitých viacúrovňových segmentácií a viacdriverových waterfall.
Pri внедрении dashboardov s kľúčovými ukazovateľmi predaja sme sa stretli so ťažkosťami v oblasti výkonu, ktoré sme zatiaľ nedokázali prekonávať. Strávili sme viac ako dva mesiace a dostali funkčne neúplný dashboard, ktorého rýchlosť reakcie sa blížila k prípustnému. A pre seba sme si urobili závery:
- Tableau nedokáže pracovať s veľkými objemami dát. Ak máte vo svojej pôvodnej dátovej modeli viac ako 10 GB dát (približne 200 mil. x 50 riadkov), tak sa dashboard výrazne spomaľuje – od 10 sekúnd po niekoľko minút na každý klik. Experimentovali sme s live-connectom aj s extraktom. Rýchlosť práce je porovnateľná.
- Obmedzenie pri používaní viacerých úložísk (datasetov). Neexistuje možnosť štandardnými prostriedkami uviesť vzťah medzi datasetmi. Ak použijete obchádzajúce riešenia na prepojenie datasetov, silne to ovplyvní výkon. V našom prípade sme zvažovali možnosť materializácie dát v každom potrebnom reze pohľadov a na týchto materializovaných datasetoch robiť prepínania so zachovaním predtým vybraných filtrov – to sa ukázalo ako nemožné v Tableau.
- V Tableau nie je možné vytvoriť dynamické parametre. Nemôžete parameter, ktorý sa používa na filtrovanie datasetu v extrakte alebo pri live-connecte, vyplniť výsledkom inej výberky z datasetu alebo výsledku iného SQL dotazu, iba natívnym vstupom používateľa alebo konštantou.
- Obmedzenia súvisiace s tvorbou dashboardu s prvkami OLAP|Súhrnnej tabuľky.
V MSTR, SAP SAC, SAP Analysis, ak pridávate do správy dátový súbor, všetky objekty sú medzi sebou navzájom prepojené predvolene. V Tableau to tak nie je, prepojenie je potrebné nastaviť manuálne. To je možno flexibilnejšie, ale pre všetky naše dashboardy je to povinnosť vo vzťahu k elementom – preto to predstavuje dodatočné náklady na prácu. Navyše, ak robíte prepojené filtre, aby, povedzme, pri filtrovaní regiónu bol zoznam miest obmedzený len na mestá tohto regiónu, okamžite narazíte na sekvenčné dotazy k DB alebo extraktu, čo viditeľne spomaľuje dashboard. - Obmedzenia funkcií. Ako nad extraktom, tak aj THE MORE nad dátovým súborom z Live-connectu nie je možné vykonávať hromadné transformácie. Toto je možné prostredníctvom Tableau Prep, ale predstavuje to dodatočné náklady na prácu a ďalší nástroj, ktorý sa treba naučiť a udržiavať. Napríklad, nemôžete transponovať dáta, urobiť join dát sám so sebou. To sa dá dosiahnuť transformáciami na jednotlivých stĺpcoch alebo poliach, ktoré je potrebné vyberať cez case alebo if, a to vedie k veľmi zložitým SQL dotazom, pri ktorých databáza stráca väčšinu času na kompiláciu textu dotazu. Tieto nepružnosti nástroja bolo potrebné riešiť na úrovni vitríny, čo vedie k zložitosti úložiska, dodatočným zaťaženiam a transformáciám.
Nezavreli sme dvere pred Tableau. Ale ako nástroj schopný vytvárať priemyselné dashboardy a prostriedok, ktorým je možné nahradiť a digitalizovať celý systém firemnej správy, Tableau neberieme do úvahy.
Aktívne vyvíjame podobný dashboard na inom nástroji a paralelne sa snažíme prehodnotiť architektúru dashboardu v Tableau, aby sme ju ešte viac zjednodušili. Ak bude komunitu zaujímať, radi sa podelíme o výsledky.
Taktiež očakávame vaše nápady alebo rady, ako v Tableau môžeme vytvoriť rýchle dashboardy nad takými veľkými objemami dát, pretože máme aj web, kde je dát oveľa viac ako v maloobchode.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish