

9. januára bol vydaný Pandas 1.0.0rc. Predchádzajúca verzia knižnice bola 0.25.
Prvý major release obsahuje množstvo skvelých noviniek, vrátane vylepšeného automatického sumarizovania DataFrame, viacerých formátov výstupu, nových typov dát a dokonca aj novej dokumentačnej stránky.
Všetky zmeny si môžete pozrieť , v článku sa obmedzíme na malý, menej technický prehľad toho najdôležitejšieho.
Nainštalovať knižnicu môžete ako zvyčajne pomocou pip, ale keďže v čase písania tohto článku je Pandas 1.0 stále release candidate, bude potrebné výslovne uviesť verziu:
pip install --upgrade pandas==1.0.0rc0Buďte opatrní: keďže ide o major release, aktualizácia môže rozbiť starý kód!
Mimochodom, s touto verziou bola úplne ukončená podpora pre Python 2 (čo môže byť dobrý dôvod — pozn. prekl.). Pandas 1.0 vyžaduje minimálne Python 3.6+, takže ak si nie ste istí, overte si, ktorú verziu máte nainštalovanú:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Skontrolovať verziu Pandas je najjednoduchšie takto:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Vylepšené automatické sumarizovanie s DataFrame.info
Moje obľúbené novinky je aktualizácia metódy DataFrame.info. Funkcia sa stala oveľa čitateľnejšou, čo robí proces preskúmania dát ešte jednoduchším:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Výstup tabuliek vo formáte Markdown
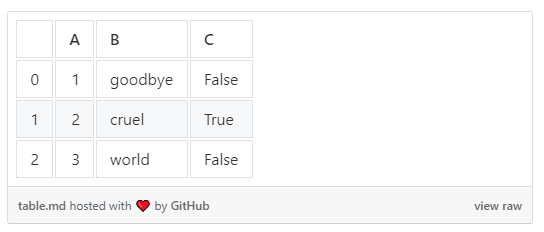
Rovnako príjemnou novinkou je možnosť exportovať DataFrame do tabuliek Markdown pomocou DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
To znateľne uľahčuje publikovanie tabuliek na stránkach ako Medium pomocou github gists.
Nové typy pre reťazce a logické hodnoty
V bonuse Pandas 1.0 boli pridané aj nové experimentálne typy. Ich API sa ešte môže zmeniť, takže používajte ich s opatrnosťou. Ale vo všeobecnosti Pandas odporúča používať nové typy všade tam, kde to dáva zmysel.
Zatiaľ je potrebné konvertovanie vykonávať výslovne:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Všimnite si, ako sa stĺpec Dtype zobrazuje nové typy — string a bool.
Najužitočnejšou vlastnosťou nového typového reťazca je možnosť vybrať iba stĺpce reťazcov z dátových rámcov. To môže výrazne zjednodušiť analýzu textových údajov:
df.select_dtypes("string")Predtým nebolo možné vyberať stĺpce reťazcov bez explicitného uvedenia mien.
Viac o nových typoch sa môžete dočítať .
Ďakujeme, že ste dočítali! Úplný zoznam zmien, ako už bolo spomenuté, si môžete pozrieť .
Zdroj: habr.com
