

Heisenbergov princíp neurčitosti hovorí, že nie je možné zároveň zmerať polohu objektu a jeho rýchlosť. Ak sa objekt pohybuje, nemá presnú polohu. A ak je polohy, znamená to, že nemá rýchlosť.
Čo sa týka mikroslužieb na platforme Red Hat OpenShift (a spravovaných Kubernetes), vďaka vhodnému softvéru s otvoreným kódom môžu súčasne hlásiť o svojej výkonnosti a funkčnosti. Toto samozrejme neodporuje starému Heisenbergovi, ale odstraňuje neurčitosť pri práci s cloudovými aplikáciami. Istio umožňuje jednoducho organizovať sledovanie a monitoring týchto aplikácií, aby sme mali všetko pod kontrolou.
Definujeme terminológiu
Pod sledovaním (Tracing) chápeme ako zaznamenávanie systémovej aktivity. Znie to dosť všeobecne, ale v skutočnosti jedno z hlavných pravidiel spočíva v tom, aby sa dáta sledovania ukládali do príslušného úložiska, bez ohľadu na ich formátovanie. A všetka práca na vyhľadávaní a analýze dát sa prenáša na ich konzumenta. V Istio sa používa systém sledovania Jaeger, ktorý implementuje model dát OpenTracing.
Sledovaním (Traces, a slovo „sledovanie“ je tu použité v zmysle „stopy“, ako napríklad v balistickej expertíze) budeme označovať dáta, ktoré úplne popisujú priebeh požiadavky alebo úlohy, ako sa hovorí, „od a do“. Napríklad všetko, čo sa deje od momentu, keď používateľ klikne na tlačidlo na webovej stránke, až po moment vrátenia dát, vrátane všetkých zapojených mikroslužieb. Môžeme povedať, že jedna trasa úplne opisuje (alebo modeluje) priebeh požiadavky tam a späť. V jaegerovskom rozhraní sú stopy rozložené na jednotlivé zložky podľa časovej osi, ako keby sa reťaz rozložila na jednotlivé články. Ibaže namiesto článkov je stopa zložená z takzvaných spanov.
Span – to je interval od začiatku vykonávania úlohy po jej dokončenie. Pokračujúc v analógii, môžeme povedať, že každý span predstavuje samostatný článok reťaze. Span môže mať (alebo nemusí mať) jeden alebo viac podriadených spanov. Ako dôsledok, span najvyššej úrovne (root span) bude mať rovnakú celkovú dĺžku ako stopa, s ktorou súvisí.
Monitorovanie – to je vlastne samotné sledovanie vašej sústavy – očami, cez UI alebo pomocou automatizačných prostriedkov. V jadre monitorovania sú údaje trasovania. V Istio je monitorovanie implementované pomocou Promethea a má zodpovedajúce UI. Prometheus podporuje automatické monitorovanie s využitím upozornení Alerts a Alert Managers.
Zanechávame značky
Aby sa trasovanie stalo možným, aplikácia musí vytvoriť kolekciu span-ov. Potom je potrebné ich exportovať do Jaeger, aby ten na oplátku vytvoril vizuálne zobrazenie trasovania. Medzi iným tieto span-y označujú názov operácie, ako aj časové pečiatky jej začatia a ukončenia. Odovzdávanie span-ov sa vykonáva preposielaním určených pre Jaeger hlavičiek HTTP požiadaviek od prichádzajúcich požiadaviek k odchádzajúcim požiadavkám. V závislosti od používaného programovacieho jazyka môže byť k tomu potrebná drobná modifikácia zdrojového kódu aplikácií. Nižšie je uvedený príklad kódu v Jave (pri použití rámca Spring Boot), ktorý pridáva hlavičky B3 (štýl Zipkin) k vášmu požiadavku v konfiguračnej triede Spring:
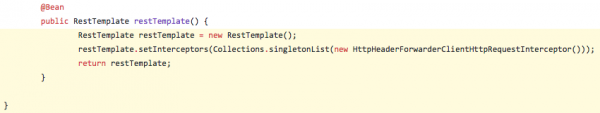
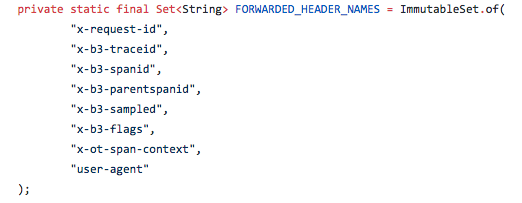
Pri tom sa používajú nasledujúce nastavenia hlavičiek:
Ak používate Javu, kód môžete nechať tak, ako je, a jednoducho pridať niekoľko riadkov do POM súboru Maven a nastaviť premenné prostredia. Tu sú riadky, ktoré treba pridať do súboru POM.XML, aby sa implementoval Jaeger Tracer Resolver:
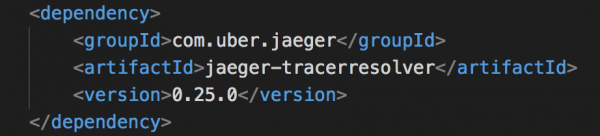
A zodpovedajúce premenné prostredia sa určujú v Dockerfile:
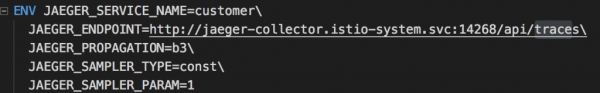
Všetko, teraz je všetko nastavené a naše mikroslužby začnú generovať údaje trasovania.
Pozrieme sa na to v hrubých rysoch
Súčasťou Istio je jednoduchá kontrolná panel na báze Grafany. Keď je všetko nastavené a funguje na platforme Red Hat OpenShift PaaS (v našom príklade je Red Hat OpenShift a Kubernetes nasadené na minishift), tento panel sa spúšťa nasledujúcou príkazom:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
Panel Grafana umožňuje rýchlo zhodnotiť výkon systému. Fragment tohto panela je zobrazený na nasledujúcom obrázku:
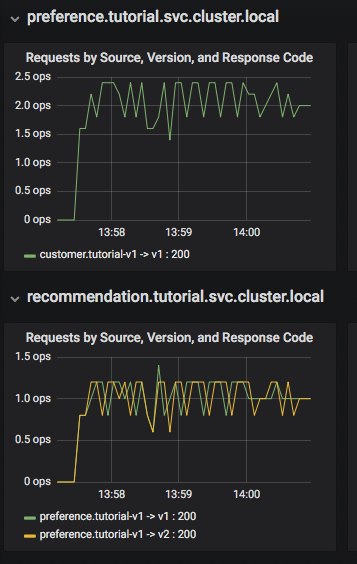
Tu je vidno, že mikroslužba customer volá mikroslužbu preference v1, a tá zase volá mikroslužby recommendation v1 a v2. Na paneli Grafana je blok Dashboard Row pre vysokú úroveň metrik ako celkový počet požiadaviek (Global Request Volume), podiel úspešných požiadaviek (success rates) a chyby 4xx. Okrem toho je tam zobrazenie Server Mesh s grafmi pre každú službu a blok Services Row na prehľad podrobných informácií o každom kontajneri pre každú službu.
Teraz sa pozrime hlbšie
Pri správne nastavenom trasovaní Istio, takpovediac, priamo z krabice, umožňuje podrobne preskúmať analýzu výkonnosti systému. V Jaegerovskom UI môžete prezerať trasovania a vidieť, ako ďaleko a hlboko siahajú, a taktiež vizuálne lokalizovať úzke miesta vo výkonnosti. Pri použití Red Hat OpenShift na platforme minishift spustíte Jaeger UI nasledujúcim príkazom:
minishift openshift service jaeger-query --in-browser
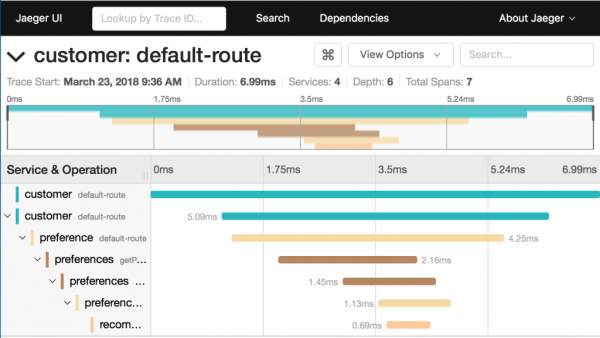
Čo môžeme povedať o trasovaní na tomto snímku:
- Rozdeľuje sa na 7 span’ov.
- Celkový čas vykonania je 6,99 ms.
- Na mikroslužbu recommendation, ktorá je posledná v reťazci, sa míňa 0,69 ms.
Diagramy tohto typu umožňujú rýchlo sa zorientovať v situácii, keď kvôli jednému neefektívnemu servisu trpí výkonnosť celého systému.
A teraz si situáciu skomplikujme a spustíme dva inštancie mikroslužby recommendation:v2 príkazom oc scale –replicas=2 deployment/recommendation-v2. Takto budeme vyzerať s pod’ami:
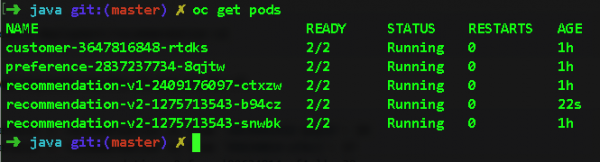
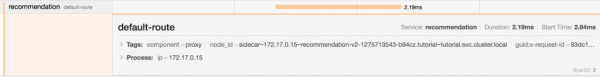
Ak sa teraz prepneme späť do Jaeger a rozbalíme span pre službu recommendation, uvidíme, na ktorý pod sa smerujú požiadavky. Takto môžeme ľahko lokalizovať spomalenia na úrovni konkrétneho pod‘a. Pri tom treba pozerať na pole node_id:
Kam a ako všetko chodí
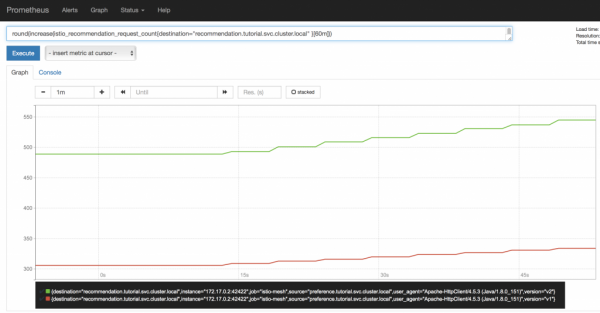
Teraz prechádzame do rozhrania Prometheus a úplne očakávane vidíme, že požiadavky medzi druhou a prvou verziou služby recommendation sa delia v pomere 2:1, striktne podľa počtu funkčných pod’ov. A tento graf sa bude dynamicky meniť pri škálovaní pod’ov nahor a nadol, čo bude obzvlášť užitočné pri Canary Deployment (túto schému nasadenia si podrobnejšie priblížime nabudúce).
Všetko len začína
V skutočnosti sme dnes, povedzme, len jemne načrtli studnicu užitočných informácií o Jaeger, Grafana a Prometheus. V podstate to bolo naším cieľom – nasmerovať vás správnym smerom a odkryť perspektívy Istio.
A pamätajte, všetko toto je už integrované do Istio. Pri použití určitých programovacích jazykov (napríklad Java) a rámcov (napríklad Spring Boot) je možné to všetko zrealizovať bez zásahu do samotného kódu aplikácií. Áno, kód bude potrebné mierne upraviť, ak používate iné jazyky, najmä ide o Nodejs alebo C#. Ale pretože sledovateľnosť (čítaj, „trasovanie“) je jednou z povinných podmienok pri vytváraní spoľahlivých cloudových systémov, budú musieť byť v každom prípade úpravy kódu, či už máte Istio alebo nie. Tak prečo nevyužiť úsilie s väčším osohom?
Aspoň na to, aby ste vždy mohli odpovedať na otázky „kde?“ a „ako rýchlo?“ s 100% istotou.
Chaos inžinierstvo v Istio: presne tak to bolo navrhnuté
Schopnosť rozbíjať veci pomáha zabezpečiť, aby sa nerozbili
Testovanie softvéru nie je len zložitá, ale aj dôležitá úloha. Zatiaľ čo testovanie správnosti (napríklad vracia funkcia správny výsledok) je jedna vec, testovanie v podmienkach nespolehlivej siete je úplne iná úloha (často sa predpokladá, že sieť funguje bez výpadkov, a to je prvé z ôsmich omylov týkajúcich sa distribuovaných výpočtov). Jednou z komplikácií pri riešení tejto úlohy je, ako simulovať zlyhania v systéme alebo ich zámerne zavádzať prostredníctvom takzvanej fault injection. To sa dá robiť úpravou zdrojového kódu samotnej aplikácie. Ale potom budete testovať už nie váš pôvodný kód, ale jeho verziu, ktorá špeciálne simuluje zlyhania. V dôsledku toho riskujete spadnúť do smrteľného objatia fault injection a naraziť na gejzínbagy – zlyhania, ktoré zmiznú pri pokuse ich odhaliť.
A teraz vám ukážeme, ako Istio pomáha zvládnuť tieto komplikácie s ľahkosťou.
Ako všetko vyzerá, keď je všetko v poriadku
Pozrime sa na nasledujúci scenár: máme dva pod’y pre našu mikroslužbu recommendation, ktorú sme vzali z učebnice o Istio. Jeden pod je označený ako v1 a druhý ako v2. Ako vidíme, zatiaľ všetko funguje skvele:
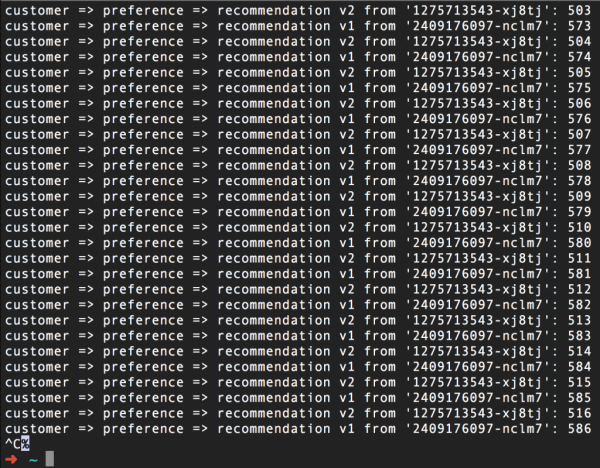
(Mimochodom, číslo napravo je len počítadlo volaní pre každý pod.)
Ale predsa potrebujeme niečo iné, že? Dobre, pokúsime sa všetko rozbiť, úplne sa nedotýkajúc zdrojového kódu.
Vyvolávame poruchy v mikroservise
Nižšie je uvedený yaml súbor pre pravidlo smerovania Istio, ktoré v polovici prípadov spôsobí zlyhanie (chybu) servera 503):
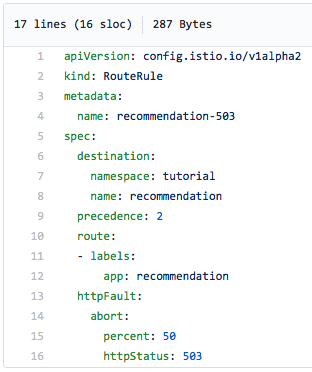
Upozorňujeme, že jasne uvádzame, že v polovici prípadov by mala byť vrátená chyba 503.
A takto bude vyzerať snímka obrazovky spustenej v cykle príkazu curl po aktivácii tohto pravidla na simuláciu porúch. Ako vidíme, polovica požiadaviek vracia chybu 503, bez ohľadu na to, na ktorý pod – v1 alebo v2 – sú poslané:
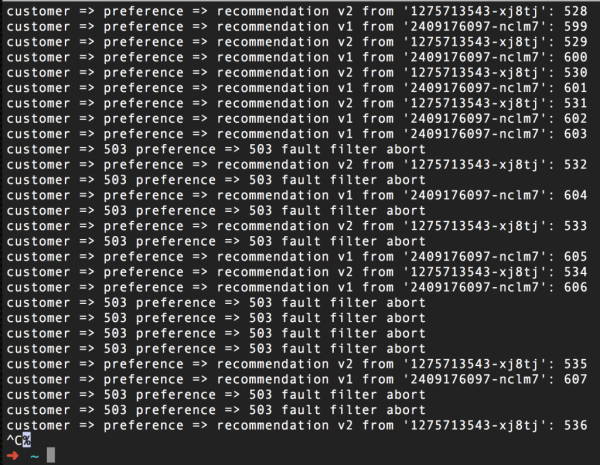
Na obnovenie normálnej činnosti stačí odstrániť toto pravidlo, v našom prípade príkazom istioctl delete routerule recommendation-503 -n tutorial. Tu Tutorial je názov projektu Red Hat OpenShift, v ktorom pracuje náš kurz o Istio.
Vykonávame umelé oneskorenia
Umelé chyby 503 pomáhajú otestovať systém odolnosti voči poruchám, ale schopnosť predpovedať a spracovávať oneskorenia by vás mala ešte viac ohromiť. A konec koncov, oneskorenia sa v skutočnom živote vyskytujú častejšie ako poruchy. Pomalý mikroservis je jedom, z ktorého trpí celý systém. Vďaka Istio je možné otestovať kód zodpovedný za spracovanie oneskorení, aniž by ste ho pritom menili. Najprv ukážeme, ako to urobiť v prípade umele zavedených sieťových oneskorení.
Majte na pamäti, že po takomto testovaní možno budete musieť (alebo budete chcieť) upraviť svoj kód. Dobrá správa je, že v tomto prípade budete konať proaktívne, nie reaktívne. Takto by mal vyzerať cyklus vývoja: kódovanie-testovanie-spätná väzba-kódovanie-testovanie…
Takto vyzerá pravidlo, ktoré... Aj keď viete čo? Istio je také jednoduché a tento yaml súbor je tak zrozumiteľný, že všetko v tomto príklade hovorí samo za seba, len sa pozrite:
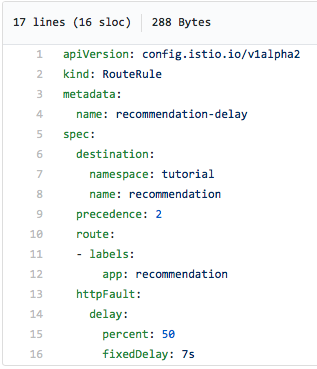
V polovici prípadov nastane 7-sekundové oneskorenie. A to rozhodne nie je to isté, ako keby sme do pôvodného kódu vložili príkaz sleep, pretože Istio naozaj zadrží požiadavku na 7 sekúnd. Keďže Istio podporuje sledovanie Jaeger, toto oneskorenie je jasne viditeľné v užívateľskom rozhraní Jaeger, ako je znázornené na obrázku nižšie. Všimnite si dlhý požiadavok v pravom hornom rohu grafu – jeho trvanie je 7.02 sekundy:
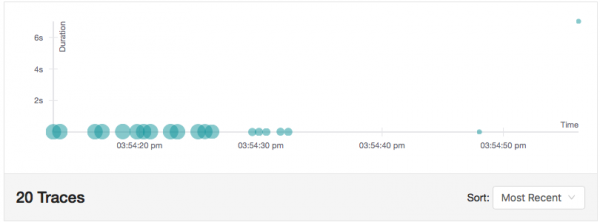
Tento scenár umožňuje otestovať kód v podmienkach sieťových oneskorení. A je jasné, že odstránením tohto pravidla odstránime umelé oneskorenie. Opakujeme, ale opäť sme to všetko urobili bez zásahu do pôvodného kódu.
Nevzdávať sa a nevzdať sa
Ďalšou užitočnou funkciou pre chaos inžinierstvo v Istio sú opakované pokusy o pripojenie k službe určitý počet krát. Zmyslom je, nevzdávať sa pokusov, keď prvý požiadavok skončí chybou 503 – a možno, že pri N-tom pokuse nám to vyjde. Možno služba bola len na chvíľu nedostupná z nejakého dôvodu. Áno, túto príčinu by sme mali preskúmať a odstrániť. Ale to je neskôr, teraz sa pokúsme urobiť tak, aby systém naďalej fungoval.
Takže chceme, aby služba občas vracala chybu 503, a Istio sa po tom pokúsi znova pripojiť. A tu jasne potrebujeme spôsob, ako generovať chybu 503, bez zásahu do samotného kódu...
Čakajte, počkajte! Veď my sme toto práve robili.
Tento súbor zabezpečí, že služba recommendation-v2 bude v polovici prípadov vracať chybu 503:
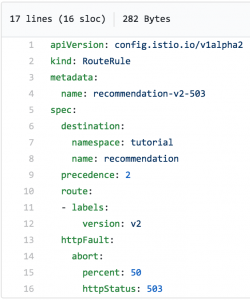
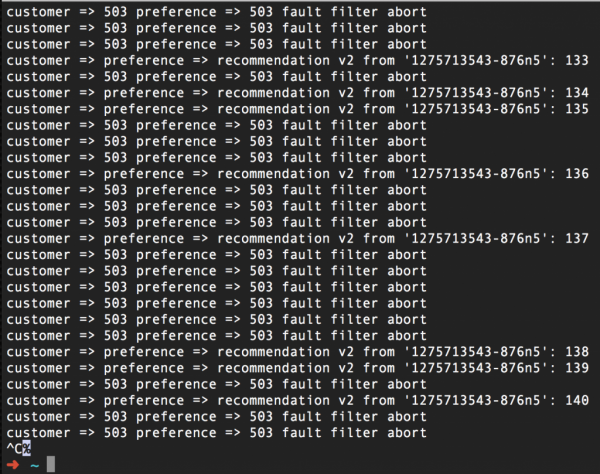
Je zrejmé, že časť požiadaviek sa skončí neúspechom:
A teraz aktivujme funkciu Retry v Istio:
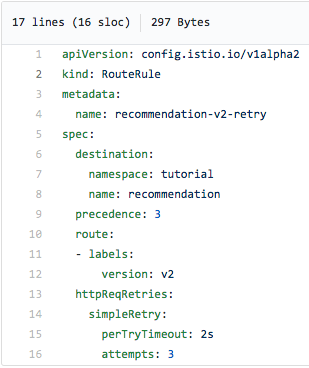
Toto pravidlo smerovania robí tri opakovania s dvojsekundovým intervalom a malo by skrátiť (a v ideálnom prípade vôbec odstrániť) chyby 503:
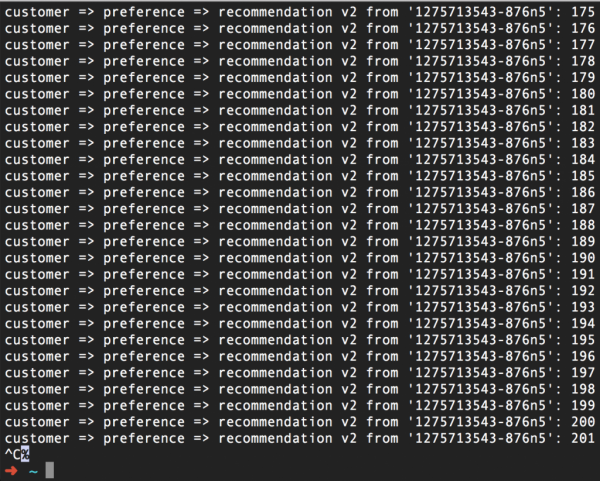
Zhrnieme: podarilo sa nám, že Istio, po prvé, generuje chybu 503 pre polovicu požiadaviek. A po druhé, to isté Istio vykonáva tri pokusy o opätovné pripojenie k službe pri vzniku chyby 503. Výsledkom je, že všetko funguje jednoducho skvele. Takto sme pomocou funkcie Retry splnili naše sľubovanie nevzdávať sa a nevzdať sa.
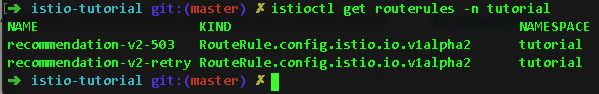
A áno, opäť sme to urobili, úplne bez zásahu do kódu. Všetko, čo sme potrebovali, sú dve pravidlá smerovania Istio:
Ako nezklamať používateľa alebo sedem jedného nečaká
A teraz prevráťme situáciu naruby a pozrime sa na scenár, keď neustupovať a nevzdávať sa má zmysel iba na vopred stanovený čas. Potom je potrebné jednoducho prestať sa snažiť spracovať požiadavku, aby sme nespôsobovali, že všetci čakajú na jeden spomaľujúci servis. Inými slovami, nebudeme chrániť stratenú pozíciu, ale ustúpime na záložnú líniu, aby sme neohrozili používateľa stránky a nespôsobili mu trápenie v nevedomosti.
V Istio môžete nastaviť časový limit vykonania požiadavky. Ak služba prekročí tento časový limit, vráti sa chyba 504 (Gateway Timeout) – opäť všetko sa to robí cez konfiguráciu Istio. Budeme musieť pridať do zdrojového kódu služby príkaz sleep (a potom samozrejme vykonať rebuild a redeploy), aby sme simulovali pomalú prácu služby. Žiaľ, inak sa to nedá.
Tak sme vložili trojsekundový sleep do kódu služby recommendation v2, znovu sme zostavili príslušný obraz a vykonali redeploy kontajnera, a teraz pridáme časový limit pomocou nasledujúceho pravidla smerovania Istio:
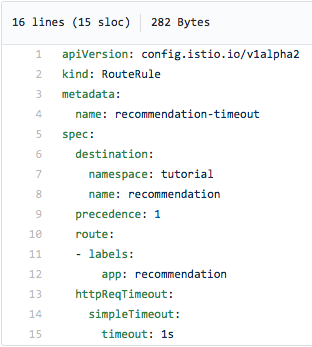
Na obrázku vyššie vidíte, že prestávame sa pokúšať skontaktovať so službou recommendation, ak nedostaneme odpoveď v priebehu jednej sekundy, teda ešte predtým, ako nastane chyba 504. Po aplikovaní tohto pravidla smerovania (a pridaní trojsekundového sleepu do kódu služby recommendation:v2) dostaneme toto:
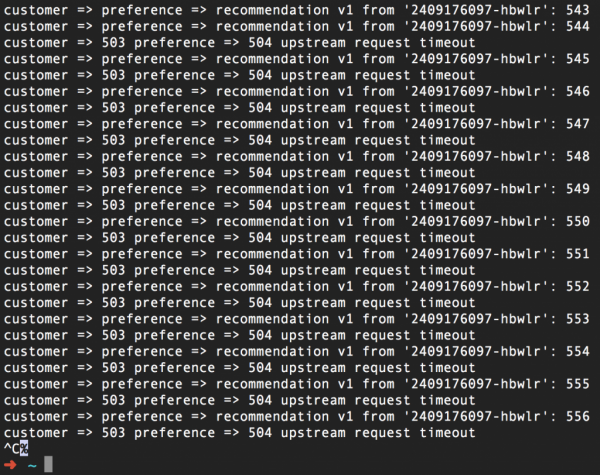
Opäť sa opakujeme, ale časový limit je možné nastaviť, aniž by sme sa dotkli zdrojového kódu. A dodatočný bonus je, že teraz môžete modifikovať svoj kód tak, aby reagoval na časový limit, a jednoducho otestovať tieto úpravy pomocou Istio.
A teraz všetko dohromady
Pridať trochu chaosu pomocou Istio je výborný spôsob, ako otestovať váš kód a spoľahlivosť vašej sústavy ako celku. Šablóny fallback, bulkhead a circuit breaker, mechanizmy na vytváranie umelých porúch a oneskorení, ako aj opakované volania a časové limity budú veľmi užitočné pri vytváraní odolných cloudových systémov. V kombinácii s Kubernetes a Red Hat OpenShift vám tieto nástroje pomôžu s dôverou sa postaviť do budúcnosti.
Zdroj: habr.com
