

Predstavujem vám prehľad správy Alexeja Lesovského z Data Egret „Základy monitorovania PostgreSQL“
V tejto správe Alexej Lesovský hovorí o kľúčových aspektoch štatistiky PostgreSQL, čo znamenajú a prečo by mali byť súčasťou monitorovania; o tom, aké grafy by mali byť v monitorovaní, ako ich pridať a ako ich interpretovať. Správa bude užitočná pre správcov databáz, systémových administrátorov a vývojárov, ktorých zaujíma troubleshooting PostgreSQL.
Volám sa Alexej Lesovský, zastupujem spoločnosť Data Egret.
Trochu slov o sebe. Kedysi dávno som začínal ako systémový administrátor.
Spravoval som rôzne Linuxy, venoval som sa rôznym veciam spojeným s Linuxom, t. j. virtualizáciou, monitorovaním, pracoval som s proxy atď. Ale v istom momente som sa začal viac zaoberať databázami, PostgreSQL. Veľmi sa mi páčil. A v istom momente som začal tráviť väčšinu svojho pracovného času PostgreSQL. Takto som sa postupne stal PostgreSQL DBA.
A počas celej mojej kariéry ma vždy zaujímali témy štatistiky, monitorovania, zberu telemetrie. Keď som bol systémovým administrátorom, veľmi som sa zaoberal Zabbixom. A napísal som malú sadu skriptov ako . Bol dosť populárny vo svojej dobe. Mohli ste tam monitorovať veľmi rôzne dôležité veci, nielen Linux, ale aj rôzne komponenty.
Momentálne sa už venujem len PostgreSQL. Píšem už niečo iné, čo umožňuje pracovať so štatistikou PostgreSQL. Volá sa (článok na habre — ).
Krátke úvodné zamyslenie. Aké sú situácie, ktoré zažívajú naši zákazníci? Dochádza k nejakej havárii súvisiacej s databázou. A keď sa už databáza obnoví, prichádza vedúci oddelenia alebo vedúci vývoja a hovorí: „Priatelia, mali by sme monitorovať databázu, pretože sa stalo niečo zlé a v budúcnosti by sa to nemalo opakovať.“ A tu začína zaujímavý proces výberu monitorovacieho systému alebo prispôsobenia existujúceho systému na to, aby sme mohli monitorovať našu databázu – PostgreSQL, MySQL alebo iné. A kolegovia začínajú navrhovať: „Počul som, že existuje taká databáza. Poďme ju použiť.“ Kolegovia sa začínajú medzi sebou hádať. A nakoniec sa rozhodneme pre nejakú databázu, ale monitorovanie PostgreSQL v nej je dosť slabé a vždy je potrebné niečo vylepšovať. Berieme si nejaké repozitáre z GitHubu, klonujeme ich, prispôsobujeme skripty, nejako nastavujeme. A na konci to prechádza do istej manuálnej práce.
Preto sa v tejto prednáške pokúsim poskytnúť vám určité poznatky o tom, ako vyberať monitorovanie nielen pre PostgreSQL, ale aj pre databázy. A poskytnúť tie vedomosti, ktoré vám umožnia vylepšiť vaše monitorovanie, aby ste z neho získali nejaký úžitok a aby ste mohli monitorovať svoju databázu s prínosom, aby ste včas upozornili na nejaké predchádzajúce havarijné situácie, ktoré môžu nastať.
A tie myšlienky, ktoré budú v tejto prezentácii, môžu byť priamo prispôsobené akejkoľvek databáze, či už ide o relačné databázy alebo noSQL. Preto tu nebude len PostgreSQL, ale aj množstvo receptov, ako to urobiť v PostgreSQL. Budú tam príklady dotazov, príklady entít, ktoré sú v PostgreSQL pre monitorovanie. A ak vaša RDBMS má podobné funkcie, ktoré umožňujú ich začleniť do monitorovania, môžete ich tiež prispôsobiť, pridať a bude to skvelé.
 V prednáške nebudem
rozprávať o tom, ako doručovať a ukladať metriky. Nechcem hovoriť o post-processingu dát a ich poskytovaní užívateľovi. A nebudem hovoriť o alertingu.
Počas rozprávania budem ukazovať rôzne snímky obrazovky existujúcich monitorovaní a občas ich skritizujem. Napriek tomu sa budem snažiť nespomínať značky, aby som nevytváral reklamu alebo antireklamu týmto produktom. Preto všetky zhody sú náhodné a zostávajú na vašej fantázii.
Najprv si ujasníme, čo je to monitorovanie. Monitorovanie je veľmi dôležitá vec, ktorú treba mať. To všetci chápu. No zároveň monitorovanie nepatrí medzi obchodné produkty a priamo neovplyvňuje zisk spoločnosti, preto sa mu vždy venuje pozornosť len okrajovo. Ak máme čas, venujeme sa monitorovaniu, ak čas nemáme, v poriadku, dáme to do backlogu a niekedy sa k týmto úlohám vrátime.
Naša skúsenosť ukazuje, že keď prichádzame k klientom, monitorovanie je často nedostatočne vypracované a nemá zaujímavé funkcie, ktoré by nám pomohli vykonávať prácu s databázami efektívnejšie. Preto je potrebné monitorovanie vždy doladiť.
Databázy sú komplikované veci, ktoré je tiež potrebné monitorovať, pretože predstavujú úložisko informácií. Informácie sú pre spoločnosť veľmi dôležité, nemôžeme ich nijako stratiť. No zároveň sú databázy veľmi zložitými kusmi softvéru. Skladajú sa z veľkého množstva komponentov. Mnohé z týchto komponentov je potrebné monitorovať.
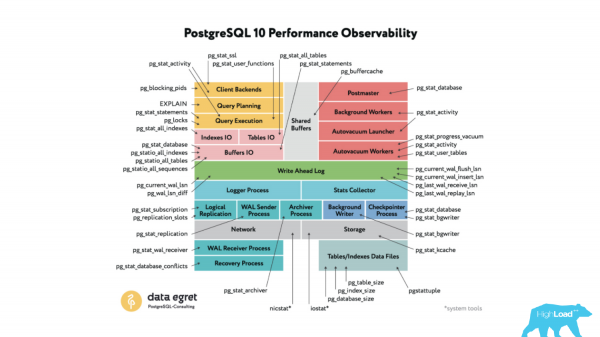 Ak hovoríme konkrétne o PostgreSQL, môžeme ho predstaviť ako schému, ktorá sa skladá z veľkého množstva komponentov. Tieto komponenty navzájom komunikujú. Zároveň v PostgreSQL existuje takzvaný subsystém Stats Collector, ktorý umožňuje zbierať štatistiky o fungovaní týchto subsystémov a poskytovať akýsi rozhranie administrátorovi alebo používateľovi, aby mohol prehliadať tieto štatistiky.
Tieto štatistiky sú prezentované vo forme súboru funkcií a pohľadov (view). Môžeme ich nazvať aj tabuľkami. Teda s pomocou obyčajného klienta psql sa môžete pripojiť k databáze, vykonať select na tieto funkcie a pohľady a získať konkrétne čísla o fungovaní subsystémov PostgreSQL.
Môžete tieto čísla pridať do vašej obľúbenej monitorovacej systému, nakresliť grafy, pridať funkcie a získať analytiku na dlhodobé obdobie.
V tejto správe nebudem zvažovať všetky tieto funkcie podrobne, pretože by to mohlo trvať celý deň. Zameriam sa doslovne na dve, tri alebo štyri veci a budem rozprávať, ako pomáhajú zlepšiť monitoring.
A ak hovoríme o monitorovaní databázy, na čo treba monitorovať? V prvom rade by sa mala sledovať dostupnosť, pretože databáza je služba, ktorá poskytuje prístup k dátam klientom a potrebujeme monitorovať jej dostupnosť, ktorá tiež zahrňuje niektoré kvalitné a kvantitatívne charakteristiky.
Rovnako je potrebné monitorovať klientov, ktorí sa pripájajú k našej databáze, pretože môžu byť normálnymi klientmi, ale aj škodlivými klientmi, ktorí môžu databáze poškodiť. Taktiež ich treba monitorovať a sledovať ich činnosť.
Keď sa klienti pripájajú k databáze, je jasné, že začínajú pracovať s našimi dátami, a preto musíme monitorovať aj to, ako klienti pracujú s dátami: s ktorými tabuľkami, v menšej miere s ktorými indexmi. T. j. musíme posúdiť pracovnú záťaž (workload), ktorú vytvárajú naši klienti.
Pracovná záťaž sa samozrejme skladá z dopytov. Aplikácie sa pripájajú k databáze, získavajú dáta pomocou dopytov, a preto je dôležité hodnotiť, aké dopyty sú v našej databáze, sledovať ich adekvátnosť, aby neboli zle napísané, že niektoré možnosti treba prepisovať a optimalizovať tak, aby fungovali rýchlejšie a s lepšou výkonnosťou.
A keď hovoríme o databáze, databáza je vždy spojená s pozadím procesmi. Pozadie procesy umožňujú udržiavať výkon databázy na dobrej úrovni, a preto na svoju činnosť vyžadujú určité množstvo zdrojov. Zároveň sa môžu prekrývať so zdrojmi klientskych dopytov, a preto náročná činnosť pozadných procesov môže priamo ovplyvniť výkon klientskych dopytov. Preto ich treba tiež monitorovať a sledovať, aby nedošlo k žiadnym problémom v oblasti pozadných procesov.
A to všetko v rámci monitorovania databáz zostáva v systémovej metrike. Ale vzhľadom na to, že väčšina našej infraštruktúry sa presúva do cloudu, systémové metriky jednotlivého hostiteľa vždy ustupujú do pozadia. No v databázach sú stále aktuálne a monitorovanie systémových metrík je samozrejme potrebné.
So systémovými metrikami je všetko celkom v poriadku, všetky moderné monitorovacie systémy už tieto metriky podporujú, ale vo všeobecnosti niektoré komponenty stále chýbajú a je potrebné pridať niektoré veci. O týchto veciach sa tiež zmienim, niekoľko snímok bude o nich.
Prvý bod plánu – to je dostupnosť. Čo je to dostupnosť? Dostupnosť, podľa môjho názoru, je schopnosť databázy obsluhovať pripojenia, t. j. databáza je spustená, ako služba, akceptuje pripojenia od klientov. A túto dostupnosť je možné hodnotiť niektorými charakteristikami. Tieto charakteristiky je veľmi vhodné umiestniť na dashboardy.
Všetci vedia, čo sú to dashboardy. To je, keď sa jediným pohľadom na obrazovku získa potrebná informácia. A už môžete okamžite určiť – existuje problém v databáze alebo nie.
Podľa toho je dostupnosť databázy a iné kľúčové charakteristiky vždy potrebné umiestniť na dashboardy, aby tieto informácie boli po ruke, aby ste ich mali vždy blízko. Niektoré ďalšie detaily, ktoré už pomáhajú pri vyšetrovaní incidentov, pri riešení nejakých havarijných situácií, je potrebné umiestniť na sekundárne dashboardy alebo skryť v odkazoch drilldown, ktoré vedú na externé monitorovacie systémy.
Príklad jednej známej monitorovacej sústavy. Je to veľmi výkonný monitorovací systém. Zbiera veľa dát, ale z môjho pohľadu má zvláštny pojem dashboardov. Existuje odkaz „vytvoriť dashboard“. Ale keď vytvoríte dashboard, vytvoríte akýsi zoznam pozostávajúci z dvoch stĺpcov, akýsi zoznam grafov. A keď si potrebujete niečo pozrieť, začnete myšou klikať, listovať, hľadať potrebný graf. A to zaberá čas, t. j. dashboardy, ako také, neexistujú. Existujú len zoznamy grafov.
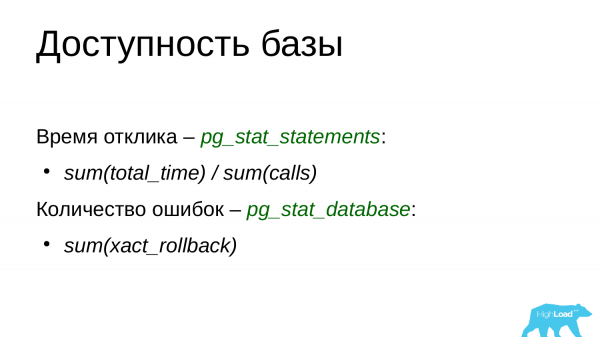
Čo treba pridať do týchto dashboardov? Môžeme začať s takou charakteristikou, ako je čas odozvy. V PostgreSQL existuje pohľad pg_stat_statements. Predvolene je zakázaný, ale je to jeden z dôležitých systémových pohľadov, ktorý je vždy potrebné zapnúť a používať. Uchováva informácie o všetkých vykonaných dotazoch, ktoré boli vykonané v databáze.
Podľa toho môžeme vychádzať z toho, že môžeme vziať súhrnný čas vykonania všetkých dotazov a podeliť ho počtom dotazov pomocou vyššie uvedených polí. Ale to je len priemerná teplota v nemocnici. Môžeme vychádzať z iných polí – minimálny čas vykonania dotazov, maximálny a medián. A dokonca môžeme vytvárať percentily, v PostgreSQL sú na to zodpovedajúce funkcie. A môžeme získať nejaké čísla, ktoré charakterizujú čas odozvy našej databázy na už vykonané dotazy, t.j. nevykonávame fiktívny dotaz ‘select 1’ a nepozeráme čas odozvy, ale analyzujeme čas odpovedí na už vykonané dotazy a zobrazujeme buď jedným číslom, alebo vytvárame graf.
Je tiež dôležité sledovať počet chýb, ktoré systém v súčasnosti generuje. A na to môžeme použiť pohľad pg_stat_database. Sústredíme sa na pole xact_rollback. Toto pole ukazuje nielen počet rollbackov, ktoré sa v databáze uskutočňujú, ale aj počet chýb. Podmienečne povedané, môžeme túto hodnotu zobraziť na našom dashboarde a sledovať, koľko máme v súčasnosti chýb. Ak je chýb veľa, je to dobrý dôvod pozrieť sa do logov a zistiť, aké sú to chyby a prečo sa vyskytujú, a potom ich vyšetrovať a riešiť.
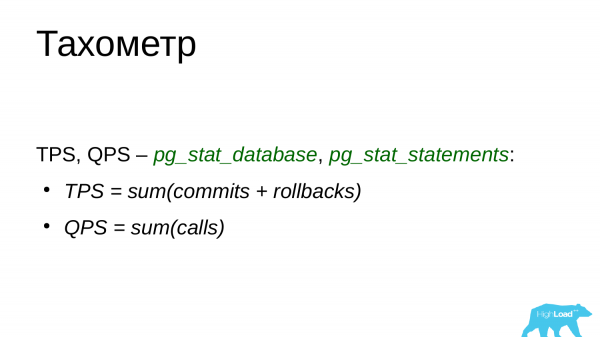
Môžete pridať aj niečo ako Tachometer. To je počet transakcií za sekundu a počet dotazov za sekundu. Povedzme, že tieto čísla môžete použiť ako aktuálny výkon vašej databázy a sledovať, či sú tu vrcholy v dotazoch, vrcholy v transakciách alebo naopak, že databáza nie je zaťažená, pretože nejaký backend zlyhal. Na túto hodnotu je dôležité vždy sa pozerať a pamätať si, že pre náš projekt je takýto výkon normálny, a hodnoty nad a pod tým sú už nejaké problémové a nejasné, a teda je potrebné preskúmať, prečo sú takéto čísla.
Na to, aby sme mohli hodnotiť počet transakcií, môžeme sa opäť obrátiť na pohľad pg_stat_database. Môžeme sčítať počet commitov a počet rollbackov a získať počet transakcií za sekundu.
Všetci rozumejú, že do jednej transakcie sa môže zmestiť niekoľko požiadaviek? Preto sa TPS a QPS mierne líšia.
Počet požiadaviek za sekundu môžeme získať z pg_stat_statements a jednoducho spočítať súčet všetkých vykonaných požiadaviek. Je jasné, že porovnávame aktuálnu hodnotu s predchádzajúcou, odčítame, získame delta a získať množstvo.
Môžeme pridať dodatočné metriky podľa záujmu, ktoré tiež pomáhajú hodnotiť dostupnosť našej databázy a sledovať, či neboli nejaké výpadky.
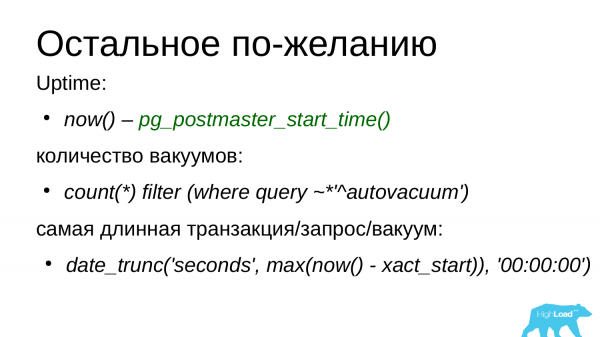
Jedna z týchto metrik je uptime. Ale uptime v PostgreSQL je trochu zložitá záležitosť. Povedzme si prečo. Keď sa PostgreSQL spustí, začína sa počítať uptime. Ale ak v nejakom momente, napríklad v noci, bola vykonaná nejaká úloha, prišiel OOM-killer a nútene ukončil podproces PostgreSQL, potom v takom prípade PostgreSQL ukončí spojenie všetkých klientov, resetuje šardovanú pamäť a začne obnovu z posledného kontrolného bodu. A kým trvá táto obnova z kontrolného bodu, databáza neprijíma pripojenia, t. j. túto situáciu môžeme považovať za výpadok. Ale pritom sa počítadlo uptime nresetuje, pretože zohľadňuje čas spustenia postmastera od samotného začiatku. Preto je možné takéto situácie prehliadnuť.
Tiež by sme mali monitorovať počet workerov vacuumu. Všetci vedia, čo je to autovacuum v PostgreSQL? Je to zaujímavý subsystém v PostgreSQL. O ňom je napísaných veľa článkov, bolo prezentovaných mnoho prednášok. Mnoho diskusií sa vedie o vacuume, o tom, ako by mal fungovať. Mnohí ho považujú za nevyhnutné zlo. A je to tak. Je to akýsi analogický zberateľ odpadu, ktorý čistí zastarané verzie riadkov, ktoré nie sú potrebné žiadnej z transakcií a uvoľňuje miesto v tabuľkách a indexoch pre nové riadky.
Prečo by sme ho mali monitorovať? Pretože vacuum občas spôsobuje veľké problémy. Spotrebováva veľké množstvo zdrojov a požiadavky od klientov začínajú trpieť.
Monitorovať by sme ho mali cez pohľad pg_stat_activity, o ktorom budem hovoriť v nasledujúcej časti. Tento pohľad zobrazuje aktuálnu aktivitu v databáze. A prostredníctvom tejto aktivity môžeme sledovať počet vakuových procesov, ktoré práve teraz bežia. Môžeme sledovať vakuové procesy a vidieť, že ak prekročíme limit, je to signál pozrieť sa do nastavení PostgreSQL a optimalizovať prácu vakuuma.
Ďalšou zvláštnosťou PostgreSQL je, že veľmi trpí dlhými transakciami. Najmä od transakcií, ktoré visia a nič nerobia. Tieto sa nazývajú stat idle-in-transaction. Takáto transakcia zadržiava blokácie, a tým bráni fungovaniu vakuumu. A v dôsledku toho tabulky narastajú, zvyšujú sa na veľkosti. A dotazy, ktoré pracujú s týmito tabulkami, začínajú fungovať pomalšie, pretože je potrebné prehľadávať všetky staré verzie riadkov z pamäte na disk a späť. Preto by sme mali monitorovať aj čas, dĺžku najdlhších transakcií a najdlhších dotazov vakuumu. A ak vidíme nejaké procesy, ktoré bežia veľmi dlho, už viac ako 10-20-30 minút pre OLTP zaťaženie, mali by sme na ne venovať pozornosť a buď ich nútene ukončiť, alebo optimalizovať aplikáciu, aby sa nespracovávali a neviseli tak dlho. Pre analytické zaťaženie je 10-20-30 minút normálne, niekedy sú aj dlhšie.
Potom máme variant s pripojenými klientmi. Keď už sme vytvorili dashboard a vystavili na ňom kľúčové metriky dostupnosti, môžeme tam pridať aj dodatočné informácie o pripojených klientoch.
Informácie o pripojených klientoch sú dôležité, pretože z pohľadu PostgreSQL sú klienti rôzni. Existujú dobrí klienti a zlí klienti.
Jednoduchý príklad. Pod klientom rozumiem aplikáciu. Aplikácia sa pripojila k databáze a hneď začína posielať svoje dotazy, databáza ich spracováva a vykonáva, výsledky vracia klientovi. To sú dobrí a správni klienti.
Niekedy nastávajú situácie, že klient sa pripojil, udržiava spojenie, ale pritom nič nerobí. Nachádza sa v stave idle.
Ale existujú aj zlí klienti. Napríklad, ten istý klient sa prihlásil, otvoril transakciu, niečo robil v databáze a potom prešiel do kódu, povedzme, aby sa obrátil na externý zdroj alebo aby spracoval získané údaje. Ale zároveň neuzavrel transakciu. A transakcia zostáva v databáze a blokuje riadky. To je zlé. A ak sa náhodou aplikácia niekde vnútri zrúti cez výnimku (Exception), transakcia môže zostať otvorená veľmi dlho. A to priamo ovplyvňuje výkon PostgreSQL. PostgreSQL bude pracovať pomalšie. Preto je dôležité takých klientov včas sledovať a nútene ukončovať ich činnosť. Musíte optimalizovať svoju aplikáciu, aby sa takéto situácie nevyskytovali.
Inými zlými klientmi sú číhajúci klienti. Ale stávajú sa zlými kvôli okolnostiam. Napríklad, jednoduchá visiacá transakcia: môže otvoriť transakciu, získať zámky na nejaké riadky, potom sa niekde v kóde zrúti a zostane visiacou transakciou. Príde iný klient, požiada o tie isté údaje, ale narazí na zablokovanie, pretože tá visiacá transakcia už zadržiava zámky na niektoré potrebné riadky. A druhá transakcia bude visieť v očakávaní, kedy prvá transakcia skončí alebo ju správca nútene ukončí. Týmto spôsobom môžu číhajúce transakcie narastať a prekročiť limit pripojení k databáze. A keď je limit prekročený, aplikácia už nemôže pracovať s databázou. To už je havarijná situácia pre projekt. Preto je potrebné sledovať zlých klientov a včas na ne reagovať.
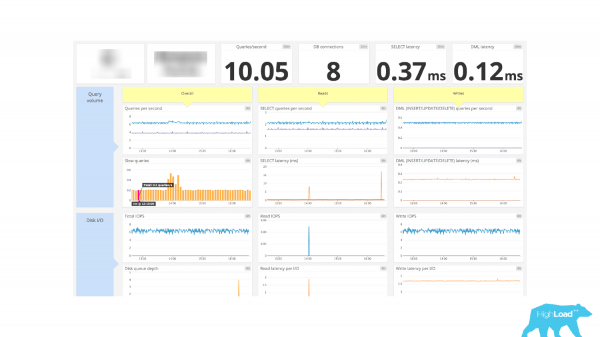
Ďalší príklad monitorovania. A tu je už solídny dashboard. Na vrchu sú informácie o pripojeniach. DB connection – 8 kusov. A to je všetko. Nemáme informácie o tom, ktorí klienti sú aktívni, ktorí klienti sú iba idle, nič nerobia. Neexistujú informácie o visiacich transakciách a číhajúcich pripojeniach, t. j. je to len číslo ukazujúce počet pripojení a všetko. A ďalej sa už hádajte sami.
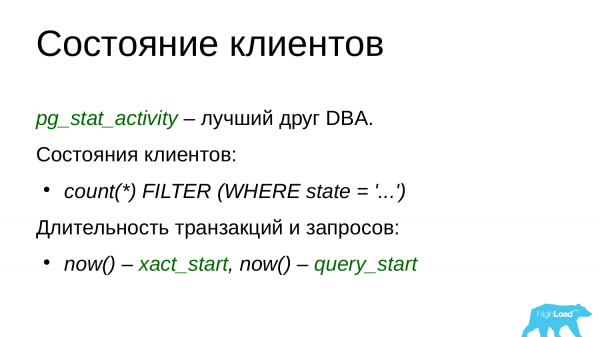
Aby sme pridali tieto informácie do monitorovania, musíme sa obrátiť na systémový pohľad pg_stat_activity. Ak trávite veľa času v PostgreSQL, je to veľmi dobrý pohľad, ktorý by sa mal stať vaším priateľom, pretože zobrazuje aktuálnu aktivitu v PostgreSQL, t. j. čo sa v ňom deje. Pre každý proces existuje samostatný riadok, ktorý zobrazuje informácie o tomto procese: z ktorého hostiteľa bolo pripojenie vykonané, pod akým používateľom, akým menom, kedy bola transakcia spustená, aký dopyt sa teraz vykonáva, aký dopyt bol vykonaný naposledy. A, prirodzene, stav klienta môžeme hodnotiť podľa poľa stat. Podmienečne povedané, môžeme spraviť groupovanie podľa tohto poľa a získať tie štatistiky, ktoré sú teraz v databáze a počet pripojení, ktoré sú s týmto statom v databáze. A už získané čísla môžeme posielať do nášho monitorovania a nakresliť podľa nich grafy.
Takisto je dôležité hodnotiť trvanie transakcie. Už som hovoril, že je dôležité hodnotiť trvanie údržby, ale aj transakcie sa hodnotia presne rovnakým spôsobom. Existujú polia xact_start a query_start. Tieto, podmienečne povedané, ukazujú čas začiatku transakcie a čas začiatku dopytu. Berieme funkciu now(), ktorá zobrazuje aktuálny čas a odčítame časovú pečiatku transakcie a dopytu. A dostávame trvanie transakcie, trvanie dopytu.
Ak vidíme dlhé transakcie, mali by sme ich už dokončiť. Pre OLTP záťaž sú dlhé transakcie už viac ako 1-2-3 minúty.. Pre OLAP záťaž sú dlhé transakcie normálne, ale ak sa vykonávajú viac než dve hodiny, je to tiež znak toho, že niekde máme nerovnováhu.
Keď sa klienti pripoja k databáze, začnú pracovať s našimi dátami. Oslovujú tabuľky, oslovujú indexy, aby získali údaje z tabuľky. A je dôležité hodnotiť, ako klienti pracujú s týmito dátami.
To evaluate our workload and understand which tables are the most 'active', this is necessary. For example, this is essential when we want to place 'hot' tables on fast SSD storage. On the other hand, archival tables that we no longer use can be moved to 'cold' storage on SATA disks, allowing them to reside there with access granted only as needed.
It is also useful for detecting anomalies after various releases and deployments. For instance, if a project rolls out a new feature, such as added functionality for working with the database, we can build usage graphs for the tables that will allow us to easily identify these anomalies. For example, spikes in updates or deletions will be clearly visible.
Moreover, we can detect anomalies in the 'distorted' statistics. What does this mean? PostgreSQL has a very strong and efficient query planner, and developers spend considerable time improving it. How does it function? To create effective plans, PostgreSQL collects statistics on the distribution of data in the tables at regular intervals. This includes the most frequent values: the count of unique values, information on NULLs in the table, and much more.
Based on this statistics, the planner generates several query plans, selects the most optimal one, and uses this plan to execute the query and return the data.
Sometimes, the statistics can become 'distorted'. The quality or quantity of data in a table may change, but the statistics might not have been updated. Consequently, the generated plans could turn out to be suboptimal. If our plans are not optimized based on the collected monitoring data related to the tables, we can spot these anomalies. For instance, if the data quality changes and a sequential scan of the table is suddenly used instead of the index, and if the query only needs to return 100 rows (with a limit set to 100), a complete scan would be performed, which always negatively impacts performance.
A môžeme to vidieť v monitorovaní. Môžeme sa pozrieť na tento dotaz, vykonať preň explain, zhromaždiť štatistiky, vytvoriť nový dodatočný index a reagovať na tento problém. Preto je to dôležité.
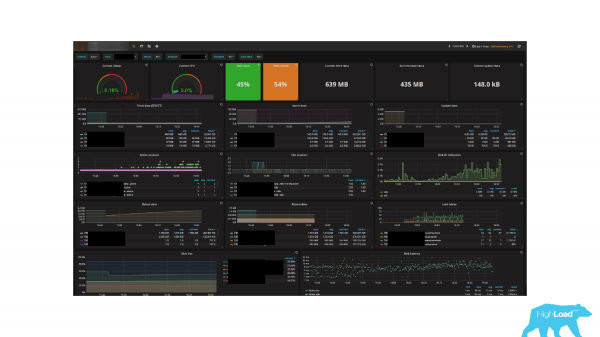
Ďalším príkladom monitorovania je niečo, čo mnohí poznajú, pretože je veľmi populárne. Kto to používa vo svojich projektoch? ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Ale tu je jedna zlomyseľná ohľadná.
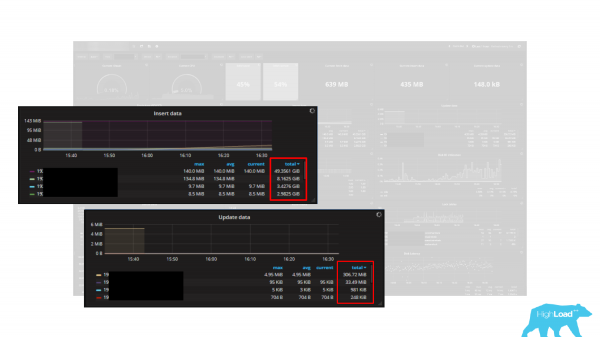
Existuje niekoľko grafov. A ako jednotka sú uvedené bajty, t.j. sú tam 5 grafov: Insert data, Update data, Delete data, Fetch data a Return data. Ako jednotka merania sú uvedené bajty. Ale problém je v tom, že štatistika v PostgreSQL vracia dáta v tuple (riadkoch). A preto sú tieto grafy veľmi dobrým spôsobom, ako znížiť váš pracovný záťaž mnohokrát, pretože tuple nie sú bajty, tuple sú riadky, a sú rôznej dĺžky. T.j. vypočítať pracovný záťaž v bajtoch pomocou tuple je nereálny alebo veľmi zložitý úlohou. Preto, keď používate dashboard alebo integrované monitorovanie, je vždy dôležité pochopiť, že to funguje správne a vracia vám presne hodnotené dáta.
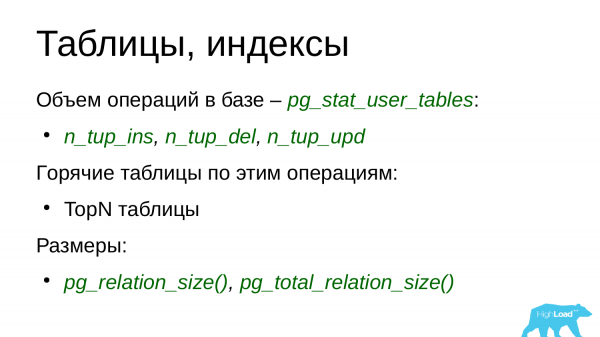
Ako získať štatistiky pre tieto tabuľky? Na to existuje v PostgreSQL niekoľko rodín pohľadov. A hlavným pohľadom je . User_tables znamená, že tabuľky boli vytvorené v mene používateľa. Na rozdiel od toho existujú systémové pohľady, ktoré používa samotný PostgreSQL. A existuje súhrnná tabuľka Alltables, ktorá obsahuje systémové aj používateľské tabuľky. Môžete sa odraziť od akejkoľvek z nich, ktorá sa vám najviac páči.
Podľa vyššie uvedených polí môžete hodnotiť počet insert, update a delete. Ten príklad dashboardu, ktorý som použil, práve využíva tieto polia na hodnotenie charakteristík pracovného záťaže. Preto sa môžeme tiež odraziť od nich. Ale treba mať na pamäti, že to sú tuple, nie bajty, takže nemôžeme jednoducho vziať a spraviť to v bajtoch.
Na základe týchto dát môžeme zostaviť takzvané TopN tabuľky. Napríklad, Top-5, Top-10. A môžeme sledovať tie horúce tabuľky, ktoré sú využívané viac ako ostatné. Napríklad 5 "horúcich" tabuliek podľa vkladania. A na základe týchto TopN tabuliek hodnotíme našu pracovný záťaž a môžeme hodnotiť výkyvy pracovného záťaže po rôznych vydaniach a aktualizáciách, a nasadeniach.
Je dôležité posúdiť veľkosť tabuliek, pretože niekedy vývojári zavádzajú nové funkcie a naše tabuľky začínajú naberať na veľkosti, pretože sa rozhodli pridať ďalšie údaje, ale nepredpovedali, ako to ovplyvní veľkosť databázy. Takéto prípady nás tiež prekvapia.
A teraz mám na vás malú otázku. Akú otázku si kladiete, keď zaznamenáte zaťaženie na serveri s databázou? Aká je vaša nasledujúca otázka?
Ale v skutočnosti vzniká nasledujúca otázka. Aké dopyty spôsobujú zaťaženie? Nie je zaujímavé sledovať procesy, ktoré spôsobujú zaťaženie. Je jasné, že ak je hostiteľ s databázou, databáza je spustená a jasné je, že tam budú len databázy, ktoré budú využívané. Ak otvoríme Top, uvidíme tam zoznam procesov v PostgreSQL, ktoré niečo robia. Z Top nebude jasné, čo robia.
Je preto potrebné identifikovať tie dopyty, ktoré spôsobujú najväčšie zaťaženie, pretože ladenie dopytov zvyčajne prináša väčší prínos, ako ladenie konfigurácie PostgreSQL alebo operačného systému, alebo dokonca ladenie hardvéru. Podľa mojich odhadov je to približne 80-85-90 %. A to sa robí omnoho rýchlejšie. Rýchlejšie je upraviť dopyt, ako upraviť konfiguráciu, naplánovať reštart, najmä ak nie je možné reštartovať databázu, alebo pridávať hardvér. Jednoduchšie je niekde prepracovať dopyt alebo pridať index, aby sme získali lepší výsledok z tohto dopytu.
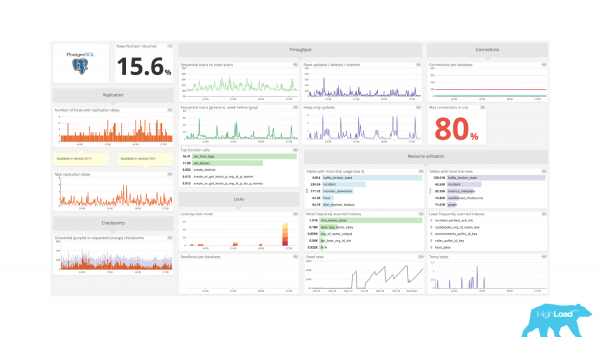
Je potrebné monitorovať dopyty a ich adekvátnosť. Zoberme si iný príklad monitorovania. A tu tiež vyzerá monitoring výborne. Sú tu informácie o replikácii, informácie o priepustnosti, blokovaní, využívaní zdrojov. Všetko je skvelé, ale chýbajú informácie o dopytoch. Nie je jasné, aké dopyty sa vykonávajú v našej databáze, ako dlho trvajú, koľko týchto dopytov je. V monitore musíme vždy mať tieto informácie.
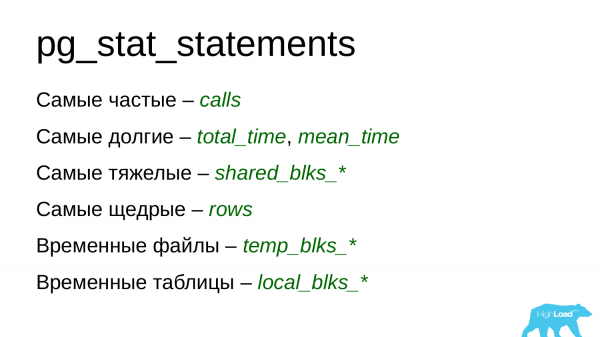
Aby sme získali tieto informácie, môžeme použiť modul pg_stat_statements. Na jeho základe môžeme vytvárať rôzne grafy. Napríklad môžeme získať informácie o najčastejších dotazoch, t. j. tých dotazoch, ktoré sa vykonávajú najčastejšie. Áno, po nasadení to môže byť veľmi užitočné na pohľad na to, aby sme pochopili, či nedochádza k náhlemu nárastu dotazov.
Môžeme monitorovať najdlhšie dotazy, t. j. tie dotazy, ktoré trvajú najdlhšie. Tieto dotazy pracujú s procesorom a spotrebovávajú vstup/výstup. To môžeme tiež hodnotiť podľa polí total_time, mean_time, blk_write_time a blk_read_time.
Môžeme hodnotiť a monitorovať najnáročnejšie dotazy z hľadiska využitia zdrojov, tie, ktoré čítajú z disku, pracujú s pamäťou alebo naopak vytvárajú nejakú zápisovú záťaž.
Môžeme hodnotiť aj najštedrejšie dotazy. To sú tie dotazy, ktoré vracajú veľké množstvo riadkov. Napríklad to môže byť nejaký dotaz, pri ktorom zabudli nastaviť limit, a vracia celé obsahy tabuľky alebo žiadaných tabuliek.
A môžeme tiež monitorovať dotazy, ktoré používajú dočasné súbory alebo dočasné tabuľky.
A zostali nám pozadie procesy. Pozadie procesy – to sú predovšetkým checkpointy alebo sa tiež nazývajú kontrolné body, autovacuum a replikácia.
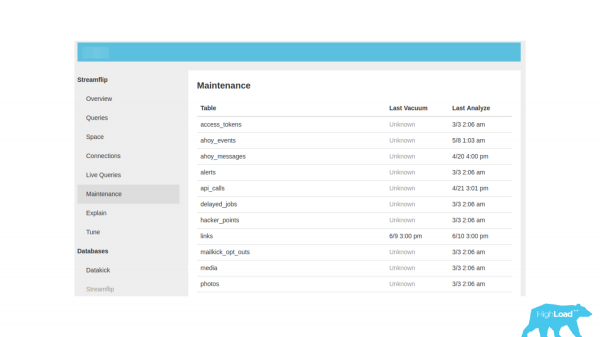
Ďalší príklad monitorovania. Naľavo je karta Údržba, prejdeme na ňu a dúfame, že uvidíme niečo užitočné. Ale sú tu len časy prevádzky vakuovania a zhromažďovania štatistiky, viac nič. To sú veľmi chudobné informácie, preto je vždy potrebné mať informácie o tom, ako fungujú pozadie procesy v našej databáze a či nie sú problémy s ich činnosťou.
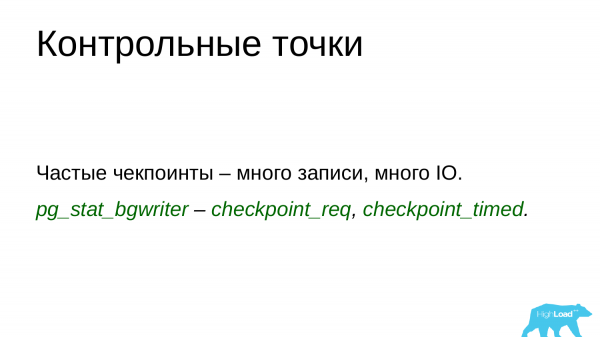
Keď sa zaoberáme kontrolnými bodmi, treba si uvedomiť, že kontrolné body vyprázdňujú „špinavé“ stránky z oblasti delenia pamäte na disk, potom vytvárajú kontrolný bod. A tento kontrolný bod môže byť neskôr použitý ako nejaké miesto pri obnove, ak by napríklad PostgreSQL bolo náhle ukončené.
Aby sa odstránili všetky 'špinavé' stránky na disk, je potrebné vykonať určitý objem zápisu. A zvyčajne na systémoch s veľkým objemom pamäte – je to veľmi veľa. A ak sa u nás kontrolné body robia veľmi často v nejakom krátkom intervale, disková výkonnosť bude veľmi výrazne klesať. A zákaznícke požiadavky budú trpieť nedostatkom zdrojov. Budú bojovať o zdroje a bude im chýbať výkon.
Cez pg_stat_bgwriter podľa uvedených polí môžeme sledovať počet nastávajúcich kontrolných bodov. A ak máme za určitý časový úsek (za 10-15-20 minút, za polhodinu) veľmi veľa kontrolných bodov, napríklad 3-4-5, môže to byť už problém. A treba sa pozrieť do databázy, pozrieť sa na konfiguráciu, čo spôsobuje také množstvo kontrolných bodov. Možno ide o nejaký veľký zápis. Na základe pracovného zaťaženia môžeme už posúdiť, pretože máme grafy pracovného zaťaženia už pridané. Môžeme upraviť parametre kontrolných bodov a zabezpečiť, aby nemali veľký dopad na výkon požiadaviek.
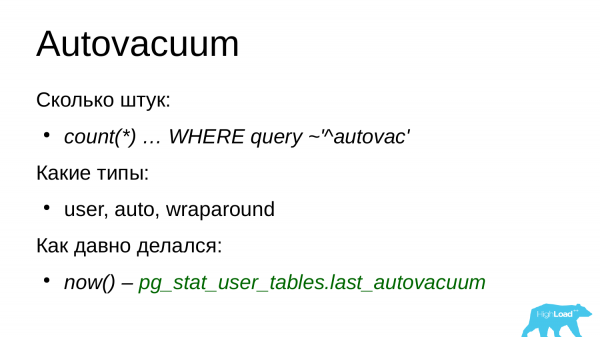
Znova sa vraciam k autovacuum, pretože to je vec, ako som už povedal, ktorá môže ľahko ovplyvniť výkon ako diskov, tak aj požiadaviek, preto je vždy dôležité hodnotiť množstvo autovacuum.
Počet pracovníkov autovacuum v databáze je obmedzený. Predvolene sú traja, takže ak nám neustále pracujú traja pracovníci v databáze, znamená to, že je autovacuum nedostatočne nastavené, je potrebné zvýšiť limity, prehodnotiť nastavenia autovacuum a zasahovať do konfigurácie.
Je dôležité posudzovať, ktorí naši pracovníci vykonávajú vacuum. Buď je spustený od používateľa, DBA prišiel a ručne spustil nejaké vacuum, a to vytvorilo záťaž. Objavila sa nejaká problém. Alebo je to počet vacuum, ktoré odpočítavajú transakčné počítadlo. Pre niektoré verzie PostgreSQL sú to veľmi náročné vacuum. A môžu ľahko ovplyvniť výkon, pretože prechádzajú celou tabuľkou vcelku, skenujú všetky bloky v tejto tabuľke.
A samozrejme, dĺžka vakuovania. Ak máme dlhé vakuovania, ktoré trvajú veľmi dlho, znamená to, že by sme sa mali opäť pozrieť na konfiguráciu vakuovania a možno prehodnotiť jeho nastavenia. Pretože môže nastať situácia, keď vakuum pracuje na tabuľke dlhú dobu (3-4 hodiny), ale počas tejto doby sa v tabuľke nahromadil ďalší veľký objem mŕtvych riadkov. A hneď ako sa vakuum dokončí, bude musieť opäť vakuovať túto tabuľku. A dostaneme sa do situácie – nekonečného vacuum. V takom prípade vakuum nezvláda svoju prácu a tabuľky začínajú postupne narastať na veľkosti, hoci objem užitočných dát v nich zostáva rovnaký. Preto pri dlhých vakuovaniach vždy sledujeme konfiguráciu a snažíme sa ju optimalizovať, ale pritom tak, aby netrpela výkonnosť klientskych požiadaviek.
V súčasnosti takmer nie je inštalácia PostgreSQL, kde by nebola streamová replikácia. Replikácia je proces prenosu dát z hlavného uzla na replikáciu.
Replikácia v PostgreSQL je realizovaná cez žurnál transakcií. Hlavný uzol generuje žurnál transakcií. Žurnál transakcie cez sieťové pripojenie ide na replikáciu, kde sa ďalej reprodukuje. Všetko je jednoduché.
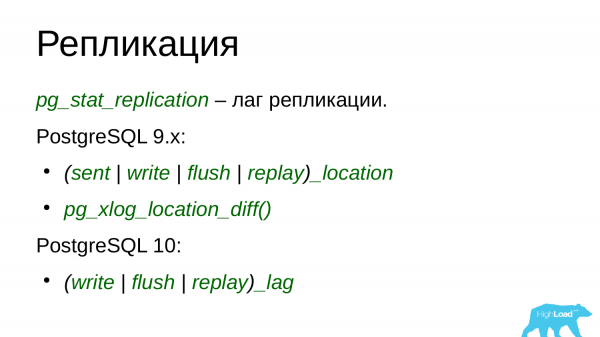
Na monitorovanie lagovania replikácie sa používa pohľad pg_stat_replication. Ale s tým nie je všetko jednoduché. V verzii 10 sa pohľad dočkal niekoľkých zmien. Po prvé, niektoré polia boli premenované. A niektoré polia boli pridané. V 10. verzii sa objavili polia, ktoré umožňujú hodnotiť lag replikácie v sekundách. To je veľmi pohodlné. Pred verziou 10 bola možnosť hodnotiť lag replikácie v bajtoch. Táto možnosť zostala aj v 10. verzii, t.j. môžete si vybrať, čo je pre vás pohodlnejšie - hodnotiť lag v bajtoch alebo hodnotiť lag v sekundách. Mnohí robia oboje.
Napriek tomu, aby sa hodnotil lag replikácie, je potrebné poznať pozíciu žurnálu v transakcii. A tieto pozície žurnálu transakcií sú práve vo výhľade pg_stat_replication. Povedzme, že pomocou funkcie pg_xlog_location_diff() môžeme zobrať dve body v žurnále transakcie. Spočítať medzi nimi rozdiel a získať lag replikácie v bajtoch. To je veľmi pohodlné a jednoduché.
V 10. verzii bola táto funkcia premenovaná na pg_wal_lsn_diff(). Vo všetkých funkciách, pohľadoch a nástrojoch, kde sa vyskytovalo slovo „xlog“, bolo nahradené hodnotou „wal“. Týka sa to nielen pohľadov, ale aj funkcií. Je to takéto novinky.
Navyše v 10. verzii pribudli riadky, ktoré konkrétne ukazujú oneskorenie. Ide o write lag, flush lag, replay lag. T. j. tieto veci je dôležité monitorovať. Ak vidíme, že máme oneskorenie replikácie, je potrebné preskúmať, prečo vzniklo, odkiaľ sa vzalo a odstrániť problém.
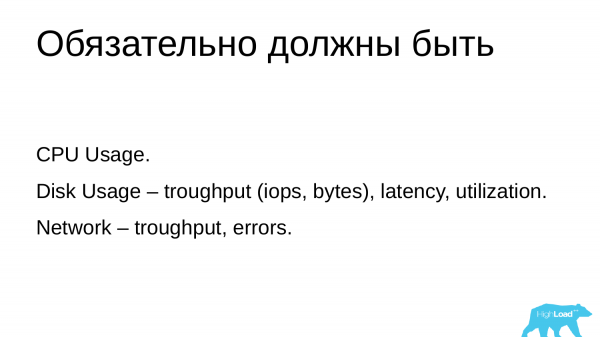
So systémovými metrikami je prakticky všetko v poriadku. Keď sa zakladá akékoľvek monitorovanie, začína so systémovými metrikami. Ide o využitie procesorov, pamäte, swapu, siete a disku. Napriek tomu tam chýba mnoho parametrov predvolene.
Ak je s využitím procesora všetko v poriadku, s využitím disku sú problémy. Zvyčajne vývojári monitorovacích nástrojov pridávajú informácie o priepustnosti. Môže to byť v iops alebo bajtoch. Ale zabúdajú na latenciu a využitie diskových zariadení. Ide o dôležitejšie parametre, ktoré umožňujú hodnotiť, ako sú naše disky zaťažené a ako spomaľujú. Ak máme vysokú latenciu, znamená to, že existujú nejaké problémy s diskami. Ak máme vysoké využitie, znamená to, že disky nezvládajú. Sú to kvalitnejšie charakteristiky ako priepustnosť.
Hoci štatistiku je možné získať aj z filesystému /proc, ako sa to robí pre využitie procesorov. Prečo tieto informácie nezapracovávajú do monitorovaní, neviem. Napriek tomu je dôležité mať toto vo svojom monitorovaní.
Rovnako je to aj v prípade sieťových rozhraní. Existujú informácie o priepustnosti siete v paketoch, v bajtoch, ale napriek tomu chýbajú informácie o latencii a využití, aj keď to je tiež užitočné.
Akékoľvek monitorovania majú nedostatky. A akékoľvek monitorovanie si zoberiete, vždy bude nevyhovovať nejakým kritériám. Napriek tomu sa vyvíjajú, pridávajú sa nové funkcie, nové veci, preto si vyberte niečo a doladte to.
A na to, aby ste to doladili, musíte vždy mať predstavu o tom, čo znamená poskytovaná štatistika a ako s jej pomocou možno vyriešiť problémy.
A niekoľko kľúčových momentov:
- Vždy je dôležité monitorovať dostupnosť a mať prehľadové panely, aby ste mohli rýchlo posúdiť, či je s databázou všetko v poriadku.
- Vždy je potrebné mať predstavu o tom, ktorí klienti pracujú s vašou databázou, aby ste mohli filtrovať zlých klientov a eliminovať ich.
- Je dôležité hodnotiť, ako títo klienti pracujú s údajmi. Je potrebné mať prehľad o vašej záťaži.
- Je dôležité zhodnotiť, ako sa táto záťaž vytvára, akými dopytmi. Môžete hodnotiť dopyty, optimalizovať ich, refaktorovať a vytvárať pre ne indexy. To je veľmi dôležité.
- Pozadie procesov môže negatívne ovplyvniť dopyty klientov, preto je dôležité sledovať, aby nepoužívali príliš veľa zdrojov.
- Systémové metriky vám umožňujú plánovať škálovanie a zvyšovanie kapacity vašich serverov, preto je tiež dôležité ich sledovať a hodnotiť.
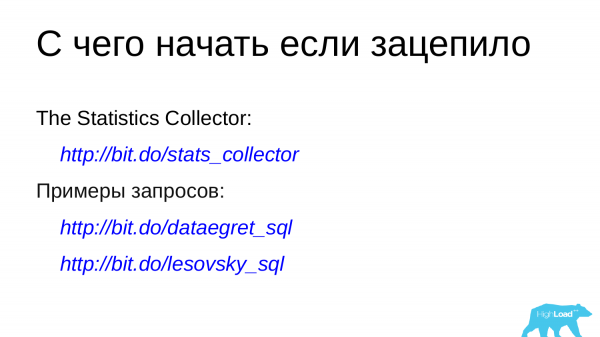
Ak vás táto téma zaujala, môžete si prejsť tieto odkazy.
— je to oficiálna dokumentácia so zberateľmi štatistiky. Tam je popis všetkých štatistických pohľadov a popis všetkých polí. Môžete si ich prečítať, pochopiť a analyzovať. A už na ich základe vytvárať svoje grafy, pridávať ich do svojich monitorovaní.
Príklady dopytov:
Toto je náš firemný repozitár a môj vlastný. Obsahuje príklady dopytov. Neexistujú tam dopyty typu select * from niečo. Sú tam už hotové dopyty s joinmi, s použitím zaujímavých funkcií, ktoré umožňujú z nepresných čísel vytvoriť čitateľné a užitočné hodnoty, t. j. sú to bajty, čas. Môžete ich skúmať, pozerať, analyzovať, pridávať do svojich monitorovaní, budovať na ich základe svoje monitorovania.
Otázky
Otázka: Hovorili ste, že nebudete propagovať značky, ale zaujíma ma – aké prehľadové panely používate vo svojich projektoch?
Odpoveď: Rôzne. Niekedy prídeme k zákazníkovi a on už má svoje monitorovanie. A poraďujeme zákazníkovi, čo by mal pridať do svojho monitorovania. Najhoršie je to so Zabbiх, pretože nemá možnosť vytvárať TopN grafy. My sami používame , pretože sme poradili týmto chlapcom s monitorovaním. Vytvorili monitorovanie PostgreSQL na základe našich požiadaviek. Píšem si svoj pet-project, ktorý zbiera údaje cez Prometheus a zobrazuje ich v . Mám úlohu vytvoriť svoj vlastný exportér v Prometheuse a potom si všetko zobraziť v Grafane.
Otázka: Existujú nejaké alternatívy k AWR správam alebo ... agregáciám? Viete o niečom takom?
Odpoveď: Áno, viem, čo je AWR, je to skvelá vec. V súčasnosti existuje množstvo rôznych riešení, ktoré realizujú približne nasledujúci model. V určitých intervaloch sa zapisujú niektoré základne do toho istého PostgreSQL alebo do samostatného úložiska. Môžete ich vyhľadať na internete, sú k dispozícii. Jeden z vývojárov takého riešenia sa nachádza na fóre sql.ru v téme PostgreSQL. Môžete ho tam zastihnúť. Áno, takéto veci existujú a dajú sa používať. Okrem toho aj ja robím niečo, čo umožňuje robiť to isté.
P.S.1 Ak používate postgres_exporter, aký dashboard používate? Je ich tam niekoľko. Už sú zastarané. Možno by komunita mohla vytvoriť aktualizovanú šablónu?
P.S.2 Odstránil som pganalyze, pretože je to proprietárna SaaS ponuka, ktorá sa zameriava na monitorovanie výkonu a automatizované návrhy na ladenie.
Len registrovaní používatelia sa môžu zúčastniť prieskumu. , prosím.
Aké self-hosted monitorovanie postgresql (s dashboardom) považujete za najlepšie?
30,0%Zabbix + doplnky od Alexeja Lesovského alebo zabbix 4.4 alebo libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze je proprietárna SaaS — nemôžem odstrániť1
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
Hlasovalo 10 používateľov. Zdržalo sa 26 používateľov.
Zdroj: habr.com
