

Ahoj, Habr.
Nedávno som o tom, aké parametre v tíme najčastejšie používame pre Kafka Producer a Consumer, aby sme sa priblížili k garantovanej dodávke. V tomto článku chcem povedať, ako sme zorganizovali opätovné spracovanie udalosti prijatej z Kafka v dôsledku dočasnej nedostupnosti vonkajšieho systému.
Súčasné aplikácie fungujú v veľmi zložitom prostredí. Biznis logika, zabalená v modernom technologickom stacku, bežiaca v Docker obrázku, ktorý spravuje orchestrátor ako Kubernetes alebo OpenShift, a komunikujúca s inými aplikáciami alebo enterprise riešeniami prostredníctvom reťazca fyzických a virtuálnych smerovačov. V takomto prostredí sa vždy môže niečo pokaziť, preto je opätovné spracovanie udalostí v prípade nedostupnosti jedného z vonkajších systémov dôležitou súčasťou našich biznis procesov.
Ako to bolo pred Kafka
Predtým sme v projekte používali IBM MQ naasynchrónny prenos správ. Ak došlo k nejakej chybe počas fungovania služby, prijatá správa mohla byť umiestnená do dead-letter-queue (DLQ) na ďalšie manuálne spracovanie. DLQ sa vytváral vedľa vstupnej fronty a presun správy prebiehal v rámci IBM MQ.
Ak bola chyba dočasná a mohli sme to určiť (napríklad ResourceAccessException pri HTTP volaní alebo MongoTimeoutException pri dotaze do MongoDb), do platnosti vstúpila stratégia opakovaných volaní. Bez ohľadu na vetvenie logiky aplikácie bola pôvodná správa presúvaná buď do systémovej fronty na oneskorené odoslanie, alebo do samostatnej aplikácie, ktorá bola dávno vytvorená na opätovné odosielanie správ. Pri tom sa do hlavičky správy zapisuje číslo opätovného odoslania, ktoré je viazané na časové oneskorenie alebo na koniec stratégie na úrovni aplikácie. Ak sme dosiahli koniec stratégie, ale vonkajší systém je stále nedostupný, správa bude umiestnená do DLQ na manuálne spracovanie.
Hľadanie riešenia
, môžete nájsť nasledujúce . Ak to zhrnieme, navrhuje sa zaviesť po jednu tému na každý interval oneskorenia a realizovať na strane aplikácie Consumerov, ktorí budú čítať správy s potrebným oneskorením.
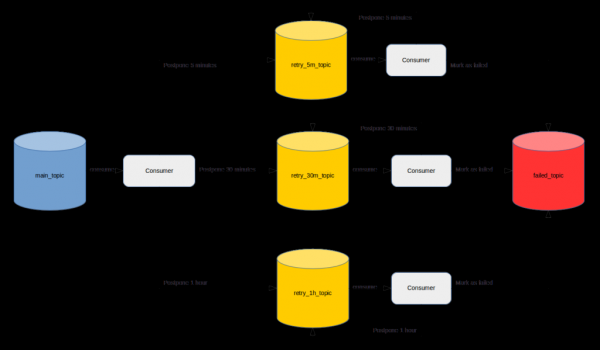
Hoci má veľa pozitívnych recenzií, zdá sa mi, že nie je úplne úspešné. Predovšetkým preto, že vývojárovi bude okrem implementácie obchodných požiadaviek potrebovať veľa času na zavedenie opísaného mechanizmu.
Okrem toho, ak je v klasteri Kafka zapnuté riadenie prístupu, bude potrebné stráviť nejaký čas vytváraním tém a zabezpečením potrebných prístupov k nim. Navyše je potrebné vybrať správny parameter retention.ms pre každú z retrial-tém, aby správy stihli byť znovu odoslané a nestratili sa. Implementáciu a žiadosť o prístupy bude potrebné zopakovať pre každú existujúcu alebo novú službu.
Poďme sa teraz pozrieť na mechanizmy opätovného spracovania správ, ktoré nám ponúka spring ako celok a spring-kafka osobitne. Spring-kafka má prenosnú závislosť na spring-retry, ktorý poskytuje abstrakcie na správu rôznych BackOffPolicy. Je to celkom flexibilný nástroj, ale jeho významným nedostatkom je uchovávanie správ na opätovné odoslanie v pamäti aplikácie. To znamená, že reštart aplikácie kvôli aktualizácii alebo chybe počas prevádzky povedie k strate všetkých správ čakajúcich na opätovné spracovanie. Keďže tento bod je kritický pre náš systém, ďalej sme sa ním nezaoberali.
Sama spring-kafka poskytuje niekoľko realizácií ContainerAwareErrorHandler, ako napríklad , pomocou ktorého je možné spracovať správu neskôr bez zmeny offsetu v prípade chyby. Od verzie spring-kafka 2.3 existuje možnosť nastaviť BackOffPolicy.
Tento prístup umožňuje opätovne spracovávaným správam prežiť reštart aplikácie, ale mechanizmus DLQ stále chýba. Tento variant sme si vybrali začiatkom roka 2019, optimisticky sme predpokladali, že DLQ nebude potrebný (mali sme šťastie a naozaj nebol potrebný počas niekoľkých mesiacov prevádzky aplikácie s týmto systémom opätovného spracovania). Dočasné chyby viedli k aktivácii SeekToCurrentErrorHandler. Ostatné chyby sa zapisovali do logu, viedli k posunu offsetu a spracovanie pokračovalo s nasledujúcou správou.
Konečné riešenie
Implementácia založená na SeekToCurrentErrorHandler nás podnietila k vývoju vlastného mechanizmu na opakované odosielanie správ.
Predovšetkým sme chceli využiť už existujúce skúsenosti a rozšíriť ich v závislosti od logiky aplikácie. Pre aplikáciu s lineárnou logikou by bolo optimálne na krátky čas zastaviť čítanie nových správ, ktorý je určený v rámci stratégie opakovaných volaní. Pre ostatné aplikácie sme chceli mať jediný bod, ktorý by zabezpečoval vykonávanie stratégie opakovaných volaní. Okrem toho by tento jediný bod mal mať funkčnosť DLQ pre oba prístupy.
Samotná stratégia opakovaných volaní by mala byť uložená v aplikácii, ktorá je zodpovedná za získať ďalší interval pri výskyte dočasnej chyby.
Zastavenie Consumer'a pre aplikáciu s lineárnou logikou
Pri práci so spring-kafka môže kód na zastavenie Consumer'a vyzerať približne takto:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // to DLQ
    }
V príklade je retryAt čas, kedy je potrebné znova spustiť MessageListenerContainer, ak ešte funguje. Opätovné spustenie sa uskutoční v samostatnom vlákne, ktoré je spustené v TaskScheduler, ktorého implementáciu tiež poskytuje spring.
Hodnotu retryAt nachádzame nasledujúcim spôsobom:
- Hľadá sa hodnota počítadla opakovaných volaní.
- Podľa hodnoty počítadla sa hľadá aktuálny interval oneskorenia v stratégii opakovaných volaní. Stratégia je deklarovaná priamo v aplikácii, na jej uchovanie sme zvolili formát JSON.
- Nájdený v JSON-rozsahu interval obsahuje počet sekúnd, po ktorých je potrebné opakovať spracovanie. Tento počet sekúnd sa pridá k aktuálnemu času, čím vznikne hodnota pre retryAt.
- Ak interval nie je nájdený, hodnota retryAt je null a správa bude odoslaná do DLQ na manuálne spracovanie.
Pri tomto prístupe zostáva iba zachovať počet opakovaných volaní pre každú správu, ktorá je momentálne spracovávaná, napríklad v pamäti aplikácie. Uchovávanie počítadla pokusov v pamäti nie je pre tento prístup kritické, pretože aplikácia s lineárnou logikou nemôže vykonávať spracovanie celkovo. Na rozdiel od spring-retry reštartovanie aplikácie nevedie k strate všetkých správ na opätovné spracovanie, ale jednoducho k reštartovaniu stratégie.
Tento prístup pomáha znížiť záťaž na externý systém, ktorý môže byť nedostupný z dôvodu veľmi veľkej záťaže. Inými slovami, okrem opätovného spracovania sme dosiahli realizáciu vzoru .
V našom prípade prah chyby predstavuje iba hodnotu 1, a aby sme minimalizovali prestoj systému z dôvodu dočasnej sieťovej poruchy, používame veľmi granularnú stratégiu opakovaných volaní s malými časovými intervalmi oneskorenia. To nemusí vyhovovať všetkým aplikáciám skupiny, preto je potrebné prah chyby a veľkosť intervalu nastaviť na základe vlastností systému.
Samostatná aplikácia na spracovanie správ z aplikácií s nedeterministickou logikou
Tu je príklad kódu, ktorý posiela správu do takejto aplikácie (Retryer), ktorá vykoná opakované odoslanie do topiku DESTINATION pri dosiahnutí času RETRY_AT:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
Z príkladu je vidieť, že sa prenáša veľa informácií v hlavičkách. Hodnota RETRY_AT sa nachádza rovnako ako pre mechanizmus opakovaného pokusu prostredníctvom zastavenia Consumer’a. Okrem DESTINATION a RETRY_AT prenášame:
- GROUP_ID, podľa ktorého skupinujeme správy na ručnú analýzu a zjednodušenie vyhľadávania.
- ORIGINAL_PARTITION, aby sme sa pokúsili zachovať rovnakého Consumer pre opätovné spracovanie. Tento parameter môže byť rovný null, v takom prípade bude nová partition získaná podľa kľúča record.key() pôvodnej správy.
- Aktualizovaná hodnota COUNTER, aby sme dodržiavali stratégiu opakovaných volaní.
- SEND_TO — konštanta ukazujúca, či poslať správu na opätovné spracovanie po dosiahnutí RETRY_AT, alebo ju umiestniť do DLQ.
- REASON — dôvod, prečo bolo spracovanie správy prerušené.
Retryer uchováva správy na opätovné odoslanie a ručné spracovanie v PostgreSQL. Podľa časovača sa spúšťa úloha, ktorá vyhľadáva správy s nastaveným RETRY_AT a posiela ich späť do partition ORIGINAL_PARTITION topiku DESTINATION s kľúčom record.key().
Po odoslaní sú správy odstránené z PostgreSQL. Ručné spracovanie správ prebieha v jednoduchom UI, ktoré interaguje s Retryer prostredníctvom REST API. Jeho hlavnými funkciami sú opätovné odosielanie alebo odstraňovanie správ z DLQ, prezeranie informácií o chybách a vyhľadávanie správ, napríklad podľa názvu chyby.
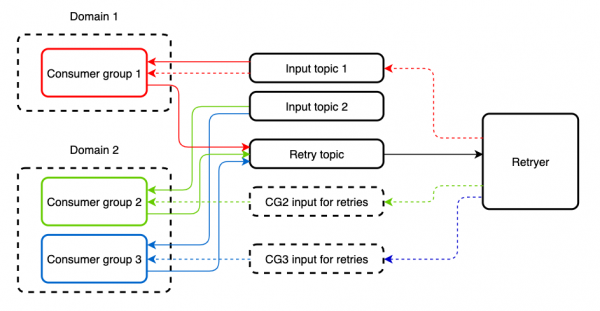
Keďže v našich klastroch je zapnuté riadenie prístupu, je potrebné navyše žiadať prístupy k topiku, ktorý sleduje Retryer, a umožniť Retryer’ovi zapisovať do topiku DESTINATION. Je to nepríjemné, ale na rozdiel od prístupu s topikom na interval máme plnohodnotnú DLQ a UI na jej správu.
Existujú prípady, keď vstupný topik číta niekoľko rôznych skupín consumer, aplikácie ktorých implementujú rôznu logiku. Opakované spracovanie správy cez Retryer pre jednu z týchto aplikácií povedie k duplicite v inej. Aby sme sa tomu vyhli, zakladáme samostatný topik na opakované spracovanie. Vstupný a retry-topik môže čítať ten istý Consumer bez akýchkoľvek obmedzení.
Podľa predvoleného nastavenia tento prístup neposkytuje možnosť circuit breaker’a, ale dá sa pridať do aplikácie pomocou alebo nového , obalením miest volaní vonkajších služieb do príslušných abstrakcií. Okrem toho sa objavuje možnosť voľby stratégie pre pattern, čo môže byť tiež užitočné. Napríklad v spring-cloud-netflix to môže byť thread pool alebo semafor.
Záver
V dôsledku toho máme samostatnú aplikáciu, ktorá umožňuje zopakovať spracovanie správy pri dočasnej nedostupnosti akejkoľvek vonkajšej systému.
Jednou z hlavných výhod aplikácie je, že ju môžu používať vonkajšie systémy, ktoré fungujú na tom istom Kafka klastere, bez významných úprav na svojej strane! Takejto aplikácii stačí získať prístup k retry-topic, vyplniť niekoľko Kafka hlavičiek a poslať správu do Retryer. Nie je potrebné budovať žiadnu ďalšiu infraštruktúru. A aby sme znížili počet presúvaných správ z aplikácie do Retryer a späť, vyčlenili sme aplikácie s lineárnou logikou a implementovali v nich opätovné spracovanie cez zastavenie Consumer.
Zdroj: habr.com
