

Nasledujúca konferencia HighLoad++ sa uskutoční 6. a 7. apríla 2020 v Petrohrade.
Podrobnosti a vstupenky . HighLoad++ Siberia 2019. Sála „Krasnojarsk“. 25. júna, 12:00. Témy a .
Niekedy praktické požiadavky konfliktujú s teóriou, kde nie sú zohľadnené dôležité aspekty pre komerčný produkt. V tejto prednáške je predstavený proces výberu a kombinovania rôznych prístupov k vytvoreniu komponentov kauzálnej konzistencie na základe akademických výskumov v súlade s požiadavkami komerčného produktu. Poslucháči sa dozvedia o existujúcich teoretických prístupoch k logickým hodinám, sledovaniu závislostí, bezpečnosti systému, synchronizácii hodín a prečo sa MongoDB rozhodlo pre konkrétne riešenia.
Michal Tuleň (ďalej – M.T.): – Budem rozprávať o kauzalnej konzistencii – je to funkcia, na ktorej sme pracovali v MongoDB. Pracujem v skupine distribuovaných systémov, robili sme ju približne pred dvoma rokmi.
Počas tohto procesu bolo nutné oboznámiť sa s veľkým množstvom akademického výskumu, pretože táto funkcia je pomerne dobre preskúmaná. Zistilo sa, že žiadny článok nezodpovedá tomu, čo je potrebné v produkcii, databáze vzhľadom na veľmi špecifické požiadavky, ktoré sú pravdepodobne v každej aplikácii v produkcii.
Budem rozprávať o tom, ako my, ako spotrebitelia akademického výskumu, pripravujeme niečo, čo môžeme neskôr predložiť našim používateľom ako hotové jedlo, ktoré je pohodlné a bezpečné na používanie.
Kauzálna konzistencia (Causal consistency). Definujme si pojmy.
Na začiatok chcem v obecných črtách povedať, čo je to kauzálna konzistencia. Sú dvaja protagonisti – Leonard a Penny (seriál „Teória veľkého tresku“):
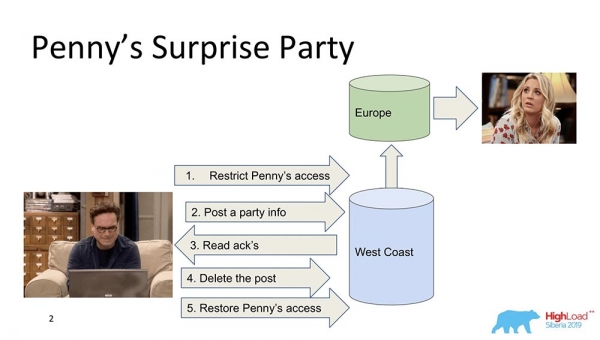
Predpokladajme, že Penny je v Európe a Leonard chce pre ňu pripraviť nejaké prekvapenie, párty. A nič lepšieho ho nenapadne, než ju vyhodiť zo zoznamu priateľov, poslať všetkým priateľom aktualizáciu na feed: „Poďme potešiť Penny!“ (ona je v Európe, zatiaľ čo spí, nevidí to všetko a nemôže to vidieť, pretože tam nie je). Na konci tento príspevok vymaže, vymaže z „Fidov“ a obnoví prístup, aby si nič nevšimla a neboli žiadne škandály.
To je všetko skvelé, ale poďme predpokladať, že systém je distribuovaný a udalosti sa nevyvíjajú úplne podľa plánu. Môže sa napríklad stať, že obmedzenie prístupu Penny nastalo až po publikovaní tohto príspevku, ak udalosti nie sú navzájom príčinno-následkové. Toto je príklad situácie, kedy je na dosiahnutie obchodnej funkcie (v tomto prípade) potrebná príčinná konzistencia.
V skutočnosti ide o dosť netriviálne vlastnosti databáz – veľmi málo z nich ich podporuje. Prejdime na modely.
Modely konzistencie (Consistency Models)
Čo vlastne znamená model konzistencie v databázach? Ide o určité záruky, ktoré distribuovaný systém poskytuje ohľadom toho, aké dáta a v akom poradí môže klient získať.
V podstate všetky modely konzistencie sa znižujú na to, ako veľmi je distribuovaný systém podobný systému, ktorý napríklad beží na jednom uzle na notebooku. A to, do akej miery je systém, ktorý beží na tisícoch geograficky rozložených uzlov, podobný notebooku, v ktorom sú všetky tieto vlastnosti vo všeobecnosti automaticky splnené.
Preto sa modely konzistencie aplikujú iba na distribuované systémy. Všetky systémy, ktoré existovali predtým a fungovali na jednom vertikálnom škálovaní, takéto problémy nemali. Existovala tam jedna vyrovnávacia pamäť (Buffer Cache) a z nej sa vždy čítalo.
Model Strong
Vlastne, najprv vznikol model Strong (alebo rise ability, ako sa často nazýva). Je to model konzistencie, ktorý zaručuje, že každá zmena, akonáhle sa potvrdí jej vykonanie, je viditeľná všetkým používateľom systému.
To vytvára globálny poriadok všetkých udalostí v databáze. Ide o veľmi silnú vlastnosť konzistencie a je veľmi nákladná. Napriek tomu je veľmi dobre podporovaná. Je to prosto veľmi drahé a pomalé – používajú sa to len zriedka. Nazýva sa to rise ability.
Existuje ešte jedna, silnejšia vlastnosť, ktorá je podporovaná v 'Spanner' – nazýva sa External Consistency. O nej si povieme neskôr.
Causal
Nasledujúce je Causal, presne to, o čom som hovoril. Medzi Strong a Causal existuje niekoľko ďalších podúrovní, o ktorých nebudem hovoriť, ale všetky sa zlučujú do Causal. Je to dôležitý model, pretože je to najsilnejší zo všetkých modelov, s najvyššou konzistenciou pri existencii siete alebo rozdelení.
Causals sú vlastne situácia, v ktorej sú udalosti prepojené príčinnou súvislosťou. Často sa vnímajú ako Read your on rights z pohľadu klienta. Ak klient sledoval určité hodnoty, nemôže vidieť hodnoty, ktoré boli v minulosti. Už začína vidieť prefíxové čítania. To všetko sa týka toho istého.
Causals ako model konzistencie – čiastočné usporiadanie udalostí na serveri, pri ktorom sú udalosti zo všetkých klientov pozorované v tej istej postupnosti. V tomto prípade – Leonard a Penny.
Eventual
Tretí model – to je Eventual Consistency. To je niečo, čo podporuje absolútne všetky distribuované systémy, minimálny model, ktorý vôbec má zmysel. Znamená to nasledujúce: keď sa uskutočnia nejaké zmeny v dátach, v nejakom momente sa stanú konzistentnými.
V takom momente to nič nehovorí, inak by sa to premenilo na External Consistency – bola by to úplne iná história. Napriek tomu je to veľmi populárny model, najrozšírenejší. Podľa predvoleného nastavenia všetci používatelia distribuovaných systémov používajú práve Eventual Consistency.
Chcem uviesť niekoľko porovnávacích príkladov:
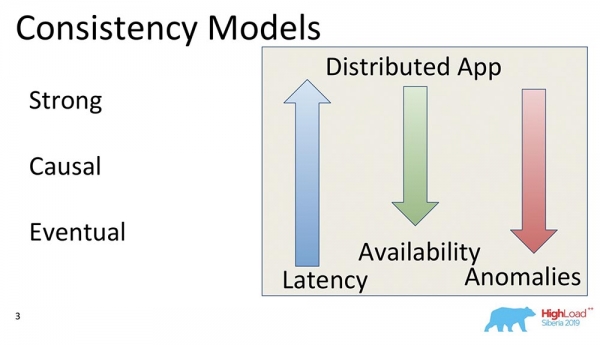
Čo tieto šípky znamenajú?
- Latencia. Pri zvyšovaní sily konzistencie sa zvyšuje aj latencia z jasných dôvodov: je potrebné vykonať viac záznamov, získať potvrdenie od všetkých hostiteľov a uzlov, ktoré sa podieľajú na klastri, že údaje tam už sú. Preto v Eventual Consistency je najrýchlejšia odpoveď, pretože tam spravidla možno aj v pamäti komitnúť a to bude v zásade stačiť.
- Dostupnosť. Ak to chápeme ako schopnosť systému odpovedať pri rozpojeniach siete, rozdeleniach alebo nejakých zlyhaniach – odolnosť voči zlyhaniam sa zvyšuje pri znižovaní modelu konzistencie, pretože nám stačí, aby jeden hostiteľ fungoval a poskytoval nejaké údaje. Eventual Consistency nezaručuje nič, čo sa týka údajov – môže to byť čokoľvek.
- Anomálie. Samozrejme sa zvyšuje aj počet anomálií. V prípade Strong Consistency by ich vôbec nemalo byť, zatiaľ čo Eventual Consistency môže obsahovať akékoľvek anomálie. Otázka znie: prečo si ľudia vyberajú Eventual Consistency, keď obsahuje anomálie? Odpoveď spočíva v tom, že modely Eventual Consistency sú použiteľné a anomálie existujú iba na veľmi krátku dobu; je možné používať master na čítanie a viac-menej čítať konzistentné údaje; často existuje možnosť použiť silné modely konzistencie. Prakticky to funguje, a často je počet anomálií časovo obmedzený.
Teorema CAP
Keď vidíte slová konzistencia, dostupnosť – čo vám napadne? Správne – teória CAP! Chcem teraz rozptýliť mýtus… Nie som to ja – je to Martin Kleppmann, ktorý napísal skvelý článok, skvelú knihu.
Teorema CAP je princip, ktorý bol formulovaný v 2000-tych rokoch a hovorí, že Konzistencia, Dostupnosť, Partitioning: vezmite si dve, a nie je možné vybrať tri. Bol to istý princíp. Bol ako teorema dokázaný o niekoľko rokov neskôr Gilbertom a Lynchom. Potom sa to začalo používať ako mantra – systémy sa začali deliť na CA, CP, AP a podobne.
Táto teorema bola naozaj dokázaná pre takéto prípady… Po prvé, dostupnosť nebola posudzovaná ako hodnota od 0 do 100 (0 – systém je 'mŕtvy', 100 – reaguje rýchlo; takto sme na to zvyknutí pozerať), ale ako vlastnosť algoritmu, ktorá zaručuje, že pri všetkých jeho vykonaniach vracia dáta.
O čase odpovede tam vlastne nie je ani slovo! Existuje algoritmus, ktorý vracia údaje po 100 rokoch – úplne vynikajúci dostupný algoritmus, ktorý je súčasťou teórie CAP.
Po druhé: teorema bola dokázaná pre zmeny hodnôt jedného a toho istého kľúča, pričom tieto zmeny sú líniou resizable. To znamená, že sa v skutočnosti prakticky nepoužívajú, pretože existujú iné modely Eventual Consistency, Strong Consistency (možno).
O čo ide? O to, že teorema CAP v tej forme, v akej bola dokázaná, je prakticky neaplikovateľná, zriedka používaná. V teoretickej forme obmedzuje spôsobom, ktorý je intuitívne pravdivý, ale v skutočnosti nie je dokázaný.
Causal consistency – najsilnejší model
To, čo sa teraz deje – môžete získať všetky tri veci: konzistenciu, dostupnosť pomocou partition. Zvlášť kauzálna konzistencia – je najsilnejší model konzistencie, ktorý za prítomnosti partition (výpadkov v sieti) stále funguje. Preto predstavuje taký veľký záujem, a preto sme sa ňou zaoberali.
Po prvé, zjednodušuje prácu vývojárov aplikácií. Zvlášť prítomnosť veľkej podpory zo strany servera: keď všetky záznamy, ktoré sa dejú v rámci jedného klienta, sú zaručené, že prídu v takom poradí na inom klientovi. Po druhé, zvláda partition.
Interné záležitosti MongoDB
Pamätajúc na to, že máme obedy, presúvame sa do kuchyne. Povedal by som vám o modeli systému, teda – čo je MongoDB pre tých, ktorí o tejto databáze počujú prvýkrát.
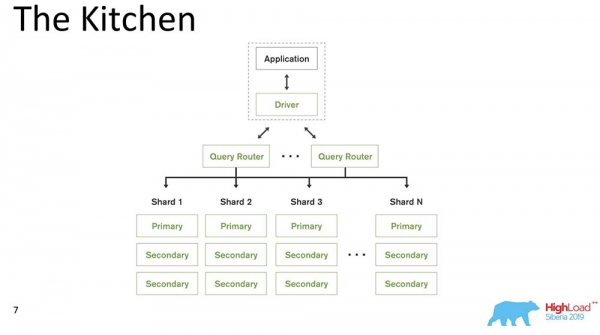
MongoDB (ďalej – „MongoDB“) je distribuovaný systém, ktorý podporuje horizontálne škálovanie, teda shardovanie; a v rámci každého shardu tiež podporuje redundanciu dát, teda replikáciu.
Shardovanie v „MongoDB“ (nerelacionálna databáza) vykonáva automatické vyváženie, teda každá kolekcia dokumentov (alebo „tabuľa“ v termínoch relačných dát) sa delí na kusy a server ich automaticky presúva medzi shardami.
Dotazovací router, ktorý distribuuje dopyty, je pre klienta určitým klientom, prostredníctvom ktorého pracuje. Už vie, kde a aké dáta sa nachádzajú a smeruje všetky dopyty k správnemu shardu.
Ešte jeden dôležitý bod: MongoDB je single master. Existuje jeden primárny – môže spracovávať záznamy, ktoré podporujú kľúče, ktoré obsahuje. Nie je možné vykonávať zapísanie z viacerých masterov.
Urobili sme vydanie 4.2 – objavili sa tam nové zaujímavé veci. Zvlášť sme integrovali Lucene – vyhľadávanie – priamo vykonateľné Java vo „Mongu“, a je teraz možné vykonávať vyhľadávanie prostredníctvom Lucene, ako v „Elastiku“.
A vytvorili sme nový produkt – Grafy, ktorý je tiež dostupný na „Atlase“ (vlastný cloud „Mongo“). Majú bezplatnú verziu – môžete si s tým pohrať. Grafy sa mi veľmi páčili – vizualizácia dát, veľmi intuitívna.
Zložky kauzálnej konzistencie
Spočítal som asi 230 článkov, ktoré boli na túto tému publikované – od Leslie Lampert. Teraz vám z mojej pamäte prinesiem niektoré časti týchto materiálov.
Všetko sa to začalo článkom Leslie Lampertovej, ktorý bol napísaný v 70. rokoch. Ako vidíte, aj dnes sa pokračuje v nejakých výskumoch na túto tému. Momentálne Causal consistency zažíva záujem v súvislosti s rozvojom distribuovaných systémov.
Obmedzenia
Aké obmedzenia existujú? To je skutočne jeden z hlavných bodov, pretože obmedzenia, ktoré ukladajú produkčné systémy, sa výrazne líšia od obmedzení, ktoré existujú v akademických článkoch. Často sú dosť umelé.
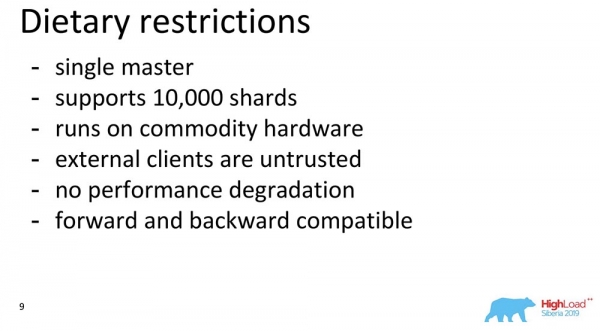
- Po prvé, „MongoDB“ je single master, ako som už povedal (to značne zjednodušuje).
- Považujeme, že systém by mal podporovať približne 10 000 shardov. Nemôžeme prijať žiadne architektonické rozhodnutia, ktoré by toto číslo jasne obmedzovali.
- Máme cloud, ale predpokladáme, že užívateľ by mal mať možnosť, keď si stiahne binary, spustiť to na svojom laptope a všetko by malo fungovať bez problémov.
- Predpokladáme, že v oblasti výskumu sa zriedka používa: externí klienti môžu robiť čokoľvek. „MongoDB“ je open source. Zodpovedajúce, klienti môžu byť takí inteligentní, zlí – môžu chcieť všetko zničiť. Predpokladáme, že sa môžu vyskytnúť byzantské failory.
- Pre externých klientov, ktorí sú mimo perimetra – dôležité obmedzenie: ak je táto funkcia vypnutá, nemalo by dochádzať k žiadnemu zhoršeniu výkonu.
- Ďalší aspekt – naozaj antiakademický: kompatibilita predchádzajúcich verzií a budúcich. Staré ovládače by mali podporovať nové aktualizácie a databáza by mala podporovať staré ovládače.
Celkovo to všetko kladie obmedzenia.
Komponenty Causal consistency
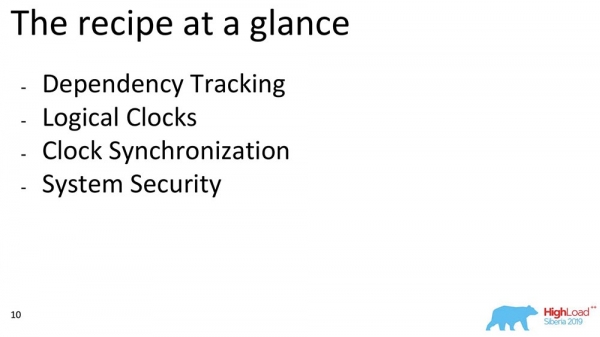
Teraz poviem niečo o niektorých komponentoch. Ak sa pozrieme na Causal consistency, môžeme vyčleniť bloky. Vyberali sme z prác, ktoré sa týkajú nejakej časti: Sledovanie závislostí, výber hodín, ako sa tieto hodiny môžu synchronizovať navzájom, a ako zabezpečujeme bezpečnosť – to je približne plán toho, o čom budem hovoriť:
Úplné sledovanie závislostí (Full Dependency Tracking)
Prečo je to potrebné? Aby, keď sa replikujú údaje – každý záznam, každá zmena údajov obsahovala informácie o tom, od ktorých zmien závisí. Najprv a naivnejšia zmena – to je, keď každá správa, ktorá obsahuje záznam, obsahuje informácie o predchádzajúcich správach:
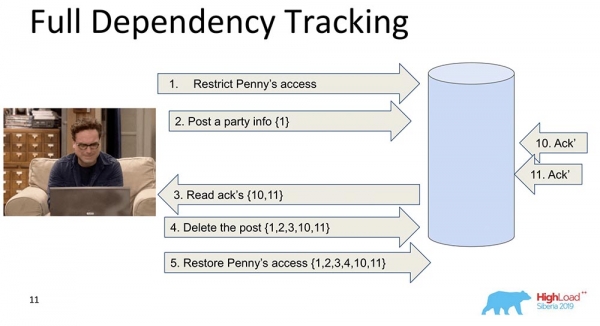
V tomto príklade číslo v zložených zátvorkách – to sú čísla záznamov. Niekedy sa tieto záznamy so hodnotami prenášajú dokonca celé, niekedy sa prenášajú nejaké verzie. Zmysel spočíva v tom, že každá zmena obsahuje informácie o predchádzajúcom (výslovne to všetko nesie v sebe).
Prečo sme sa rozhodli nepoužívať takýto prístup (úplné sledovanie)? Očividne preto, lebo tento prístup je nepraktický: akákoľvek zmena v sociálnej sieti závisí od všetkých predchádzajúcich zmien v tejto sociálnej sieti, prenášajúc, povedzme, „Facebook“ alebo „Vkontakte“ v každej aktualizácii. Napriek tomu existuje množstvo výskumov konkrétne o Full Dependency Tracking – to sú pred-sociálne siete, pre niektoré situácie to naozaj funguje.
Explicitné sledovanie závislostí (Explicit Dependency Tracking)
Ďalší – obmedzenejší. Tu sa tiež zvažuje prenos informácií, ale iba tých, ktoré sú výslovne závislé. To, čo od čoho závisí, zvyčajne určuje už aplikácia. Pri replikácii údajov sa pri žiadosti vydávajú iba odpovede, keď boli splnené predchádzajúce závislosti, teda zobrazené. V tom spočíva podstata toho, ako funguje kauzálna konzistencia.
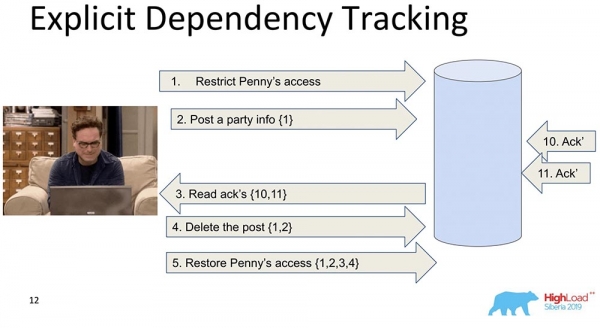
Vidí, že záznam 5 závisí od záznamov 1, 2, 3, 4 – teda čaká, kým klient získa prístup k zmenám, ktoré urobil príkazom prístupu Penny, keď už všetky predchádzajúce zmeny prešli v databáze.
To nás tiež nevyhovuje, pretože informácií je stále príliš veľa a to bude spomaľovať. Existuje iný prístup…
Lamportove hodiny (Lamport Clock)
Sú veľmi staré. Lamport Clock predpokladá, že tieto závislosti sa zlučujú do skalárnej funkcie, ktorá sa nazýva Lamport Clock.
Skalárna funkcia je určité abstraktné číslo. Často sa označuje ako logický čas. Pri každom udalosti sa tento counter zvyšuje. Counter, ktorý je momentálne známy procesu, posiela každú správu. Je jasné, že procesy môžu byť rozosynchronizované, môžu mať úplne rôzny čas. Napriek tomu takouto výmenou správ systém nejakým spôsobom vyrovnáva hodiny. Čo sa v takom prípade deje?
Rozdelil som tú veľkú shard na dve časti, aby to bolo jasnejšie: Friends môžu žiť v jednom node, ktorý obsahuje časť kolekcie, zatiaľ čo Feed – v úplne inom node, ktorý obsahuje časť tejto kolekcie. Ako sa môžu dostať mimo fronty? Najprv Feed povie: „Replikovaný“, a potom – Friends. Ak systém neposkytuje žiadne záruky, že Feed nebude zobrazený, kým závislosti Friends v kolekcii Friends nebudú tiež doručené, potom presne vznikne situácia, ktorú som spomenul.
Vidíte, ako logicky rastie čas counter na Feede:
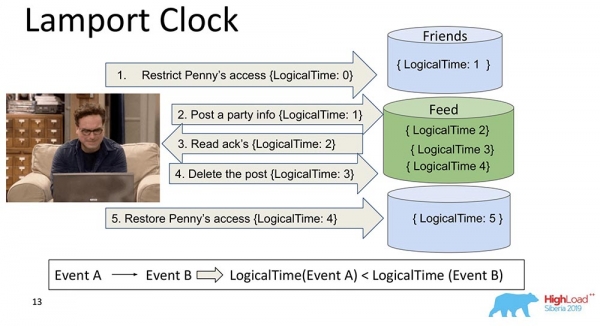
Hlavné vlastnosti tohto Lamport Clock a Causal consistency (vysvetleného cez Lamport Clock) spočívajú v nasledovnom: ak máme udalosti A a B, a udalosť B závisí od udalosti A *, potom z toho vyplýva, že LogicalTime udalosti A je menší ako LogicalTime udalosti B.
* Niekedy sa tiež hovorí, že A happened before B, teda A sa stalo pred B – to je akýsi vzťah, ktorý čiastočne usporadúva celé množstvo udalostí, ktoré sa vôbec stali.
opak nie je pravdivý. V skutočnosti je to jeden z hlavných nedostatkov Lamport Clock – čiastočné usporiadanie. Existuje pojem súčasných udalostí, teda udalostí, pri ktorých ani (A happened before B), ani (B happened before A). Príkladom môže byť paralelné pridávanie Leonarda medzi priateľov niekoho iného (hoci nie Leonardom, ale napríklad Sheldonem).
A to je vlastnosť, ktorú často využívajú pri práci s Lamportovými hodinami: sledujú práve funkciu a z toho vyvodzujú – možno sú tieto udalosti závislé. Pretože v jednom smere je to pravda: ak je LogicalTime A menší ako LogicalTime B, potom B nemôže happened before A; a ak je väčší, tak možno môže.
Vektory hodiny (Vector Clock)
Logický rozvoj Lamportových hodín – to sú Vektorové hodiny. Rozlišujú sa tým, že každý node, ktorý tu je, obsahuje svoje, samostatné hodiny, a tie sú prenášané ako vektor.
V tomto prípade vidíte, že nulový index vektora zodpovedá feedu a prvý index vektora priateľom (každý z týchto uzlov). A teraz sa budú zvyšovať: nulový index „feedu“ sa zvyšuje pri zápise – 1, 2, 3:
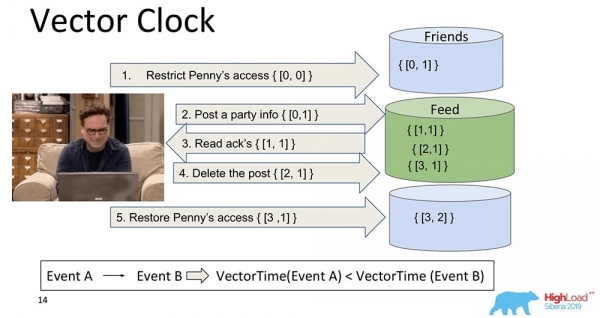
Čím sú vektorové hodiny lepšie? Tým, že umožňujú zistiť, aké udalosti súčasne prebiehajú a kedy sa dejú na rôznych uzloch. To je veľmi dôležité pre systém shardovania, ako je „MongoDB“. Avšak, toto sme nevybrali, aj keď je to skvelá vec a funguje to výborne, asi by nám to vyhovovalo...
Ak máme 10 000 shardov, nemôžeme prenášať 10 000 komponentov, aj keď ich komprimujeme alebo vymýšľame niečo iné – aj tak bude užitočné zaťaženie niekoľkonásobne menšie ako objem celého tohto vektora. Preto sme, s ťažkým srdcom, odmietli tento prístup a prešli sme k inému.
Spanner TrueTime. Atómové hodiny
Hovoril som, že bude reč o „Spanneri“. Je to skvelá vec, priamo 21. storočie: atómové hodiny, GPS-synchronizácia.
Aká je idea? „Spanner“ je systém od Googlu, ktorý nedávno sprístupnili aj ľuďom (pridali k nemu SQL). Každá transakcia tam má určitý časový odtlačok. Keďže je čas synchronizovaný*, každému udalosti je možné priradiť určitý čas – atómové hodiny majú čas čakania, po ktorom určite „nastane“ už iný čas.
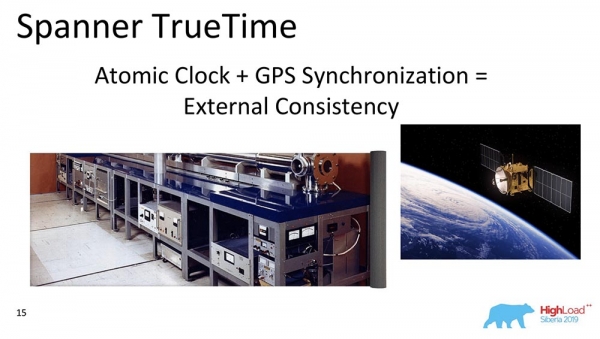
Týmto spôsobom, jednoducho zapisovaním do DB a očakávaním nejakého časového obdobia, je automaticky zaručená serializovateľnosť udalosti. Majú najsilnejší model konzistencie, ktorý je vlastne možné predstaviť – je to externá konzistencia.
* To je hlavný problém Lamportových hodín – nikdy nie sú synchronizované na distribuovaných systémoch. Môžu sa rozchádzať, aj keď je k dispozícii NTP, a stále nefungujú veľmi dobre. „Spanner“ má atómové hodiny a synchronizáciu, zdá sa, na mikrosekundy.
Prečo sme nevybrali? Predpokladáme, že naši používatelia nemajú zabudované atómové hodiny. Keď sa objavia, a budú zabudované do každého notebooku, bude nejaká super skvelá GPS-synchronizácia – vtedy áno… Ale zatiaľ to najlepšie, čo je možné – sú „Amazon“, základňové stanice – pre fanatikov… Preto sme použili iné hodiny.
Hybridné hodiny (Hybrid Clock)
Toto je vlastne to, čo tiká v „MongoDB“ pri zabezpečení kauzálnej konzistencie. Čím sú hybridné? Hybrid je skalárna hodnota, ale pozostáva z dvoch komponentov:
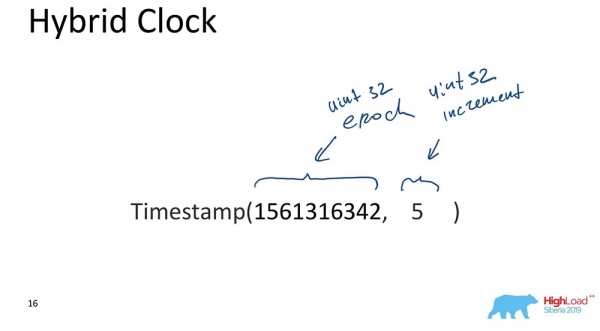
- Prvá je unixová epocha (koľko sekúnd uplynulo od „začiatku počítačového sveta“).
- Druhá je určitý inkrement, tiež 32-bitový unsigned int.
To je vlastne všetko. Existuje taký prístup: časť, ktorá zodpovedá za čas, sa neustále synchronizuje s hodinami; zakaždým, keď dôjde k aktualizácii, táto časť sa synchronizuje s hodinami a dostáva sa k tomu, že čas je vždy viac-menej správny, zatiaľ čo inkrement umožňuje rozlíšiť udalosti, ktoré sa stali v rovnakom okamihu.
Prečo je to dôležité pre „MongoDB“? Pretože to umožňuje robiť zálohovania a obnovy k určitým časovým okamihom, teda udalosť je indexovaná časom. Je to dôležité, keď sú potrebné niektoré udalosti; pre databázy sú udalosti zmeny v databáze, ktoré sa stali v určitých časových intervaloch.
Najdôležitejší dôvod vám poviem iba vám (prosím, len to nikomu nehovorte)! Urobili sme to tak, pretože takto vyzerajú usporiadané, indexované dáta v MongoDB OpLog. OpLog je dátová štruktúra, ktorá obsahuje všetky zmeny v databáze: najprv sa dostanú do OpLog a potom sa aplikujú do vlastného úložiska v prípade, že ide o replikované dáta alebo shard.
Toto bola hlavná príčina. Existujú aj praktické požiadavky na vývoj databázy, čo znamená, že to musí byť jednoduché - málo kódu, čo najmenej pokazených vecí, ktoré treba prepisovať a testovať. To, že naše oplogi boli indexované hybridnými hodinami, veľmi pomohlo a umožnilo správny výber. Naozaj to ospravedlnilo seba a akosi čarovne to fungovalo na prvom prototype. Bolo to veľmi skvelé!
Synchronizácia hodín
Existuje niekoľko spôsobov synchronizácie, ktoré sú opísané v odbornej literatúre. Hovorím o synchronizácii, keď máme dva rôzne shardy. Ak existuje jeden replica-set, synchronizácia nie je potrebná: je to "single-master"; máme OpLog, do ktorého sa všetky zmeny uložia – v tomto prípade je všetko už sekvenčne usporiadané v samotnom "OpLogu". Ale ak máme dva rôzne shardy, tu je synchronizácia času dôležitá. Tu nám viac pomohli vektorové hodiny! Ale nemáme ich.
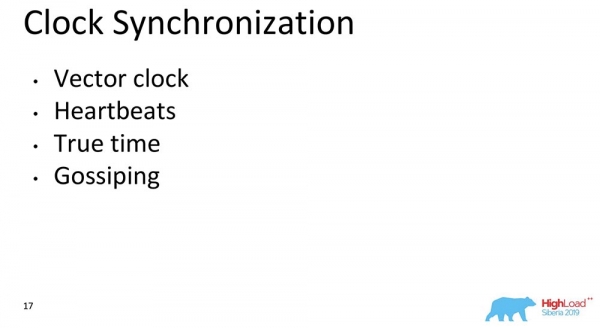
Druhá možnosť sú "Heartbeats". Môžeme si vymieňať určité signály, ktoré prebiehajú každú jednotku času. Ale "Heartbeats" sú príliš pomalé, nemôžeme zabezpečiť latenciu pre našich zákazníkov.
True time – samozrejme, je to skvelá vec. Ale, opäť, to je pravdepodobne budúcnosť… Aj keď v "Atlase" už lze dosiahnuť, už existujú rýchle "amazonické" synchronizátory času. Ale to nebude dostupné pre všetkých.
Gossiping – to je vtedy, keď všetky správy zahŕňajú čas. Je to približne to, čo používame. Každá správa medzi uzlami, ovládač, router dátových uzlov, úplne všetko pre "MongoDB" – to sú akési komponenty databázy, ktoré obsahujú hodiny, ktoré plynú. Všade majú hodnotu hybridného času, táto hodnota sa prenáša. 64 bitov? To umožňuje, to je možné.
Ako to všetko spolupracuje?
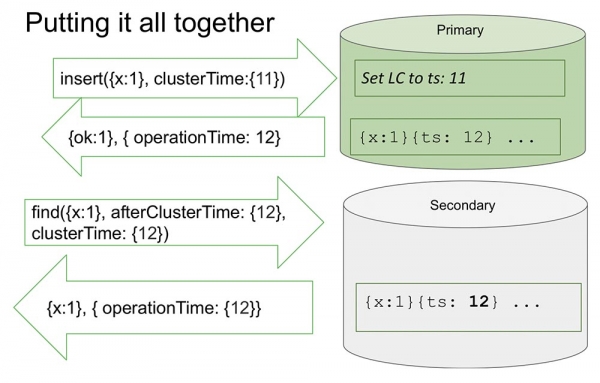
Tu zvažujem jeden replica-set, aby to bolo o niečo jednoduchšie. Existuje Primary a Secondary. Secondary robí replikáciu a nie vždy je úplne synchronizovaný s Primary.
Prebieha vloženie (insert) do "Primary" s určitou hodnotou času. Tento insert zvyšuje vnútorný čítač o 11, ak je to maximálne. Alebo skontroluje hodnoty hodín a synchronizuje sa podľa hodín, ak sú hodnoty hodín väčšie. To umožňuje usporiadať podľa času.
Po tom, čo sa vykoná zápis, nastáva dôležitý okamih. Hodiny v "MongoDB" sú inkrementované iba v prípade zápisu do "OpLogu". To je udalosť, ktorá mení stav systému. Všetky klasické články považujú udalosť za príchod správy do uzla: správa prišla – to znamená, že systém zmenil svoj stav.
To je spôsobené tým, že pri skúmaní nie je úplne jasné, ako bude táto správa interpretovaná. Presne vieme, že ak nie je odrazom v "Oploge", tak nebude interpretovaná vôbec, a zmenou stavu systému je len záznam v "Oplogu". To nám všetko uľahčuje: a model zjednodušuje, a umožňuje poriadok v rámci jedného replika-setu, a veľa ďalších užitočných vecí.
Vracia sa hodnota, ktorá je už zaznamenaná v "Oplogu" – vieme, že v "Oplogu" už je táto hodnota a jej čas – 12. Teraz, povedzme, začína čítanie z iného uzla (Secondary), a on už posiela afterClusterTime v samotnej správe. Hovorí: „Potrebujem všetko, čo sa stalo aspoň po 12 alebo počas dvanástej“ (pozri obrázok vyššie).
Toto sa nazýva Causal and consistent (CAT). Existuje taký pojem v teórii, že to je určitý priesečník času, ktorý je sám o sebe konzistentný. V tomto prípade môžeme povedať, že je to stav systému, ktorý bol pozorovaný v čase 12.
Teraz tu zatiaľ nič nie je, pretože to akoby imituje situáciu, keď je potrebné, aby Secondary replikoval dáta z Primary. Čaká... A už prichádzajú dáta – vracia naspäť tieto hodnoty.
Takto to asi všetko funguje. Takmer.
Čo znamená „takmer“? Predpokladajme, že existuje určitý človek, ktorý prečítal a pochopil, ako to celé funguje. Pochopil, že každýkrát nastáva ClusterTime, aktualizuje interné logické hodiny a potom nasledujúci záznam sa zvyšuje o jednotku. Táto funkcia zaberá 20 riadkov. Predpokladajme, že tento človek posiela maximálne veľké 64-bitové číslo, mínus jedna.
Prečo „mínus jedna“? Pretože interné hodiny sa dosadia do tejto hodnoty (zjavne je to najväčšia možná a väčšia ako aktuálny čas), potom nastane záznam v "Oplogu" a hodiny sa inkrementujú ešte o jednu – a už to bude celkové maximálne hodnotenie (tam sú jednoducho všetky jedničky, ďalej to už neexistuje, unsaint int'y).
Jasné je, že po tomto je systém úplne nedostupný na čokoľvek. Môže sa iba vyexpedovať, vyčistiť – veľa manuálnej práce. Úplná dostupnosť:
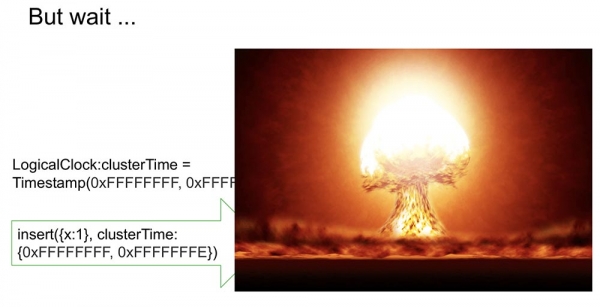
Ak to bude replikované niekam inam, celý klaster sa jednoducho zloží. Úplne neprijateľná situácia, ktorú môže ktokoľvek veľmi rýchlo a jednoducho zorganizovať! Preto sme tento aspekt považovali za jeden z najdôležitejších. Ako to zabrániť?
Naša cesta – podpisovať clusterTime
Takto sa to prenáša v správe (do modrého textu). Ale začali sme tiež generovať podpis (modrý text):
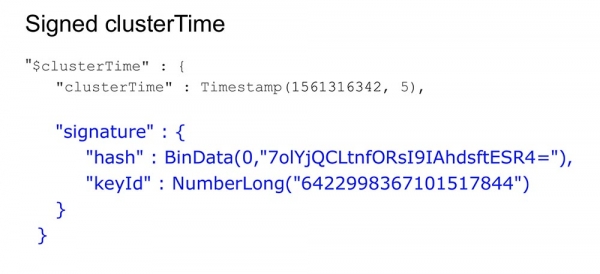
Podpis sa generuje kľúčom, ktorý je uložený vo vnútri databázy, vo vnútri chráneného perimetra; sám sa generuje, aktualizuje (užívatelia to nič nevidia). Generuje sa hash a každá správa pri vytvorení sa podpisuje a pri prijatí sa validuje.
Možno sa u ľudí objaví otázka: „Ako veľmi to všetko spomaľuje?“ Hovoril som, že by to malo fungovať rýchlo, najmä bez tejto funkcie.
Čo to znamená používať Causal consistency v tomto prípade? To znamená ukazovať parameter afterClusterTime. Bez toho jednoducho bude prenášať hodnoty za každých okolností. Gossiping, počnúc verziou 3.6, funguje vždy.
Ak ponecháme neustále generovanie podpisov, spomalí to systém aj bez funkcie, čo nezodpovedá našim prístupom a požiadavkám. A čo sme urobili?
Rob to rýchlo!
Dosť jednoduchá vec, ale zaujímavý trik – zdieľam, možno to niekoho zaujme.
Máme hash, v ktorom sú uložené podpísané dáta. Všetky dáta prechádzajú cez cache. Cache nepodpisuje konkrétne čas, ale rozsah. Keď príde nejaká hodnota, generujeme rozsah, zamaskujeme posledných 16 bitov, a túto hodnotu podpisujeme:
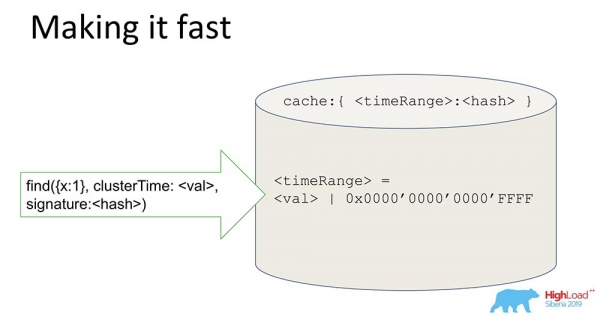
Získaním takého podpisu zrýchlime systém (podmienene) 65 tisíc krát. Funguje to skvele: keď sme vykonali experimenty – naozaj sa čas pri sekvenčnej aktualizácii skrátil na 10 tisíc krát. Je jasné, že keď sú hodnoty roztrúsené, tak to nefunguje. Ale vo väčšine praktických prípadov to funguje. Kombinácia podpisu rozsahu spolu s podpisom umožnila vyriešiť problém bezpečnosti.
Čo sme sa naučili?
Lekcie, ktoré sme z toho vyvodili:
- Je potrebné čítať materiály, príbehy a články, pretože máme veľa zaujímavého obsahu. Keď pracujeme na nejakých funkciách (najmä teraz, keď sme sa zaoberali transakciami a pod.), musíme čítať a rozumieť. To si vyžaduje čas, ale je to naozaj veľmi užitočné, pretože sa stáva jasným, kde sa nachádzame. Nič nové sme vlastne nevymysleli – len sme zobrali prísady.
Vo všeobecnosti pozorujeme určitý rozdiel v myslení, keď ide o akademickú konferenciu (napr. „Sigmon“) – tam všetci sústredia sa na nové nápady. Aká je novosť nášho algoritmu? Tu nie je žiadna zásadná novosť. Novosť spočíva skôr v tom, ako sme skombinovali existujúce prístupy. Preto prvé - treba čítať klasikou, počnúc Lamportom.
- V produkčnom prostredí sú úplne iné požiadavky. Som si istý, že mnohí z vás sa nestretávajú s ‚sférickými‘ databázami v abstraktnom vákuu, ale s normálnymi, reálnymi vecami, ktoré majú problémy s dostupnosťou, latenciou a odolnosťou voči chybám.
- Posledná vec je tá, že sme museli zvážiť rôzne nápady a skombinovať niekoľko úplne rôznych článkov do jedného prístupu. Nápad o podpisovaní, napríklad, prišiel z článku, ktorý sa zaoberal Paxos protokolom, ktorý je určený pre neveziánske zlyhania v rámci autorizačného protokolu, pre veziánske – mimo autorizačného protokolu… V podstate presne to sme nakoniec urobili.
Absolútne nič nové tu nie je! Ale akonáhle sme to všetko skombinovali… Je to ako povedať, že recept na Olivier šalát je nezmysel, pretože vajcia, majonéz a uhorky už vymysleli… To je približne tá istá história.
Na tomto zakončím. Ďakujem!
Otázky
Otázka z publika (ďalej – O): – Ďakujem, Michail, za prezentáciu! Téma o čase je zaujímavá. Používate Gossiping. Povedali ste, že každý má svoj čas, všetci poznajú svoje lokálne časové pásmo. Pochopil som to tak, že máme ovládač - klientov môže byť veľa, plánovačov dotazov tiež, shardov tiež veľa… A kam sa systém dostane, ak zrazu dôjde k rozporu: niekto sa rozhodne, že je o minútu napred, niekto – o minútu pozadu? Kde sa ocitneme?
MT: – To je naozaj skvelá otázka! Práve som chcel povedať o shardoch. Ak to správne chápem, máme takú situáciu: je shard 1 a shard 2, čítanie prebieha z týchto dvoch shardov – sú medzi sebou odlišné, nezapájajú sa vzájomne, pretože čas, ktorý poznajú, je iný, najmä čas, ktorý existuje v oplogoch.
Predpokladajme, že shard 1 vytvoril milión záznamov, shard 2 – vôbec nič, a dopyt prišiel na oba shardy. A prvý má afterClusterTime viac ako milión. V takejto situácii, ako som vysvetlil, shard 2 nikdy neodpovie.
A: – Chcel som sa opýtať, ako sa synchronizujú a vyberú jedno logické čas?
MT: – Synchronizujú sa veľmi jednoducho. Shard, keď k nemu príde afterClusterTime a nenájde čas v „oploge“, iniciuje no approved. To znamená, že manuálne zvyšuje svoj čas na túto hodnotu. To znamená, že nemá žiadne udalosti, ktoré by odpovedali tejto požiadavke. Umelo vytvorí túto udalosť a tým sa stáva Causal Consistent.
A: – A čo ak k nemu po tomto ešte prídu nejaké udalosti, ktoré sa niekde v sieti stratili?
MT: – Shard je nastavený tak, že už neprídu, pretože ide o single master. Ak už zaregistroval, už neprídu, ale prídu neskôr. Nemôže sa stať, že sa niekde niečo zaseklo, potom urobí no write, a potom tieto udalosti prišli – a narušila sa Causal consistency. Keď vykoná no write, všetky musia prísť ďalej (počká si na ne).
A: – Mám niekoľko otázok ohľadom front. Causal consistency predpokladá, že existuje určitá fronta akcií, ktoré je potrebné vykonať. Čo sa stane, ak nám jeden paket zmizne? Takto išiel 10., 11… 12. zmizol, a všetky ostatné čakajú, kedy sa to vykoná. A zrazu nám stroj umrel, nemôžeme nič spraviť. Existuje maximálna dĺžka fronty, ktorá sa hromadí, skôr ako sa vykoná? Aký fatálny zlyhanie sa môže stať pri strate ktorejkoľvek jednej položky? O to viac, ak zapisujeme, že existuje nejaký predošlý stav, mali by sme sa od neho nejako odraziť? Ale od neho sme sa neodrazili!
MT: – To je tiež nádherná otázka! Čo robíme? V MongoDB existuje pojem kvórumových záznamov, kvórumového čítania. V akých prípadoch môže správa zmiznúť? Keď zápis nie je kvórumový alebo keď čítanie nie je kvórumové (môže sa tam tiež objaviť nejaký garbage).
V súvislosti s kauzálnou konzistenciou sme vykonali rozsiahle experimentálne testovanie, ktorého výsledkom je, že v prípade, keď zápisy a čítania sú nekvorumové, dochádza k porušeniu kauzálnej konzistencie. Presne to, čo hovoríte!
Naša rada: používať aspoň kvorumové čítanie pri použití kauzálnej konzistencie. V takom prípade sa nič nestratí, aj keď kvorumový zápis zmizne... Ide o ortogonálnu situáciu: ak používateľ nechce, aby sa strácali dáta, mal by používať kvorumový zápis. Kauzálna konzistencia nezaručuje trvácnosť. Záruku trvácnosti poskytuje replikácia a mechanizmy s ňou spojené.
A: – Keď vytvárame inštanciu, ktorá vykonáva shardovanie (nie master, ale slave), opiera sa o unixový čas vlastného stroja alebo o čas "mastera"; synchronizuje sa po prvý raz alebo pravidelne?
MT: – Teraz to objasním. Shard (t.j. horizontálna partition) má vždy primárny uzol. A v sharde môže byť "master" a môžu byť repliky. Ale shard vždy podporuje zápis, pretože musí podporovať určitú doménu (v sharde je primárny uzol).
A: – Takže všetko závisí výhradne od "mastera"? Vždy sa používa "masterovo" časovanie?
MT: – Áno. Môžeme to obrazne povedať: hodiny tikajú, keď dochádza k zápisu do "mastera", do "OpLogu".
A: – Máme klienta, ktorý sa pripája, a nemá potrebovať nič vedieť o čase?
MT: – Vôbec nič nemusí vedieť! Ak hovoríme o tom, ako to funguje na klientovi: keď chce klient využívať kauzálnu konzistenciu, musí otvoriť reláciu. Teraz tam je všetko: aj transakcie v relácii, aj obdržanie práv... Relácia je usporiadanie logických udalostí, ktoré sa dejú s klientom.
Ak otvorí túto reláciu a povie, že chce kauzálnu konzistenciu (ak relácia predvolene podporuje kauzálnu konzistenciu), všetko automaticky funguje. Ovládač si pamätá tento čas a zvyšuje ho, keď prijme novú správu. Pamätá si, akú odpoveď vrátilo predchádzajúce volanie zo servera, ktorý vrátil údaje. Nasledujúci požiadavok bude obsahovať afterCluster ("čas väčší ako tento").
Zákazník nemusí vedieť vôbec nič! Je to pre neho úplne nepriehľadné. Ak ľudia používajú tieto funkcie, čo to umožňuje? Po prvé, môžu bezpečne čítať sekundárne databázy: môžu zapisovať na primár, zatiaľ čo čítajú z geograficky replikovaných sekundárnych databáz a môžu si byť istí, že to funguje. Pritom relácie, ktoré boli zaznamenané na primárnych databázach, je možné prenášať aj na sekundárne, teda je možné používať nie jednu reláciu, ale niekoľko.
A: – S témou Eventual consistency úzko súvisí nová oblasť počítačovej vedy – typy dát CRDT (Conflict-free Replicated Data Types). Zvažovali ste integráciu týchto typov dát do databázy a čo o tom môžete povedať?
MT: – Dobrý otázka! CRDT má zmysel pri konfliktoch pri zápise: v MongoDB je to single master.
A: – Mám otázku od DevOps. V reálnom svete sa vyskytujú také jezuitské situácie, keď nastáva byzantský Failure a zlí ľudia vnútri chráneného perimetra začínajú zasahovať do protokolu, špeciálne pripravovať pakety?
MT: – Zlí ľudia vnútri perimetra sú ako trojský kôň! Zlí ľudia vnútri perimetra môžu spôsobiť veľa zlých vecí.
A: – Je jasné, že nechať v serveri, akoby bola dierka, cez ktorú by sa dal pretiahnuť zoologický park slonov a zrútiť celý klaster navždy... Obnovovanie ručne potrvá nejaký čas... To je, mierne povedané, nesprávne. Na druhej strane, zaujímavé je to: v reálnom živote, v praxi sa vyskytujú také situácie, keď sa skutočne také interne útoky odohrávajú?
MT: – Pretože sa s bezpečnostnými priestupkami v reálnom živote často nestretávam, nemôžem povedať – možno sa aj vyskytujú. Ale ak hovoríme o vývojovej filozofii, považujeme to takto: máme perimetr, ktorý zabezpečuje chlapcov, ktorí robia bezpečnosť – to je zámok, múr; a vnútri perimetra sa dá robiť čokoľvek. Je jasné, že sú používatelia, ktorí môžu len sledovať, a sú používatelia, ktorí môžu zmazať adresár.
V závislosti od práv má používateľ možno spôsobovať škody myšou, alebo možno aj slonom. Je jasné, že používateľ s plnými právami môže robiť čokoľvek. Používateľ s obmedzenými právami môže spôsobiť podstatne menej škôd. Konkrétne nemôže rozbiť systém.
A: – V zabezpečenom perimetri niekto začal formovať nečakané protokoly pre server, aby ho dostal do krízovej situácie a ak sa podarí, tak aj celý klaster... Môže to byť až 'príliš dobré'?
MT: – Nikdy som o takýchto veciach nepočul. Nie je tajomstvom, že to, čo spôsobuje pád servera, je možné. Spôsobiť pád zvnútra, keď je niekto prihlásený a môže niečo zapísať do správy... V skutočnosti to nie je možné, pretože sa to aj tak overí. Je tu možnosť deaktivovať toto overovanie pre používateľov, ktorí to nechcú – to už sú ich problémy; hrubo povedané, sami rozbili múry a môžu tam naraziť slona, ktorý všetko rozdrví... A vlastne, možno sa obliecť ako opravár, prísť a vytiahnuť to!
A: – Ďakujem za prezentáciu. Sergej ("Yandex"). V "Mongi" je konštanta, ktorá obmedzuje počet hlasujúcich členov v Replica Set'e a táto konštanta je rovná 7 (sedem). Prečo je to konštanta? Prečo to nie je nejaký parameter?
MT: – Replica Set môže mať aj 40 uzlov. Tam je vždy väčšina. Neviem, aká verzia...
A: – V Replica Set'e je možné spúšťať aj nehlasujúcich členov, ale hlasujúcich – maximálne 7. Ako sa v tomto prípade vyrovnať s vypnutím, ak máme Replica Set rozdelený na 3 dátové centrá? Jedno dátové centrum sa môže jednoducho vypnúť a ďalší stroj sa môže odpojiť.
MT: – To už je trochu mimo prezentácie. Je to všeobecná otázka. Možno ju môžem neskôr vysvetliť.
Trochu reklamy 🙂
Ďakujeme, že ostávate s nami. Páčia sa vám naše články? Chcete vidieť viac zaujímavých materiálov? Podporte nás, vytvorením objednávky alebo odporúčaním známym, , unikátny ekvivalent entry-level serverov, ktorý sme pre vás vytvorili: (k dispozícii varianty s RAID1 a RAID10, až 24 jadier a až 40GB DDR4).
Dell R730xd je dvakrát lacnejší v dátovom centre Equinix Tier IV v Amsterdame? Len u nás v Holandsku! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 dolárov! Prečítajte si o tom
Zdroj: habr.com
