

Proces aktualizácie pre váš Kubernetes klaster
Pri používaní klastera Kubernetes sa v určitom momente objaví potreba aktualizovať fungujúce nody. Môže to zahŕňať aktualizácie balíkov, aktualizáciu jadra alebo nasadenie nových obrazov virtuálnych strojov. V terminológii Kubernetes sa tomu hovorí .
Tento príspevok je súčasťou cyklu zo 4 príspevkov:
- Tento príspevok.
- Správne ukončenie podov v Kubernetes klastri
- Odložené ukončenie podu pri jeho odstránení
- Ako sa vyhnúť prestojom v prevádzke Kubernetes klastra pomocou PodDisruptionBudgets
(pozn. prekl. očakávajte preklady ostatných článkov cyklu v blízkej budúcnosti)
V tomto článku budeme popisovať všetky nástroje, ktoré poskytuje Kubernetes na dosiahnutie nulového času prestoja pre fungujúce nody vo vašom klastri.
Definícia problému
Najprv použijeme naivný prístup, určíme problémy a vyhodnotíme potenciálne riziká tohto prístupu a budeme zhromažďovať poznatky na riešenie každej z problémov, s ktorými sa stretneme počas celého cyklu. Nakoniec získame konfiguráciu, ktorá využíva lifecycle hooks, readiness probes a Pod disruption budgets na dosiahnutie nášho nulového času prestoja.
Aby sme začali našu cestu, vezmime konkrétny príklad. Predpokladajme, že máme Kubernetes klaster z dvoch nodov, v ktorom je spustená aplikácia so značkami podov nachádzajúcimi sa za Service:
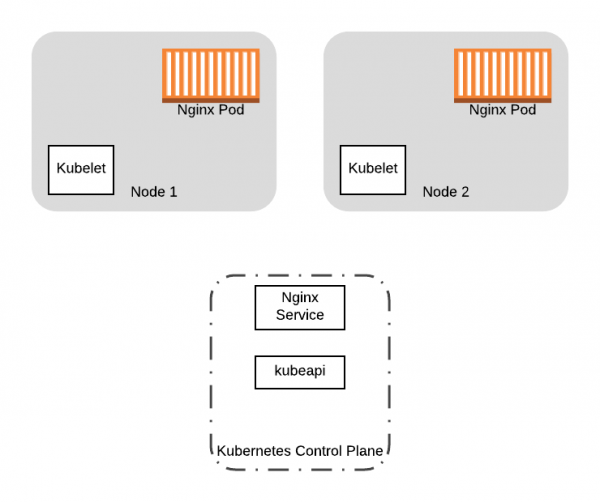
Začneme s dvoma podmi s Nginx a službou spustenými na našich dvoch nodoch Kubernetes klastra.
Chceme aktualizovať verziu jadra dvoch pracovných nodov v našom klastri. Ako to urobíme? Jednoduchým riešením by bolo spustiť nové nody s aktualizovanou konfiguráciou a potom vypnúť staré nody, súčasne spúšťajúc nové. Hoci to funguje, s takým prístupom sa objaví niekoľko problémov:
- Keď vypnete staré nody, spustené na nich podsy tiež vypnú. Čo ak je potrebné pody vyčistiť pre správne odpojenie? Systém virtualizácie, ktorý používate, nemusí čakať na ukončenie procesu čistenia.
- Čo ak vypnete všetky nody naraz? Získate značný prestoj, kým sa pody presunú na nové nody.
Potrebujeme spôsob, ako správne migrovať pod'y zo starých uzlov a zároveň sa musíme uistiť, že žiadny z našich pracovných procesov nie je spustený, kým robíme zmeny pre uzol. Alebo keď robíme úplnú výmenu klastra, ako v príklade (t.j. nahrádzame obrazy VM), chceme presunúť fungujúce aplikácie zo starých uzlov na nové. V oboch prípadoch chceme zabrániť plánovaniu nových pod'ov na starých uzloch a potom ich všetky vysťahovať. Na dosiahnutie týchto cieľov môžeme použiť príkaz kubectl drain.
Presunutie všetkých pod'ov z uzla
Operácia drain umožňuje presunúť všetky pod'y z uzla. Počas vykonávania drain je uzol označený ako unschedulable (značka NoSchedule). To zabraňuje vzniku nových pod'ov na ňom. Potom drain začína vysťahovať pod'y z uzla, ukončuje kontajnerové procesy, ktoré sú aktuálne spustené na uzle, posielajúc signál TERM kontajnerom v pod'e.
Aj keď kubectl drain oproti vysťahovaniu pod'ov, sú aj ďalšie dva faktory, ktoré môžu spôsobiť zlyhanie pri vykonávaní operácie drain:
- Vaša aplikácia by mala byť schopná správne sa ukončiť pri prijatí
TERMsignálu. Keď sú pod'y vysťahované, Kubernetes posiela signálTERMkontajnerom a čaká na ich zastavenie zadaný čas, po ktorom, ak sa nezastavili, ich nútene ukončí. V každom prípade, ak váš kontajner nereaguje na signál správne, môžete stále zničiť pod'y nesprávne, ak sú v danom konkrétnom okamihu aktívne (napr. prebieha transakcia v DB). - Strácate všetky pod'y, v ktorých sa nachádza vaša aplikácia. Môže byť nedostupná v čase spustenia nových kontajnerov na nových uzloch alebo, ak sú vaše pod'y nasadené bez kontrolérov, nemusia sa vôbec reštartovať.
Vyhýbanie sa prestojom
Aby sme minimalizovali čas prestojov v dôsledku dobrovoľnej poruchy, ako je operácia drain pre uzol, Kubernetes ponúka nasledujúce možnosti spracovania chýb:
V ostatných častiach cyklu použijeme tieto funkcie Kubernetes na zmiernenie následkov presunu pod'ov. Aby sme to uľahčili, použijeme náš vyššie uvedený príklad s nasledujúcou konfiguráciou zdrojov:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Táto konfigurácia je minimálnym príkladom Nasadenie, ktorý spravuje pod’y nginx v klastri. Okrem toho konfigurácia opisuje zdroj Service, ktorý sa dá použiť na prístup k pod’om nginx v klastri.
Počas celého cyklu budeme iteratívne rozširovať túto konfiguráciu, aby na konci zahŕňala všetky funkcie, ktoré Kubernetes poskytuje na zníženie času výpadku.
Aby ste získali plne implementovanú a testovanú verziu aktualizácií klastra Kubernetes pre nulový čas výpadku na AWS a iných zdrojoch, navštívte .
Čítajte tiež ďalšie články na našom blogu:
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish