

Preklad článku bol pripravený špeciálne pre študentov kurzu .
V uplynulých niekoľkých týždňoch sme s pridali do binarne streamovací formát, doplnili sme už existujúci formát súborov pre náhodný prístup/IP. Máme implementácie v Jave a C++ a vazby pre Python. V tomto článku vám ukážem, ako funguje formát a ukážem, ako dosiahnuť veľmi vysokú priepustnosť údajov pre pandas DataFrame.
Streaming stĺpcových dát
Častá otázka, ktorú dostávam od používateľov Arrow, sa týka vysokých nákladov na prenos veľkých súborov tabulkových dát z formátu orientovaného na riadky alebo záznamy do stĺpcového formátu. Pre viacgigabajty veľké datasety môže byť transponovanie v pamäti alebo na disku nezdolateľnou úlohou.
Pre streamovanie dát, bez ohľadu na to, či sú pôvodné dáta riadkové alebo stĺpcové, jednou z možností zostáva odosielanie malých paketov riadkov, z ktorých každý obsahuje usporiadanie podľa stĺpcov.
V Apache Arrow sa zbierka stĺpcových polí v pamäti, ktorá predstavuje chunk tabuľky, nazýva balík záznamov (record batch). Aby sme predstavili jednotnú štruktúru dát logickej tabuľky, môžeme zostaviť niekoľko balíkov záznamov.
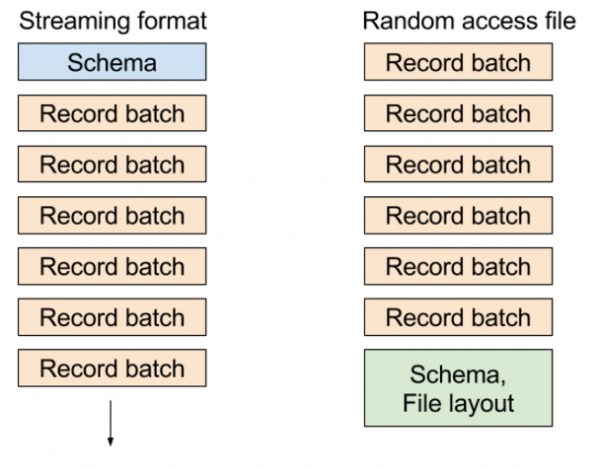
V existujúcom formáte súborov pre náhodný prístup zapisujeme metadata, ktoré obsahujú schému tabuľky a umiestnenie blokov na konci súboru, čo vám umožňuje veľmi lacno vybrať akýkoľvek balík záznamov alebo akýkoľvek stĺpec zo súboru dát. V streamovacom formáte odosielame sériu správ: schému a potom jeden alebo viac balíkov záznamov.
Rôzne formáty vyzerajú približne tak, ako je znázornené na tomto obrázku:
Streaming dát v PyArrow: aplikácia
Aby som vám ukázal, ako to funguje, vytvorím príklad datasetu, ktorý predstavuje jeden streamovací chunk:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Teraz predpokladajme, že chceme zapísať 1 GB dát, pozostávajúcich z chunkov veľkých 1 MB, celkom 1024 chunkov. Pre začiatok vytvorme prvý dataframe veľkosti 1 MB so 16 stĺpcami:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Potom ich konvertujem na pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Teraz vytvorím výstupný stream, ktorý bude zapisovať do pamäte a vytvorím StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Potom zapíšeme 1024 kusov, ktoré nakoniec tvoria 1GB dátovej sady:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Keďže sme zapisovali do RAM, celý stream môžeme získať v jednom buffere:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Keďže sú tieto dáta v pamäti, čítanie Arrow záznamových balíčkov je operácia zero-copy. Otváram StreamReader, čítam dáta do pyarrow.Table, a potom ich konvertujem do DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Všetko to je pekné, ale môžete mať otázky. Ako rýchlo to prebieha? Ako veľkosť kusu ovplyvňuje výkon získania DataFrame pandas?
Výkon streamovania dát
Pri zmenšení veľkosti kusu streamovania sa náklady na rekonštrukciu kontinuálneho stĺpcového rámca DataFrame v pandas zvyšujú kvôli neefektívnym schémam prístupu do cache. Existujú aj určité náklady spojené s prácou so štruktúrami dát C++ a ich pamäťovými buffermi.
Pre 1 MB, ako je uvedené vyššie, na mojom notebooku (Quad-core Xeon E3-1505M) dostávame:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Takže efektívna priepustnosť je 7.75 GB/s pre obnovu DataFrame s veľkosťou 1GB z 1024 kusov po 1MB. Čo sa stane, ak použijeme väčšie alebo menšie kusy? Tu sú výsledky:
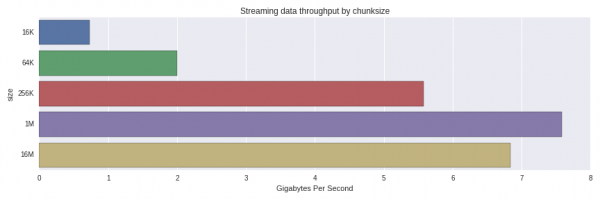
Výkon sa výrazne znižuje z 256K na 64K kusov. Prekvapilo ma, že kusy s veľkosťou 1 MB sa spracovávali rýchlejšie ako 16 MB. Je potrebné dôkladnejšie preskúmať a zistiť, či je to normálne rozdelenie alebo je tu ešte niečo iné.
V aktuálnej implementácii formátu sa dáta prakticky nekontrolujú, takže veľkosť v pamäti a "v drôtoch" je približne rovnaká. V budúcnosti by mohla byť kompresia ďalšou možnosťou.
Záver
Prenos stĺpcových údajov sa môže ukázať ako efektívny spôsob prenosu veľkých súborov dát do stĺpcových analytických nástrojov, ako sú napríklad pandas, pomocou malých blokov. Dátové služby, ktoré používajú ukladanie zamerané na riadky, môžu prenášať a transponovať malé bloky dát, ktoré sú vhodnejšie pre L2 a L3 cache vášho procesora.
Úplný kód
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size // ncols // np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) // NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Zdroj: habr.com
