

Keď je tvojou prácou vytvárať niečo pekné, nemusíš o nej až tak veľa rozprávať, pretože výsledok je každému pred očami. No ak zakrývaš nápisy na plotoch, nikto si tvoju prácu nevšimne, kým sú ploty v dobrom stave alebo kým nezmažeš niečo nevhodné.
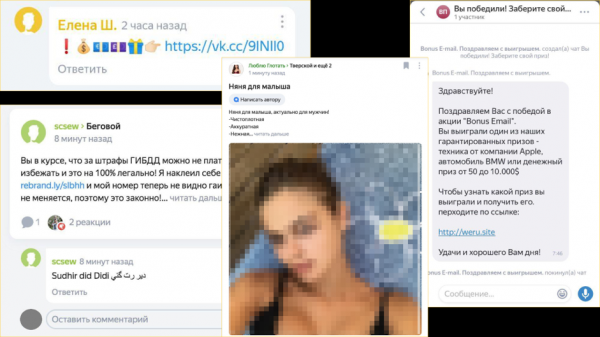
Každá služba, kde sa dá zanechať komentár, recenzia, poslať správa alebo nahrať obrázky, skôr či neskôr čelí problému spamu, podvodov a nevhodného obsahu. Tomu sa nedá vyhnúť, ale je potrebné s tým bojovať.
Volám sa Michail, pracujem v tíme Antispamu, ktorý chráni používateľov služieb Yandexu pred podobnými problémami. Naša práca zriedkakedy upúta pozornosť (a to je dobré!), takže dnes vám o nej poviem viac. Zistíte, v ktorých prípadoch je moderácia zbytočná a prečo presnosť nie je jediným ukazovateľom jej efektivity. A ešte sa porozprávame o nevhodných výrazoch na príklade mačiek a psov a o tom, prečo niekedy pomáha „premýšľať ako hrubozrnný človek“.
V Yandexe sa objavuje čoraz viac služieb, kde používatelia publikujú svoj obsah. Môžete položiť otázku alebo napísať odpoveď v Yandex.Q, prediskutovať novinky vo vašej štvrti v Yandex.Raione, zdieľať dopravné informácie v rozhovoroch na Yandex.Mapách. Ale keď sa publikum služby rozrastá, stáva sa atraktívnym pre podvodníkov a spammerov. Tí prichádzajú a zapĺňajú komentáre: ponúkajú ľahké zárobky, inzerujú zázračné prostriedky a sľubujú sociálne dávky. V dôsledku spammerov niektorí používatelia prichádzajú o peniaze, iní zas o chuť tráviť čas na neudržiavanej, spamom zarastenej službe.
A to nie je jediný problém. Snažíme sa nielen ochrániť používateľov pred podvodníkmi, ale aj vytvoriť príjemnú atmosféru pre komunikáciu. Ak sa ľudia v komentároch stretávajú s nevhodnými výrazmi a urážkami, s veľkou pravdepodobnosťou odídu a už sa nevrátia. Preto je potrebné aj s týmto vedieť bojovať.
Čistý Web
Ako to u nás často býva, prvé návrhy vznikli v Hľadaní, v tej časti, ktorá bojuje so spamom vo výsledkoch. Ešte pred desiatimi rokmi sa objavila úloha filtrovania dospelého obsahu pre rodinné vyhľadávanie a pre vyhľadávania, ktoré nepredpokladajú odpovede z kategórie 18+. Tak sa objavili prvé, ručne zostavené slovníky pornografie a vulgarizmov, ktoré zapĺňali analytici. Hlavnou úlohou bola klasifikácia vyhľadávaní na tie, kde je dovolené zobrazovať dospelý obsah a kde nie. Pre túto úlohu sa zhromažďovala anotácia, budovali sa heuristiky, trénovali modely. Tak vznikli prvé návrhy na filtrovanie neželaného obsahu.
Postupom času sa v Yandexe začal objavovať UGC (užívateľom generovaný obsah) — správy, ktoré píšu samotní používatelia, a Yandex ich len publikuje. Z vyššie popísaných dôvodov mnohé správy nebolo možné publikovať bez kontroly — vyžadovala sa moderácia. Potom sa rozhodlo vytvoriť službu, ktorá by poskytovala ochranu pred spamom a zločincami pre všetky UGC produkty Yandexu a využila návrhy na filtrovanie neželaného obsahu v Hľadaní. Službu nazvali „Čistý Web“.
Nové úlohy a pomoc pracovníkov
Na začiatku u nás fungovala len jednoduchá automatizácia: služby nám posielali texty, a my sme na nich prevádzali slovníky vulgarizmov, slovníky pornografie a regulárne výrazy — analytici všetko zostavovali manuálne. Ale služba sa postupom času aplikovala vo stále väčšom počte produktov Yandexu, a museli sme sa naučiť pracovať s novými problémami.
Často namiesto recenzie používatelia publikujú bezvýznamnú zbierku písmen, snažiac sa získať si svoje úspechy, občas propagujú svoju spoločnosť v recenziách o spoločnosti konkurenta, a niekedy jednoducho pomýlia organizácie a v recenzii o zverimexu napíšu: „Výborne pripravená ryba!“. Možno, že raz umelá inteligencia naučí ideálne zachytiť význam akéhokoľvek textu, ale teraz automatizácia niekedy zvládne horšie ako človek.
Bol jasno, že bez ručného označovania sa tu nezaobídeme, a pripojili sme k nášmu systému druhú fázu — odoslanie na ručné overenie človekom. Sem patrili tie publikované texty, pri ktorých klasifikátor nezistil žiadne problémy. Rozsah tejto úlohy si môžete ľahko predstaviť, preto sme sa nielen spoliehali na hodnotiteľov, ale aj využili «múdrosť davu», teda sme požiadali o pomoc tolokerov. Tí nám pomáhajú odhaľovať to, čo stroj prehliadol, a tým ju takto učia.
Inteligentné cachovanie a LSH hashovanie
Ďalší problém, s ktorým sme sa stretli pri práci s komentármi, je spam, presnejšie jeho objemy a rýchlosť šírenia. Keď sa publikum Yandex.Rajóna rýchlo rozrástlo, prišli tam spammeri. Naučili sa obchádzať regulárne výrazy, mierne zmenou textu. Spam, samozrejme, stále nachádzali a odstraňovali, ale v rozsahu Yandexu mohlo byť neprijateľné oznámenie zverejnené aj na 5 minút a videlo ho stovky ľudí.
Nás to, samozrejme, neuspokojovalo, a vytvorili sme inteligentné cachovanie textov založené na LSH (). Funguje to takto: normalizovali sme text, odstránili z neho odkazy a rozrezali ho na n-gramy (sekvencie z n písmen). Potom sme počítali hashe z n-gramov a na ich základe sme vytvorili LSH vektor dokumentu. Zmysel je v tom, že podobné texty, aj keď boli trochu zmenené, sa transformovali na podobné vektory.
Toto riešenie nám umožnilo znovu využiť verdikty klasifikátorov a hodnotiteľov pre podobné texty. Pri spamovej útoku, akonáhle prvá správa prešla kontrolou a dostala sa do cache s verdiktom «spam», všetky nové podobné správy, aj keď zmenené, dostali ten istý verdikt a boli automaticky odstránené. Neskôr sme sa naučili trénovať a automaticky pretrénovať klasifikátory spamu, ale tento «inteligentný cache» nám ostal a dodnes nám často pomáha.
Klasifikátor dobrých textov
Nedokázali sme si oddýchnuť od boja so spamom, keď sme si uvedomili, že 95 % obsahu u nás sa moderuje ručne: klasifikátory reagujú len na porušenia a väčšina textov sú dobré. Zatiaľ čo zaťažujeme pracovníkov, ktorí v 95 prípadoch zo 100 dajú hodnotenie "Všetko OK". Museli sme sa pustiť do nezvyčajnej práce — vytvárať klasifikátory pre dobrý obsah, našťastie sa medzitým nazbieralo dosť označkovaných údajov.
Prvý klasifikátor vyzeral takto: lematizujeme text (privedieme slová k základnej forme), vyhadzujeme všetky pomocné časti reči a aplikujeme vopred pripravený „slovník dobrých lem”. Ak sú v texte všetky slová „dobré”, znamená to, že ani text ako celok neobsahuje porušenia. Na rôznych službách takýto prístup hneď poskytol od 25 do 35 % automatizácie ručného označovania. Samozrejme, tento prístup nie je dokonalý: nie je ťažké skombinovať niekoľko nevinných slov a získať veľmi urážlivé vyjadrenie, ale umožnil nám rýchlo dosiahnuť dobrú úroveň automatizácie a dal čas na vyškolenie zložitejších modelov.
Nasledujúce verzie klasifikátorov dobrých textov už zahŕňali aj lineárne modely, rozhodovacie stromy a ich kombinácie. Pri označovaní vulgarizmov a urážok skúšame napríklad neurónovú sieť BERT. Tu je dôležité zachytiť význam slova v kontexte a vzťah medzi slovami z rôznych viet a BERT s tým celkom dobre zvláda. (Mimochodom, nedávno kolegovia z Novinami , ako využívajú technológiu na netradičnú úlohu — hľadanie chýb v nadpisoch.) Nakoniec sa nám podarilo automatizovať až 90 % toku v závislosti od služby.
Presnosť, úplnosť a rýchlosť
Aby sme sa mohli rozvíjať, musíme rozumieť, akú hodnotu prinášajú tie či oné automatické klasifikátory, zmeny v nich, ako aj to, či sa neznižuje kvalita ručných kontrol. Na tento účel používame ukazovatele presnosti a úplnosti.
Presnosť je podiel správnych verdiktov medzi všetkými verdiktmi o zlom obsahu. Čím je presnosť vyššia, tým je menej falošných poplachov. Ak sa nezameriame na presnosť, teoreticky môžeme odstrániť celý spam a vulgárnosti, a spolu s nimi aj polovicu dobrých príspevkov. Na druhej strane, ak sa budeme spoliehať len na presnosť, najlepšou technológiou bude tá, ktorá nikoho nezachytáva. Preto existuje aj ukazovateľ úplnosti: podiel identifikovaného zlého obsahu medzi celkovým objemom zlého obsahu. Tieto dve metriky sa navzájom vyvažujú.
Na meranie vzorkujeme celý prichádzajúci tok z každého služby a odosielame vzorky obsahu hodnotiteľom na odborné posúdenie a porovnanie s riešeniami stroja.
Ale existuje ešte jeden dôležitý ukazovateľ.
Povedal som, že neprijateľnú správu môže za 5 minút vidieť aj sto ľudí. Preto počítame, koľkokrát sme stihli zobraziť zlý obsah ľuďom predtým, ako sme ho skryli. Je to dôležité, pretože nestačí pracovať kvalitne — treba pracovať aj rýchlo. A keď sme vybudovali ochranu pred vulgarizmami, naplno sme to pocítili.
Proti vulgarizmom na príklade mačičiek a psíkov
Malé literárne odbočenie. Niekto môže povedať, že vulgarizmy a urážky nie sú také nebezpečné ako škodlivé odkazy, a nie sú také otravné ako spam. Ale usilujeme sa udržiavať komfortné podmienky pre komunikáciu miliónov používateľov, a ľudia sa radi nevracajú tam, kde sú urážaní. Nie nadarmo je zákaz vulgarizmov a urážok uvedený v pravidlách mnohých komunít, vrátane Habr. Ale odbočili sme.
Slovníky vulgarizmov si nevedú rady so všetkým bohatstvom ruštiny. Napriek tomu, že existujú len štyri hlavné zakázané korene, z nich je možné vytvoriť nespočetné množstvo slov, ktoré nijakými regulárnymi výrazmi nezachytíte. Navyše, môžete písať časť slova translitom, nahrádzať písmená podobnými kombináciami, presúvať písmená, pridávať hviezdičky atď. Niekedy bez kontextu nie je možné určiť, čo mal používateľ na mysli vulgárnym slovom. Respektujeme pravidlá Habr, a preto to neukážeme na živých príkladoch, ale na mačičkách a psíkoch.
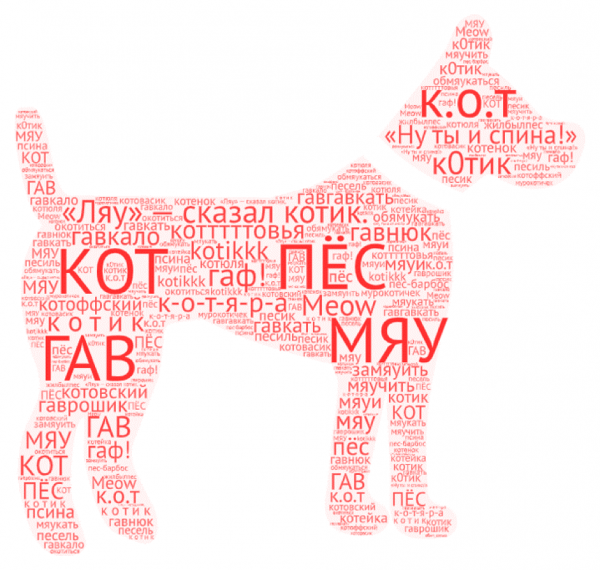
„Mňau,“ povedal kocúrik. Ale chápeme, že kocúrik povedal iné slovo…
Začali sme premýšľať o algoritmoch „nepresného zladenia“ našich slovníkov a o inteligentnejšom predspracovaní: prevádzali sme transliteráciu, spájali medzery a interpunkciu, hľadali vzory a písali na ne samostatné regulárne výrazy. Tento prístup prinášal výsledky, no často znižoval presnosť, nedávajúc požadovanú úplnosť.
Vtedy sme sa rozhodli „myslieť ako vulgaristi“. Začali sme sami pridávať šum do dát: presúvali sme písmená, generovali preklepy, zamieňali sme písmená podobné svojím písaním a podobne. Počiatočné označovanie pre toto sme brali aplikovaním slovníkov vulgarizmov na veľké korpusy textov. Ak vezmeme jednu vetu a skomolíme ju niekoľkými spôsobmi, vznikne už množstvo viet. Týmto spôsobom môžeme zvýšiť tréningovú vzorku desiatkykrát. Ostávalo len naučiť na získanom súbore nejaký rozumný model, ktorý zohľadňuje kontext.
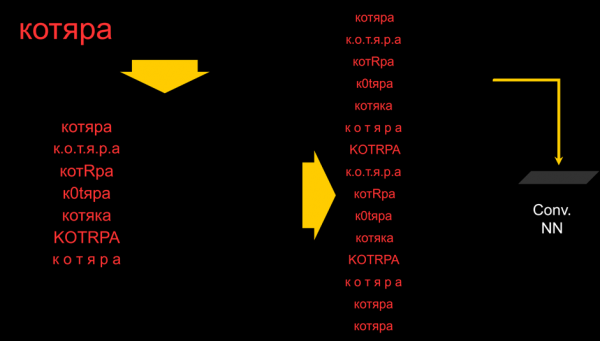
O konečnom riešení je zatiaľ predčasné hovoriť. Stále experimentujeme s prístupmi k tomuto problému, ale už vidíme, že jednoduchá symbolická konvolučná sieť z niekoľkých vrstiev viditeľne prevyšuje slovníky a regulárne výrazy: dokážeme zvýšiť aj presnosť, aj úplnosť.
Samozrejme, chápeme, že vždy sa nájdu spôsoby, ako obísť aj tú najpokročilejšiu automatizáciu, obzvlášť keď ide o takú zábavnú činnosť: napísať tak, aby blbú mašinu nepochopila. Tu, ako pri boji proti spamu, nemáme za cieľ vymýtiť samotnú možnosť napísať niečo neslušné, našou úlohou je zabezpečiť, aby hra nestála za námahu.
Otvorenie príležitosti na zdieľanie svojho názoru, komunikáciu a komentovanie — nie je ťažké. Podstatne ťažšie je dosiahnuť bezpečné, komfortné podmienky a rešpektujúci prístup k ľuďom. A bez toho nebude vývoj žiadneho spoločenstva.
Zdroj: habr.com
