

Zdravím, a na úvod trochu lyriky. Niekedy závidím kolegom, ktorí pracujú na diaľku — veď je to úžasné mať možnosť pracovať z ktoréhokoľvek miesta na svete pripojeného k Internetu, mať voľno kedykoľvek, zodpovednosť za projekty a termíny, nie byť v kancelárii od 8 do 17. Môj post a pracovné povinnosti prakticky vylučujú možnosť dlhého neprítomnosti v dátovom centre. Avšak — občas sa vyskytnú zaujímavé prípady, ako ten nižšie — a chápem, že existuje len málo pozícií, kde je taký priestor na kreatívne vyjadrenie vnútorného troubleshooter’a.
Malý disklejmer — v čase písania článku nebol prípad úplne vyriešený, ale vzhľadom na rýchlosť odpovedí dodávateľov môže úplné riešenie trvať ešte mesiace, a chcem sa podeliť o svoje nálezy už teraz. Dúfam, vážení čitatelia, že mi odpustíte túto ukvapenosť. Ale dosť o vode — čo sa deje s prípadom?
Na začiatku Kontext: existuje firma (kde pracujem ako sieťový inžinier), ktorá hosťuje klientské riešenia v privátnom cloude VMWare. Väčšina nových riešení sa pripája k VXLAN-segmentom, ktoré sú spravované NSX-V — nebudem hodnotiť, koľko času mi toto riešenie ušetrilo, stručne povedané — veľa. Dokázal som dokonca zaškoliť kolegov v nastavení NSX ESG a malé klientské riešenia sa nasadzujú bez mojej účasti. Dôležitá poznámka — riadiaca rovina má unicast replikáciu. Hypervízory sú pripojené redundantne dvoma rozhraním k rôznym fyzickým prepínačom Juniper QFX5100 (zostaveným v Virtual Chassis) a politikou časovania route based on originating virtual port — to pre úplnosť obrazu.
Klientské riešenia sú veľmi rôznorodé: od Windows IIS, kde sú všetky komponenty webového servera nainštalované na jednom zariadení, až po skutočne veľké — napríklad load-balanced Apache webové fronty + LB MariaDB v Galera + zdieľané servery synchronizované pomocou GlusterFS. Prakticky každý server je potrebné monitorovať osobitne, a verejné adresy nemá všetky komponenty — ak ste sa s touto úlohou už stretli a máte elegantnejšie riešenie, budem rád za radu.
Moje riešenie monitorovania spočíva v "pripojení" firewallu (Fortigate) k každej vnútornej klientskej sieti (+SNAT a samozrejme prísne obmedzenia týkajúce sa povoleného prenosu) a sledovaní interných adries - takto sa dosahuje určitá unifikácia a zjednodušenie monitorovania. Samotné monitorovanie prebieha z klasteru serverov PRTG. Schéma monitorovania vyzerá približne takto:
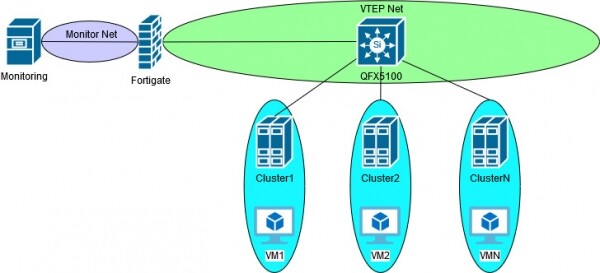
Kým sme pracovali iba s VLAN, všetko bolo celkom bežné a predvídateľné, fungovalo to ako hodinky. Po zavedení NSX-V a VXLAN sme sa stretli s otázkou - môže sa pokračovať v monitorovaní starým spôsobom? V čase tejto otázky bolo najrýchlejším riešením nasadiť NSX ESG a pripojiť VXLAN trunk-interface do siete VTEP. Rýchle v úvodzovkách - pretože použitie GUI na nastavenie klientskych sietí, SNAT a pravidiel firewallu síce môže unifikovať správu v jediného rozhraní vSphere, ale podľa môjho názoru je to dosť neprehľadné a okrem iného obmedzuje sadu nástrojov na riešenie problémov. Tí, ktorí používali NSX ESG ako náhradu za "skutočný" firewall, si myslím, súhlasí. Hoci, pravdepodobne, takéto riešenie by bolo stabilnejšie - veď všetko prebieha v rámci jedného dodávateľa.
Ďalším riešením je použiť NSX DLR v režime mosta medzi VLAN a VXLAN. Tu myslím, že je všetko jasné — jednoducho sa stratí výhoda z použití VXLAN — veď v tomto prípade aj tak treba ťahať VLAN k monitorovacej inštalácii. Mimochodom, pri práci na tomto riešení som sa stretol s problémom, keď DLR most neodosielal pakety virtuálke, s ktorou sa nachádzal na jedinom hoste. Viem, viem — v knihách a príručkách o NSX-V priamo povedané, že pre NSX Edge by mal byť vyhradený samostatný klaster, ale to je v knihách… Tak či onak, po pár mesiacoch s podporou sme problém nevyriešili. V zásade som pochopil logiku fungovania — modul jadra hypervízora zodpovedný za enkapsuláciu VXLAN nebol využívaný, ak DLR a monitorovaný server boli na jednom hoste, pretože prevádzka neopustila host a podľa logiky by mala byť pripojená k VXLAN segmentu — enkapsulácia nie je potrebná. S podporou sme sa zastavili na virtuálnom rozhraní vdrPort, ktoré logicky spája uplinky a ono samo uskutočňuje mostovanie/enkapsuláciu — tam bolo pozorované nesúlad vo vchádzajúcej prevádzke, ktorý som zobrala na spracovanie v aktuálnom prípade. Ale ako bolo povedané, do konca som tento prípad nedovedol, pretože som bol presmerovaný na iný projekt a takisto táto vetva bola pôvodne bezvýchodná a nemal som veľmi chuť ju rozvíjať. Ak sa nemýlim, problém bol pozorovaný vo verziách NSX 6.1.4 a 6.2.
A tu — bingo! Fortinet oznamuje natívnu . A nie len point-to-point alebo VXLAN-over-IPSec, nie softvérové mostovanie VLAN-VXLAN — toto všetko začali zavádzať už od verzie 5.4 (a je to predložené u iných ), a reálnu podporu unicast control plane. Pri implementácii riešenia som narazil na ďalší problém - monitorované servery sa periodicky buď „strácali“, alebo sa znova objavovali, aj keď samotná virtuálka bola nažive. Príčinou bolo, ako sa ukázalo, to, že som zabudol povoliť Ping na VXLAN rozhraní. Počas prebalansovania klastrov sa virtuálky presúvali a Ping ukončoval vMotion, aby označil nový ESXI hostiteľ, na ktorý sa stroj presunul. Moja hlúposť, ale tento problém opäť podkopal dôveru v podporu výrobcu - v tomto prípade Fortinet. Už ani nehovorím o tom, že každý prípad týkajúci sa VXLAN začína otázkou „kde máte vo svojich nastaveniach softswitch VLAN-VXLAN?“ Tentokrát mi odporučili zmeniť MTU - to je pre Ping, ktorý má 32 bajtov. Potom „si pohraj“ s tcp-send-mss a tcp-receive-mss v politike - pre VXLAN, ktorý je kapsulovaný v UDP. Uf, prepáčte - nahromadilo sa to. V každom prípade som tento problém vyriešil sám.
Úspešne odskúšaním testovacieho prenosu sa rozhodlo implementovať toto riešenie. A v produkcii sa ukázalo, že po jednom alebo dvoch dňoch postupne odpadáva všetko, čo je monitorované cez VXLAN. Deaktivácia/aktivácia rozhrania pomohla, ale iba na krátky čas. Pamätajúc na pomalosť podpory výrobcu, som sa pustil do troubleshooting z mojej strany - veď napokon moja spoločnosť, moja sieť - moja zodpovednosť.
Pod spoilerom sa nachádza priebeh troubleshooting. Kto sa unavil od písmen a chvastania - preskočte a prejdite k postanalýze.
Priebeh troubleshootingĎakujem, že ste pokračovali v čítaní - pokračujme!
Takže, monitoring funguje nejaký čas, potom sa sám odpojí. Znamená to, že v politikách firewallu pravdepodobne nie sú problémy. Avšak, keďže som sa stretol s problémom zamrznutých systémových procesov vo Fortigate verziách 5.6+, najprv sa pozrieme na „diagnose debug flow“ - očakávane, traffic je povolený a odchádza z rozhrania a očakávane nič neprichádza ako odpoveď. Znamená to, že musíme kopnúť hlbšie do zásobníka. Budem musieť, bohužiaľ, skryť adresy, aj keď sú RFC1918, ale dúfam, že proces bude dostatočne popísaný na pochopenie. Server vnútri VXLAN má adresu x.x.x.15, rozhranie Fortigate má adresu x.x.x.254, všetky ostatné adresy patria do siete VTEP.
Na úspešný prenos VXLAN zakapsulovaných paketov je potrebné mať správne informácie v niekoľkých tabuľkách. Pre overlay ide o ARP a OVSDB, pre underlay sú to ARP a CAM. V prípade Fortigate je VXLAN FDB a OVSDB rovnaký. Odtiaľ aj začneme:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=у.у.у.47 port=4789 vni=5008 ifindex=7
Tu je všetko dosť jednoduché — MAC adresa virtuálneho stroja musí byť na VTEP s adresou у.у.у.47. Skontroloval som obsah a nastavenia ESXI klastra a zistil som, že MAC virtuálneho stroja je správny, adresa VTEP tiež. Kontrolujem CAM/ARP tabuľku na Fortigate — opäť všetko súhlasí s nastaveniami ESXI hostiteľa:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
Tabuľky sú správne a prenos prebieha — môže byť problém nie na Fortigate? Úmyselne som vynechal analýzu prepínania prenosu na Juniperi — logicky by sa to malo uskutočniť v ďalšom kroku riešenia problémov, ale sieť mám jednoduchú — iba jedno VLAN pre VTEP a všetky komponenty sú pripojené priamo. Navyše si spomínam na prípad s DLR mostom, VDR a zmiznutými prenosmi — idem snímať na ESXI hoste, zatiaľ čo vytváram tiket už k VMWare. Nižšie MAC „97:6e“ patrí Fortigate, vmnic1 — to je rozhranie, ktoré má VTEP s adresou у.у.у.47, snímam v oboch smeroch "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
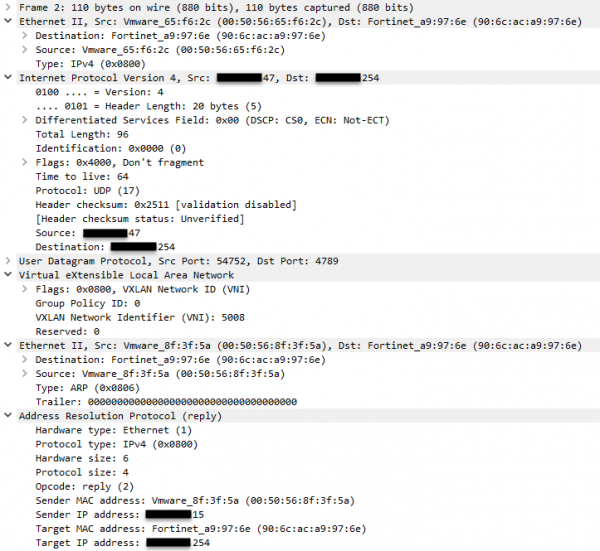
Pokrok — v snímaní vidím ARP požiadavku a prichádzajúcu odpoveď. Uvádzam len ARP odpoveď a tam je všetko správne. Nespomenul som, ale po celé toto obdobie server monitorovania pingoval adresu х.х.х.15 — kde je ICMP prenos? Spomínam si, že mám dva uplinky. Tu by sa dalo polemizovať a povedať, že virtuálny port zdroja je rovnaký (mojím teaming policy), teda pre rovnakú vNIC by sa mal vybrať rovnaký uplink, ale keďže som na hoste, skontrolovať iný uplink nie je problém:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
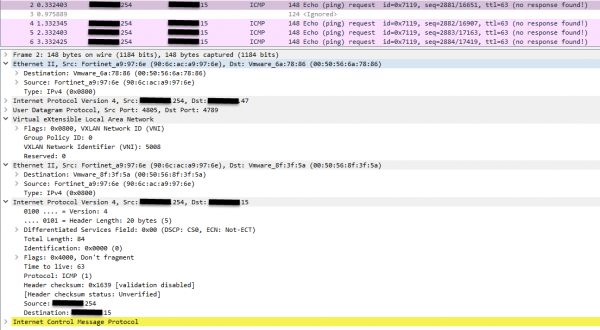
Prichádzajú požiadavky od fortigatu, ale odpovede niet. To znamená, že problém nie je vo fortigate. No, všetko — myslím si — zase ten istý problém so zmiznutím prevádzky na VDR, zase pár mesiacov smerovať prípad na správnu cestu. Po pár dňoch, ochladnúc a nechcúc sa zmieriť s visiacim stavom, som sa rozhodol nazhromaždiť ešte sniffy pre podporu, aby som urýchlil proces. A tu sa „náhodou“ môj pohľad zastaví na Ethernet inkapsulácii underlay. Cár nie je pravý a MAC adresa VTEP nesúhlasí s jeho IP. Resetujem na nulu, sniffujem, hrabem — správne, že nie je. Priložím ARP tabuľku vedľa, aby bolo pohodlnejšie porovnávať. Všimnite si prvú Ethernet inkapsuláciu na obrázku hore:
fortigate (root) #get sys arp | grep x.x.x.47
x.x.x.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep x.x.x.42
x.x.x.42 0 00:50:56:6a:78:86 dmz
A tak, čo máme v konečnom dôsledku — po migrácii virtuálneho stroja sa fortigate snaží poslať prevádzku na VTEP z (správneho) VXLAN FDB, ale používa nesprávny DST MAC a prevádzka logicky odmieta prijímajúci rozhraní hypervízora. Až v jednom prípade z štyroch tento MAC patril pôvodnému hypervízoru, z ktorého začínali migráciu stroja.
Včera som dostal e-mail od technickej podpory Fortinet — otvorili chybu 615586 na mojom prípade. Úplne neviem, či sa mám tešiť alebo smútiť: z jednej strany — problém nie je v nastaveniach, z druhej — oprava príde len s aktualizáciou firmvéru, v tom lepšom prípade s nasledujúcim. Ego mi tiež povzbudzuje ďalšia chyba, ktorú som odhalil minulý mesiac, pravda, vtedy v HTML5 GUI vSphere. Tak presne lokálny QA tím dodávateľov…
Rizkujem predpoklad, že nasledujúce:
1 — multicast ovládací plán pravdepodobne nebude podliehať opísanému problému — veď MAC adresy VTEP sa získavajú z IP adresy skupiny, na ktorú je pripojené rozhranie.
2 — pravdepodobne problém fortigatu v offloadovaní relácií na Network Processor (približne analóg CEF) — ak sa prechádza každým paketom cez CPU, budú sa používať tabuľky obsahujúce správne — aspoň vizuálne — informácie. V prospech tohto predpokladu hovorí, že pomáha zatvárať/otvárať rozhranie alebo čakať nejaký čas — viac ako 5 minút.
3 — zmena politiky tímovania, napríklad na explicit failover, alebo implementácia LAG problém nevyrieši, pretože sa pozorovalo „zaseknutie“ MAC pôvodného hypervízora v inkapsulovaných paktoch.
V svetle tohto môžem zdieľať, že som nedávno objavil , kde v jednom z článkov sa tvrdilo, že stateful firewall a cacheovateľné metódy prenosu dát sú len barlami. Nuž, nie som dostatočne skúsený v IT, aby som mohol takéto niečo tvrdiť, navyše nie so všetkými tvrdeniami blogových článkov súhlasím hneď. Avšak niečo mi hovorí, že v slovách Ivana je určitá pravda.
Ďakujem za pozornosť! Budem rád odpovedať na otázky a vypočuť si konštruktívnu kritiku.
Zdroj: habr.com
