

Tisíce manažérov z predajných kancelárií po celej krajine zaznamenávajú v denne desiatky tisíc kontaktov — faktov o komunikácii s potenciálnymi alebo už existujúcimi zákazníkmi. A aby sme sa dostali k tomuto zákazníkovi, treba ho najprv nájsť, a to čo najrýchlejšie. To sa zvyčajne deje podľa názvu.
Preto nie je prekvapujúce, že pri opakovanom skúmaní "ťažkých" požiadaviek na jednej z našich najvyťaženejších databáz — našom vlastnom , som objavil v "top" požiadavku na "rýchle" vyhľadávanie podľa názvu pre karty organizácií.
Zároveň ďalšie vyšetrovanie odhalilo zaujímavý príklad najprv optimalizácie, a potom degradácie výkonu požiadavky pri postupnej práci s ňou viacerými tímami, z ktorých každý konal iba z najlepších úmyslov.
0: čo vlastne používateľ chcel
 [KDPV ]
Čo vlastne zvyčajne myslí používateľ, keď hovorí o "rýchlom" vyhľadávaní podľa názvu? Takmer nikdy to nie je "poctivé" vyhľadávanie podľa podreťazca ako ... LIKE '%růže%' — veď v takom prípade sa dostanú do výsledkov nielen 'Rózalia' a 'Predajňa Róza', ale aj 'Grůže' a dokonca 'Dom Deda Morůže'.
Používateľ má však na bežnej úrovni na mysli, že mu zabezpečíte vyhľadávanie podľa začiatku slova v názve a ukážete relevantnejšie to, čo začína na zadané. A spravíte to prakticky okamžite — pri podreťazcovom vstupe.
1: obmedzujeme úlohu
A už vôbec nie bude človek špeciálne zadávať 'růže obchod',aby ste každé slovo museli hľadať prefixovo. Nie, reagovať na rýchlu návrh posledného slova je pre používateľa oveľa jednoduchšie, než cielene "nedoplniť" predchádzajúce — pozrite sa, ako na to reaguje akýkoľvek vyhľadávač.
Vo všeobecnosti, správne formulovať požiadavky na úlohu — to je viac ako polovica riešenia. Niekedy dôkladná analýza use case .
A čo robí abstraktný vývojár?
1.0: externý vyhľadávací engine
Och, vyhľadávanie je zložité, vôbec sa mi do toho nechce — poďme to odovzdať devops! Nech nám rozbehnú externý vyhľadávací systém relatívne k databáze: Sphinx, ElasticSearch,…
Pracovný variant, aj keď namáhavý z hľadiska synchronizácie a rýchlosti zmien. Ale nie v našom prípade, pretože vyhľadávanie sa vykonáva pre každého klienta iba v rámci údajov jeho účtu. A údaje majú dosť vysokú variabilitu — a ak teraz manažér vložil kartu 'Obchod Róza', tak si môže už za 5-10 sekúnd spomenúť, že zabudol uviesť e-mail a chce ju nájsť a opraviť.
Preto — poďme hľadať „priamo v databáze“. Našťastie, PostgreSQL nám to umožňuje, a to nie jedným spôsobom — tie si prejdeme.
1.1: „čestný“ podreťazec
Zameriame sa na slovo „podreťazec“. A presne na indexové vyhľadávanie podľa podreťazca (a aj na regulárne výrazy!) existuje skvelý ! Len to bude potrebné správne zoradiť.
Poďme skúsiť vziať pre jednoduchosť model takú tabuľku:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Nahrávame tam 7,8 milióna záznamov reálnych organizácií a indexujeme:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Hľadajme pre podreťazcové vyhľadávanie prvých 10 záznamov:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'róza')
ORDER BY
  lower(name) ~ ('^' || 'róza') DESC -- najprv "začínajúce na"
, lower(name) -- zvyšok podľa abecedy
LIMIT 10;
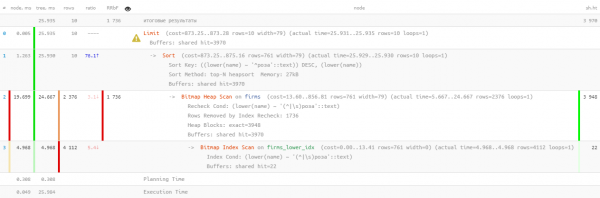
No, takto... 26ms, 31MB prečítaných údajov a viac ako 1,7K filtrovaných záznamov — pre 10 hľadaných. Náklady sú príliš vysoké, nedá sa to urobiť efektívnejšie?
1.2: vyhľadávanie v texte? to je predsa FTS!
Naozaj, PostgreSQL poskytuje veľmi mocný (Full Text Search), vrátane možnosti prefixového vyhľadávania. Skvelá alternatíva, dokonca nie je potrebné inštalovať rozšírenia! Poďme to skúsiť:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'róza:*')
ORDER BY
lower(name) ~ ('^' || 'róza') DESC
, lower(name)
LIMIT 10; 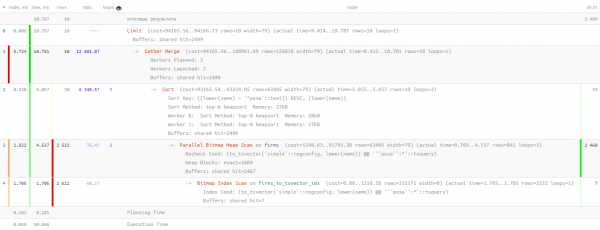
Tu nám trochu pomohla paralelizácia vykonávania dotazu, čím sa čas skrátil na 11ms. A museli sme prečítať 1,5-krát menej — iba 20MB. A tu platí, čím menej — tým lepšie, pretože čím väčší objem prečítame, tým vyššie sú šance na cache miss, a každá zbytočne prečítaná stránka údajov z disku je potenciálny „spomalenie“ dotazu.
1.3: predsa len LIKE?
Všetky predchádzajúce dotazy sú dobré, ale ak ich spustíme stotisíckrát za deň, tak sa nahromadí už 2TB prečítaných údajov. V najlepšom prípade — z pamäte, ale ak nemáme šťastie, tak aj z disku. Tak skúsme urobiť, aby bol menší.
Pripomeňme si, čo chce používateľ vidieť najprv „ktoré začínajú na …“. Veď to je v čistom zmysle s pomocou text_pattern_ops! A len ak nám „nepostačí“ do 10 hľadaných záznamov, budeme musieť dočítať pomocou FTS vyhľadávania:
VYTVORIŤ INDEX NA firms(lower(name) text_pattern_ops);VYBRAŤ
*
Z
firms
KDE
lower(name) LIKE ('rôza' || '%')
LIMIT 10; 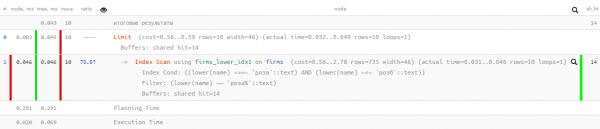
Skvelé výsledky — iba 0.05ms a niečo málo viac ako 100KB prečítané! Iba sme zabudli zoradenie podľa názvu, aby sa používateľ nestratil vo výsledkoch:
VYBRAŤ
  *
Z
  firms
KDE
  lower(name) LIKE ('rôza' || '%')
ORDER BY
  lower(name)
LIMIT 10; 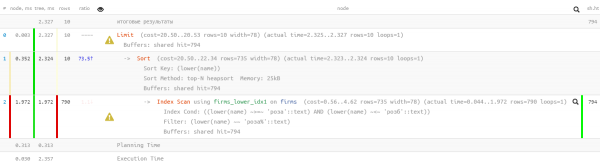
Och, niečo už nie je tak pekné — akoby index bol, ale zoradenie prechádza mimo neho… To je samozrejme už oveľa efektívnejšie ako predchádzajúca možnosť, ale…
1.4: „doplniť pilníkom“
Ale existuje predsa index, ktorý umožňuje aj vyhľadávanie v intervale, a pritom používať zoradenie normálne — obyčajný btree!
VYTVORIŤ INDEX NA firms(lower(name));Iba dotaz pod ním budeme musieť „poskladať ručne“:
VYBRAŤ
  *
Z
  firms
KDE
  lower(name) >= 'rôza' A
  lower(name) <= ('rôza' || chr(65535)) -- pre UTF8, pre jedným bajtom - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 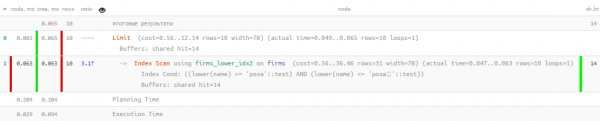
Skvele — a zoradenie funguje, a spotreba zdrojov zostala „mikroskopická“, tisíckrát efektívnejšie ako „čistej“ FTS! Ešte zostáva zhrnúť do jedného dotazu:
(
  VYBRAŤ
    *
  Z
    firms
  KDE
    lower(name) >= 'rôza' A
    lower(name) <= ('rôza' || chr(65535)) -- pre UTF8, pre jedným bajtom - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  VYBRAŤ
    *
  Z
    firms
  KDE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rôza:*') A
    lower(name) NOT LIKE ('rôza' || '%') -- "začínajúce na" sme už našli vyššie
  ORDER BY
    lower(name) ~ ('^' || 'rôza') DESC -- používame to isté zoradenie, aby sme NEšli po btree-indexe
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Poznamenám, že druhý poddotaz sa vykonáva iba ak prvý vrátil menej očakávaného posledného LIMIT počtu riadkov. O takýchto metódach optimalizácie dotazov som .
Áno, teraz máme na tabuľke zároveň btree a gin, len štatisticky sa ukázalo, že menej ako 10% dotazov dosiahne vykonanie druhej časti. To znamená, že pri takýchto vopred známych typických obmedzeniach pre úlohu sme dokázali znížiť celkovú spotrebu serverových zdrojov prakticky tisíckrát!
1.5*: obídeme sa bez pilníka
Vyššie LIKE bránilo nám používať nesprávne zoradenie. Ale dá sa to "nasmerovať na správnu cestu" pomocou operátora USING:
Predpokladá sa
ASC. Okrem toho je možné zadať názov špecifického operátora zoradenia v príkazeUSING. Operátor zoradenia musí byť členom rodiny operátorov B-stromu "menšie" alebo "väčšie".ASCzvyčajne zodpovedáUSING <aDESCzvyčajne zodpovedáUSING >.
V našom prípade "menšie" je ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('růže' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 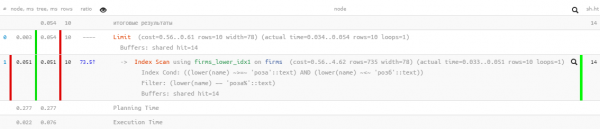
2: ako „zkysnú“ dotazy
Teraz nechávame náš dotaz "odpočívať" pol roka až rok, a s prekvapením opäť nachádzame jeho "v top" s ukazovateľmi celkového denných "vylepšení" pamäte (buffers shared hit) v 5.5TB — teda ešte viac, ako to bolo pôvodne.
Nie, samozrejme, že biznis nám vzrástol, a záťaž sa zvýšila, ale nie tak veľmi! To znamená, že niečo tu nie je v poriadku — poďme sa na to pozrieť.
2.1: zrodenie stránkovania
V istom momente iný tím vývojárov sa rozhodol vytvoriť možnosť pre "skok" z rýchleho podčiarkovaného vyhľadávania do registra s tými istými, ale rozšírenými výsledkami. A aký register bez stránkovania? Poďme to pripevniť!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Teraz bolo možné bez napätia pre vývojára zobrazovať register výsledkov vyhľadávania s "typom-stránkovanou" dodávkou.
Samozrejme, v skutočnosti, pre každú nasledujúcu stránku sa číta čoraz viac a viac dát (všetko z predchádzajúceho, čo zahodíme, plus potrebný "chvost") — to znamená, že je to jednoznačný antipattern. A správnejšie by bolo — spustiť vyhľadávanie na ďalšej iterácii od zapamätaného v rozhraní kľúča, ale o tom — nabudúce.
2.2: chce to exotičnost
V istom momente vývojárovi sa zatúžilo obohatiť výsledný výber týmito údajmi z inej tabuľky, na čo bol celý predchádzajúci dotaz poslaný do CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- nejaký dotaz na priradenú tabuľku
FROM
  q
LIMIT 10 OFFSET ;
A aj tak — nie zlé, pretože vnorený dotaz sa počíta len pre 10 vracaných záznamov, keby nebolo...
2.3: DISTINCT bez zmyslu a bez milosti
Kdesi v procese takej evolúcie z 2. poddotazu sa stratilo NOT LIKE podmienka. Je jasné, že po tom UNION ALL začal vracať niektoré záznamy dvakrát — najprv nájdené podľa začiatku riadku, a potom ešte raz — podľa začiatku prvého slova tohto riadku. V limite, všetky záznamy 2. poddotazu mohli súhlasiť so záznamami prvého.
Čo robí vývojár namiesto hľadania príčiny?.. Nie je to otázka!
- rozšírime veľkosť na dvojnásobok počiatočných výberov
- aplikujeme DISTINCT, aby sme sa dostali iba k jedným exemplárom každého riadku
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Teda je jasné, že výsledok, nakoniec, je presne ten istý, ale šanca "premrhať" v 2. poddotaze CTE sa značne zvýšila, a aj bez toho, je zrejmé, že sa číta oveľa viac.
Ale to nie je najväčší problém. Keďže vývojár požiadal o výber STDEV nie podľa konkrétnych, ale hneď podľa všetkých polí záznamy, tak tam automaticky patrilo aj pole sub_query — výsledok poddotazu. Teraz, pre vykonanie STDEV, musela databáza vykonať už nie 10 poddotazov, ale všetky + 10!
2.4: spolupráca je všetkým!
Takto žili vývojári — netrápili sa, pretože v registri "dotiahnuť" na významné hodnoty N pri chronickom spomalení získavania každej ďalšej "stránky" užívateľ evidentne nemal trpezlivosť.
Kým k nim neprišli vývojári z iného oddelenia, a nechceli využiť takú pohodlnú metódu pre iteratívne hľadanie — teda berieme z nejakej výberu kúsok, filtrujeme podľa dodatočných podmienok, zobrazíme výsledok, potom ďalší kúsok (čo v našom prípade dosahujeme zvýšením N), a tak ďalej, kým nevyplníme obrazovku.
Celkovo, v zachytenom exemplári N dosiahlo hodnoty takmer 17K, a v priebehu jedného dňa bolo vykonaných "za sebou" nie menej ako 4K takýchto požiadaviek. Posledné z nich už smelo skenovali po 1GB pamäte na každej iterácii…
Spolu
Zdroj: habr.com
