

Ahoj! Volám sa Alexej Pjankov a som vývojár v spoločnosti Sportmaster. V tomto som hovoril o tom, ako sa začala práca na webovej stránke Sportmaster v roku 2012, aké iniciatívy sa podarilo "presadiť" a naopak, aké problémy sme narazili.
Dnes sa chcem podeliť o myšlienky, ktoré súvisia s iným tématom – výberom systému cache pre java backend v administrácii webovej stránky. Táto téma má pre mňa osobitný význam – hoci sa príbeh odohrával len dva mesiace, tieto 60 dní sme pracovali 12-16 hodín bez jediného dňa voľna. Nikdy predtým som si nemyslel a nemohol ani predstaviť, že sa dá pracovať takto veľa.
Preto text delím na dve časti, aby som to úplne nezavalil. Naopak, prvá časť bude veľmi jednoduchá — príprava, úvod, niektoré úvahy o tom, čo je caching. Ak ste už skúsený vývojár alebo ste pracovali s cache, z technického hľadiska tu pravdepodobne nič nové nebude. Pre juniora však môže byť tento malý prehľad užitočný, ak sa ocitne na takej križovatke.
Keď bola nová verzia webovej stránky Sportmaster uvedená do produkcie, dáta prúdili spôsobom, jemne povedané, nie veľmi pohodlným. Základom boli tabuľky, ktoré boli pripravené pre predchádzajúcu verziu webu (Bitrix), a ktoré bolo potrebné preniesť do ETL, upraviť do nového formátu a obohatiť rôznymi prvkami z desiatich ďalších systémov. Aby sa nová fotografia alebo popis produktu dostali na web, bolo potrebné čakať do nasledujúceho dňa — aktualizácia bola iba raz za noc, raz denne.
Na začiatku sme mali toľko starostí v prvých týždňoch po uvedení do produkcie, že takéto nepríjemnosti pre content managerov boli maličkosťou. Ale hneď, ako sa všetko usadilo, pokračoval rozvoj projektu — o niekoľko mesiacov, na začiatku roku 2015 sme začali aktívne vyvíjať administráciu. V rokoch 2015 a 2016 všetko ide dobre, pravidelne vydávame aktualizácie a administrácia pokrýva čoraz väčšiu časť prípravy dát a pripravujeme sa na to, že čoskoro našej tímu zveria to najdôležitejšie a najnáročnejšie – produktový rámec (úplná príprava a správa dát pre všetky produkty). Ale v lete 2017, tesne pred spustením produktového rámca, sa projekt ocitne v veľmi zložitej situácii – práve kvôli problémom s cache. O tomto epizóde chcem rozprávať v druhej časti tejto dvojdielnej publikácie.
V tomto príspevku začnem z diaľky a zhrniem niektoré myšlienky – predstavy o caching, ktoré by bolo dobré prejsť pred veľkým projektom.
Keď nastane úloha caching
Úloha caching sa neobjavuje len tak. Sme vývojári, píšeme softvérový produkt a chceme, aby bol žiadaný. Ak je produkt žiadaný a úspešný, užívatelia prichádzajú. A znovu prichádzajú, a ešte raz. A keď je užívateľov veľa, produkt sa stáva vysokonáročným.
V počiatočných fázach nemyslíme na optimalizáciu a výkon kódu. Hlavné je – funkčnosť, rýchlo zaviesť pilot a overiť hypotézy. A keď sa zaťaženie zvyšuje, vylepšujeme hardvér. Zvyšujeme ho dvakrát, trikrát, päťkrát, nech aj desaťkrát. Kdesi na tomto mieste – financie už nebudú stačiť. A koľkokrát sa zvýši počet používateľov? Nebude to len 2-5-10, ale v prípade úspechu to bude od 100-1000 a až po 100 tisíc. To znamená, že skôr alebo neskôr sa vyžaduje optimalizácia.
Predpokladajme, že určitá časť kódu (nazvime túto časť funkciou) pracuje nepríjemne dlho a chceme skrátiť čas vykonávania. Funkcia – to môže byť prístup k databáze, môže to byť vykonávanie nejakej zložitej logiky – hlavné je, že trvá dlho. O koľko môžeme skrátiť čas vykonávania? V limite – môžeme skrátiť na nulu, nič ďalej. A ako môžeme skrátiť čas vykonávania na nulu? Odpoveď: úplne vylúčiť vykonávanie. Namiesto toho – okamžite vrátiť výsledok. A ako získať výsledok? Odpoveď: buď vypočítať, alebo niekde nahliadnuť. Vypočítať – to trvá dlho. A nahliadnuť – to je napríklad zapamätať si ten výsledok, ktorý funkcia vrátila naposledy pri volaní s rovnakými parametrami.
To put it simply, the implementation of the function doesn't matter to us. It's enough to know which parameters affect the result. Then, if we represent the parameter values as an object that can be used as a key in some storage — we can save the computation result and retrieve it the next time we call. If the read-write performance is faster than executing the function – we gain speed benefits. The gain can reach up to 100, 1000, or even 100,000 times (10^5 is more of an exception, but in the case of a heavily lagging database - it's quite possible).
Basic requirements for the caching system
The first requirement that might apply to the caching system is fast read speed and, to a lesser extent, write speed. This is true, but only until we roll the system into production.
Let's consider a case.
Suppose we provided the hardware for the current load and are now gradually implementing caching. The user base grows slightly, load increases – we add caches here and there. This continues for a while, and now heavy functions are hardly called — the main load falls entirely on the cache. The number of users has increased N times during this period.
And if the initial hardware capacity could have been 2-5 times, then with the help of caching, we could have boosted performance by 10 times or, in the best case, by 100 times, and in some instances, even 1000 times. That is, on the same hardware – we're processing 100 times more requests. Wonderful, we deserve a reward!
But now, at one point, by chance, the system failed and the cache crashed. Nothing unusual – after all, the cache was chosen based on the requirement of 'high read and write speed, the rest doesn't matter.'
Regarding the initial load, we had a 2-5 times hardware capacity, while the load during this time increased by 10-100 times. With the help of caching, we eliminated calls for heavy functions, and therefore everything was running smoothly. But now, without the cache – how much will our system drop? What will happen? The system will crash.
Even if our cache didn't crash, but just cleared for a period – it will need to be warmed up, and that will take some time. During that time, the main load will fall on the functionality.
Výstup: vysoko zaťažené projekty v produkcii vyžadujú od systému cachingu nielen vysokú rýchlosť čítania a zápisu, ale aj zachovanie dát a odolnosť voči chybám.
Múky výberu
V projekte s administrátorským rozhraním – výber prebiehal takto: najskôr sme nainštalovali Hazelcast, pretože sme už mali s týmto produktom skúsenosti z hlavnej stránky. Ale takýto výber sa ukázal byť nešťastný – pod naším zaťažením funguje Hazelcast nielen pomaly, ale hrozne pomaly. A s termínmi uvedenia do produkcie sme sa už v tom čase zaviazali.
Spoiler: ako sa vlastne vyvinuli okolnosti, že sme prehliadli takúto nevýhodu a dostali sa do ťažkej a napätej situácie – o tom poviem v druhej časti – a ako sme sa dostali, a ako sme sa vymotali. Ale teraz – poviem len to, že to bol silný stres a „premýšľať – akosi sa mi nechce, trasieme fľašou“. „Traseme fľašou“ – to je tiež spoiler, viac o tom neskôr.
Čo sme urobili:
- Skladáme zoznam všetkých systémov, ktoré odporúča Google a StackOverflow. Niečo viac ako 30.
- Píšeme testy so záťažou, ktorá je typická pre produkciu. Na tento účel sme zaznamenali dáta, ktoré prechádzajú systémom v produkčnom prostredí – taký sniffér pre dáta nie v sieti, ale v rámci systému. Do testov sme spustili presne tieto dáta.
- Celý tím, každý si vyberá ďalší systém zo zoznamu, nastavuje ho, spúšťa testy. Ak test neprejde, nezvláda záťaž – vyradíme, prejdeme na ďalší v poradí.
- Na 17. systéme bolo jasné, že to všetko je beznádejne. Dosť trasenia fľašou, je čas zamyslieť sa vážne.
Ale to je varianta, keď treba vybrať systém, ktorý „prejde rýchlosťou“ v vopred pripravených testoch. A čo ak také testy ešte nie sú a chcete vybrať rýchlo?
Modelujeme takúto variantu (ťažko si predstaviť, že mid-level+ vývojár žije v prázdne, a v čase výberu ešte nemá jasne stanovené preferencie, aký produkt vyskúšať ako prvý — preto, ďalšie úvahy sú skôr teoretického charakteru/filosofia/o juniorovi).
Ujasnime si požiadavky a začneme vyberať riešenie z krabice. Prečo vynachádzať koleso: pôjdeme a vezmeme hotový systém cachingu.
Ak sa len začínate a budete googliť, poradím vám približnú sekvenciu. Najprv natrafíte na Redis, ktorý je veľmi známy. Potom zistíte, že existuje EhCache, najstarší a osvedčený systém. Ďalej budeme hovoriť o Tarantool, domácej technológii s unikátnym prístupom. A takisto o Ignite, pretože momentálne zažíva vzostup popularity a má podporu SberTechu. Nakoniec sa spomenie aj Hazelcast, pretože sa často objavuje vo svete podnikov.
Týmto zoznam nekončí, existuje desiatky systémov. My si vezmeme len jeden. Vyberieme si 5 systémov na "súťaž krásy" a uskutočníme výber. Kto sa stane víťazom?
Kľuč-hodnota
Čítame, čo píšu na oficiálnom webe.
— opensource projekt. Ponúka in-memory úložisko, možnosť ukladania na disk, automatické rozdelenie na partície, vysokú dostupnosť a obnovu po sieťových prerušeniach.
Všetko sa zdá byť skvelé, môžeme ho vziať a implementovať — robí všetko, čo potrebujeme. Ale pozrime sa len tak pre zaujímavosť na ostatných kandidátov.
EhCache
— "najširšie používaná cache pre Java" (preklad sloganu z oficiálnej stránky). Taktiež opensource. Tu chápeme, že Redis nie je určený pre Java, ide o všeobecný systém, a na jeho interakciu potrebuje obal. EhCache by bola pohodlnejšia. Čo ešte systém sľubuje? Spoľahlivosť, preverenosť, plnofunkčnosť. A je najrozšírenejšia, cacheuje terabajty dát.
Redis bol zabudnutý, som pripravený zvoliť EhCache.
Ale pocit patriotizmu ma nabáda pozrieť sa, čo je dobré na Tarantool.
Tarantool
— zavádza nás označením "Platforma na integráciu dát v reálnom čase". Znie to veľmi zložito, preto si dôkladne prečítame stránku a nachádzame silné vyhlásenie: "Cacheuje 100% dát v operačnej pamäti". To by malo vzbudzovať otázky — pretože dát môže byť omnoho viac, než je pamäť. Vysvetlením je, že pri zápise dát na disk z pamäte Tarantool neprechádza serializáciou. Namiesto toho využíva nízkoúrovňové vlastnosti systému, keď je pamäť jednoducho mapovaná na súborový systém s veľmi dobrými ukazovateľmi I/O. Skrátka, urobili to celkom úžasne a šikovne.
Pozrime sa na realizácie: Mail.ru firemná diaľnica, Avito, Beeline, MegaFon, Alfa-Bank, Gazprom…
Ak ešte existovali nejaké pochybnosti o Tarantool, tak implementácia v Mastercard ma definitívne presviedča. Beriem Tarantool.
Ale predsa len…
Ignite
… sú tu ešte , deklarované ako „in-memory výpočtová platforma… in-memory rýchlosti na petabajtoch dát“. Aj tu je veľa výhod: distribuovaný in-memory cache, najrýchlejšie key-value úložisko a cache, horizontálne škálovanie, vysoká dostupnosť, prísna integrita. V skratke, najrýchlejší je Ignite.
Implementácie: Sberbank, American Airlines, Yahoo! Japan. A potom sa ešte dozvedám, že Ignite nie je len tak implementovaný v Sberbank, ale tím SberTechu posiela svojich ľudí do tímu samotného Ignite, aby vylepšili produkt. To ma úplne presviedča a som pripravený zobrať Ignite.
Úplne mi nie je jasné, prečo sa pozerám na piaty bod.
Hazelcast
Vstupujem na stránku , čítam. A ukazuje sa, že najrýchlejšie riešenie pre distribuované cacheovanie je Hazelcast. Je rádovo rýchlejší ako všetky ostatné riešenia a je skutočným lídrom v oblasti in-memory data grid. V tomto kontexte vziať niečo iné — nebrať sa vážne. A navyše používa redundantné uloženie údajov pre nepretržitú prevádzku klastrov bez straty údajov.
Vsetko, som pripravený zobrať Hazelcast.
Porovnanie
Ale ak sa pozrieme, všetkých päť kandidátov je popísaných tak, že každý z nich je najlepší. Ako si vybrať? Môžeme sa pozrieť, ktorý z nich je najpopulárnejší, hľadať porovnania a bolesť hlavy sa rozplynie.
Nájdeme taký , vyberáme našich 5 systémov.
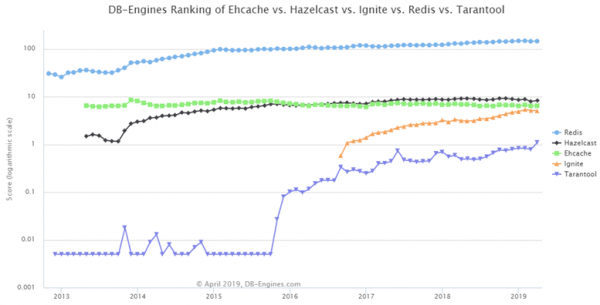
Tu sú zoradené: na vrchu Redis, na druhom mieste — Hazelcast, získavajú popularitu Tarantool a Ignite, EhCache zostáva na rovnakom mieste.
Ale pozrime sa na : odkazy na webové stránky, všeobecný záujem o systém, pracovné ponuky — skvelé! Teda, keď mi systém spadne, poviem: „Nie, je predsa spoľahlivý! Tu je veľa pracovných ponúk…“. Takéto jednoduché porovnanie sa nehodí.
Všetky tieto systémy nie sú len systémy na cacheovanie. Majú tiež veľmi veľa funkcií, vrátane – keď nie sú dáta posielané klientovi na spracovanie, ale opačne: kód, ktorý treba vykonať na údajoch, sa prenáša na server, tam sa vykonáva a výsledok sa vracia. A ako samostatný systém pre cacheovanie sa často ani neberú do úvahy.
Dobre, nevzdávame sa, nájdeme priamu komparáciu systémov. Zoberieme dva najvyššie varianty — Redis a Hazelcast. Zaujíma nás rýchlosť, podľa tohto parametra ich porovnáme.
Hz vs Redis
Nájdeme takú :
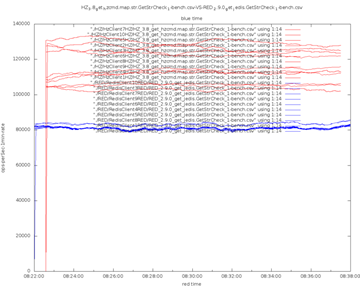
Modrá je Redis, červená je Hazelcast. Hazelcast neustále vyhráva a to má svoje dôvody: je viacvláknový, vysoko optimalizovaný, každý vlákno pracuje so svojou partíciou, preto sú tam žiadne zámky. Redis je jednovláknový, nevyužíva výhody moderných viacjadrových CPU. Hazelcast má asynchrónne I/O, zatiaľ čo Redis-Jedis pracuje s blokujúcimi socketmi. Nakoniec, Hazelcast používa binárny protokol, zatiaľ čo Redis je orientovaný na text, takže je menej efektívny.
Pre istotu sa pozrime na ďalší zdroj porovnania. Čo nám ukáže?
Redis vs Hz
Ešte jedno :
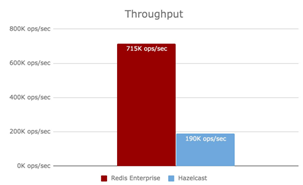
Tu je naopak, červená je Redis. To znamená, že Redis po výkonnostnej stránke prekonáva Hazelcast. V prvom porovnaní vyhrával Hazelcast, v druhom – Redis. veľmi presne vysvetlené, prečo v predchádzajúcom porovnaní vyhral Hazelcast.
Ukazuje sa, že výsledok prvého bol vlastne falšovaný: Redis bol použitý v základnej verzii, zatiaľ čo Hazelcast bol prispôsobený testovaciemu prípadu. Takže dostávame: po prvé, nikomu sa nedá veriť, a po druhé, keď si už vyberieme systém, musíme ho ešte správne nastaviť. Tieto nastavenia zahŕňajú desiatky, takmer stovky parametrov.
Treseme fľašu
A celý proces, ktorý sme teraz vykonali, môžem vysvetliť takouto metaforou: "Treseme fľašu". To znamená, že teraz nie je potrebné programovať, teraz je najdôležitejšie vedieť čítať stackoverflow. A mám v tíme človeka, profesionála, ktorý presne takto pracuje v kritických momentoch.
Čo robí? Vidí nefunkčný komponent, vidí stack trace, vyberie niektoré slová z neho (aké presne – to je jeho expertíza v programe), hľadá v Google, nájde stackoverflow medzi odpoveďami. Nečítajúc, neprežívajúc, medzi odpoveďami na otázku – vyberie niečo, čo je najviac podobné návrhu "urobiť toto a toto" (vybrať takú odpoveď – to je jeho talent, pretože to nie vždy je presne tá odpoveď, ktorá dostala najviac hlasov), aplikuje, pozrie: ak sa niečo zmenilo, tak je to skvelé. Ak sa nezmenilo – vraciame sa späť. A opakujeme spustenie-kontrolu-hľadanie. A týmto intuíciou dosiahne, že za nejaký čas kód funguje. Nevie prečo, nevie, čo spravil, nevie to vysvetliť. Ale! Ten zázrak funguje. A "požiar je uhasený". Teraz rozoberáme, čo sme spravili. Keď program funguje – je to stokrát jednoduchšie. A výrazne šetrí čas.
Tento spôsob sa veľmi dobre ilustruje na takomto príklade.
Niekedy bolo veľmi populárne skladať plachetnicu do fľaše. Plachetnica je pritom veľká a krehká, a hrdlo fľaše je veľmi úzke, nedá sa jej tam dostať. Ako ju teda zložiť?
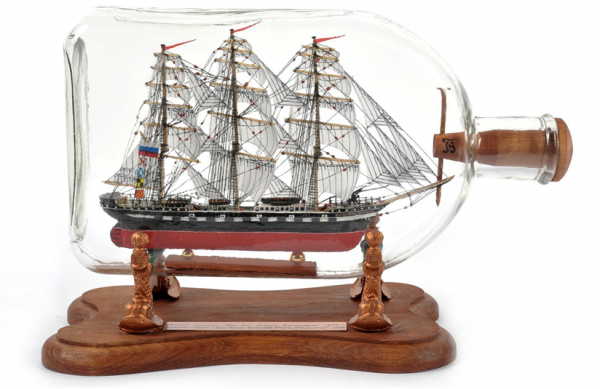
Existuje taká metóda, veľmi rýchla a veľmi efektívna.
Loď sa skladá z množstva drobností: paličiek, šnúriek, plachiet, lepidla. To všetko dáme do fľaše.
Bereme fľašu oboma rukami a začneme ju trasenie. Traseme ju, traseme. A zvyčajne – dopadá to úplne zle. Ale niekedy. Niekedy to dopadne ako loď! Presnejšie, niečo, čo vyzerá ako loď.
To niečo ukazujeme niekomu: „Seroha, vidíš!?“. A naozaj, z diaľky – vyzerá to ako loď. Ale ďalej to nie je možné pustiť.
Existuje aj iný spôsob. Používajú ho pokročilejší, takí hakeri.
Dal som takému chlapcovi úlohu, on to všetko urobil a odišiel. A pozrieš sa – akoby to bolo hotové. Ale po chvíli, keď treba dodatočne spracovať kód – začne tam také niečo kvôli nemu... Našťastie, už bol dosť ďaleko preč. Títo chlapci robia na príklade fľaše takto: vidíte, tam, kde je dno – sklo sa ohýba. A nie je celkom jasné, či je priehľadné alebo nie. Tak „hakeri“ zrežú toto dno, vložia tam loď, dno potom opäť prilepia a vyzerá to, akoby to tak malo byť.
Z pohľadu zadania úlohy sa všetko zdá správne. Ale na príklade lodí: prečo vôbec robiť tú loď, komu to vlastne slúži? Fункčnosť nemá žiadnu. Zvyčajne sú takéto lode dary veľmi vysokopostaveným osobám, ktoré si ich vystavujú na polici nad sebou ako symbol, ako znak. A ak takýto človek, vedúci veľkého podniku alebo vysokopostavený úradník, má takúto katastrofu so zrezaným hrdlom ako vlajku, bude lepšie, ak sa o tom nikdy nedozvie. Tak, a ako sa nakoniec robia tieto lode, ktoré je možné darovať dôležitej osobnosti?
Jediné miesto, s ktorým sa naozaj nedá nič robiť, je trup. A trup lode prechádza práve cez hrdlo. Zatiaľ čo sa loď skladá mimo fľaše. Ale nie je to len tak, poskladať loď, to je skutočné umelecké remeslo. Do jej súčastí sa pridávajú špeciálne páky, ktoré potom umožňujú ich zdvihnúť. Napríklad sa zložia plachty, starostlivo sa vložia dovnútra, a potom sa pomocou pinzety veľmi precízne, presne, vytiahnu a zdvihnú. Výsledkom je umelecké dielo, ktoré možno s čistým svedomím a hrdosťou darovať.
A ak chceme, aby bol projekt úspešný – v tíme by mal byť aspoň jeden zlatník. Ten, kto sa stará o kvalitu produktu a zohľadňuje všetky aspekty, ani v stresových momentoch, keď okolnosti vyžadujú, aby sa niečo urobilo rýchlo na úkor dôležitého. Všetky úspešné projekty, ktoré sú odolné a prežili skúšku časom, sú postavené na tomto princípe. Majú v sebe niečo veľmi presné a jedinečné, niečo, čo využíva všetky dostupné možnosti. V prípade lode vo fľaši sa hrá s tým, že trup lode prechádza cez hrdlo.
Vrátim sa k úlohe výberu nášho cache servera, ako by sa tento prístup dal aplikovať? Navrhujem takú možnosť výberu zo všetkých systémov, ktoré sú – netraseme so fľašou, nevyberáme, ale pozrieme sa, čo v nich vôbec je, na čo je potrebné dávať pozor pri výbere systému.
Kde hľadať bottleneck
Skúsme netriasť fľašou, neprehľadávať všetko, čo máme po poradí, ale pozrime sa, aké úlohy vzniknú, ak náhodou, pre svoju úlohu – navrhnúť taký systém samostatne. Samozrejme, neskladáme bicykel, ale využijeme túto schému, aby sme sa zorientovali, na ktoré aspekty sa zamerať v popisoch produktov. Narysujeme takú schému.
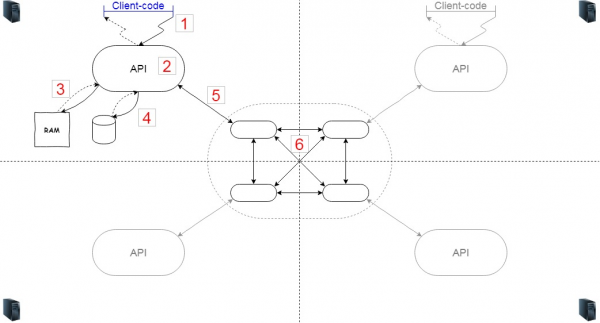
Ak je systém distribuovaný, znamená to, že budeme mať viac serverov (6). Predpokladajme, že štyri (je to pohodlné zobraziť na obrázku, ale samozrejme, ich môže byť koľko chce). Ak sú servery na rôznych uzloch, znamená to, že na nich všetkých beží nejaký kód, ktorý zaisťuje, aby tieto uzly vytvorili klaster a v prípade prerušenia – sa spojili, spoznali navzájom.
Ešte potrebujeme kód-logiku (2), ktorá sa týka cacheovania. S týmto kódom interagujú klienti prostredníctvom istého API. Klientsky kód (1) môže byť ako v rámci tej istej JVM, tak sa naň môže odkazovať aj cez sieť. Logika implementovaná vo vnútri spočíva v rozhodovaní, ktoré objekty v cache nechať a ktoré odstrániť. Na uchovávanie cache používame pamäť (3), ale ak bude potrebné, časť dát môžeme uložiť aj na disku (4).
Pozrime sa, v ktorých častiach bude dochádzať k zaťaženiu. Vlastne, zaťažované budú každá šípka a každý uzol. Po prvé, medzi klientským kódom a API, ak ide o sieťovú interakciu, pokles môže byť dosť výrazný. Po druhé, v rámci samotného API – ak to prehnáme s komplexnou logikou, môžeme naraziť na CPU. A bolo by dobré, aby logika nepoužívala pamäť zbytočne. A zostáva interakcia so súborovým systémom – v bežnej variantu to je serializovať / obnoviť a zapísať / prečítať.
Ďalej interakcia s klastrom. Pravdepodobne bude v tej istej sústave, ale môže byť aj oddelene. Tu je tiež potrebné zohľadniť prenos dát k nemu, rýchlosť serializácie dát a interakcií medzi klastrom.
Teraz, z jednej strany – môžeme si predstaviť, "aké kolieska sa budú točiť" v cache-systéme pri spracúvaní požiadaviek od nášho kódu, a z druhej strany – môžeme odhadnúť, aké a koľko požiadaviek náš kód na tento systém vygeneruje. To je dostatočné na to, aby sme urobili viac-menej rozumný výber – prispôsobiť systém našej potrebe.
Hazelcast
Pozrime sa, ako také rozloženie aplikovať na náš zoznam. Napríklad, Hazelcast.
Aby sme mohli uložiť / získať dáta z Hazelcast, klientsky kód sa obracia (1) na API. Hz umožňuje spustiť server ako embedded, a v tomto prípade je prístup k API – to je volanie metódy vo vnútri JVM, čo môžeme považovať za bezplatné.
Aby logika v (2) fungovala, Hz sa opiera o hash z bajtového poľa serializovaného kľúča – to znamená, že serializácia kľúča prebehne v každom prípade. To je nevyhnutný overhead pre Hz.
Eviction-stratégie sú dobre implementované, ale pre špeciálne prípady – je možné pripojiť aj vlastné. O túto časť sa netreba obávať.
Úložisko (4) je možné pripojiť. Skvelé. Interakcia (5) pre embedded sa dá považovať za okamžitú. Výmena dát medzi uzlami v clustri (6) – áno, táto existuje. Je to prínos pre dostupnosť na úkor rýchlosti. Zníženie ceny umožňuje Hz-funkcia Near-cache – dáta získané z iných uzlov clustra budú cachované.
Čo je možné v takých podmienkach urobiť pre zvýšenie rýchlosti?
Napríklad, aby sa predišlo serializácii kľúča v (2) – nad Hazelcast pripojiť ďalší cache pre najhorúcejšie dáta. Vo Sportmasteri zvolili na tento účel Caffeine.
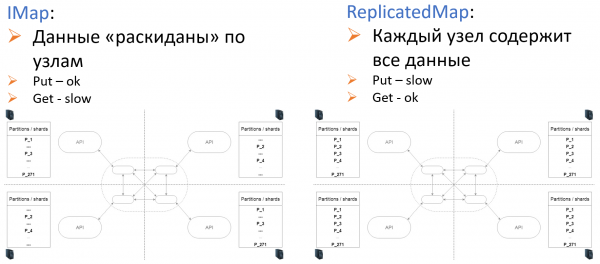
Pre nastavenie na úrovni (6) sú v Hz navrhnuté dva typy ukladania: IMap a ReplicatedMap.
Stojí za to povedať, ako sa Hazelcast dostal do technologického stacku Sportmasteru.
V roku 2012, keď sme pracovali na prvom pilote budúceho webu, práve Hazelcast sa ukázal ako prvý odkaz, ktorý vyhľadal vyhľadávač. Zoznámenie sa začalo "na prvý pokus" – zaujalo nás, že len dve hodiny po pripojení Hz do systému – fungoval. A fungoval dobre. Do konca dňa sme dopísali niekoľko testov, tešili sa. A táto rezerva entuziazmu stačila na prekonanie prekvapení, ktoré Hz prinášal časom. Teraz tímu Sportmasteru nie sú dôvody, aby sa vzdali Hazelcast.
Ale také argumenty, ako „prvý odkaz vo vyhľadávači“ a „rýchlo sme postavili HelloWorld“ – to je, samozrejme, výnimka a osobitosť momentu, v ktorom prebiehal výber. Skutočné skúšky pre vybraný systém začínajú s prechodom do produkcie, a tento aspekt je potrebné zohľadniť pri výbere akéhokoľvek systému, vrátane cache. V našom prípade sa vlastne dá povedať, že sme si Hazelcast vybrali náhodou, ale potom sa ukázalo, že sme vybrali správne.
Pre produkciu je veľmi dôležitejšie: monitorovanie, spracovanie zlyhaní na jednotlivých uzloch, replikácia dát, náklady na škálovanie. Teda je potrebné venovať pozornosť úlohám, ktoré vzniknú práve pri podpore systému – keď záťaž desiatky ráz prevýši plánovanú, keď náhodou pošleme niečo nesprávne a tam, keď bude potrebné nasadiť novú verziu kódu, nahradiť dáta a urobiť to nepozorovane pre klientov.
Pre všetky tieto požiadavky sa Hazelcast bezpochyby hodí.
Pokračovanie bude
Ale Hazelcast nie je všeliek. V roku 2017 sme si vybrali Hazelcast ako cache pre administráciu, jednoducho na základe pozitívneho dojmu z predchádzajúcej skúsenosti. To zohralo kľúčovú úlohu v veľmi nepríjemnej situácii, z ktorej sme sa "hrdinsky" dostávali 60 dní. O tom však v ďalšej časti.
A zatiaľ… Šťastný nový kód!
Zdroj: habr.com
