

Možnosti fungovania vnútorných mechanizmov PostgreSQL umožňujú, aby bol v niektorých situáciách veľmi rýchly a v iných „nie veľmi“. Dnes sa zameriame na klasický príklad konfliktu medzi tým, ako databázový systém funguje, a tým, čo s ním robí vývojár — UPDATE vs princípy MVCC.
Stručne na základe :
Keď sa riadok mení príkazom UPDATE, v skutočnosti sa vykonávajú dve operácie: DELETE a INSERT. V aktuálnej verzii riadku sa nastavuje xmax, rovný číslu transakcie, ktorá vykonala UPDATE. Potom sa vytvorí nová verzia téhož riadku; hodnota xmin na nej sa zhoduje s hodnotou xmax predchádzajúcej verzie.
Po nejakej dobe po ukončení tejto transakcie, stará alebo nová verzia, v závislosti od COMMIT/ROLLBACK, budú uznané „mŕtve“ (dead tuples) pri prechode VACUUM cez tabuľku a vyčistené.
Ale to sa nestane hneď, avšak problémy s "mŕtvolami" môžu veľmi rýchlo vzniknúť — pri opakovanom alebo vo veľkej tabuľke, a o chvíľu neskôr sa môžete stretnúť so situáciou, že aj .
#1: I Like To Move It
Predpokladajme, že vaša metóda v obchodnej logike funguje, a zrazu si uvedomí, že by bolo dobré aktualizovať pole X v nejakom zázname:
UPDATE tbl SET X = <newX> WHERE pk = $1;Potom, v priebehu vykonávania, zistí, že by sa malo aktualizovať aj pole Y:
UPDATE tbl SET Y = <newY> WHERE pk = $1;… a potom aj Z — prečo sa s tým šetriť?
UPDATE tbl SET Z = <newZ> WHERE pk = $1;Koľko verzií tohto záznamu teraz máme v databáze? Aha, 4 kusy! Z nich je jeden aktuálny a 3 budú musieť byť upratané za vás [auto]VACUUM.
Nerobte to takto! Použite aktualizáciu všetkých polí v jednom príkaze — takmer vždy je možné logiku práce metódy takto zmeniť:
UPDATE tbl SET X = <newX>, Y = <newY>, Z = <newZ> WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Takže, predsa len ste sa rozhodli (počas vykonávania skriptu alebo prevodníka, napríklad). A do skriptu ide niečo takéto:
UPDATE tbl SET X = <newX> WHERE pk BETWEEN $1 AND $2;Približne v takejto forme sa dopyt stretáva dosť často a takmer vždy nie na doplnenie prázdneho nového poľa, ale na opravu nejakých chýb v údajoch. Pri tom samotná správnosť už existujúcich údajov sa vôbec nezohľadňuje — a to je škoda! To znamená, že záznam sa prepíše, aj keď tam bolo presne to, čo ste chceli — a prečo? Opraviť to:
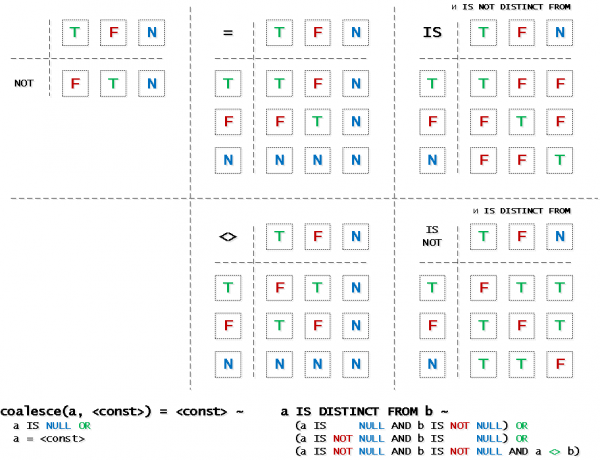
UPDATE tbl SET X = <newX> WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM <newX>; Mnohí nevedia o existencii takého úžasného operátora, preto tu je návod na IS DISTINCT FROM a ďalšie logické operátory na pomoc:
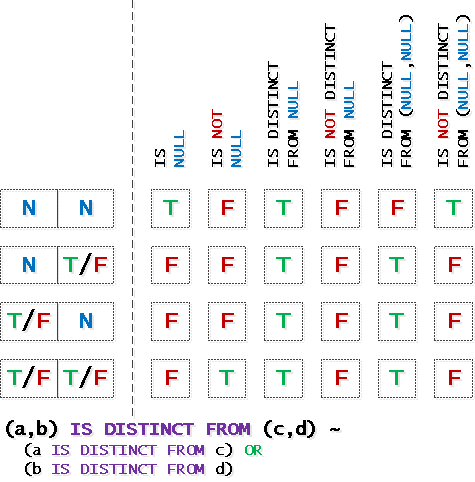
… a trochu o operáciách so zložitými ROW()-výrazmi:
#3: А я милого узнаю по… блокировке
Spúšťajú sa dva rovnaké paralelné procesy, pričom každý z nich sa snaží označiť záznam ako ‘v spracovaní’:
UPDATE tbl SET processing = TRUE WHERE pk = $1;Aj keď tieto procesy vykonávajú nezávislé úlohy, v rámci jedného ID sa v tomto požiadavku druhý klient ‘uzamkne’, kým sa neskončí prvá transakcia.
Riešenie č. 1: úloha sa zredukuje na predchádzajúcu
Jednoducho znova pridáme IS DISTINCT FROM:
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE;V tejto forme druhý požiadavok jednoducho nič nezmení v databáze, je tam už ‘všetko, ako má byť’ – preto nedôjde k uzamknutiu. Ďalej fakt ‘nenájdenia’ záznamu už spracovávame v aplikačnom algoritme.
Riešenie č. 2: poradenské zámky
Veľká téma na samostatný článok, v ktorom sa dá prečítať o .
Riešenie č. 3: bez[č]udné výzvy
A teraz by ste mali skutočne mať súčasnú prácu s jedným a tým istým záznamom? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Zdroj: habr.com
