

Volám sa Juraj, som vedúci tímu systémovej administrácie v Sitimobil. Dnes sa podelím o skúsenosti s technológiou tenkého rezervovania (thin provisioning) súborových systémov Linux a poviem, ako ju môžeme aplikovať v technologických CI/CD procesoch spoločnosti. Rozoberieme situáciu, keď pre automatické testovanie kódu pri dodávke do produkcie potrebujeme čo najrýchlejšie kópie databáz MySQL, čo najbližšie k „produkčnej“ verzii, dostupné na čítanie aj zápis.
Úvod: Prečo dávať škodlivé rady?
Logická otázka, veď existujú vypracované mechanizmy migrácie schém databáz do testovacích prostredí. Prečo vôbec privádzať hlavnú nešardovanú DBMS do takých objemov? A na testovanie nie sú potrebné všetky údaje. Pokúsim sa vysvetliť.
Približne pred rokom, na pozadí aktívneho rastu našej taxi agregátora (v roku 2018 sme vzrástli približne 15-násobne podľa dokončených jázd), sa zvýšili objemy dát, záťaž na serveroch, frekvencia nasadzovania. Ocitli sme sa v nasledujúcej situácii:
- Hlavná databáza MySQL sa zvýšila na približne 1000 tabuliek s celkovým objemom 2,5 TB a naďalej rástla.
- Nebolo možné rýchlo zašardovať a rozdeliť databázu. To neumožnil starý prístup „napíšem do databázy, čo chcem a ako chcem“, množstvo JOINov a vnútorných závislostí tabuliek.
- Nebolo mechanizmu migrácií schémy databázy do testovacích prostredí.
- Nebolo automatizované testovanie kódu pri nasadení do prevádzky.
Posledný problém sme chceli vyriešiť čo najrýchlejšie. Už boli napísané testy Postman na kontrolu hlavného PHP monolitu, ale chýbala aktuálna databáza. Zároveň sme nemohli vytvárať repliky v noci, robiť z nej primárnu a dávať ju do prevádzky cez deň: veľmi veľké množstvo nasadení a zmien, vrátane v údajoch a schéme databázy, by urobilo stánok nefunkčným už v polovici dňa. A obmedziť nasadenia len na pracovný deň by bolo neefektívne.
Napriek tomu bola úloha splnená: prvý funkčný stánok sme získali už za dva týždne. Po uplynulom roku prešiel mnohými zmenami a naďalej sa používa.
Ďalej podrobne opíšem všetky kroky a fázy vývoja našej činnosti. Uvidíte, že táto metóda si zaslúži existenciu.
Čo je to „tenké rezervovanie“?
Toto je hardvérová alebo softvérová technológia (známa aj ako sparse volumes), ktorá umožňuje priradiť viac požadovaných zdrojov, než sú k dispozícii. Priradený objem by mal spĺňať kritériá just-enough (len toľko, koľko potrebujeme) a just-in-time (v potrebnom čase). Hlavne sa tenké rezervovanie používa v rôznych SYSTÉMOCH ÚLOŽISKA, aby sa poskytoval diskový priestor v požadovaných objemoch, ktoré prekračujú skutočne dostupné. Technológia je podporovaná rôznymi súborovými systémami, ako sú LVM2, ZFS, BTRFS. Je široko používaná v hypervízoroch virtualizácie. Tenké rezervovanie nám umožnilo rýchlo vytvoriť z snapshotov hlavného oddielu s dátami toľko kópií tohto oddielu, koľko potrebujeme (data adresár DB MySQL).
Prvý stánok, technológia Thin LVM
Túto kapitolu môžeme nazvať aj „Ako vytvoriť maximálne rýchle snímky veľkých objemov údajov pomocou , znížením stability súborového systému a DB MySQL na neprijateľné úrovne“.
Keďže sme už používali LVM na vytváranie hlavných oddielov OS, rozhodli sme sa začať práve s ňou. Najprv sme potrebovali samostatný fyzický stroj — replikáciu našej hlavnej databázy MySQL, na ktorom by sme mohli na požiadanie vytvárať snapshot repliky a spustiť ho vedľa ako samostatný inštanciu MySQL. Počas testovania sme povolili použitie zmien v tejto inštancii a po dokončení testov sme ju úspešne odstránili. Konfigurácia servera bola nasledovná:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD v RAID ovládači Adaptec v RAID-10
O výbere medzi RAID ovládačom a softvérovým RAID MD by sa dala napísať samostatná téma. Povieme len, že našu voľbu ovplyvnili dva faktory:
- V čase definovania úlohy sme na všetkých DB inštalovali na RAID ovládače, takže sa dá povedať, že to historicky vyšlo takto.
- Rozdiel vo výkonnosti v syntetických testoch súborového systému a testoch s rôznymi operáciami v MySQL bol minimálny.
Rozdelili sme výsledný RAID-10: vytvorili sme jednotnú Volume Group (VG) na celý objem (s nákladmi približne 6,7 GB) a vytvorili sme logickú partition (Logical Volume, LV) pod systém na 50 GB. V bežnej situácii by sme celé ostatné miesto určovali pod oddiel s MySQL. Ale potrebovali sme tenké zálohovanie, preto sme najprv vytvorili takzvaný pool, v rámci ktorého sme vytvorili oddiel pod /var/lib/mysql s objemom 3,5 TB (na základe predpokladaných objemov databázy):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Naformátovali sme oddiel do ext4, pripojili sme ho, uložili replikáciu a získali pôvodný systém. Potom sme vytvorili API vrstvu, ktorá má vytvárať snapshoty, spúšťať inštanciu databázy MySQL na stanovenom porte a odstraňovať vytvorenú inštanciu. Keďže sa pri tom používajú výlučne systémové volania, ako jazyk písania skriptov sme zvolili obyčajný bash, a ako prepojenie API HTTP → bash sme rozvinuli open source riešenie. , napísané v Go.
Niekedy zverejníme naše bash skripty v open source, ale zatiaľ jednoducho popíšem základný algoritmus:
Vytvorenie hlavného snapshotu snapmain:
- Zastavujeme hlavnú replikáciu.
- Umiestňujeme zámku na operácie so snapshotom snapmain.
- Vytvárame nový snapshot snapmain.
- Spúšťame MySQL a odstraňujeme zámku.
Vytvorenie databázy na ľubovoľnom porte zo snapmain:
- Umiestňujeme zámku na konkrétnu inštanciu databázy (port).
- Kontrolujeme prítomnosť zámky vytvorenia hlavného snapshotu. Ak existuje, čakáme a overujeme každých 5 sekúnd.
- Kontrolujeme, či existuje starý LV oddiel inštancie.
3.1 Ak áno, zastavujeme pomocou kill -9 inštanciu MySQL a odstraňujeme LV oddiel. - Vytvárame z snapmain novú inštanciu.
- Pripravujeme a montujeme adresáre pre túto inštanciu.
- Zbavujeme sa znakov sláva (súborov) a spúšťame inštanciu MySQL.
- Robíme z nej master.
- Odstraňujeme zámku.
Odstránenie databázy na ľubovoľnom porte:
- Umiestňujeme zámku na konkrétnu inštanciu databázy (port).
- Zabíjame inštanciu MySQL pomocou kill -9.
- Odmountujeme adresáre.
- Odstraňujeme LV oddiel a odstraňujeme zámku.
Príklad príkazov na klonovanie oddielov novej inštancie databázy:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Teraz vám poviem o hlavných problémoch, s ktorými sme sa stretli pri používaní tenkého rezervovania. Narazili sme na výkonnosť SSD diskov. K tomu došlo kvôli špecifikám Thin LVM: v podstate pracuje na úrovni zariadenia s nízkoúrovňovými blokmi veľkosti predvolene 4 MB. Ako to vyzeralo:
- Vytvárame snímku z hlavného oddielu /var/lib/mysql.
- Spúšťame replikáciu, aby sme dobehli majstra.
- Akákoľvek zmena v tabuľkách repliky vyžaduje uchovanie starých, nezmenených blokov dát v oddiele snímky.
- Akákoľvek zmena v spustenom testovacom instance vyžaduje uchovanie starých, nezmenených blokov dát v oddiele sklonenej snímky pre túto inštanciu.
- Sme na 100% vyťažení vstupno-výstupných operácií na zariadení, čo spomaľuje akékoľvek operácie a vedie k postupnému zaostávaniu repliky.
- Na konci pracovného dňa máme zaostávajúci stand o niekoľko hodín.
Ako sme sa s týmto vysporiadali, aby sme dosiahli rozumnejší výsledok (hlavné body):
RAID kontrolér:
- Deaktivovali sme všetky druhy cachovania predvolene.
- Nastavili sme writeback (keď sú dáta v cache, zápis sa dokončí skôr, než je skutočne uložený na disk).
Súborový systém:
- Na mount point /var/lib/mysql sme uviedli noatime,nodiratime,data=writeback
- Deaktivovali sme journaling ext4 pomocou tune2fs.
MySQL:
- Uvedli sme innodb_flush_method = O_DSYNC (zvýšili sme rýchlosť zápisu, čím sme znížili spoľahlivosť).
- Deaktivovali sme journaling, logy nie sú potrebné.
- Uvedli sme innodb_buffer_pool_size = 4G (čím menšia je veľkosť InnoDB poolu, tým rýchlejšie sa MySQL zastaví pri vypnutí, a tým rýchlejšie vytvoríme snímku).
Toto rozhodne nie je úplný zoznam, najmä pokiaľ ide o MySQL. Avšak, ďalšie zmeny sú minoritné a často sú aplikovateľné nie vždy a nie presne. Napríklad, v snahe odľahčiť disky sme dokonca presunuli innodb_parallel_doublewrite_path do /dev/shm, čo v niektorých prípadoch pri štarte nesprávne ukončenej inštancie šetrilo až 5 sekúnd.
Prečo zastavujeme MySQL pred vytvorením snímky? Veď môžeme urobiť snímku z pracujúcej repliky. Je to pravda, lenže nová inštancia DB na tejto snímke bude predvolene považovaná za poškodenú a pri spustení si bude vyžadovať úplné skenovanie. Zastaviť replikáciu je určite rýchlejšie, aj keď to nakoniec predstavuje najdlhšiu operáciu v celom procese.
Nakoniec sme získali prijateľnejšie časovanie a funkčný stánok. Aj keď, ako ukazuje najpresvedčivejší graf oneskorenia hlavnej repliky, situácia je stále ďaleko od ideálu:
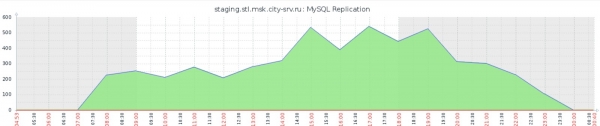
Medzi ďalšími nevýhodami stojí za zmienku takmer nemožnosť monitorovania poolu Thin LVM: okrem systémových štandardných funkcií iostat nie je možné zistiť, ktorý prvok poolu v súčasnosti vytvára najväčšiu záťaž na súborový systém.
Osobitne treba zdôrazniť jednu veľkú nevýhodu spojenú s vyššie popísanou optimalizáciou: vytvorili sme YOLO-stánok. Približne raz za jeden až dva mesiace ext4 nezvládala takéto zneužívanie a beznádejne sa rozpadla, čo si vyžadovalo jej přeformátovanie a opnieuw nahrávanie repliky. Získali sme rýchlosť, ale beznádejne sme zničili stabilitu.
Na aké metriky sa treba sústrediť pri prevádzke Thin LVM:
- Percento údajov v tenkom poole
- Percento metadát v tenkom poole
Ak náš stánok prežije skončené miesto pre údaje (stačí vyčistiť disky), skončené miesto pre metadáta povedie k úplnému kolapsu poolu a potrebe jeho opätovného vytvorenia od nuly.
Súborový systém vnútri poolu sa časom veľmi fragmentuje. Odporúčam každých 24 hodín spustiť cez cron príkaz fstrim -v /var/lib/mysql.
Medzi výsledkami:
- Technológia sa dá ľahko aplikovať, rovnako ako samotný LVM, a nevyžaduje špeciálne kvalifikácie inžiniera.
- Bude to dobre fungovať pre malé databázy a menej zaťažené. Čím menšia je databáza, tým menej položiek sa presúva cez súborový systém vnútri poolu, a tým nižšia je záťaž na disky.
- Pre našu úlohu sme začali hľadať iné riešenia, o ktorých sa bude hovoriť v nasledujúcej kapitole.
Druhý stánok, technológia ZFS
Pred mnohými rokmi som mal skúsenosti so súborovým systémom ZFS, ale vtedy ZFS skutočne dobre fungovala na svojom rodnom operačnom systéme Solaris. Existovala portovaná verzia na FreeBSD s celkom dobrým úrovňou implementácie. Bol tu aj nedokončený port na Linux, ktorý málokto používal. Vzhľadom na štruktúru ukladania dát typu B-tree (mimochodom, rovnakú štruktúru ukladania má aj InnoDB MySQL) sa ZFS málo osvedčila na inštaláciách s veľmi veľkým počtom súborov. To všetko spolu s potrebou naučiť sa technológie na dlhú dobu vyškrtlo tento súborový systém z mojej praxe. Objavili sa ext4 a xfs, ktoré sa stali štandardom. Ale vzhľadom na to, že ZFS v našom prípade vyhovuje viac než dostatočne, a aj verzia pre Linux, súdiac podľa recenzií, sa vyvinula na celkom rozumný produkt (hoci nie je plne podporovaná, čo znamená, že systém na ZFS je možné nastaviť úplne od začiatku len s rôznymi čarami), rozhodli sme sa to vyskúšať.
Z pochopiteľných dôvodov sme zvolili stojan s rovnakou konfiguráciou (s výnimkou RAID ovládača). Nainštalovali sme osem SSD diskov s kapacitou 1920 GB. Nebol záujem vytvárať vlastný sieťový obraz na inštaláciu servera na holú ZFS, preto sme odobrali 50 GB z každého disku a vytvorili na nich MD RAID-10 pre systém. Zvyšných 1950 GB na každom disku sme spojili do analógu ZFS RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Vytvorili sme oddiely pre MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Všimnite si, že sme zapli štandardné gzip kompresiu dát. Naše serverové procesorové zdroje sú veľmi silné a nie sú úplne využité. V dôsledku toho sa 3 TB našich databáz premenili na 1,6 TB, a pretože najslabším článkom, ako aj v minulom prípade, je maximálny výkon diskov, čím menej dát — tým lepšie, hneď od začiatku získavame skvelý bonus zo ZFS! V špičke, pri plnom zaťažení, má gzip na údržbu využiť až 4 jadrá, ale nám to neprekáža.
Ďalej implementácia pokračovala rýchlejšie. Bez problémov sme preniesli nastavenia repliky MySQL z LVM stojana. Museli sme stráviť určitý čas prepisovaním skriptov na príkazy ZFS, ale vo všeobecnosti zostali algoritmy rovnaké. Príklad vytvorenia snapshotu:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
Z ďalšieho ladění: vyčlenili sme v pamäti ZFS oddiely s metadátami a logmi l2arc a zil. Pre našu úlohu sa ukázalo, že to bolo nadmerné, ale zatiaľ sme túto optimalizáciu zachovali, v prípade potreby sa ľahko zmení. Z negatívnych efektov — po reštartovaní servera sa musia príslušné oblasti pamäte znovu vytvoriť. Výňatok z zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
V takejto konfigurácii sme začali testovať stánok a dosiahli sme skvelé výsledky: so dvoma súčasne pracujúcimi inštanciami DB (a aktívnou hlavnou replikou) na snímkach sme dosiahli zaťaženie diskov 50-60 %.
Osvojili sme si našu hlavnú problematiku, čo je vidno v grafe zdržania replikácie (porovnajte s predchádzajúcim grafom v sekcii Thin LVM):
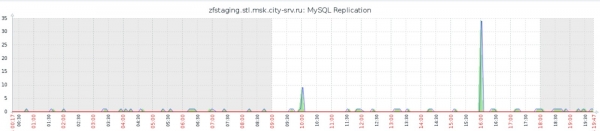
Okrem a vďaka tomu sme sa značne zrychlili vo všetkých operáciách: úplné vytvorenie snímku s zastavením a spustením repliky trvá až 40 sekúnd, nasadenie z snímku novej inštancie MySQL trvá až 20 sekúnd. To viac ako vyhovuje nám aj našim testom softvérového kódu.
Medzi výsledkami:
- Výsledky úplne uspokojili našu potrebu získať kópiu ostrého DB pre testovanie kódu.
- Technológia si vyžaduje vstup: treba pochopiť, čo je ZFS a ako s ňou pracovať.
- Nepreskúmali sme aktuálny stav fungovania ZFS s veľkým množstvom (od 1 milióna) malých súborov. Ale predpokladáme, že problém pretrváva, preto by som túto súborový systém neodporúčal pre akékoľvek úložiská súborov.
Čo ďalej?
V rámci stánku robiť viac nič, výsledok nás uspokojuje. Možno sa neskôr pridáme do nastavenia replikácie stánku výnimky tabuliek, ktoré nie sú potrebné na testovanie, to ešte viac skráti objem DB. Testovali sme systém BTRFS a jeho implementáciu technológie tenkého zálohovania. Napriek tomu, taká úloha už nestojí, keďže hlavný cieľ bol dosiahnutý. V celku, samozrejme, by sme chceli opustiť vyššie opísaný prístup — implementovať funkčné migrácie DB do testovacieho prostredia, vytvoriť samostatnú testovaciu líniu DB, venovať sa shardovaniu hlavnej databázy. Mnohé z tohto už realizujeme, o čom sa určite dozviete v budúcich článkoch.
Zhrnutie
Prvotná úloha bola vyriešená, aj keď nezvyčajným spôsobom. V medzi výsledkoch boli opísané výhody a nevýhody každej z použitých technológií, preto sa poďme rozhodnúť, ktorú technológiu a kedy môžeme použiť:
- Thin LVM — na malých DB a keď sa nechce alebo nie je čas študovať ZFS.
- ZFS — ak máte skúsenosti s prácou s ňou alebo možnosť stráviť čas na štúdium v akýchkoľvek situáciách.
Na vyššej úrovni predstavovania je tento článok — nie len porovnanie technológie dvoch súborových systémov. Hlavná myšlienka, ktorú by som chcel predložiť a upevniť, spočíva v tom, že sa netreba báť myslieť netradične v situáciách kritických pre biznis, a brať len hotové recepty. Kedysi sme mohli všetkým technickým oddelením pokrútiť hlavou a povedať, že úloha vytvorenia trojterabajtových kópií DB za menej ako minútu je nevykonateľná, a nepotrebujeme riskantné technológie, poďme to urobiť tak, ako sa má. Bolo by to možné, ale prišli by sme približne o pol roka až rok a mnoho ciest klientov (cesty — náš hlavný obchodný ukazovateľ) bez testov a počas implementácie. Neštandardným postupom sme stratili nie tak veľa času na implementáciu, získali sme skúsenosti s novými a zabudnutými starými technológiami a poskytli sme testovanie práve v tom okamihu, keď sme to veľmi potrebovali. Nezameniteľne to pozitívne ovplyvnilo všetky naše ukazovatele. Výber je vždy na vás, a my z našej strany budeme pokračovať v rozprávaní na našom blogu o zaujímavých aktuálnych a budúcich úspechoch.
Zdroj: habr.com
