

Kanárik je malý vták, ktorý neustále spieva. Títo vtáci sú citliví na metán a oxid uhoľnatý. Už aj pri malej koncentrácii nadbytočných plynov vo vzduchu strácajú vedomie alebo umierajú. Hľadači zlata a baníci brávali vtáčiky so sebou: pokiaľ kanáriky spievajú, môžu pracovať, ak mlčia — v bani je plyn a je čas odísť. Baníci obetovali malú vtáčik, aby sa dostali z baní živí.
Podobná prax sa uplatňuje aj v IT. Napríklad pri štandardnej úlohe nasadenia novej verzie služby alebo aplikácie na produkciu s predchádzajúcim testovaním. Testovacie prostredie môže byť príliš drahé, automatizované testy nepokrývajú všetko, čo by sme chceli, a nenasadzovať a riskovať kvalitu je nebezpečné. V takýchto prípadoch pomáha prístup Canary Deployment, pri ktorom sa malé množstvo skutočného produkčného trafiku pustí na novú verziu. Tento prístup pomáha bezpečne overiť novú verziu na produkciu, obetujúc málo pre veľký cieľ. Podrobnejšie, ako funguje tento prístup, čím je užitočný a ako ho realizovať, povie Andrej Markelov (), na príklade realizácie vo firme Infobip.
Andrej Markelov — vedúci inžinier-programátor v Infobip, už 11 rokov sa zaoberá vývojom aplikácií v Jave v oblasti financií a telekomunikácií. Vyvíja Open Source produkty, aktívne sa podieľa na Atlassian Community a píše pluginy pre produkty Atlassian. Evangelista Prometheus, Docker a Redis.
O spoločnosti Infobip
Je to globálna telekomunikačná platforma, ktorá umožňuje bankám, maloobchodu, internetovým obchodom a dopravným spoločnostiam posielať správy svojim klientom pomocou SMS, push, e-mailov a hlasových správ. V takomto biznise je dôležitá stabilita a spoľahlivosť, aby klienti dostávali správy včas.
IT infraštruktúra Infobip v číslach:
- 15 dátových centier po celom svete;
- 500 unikátnych služieb v prevádzke;
- 2500 exemplárov služieb, čo je omnoho viac ako tímov;
- 4,5 TB mesačného trafiku;
- 4,5 miliardy telefónnych čísel;
Biznis rastie a s ním aj počet vydaní. Robíme 60 vydaní denne, pretože klienti chcú viac funkcií a možností. Ale je to zložité — služieb je veľa a tímov málo. Musíme rýchlo písať kód, ktorý musí fungovať na produkcii bez chýb.
Vydania
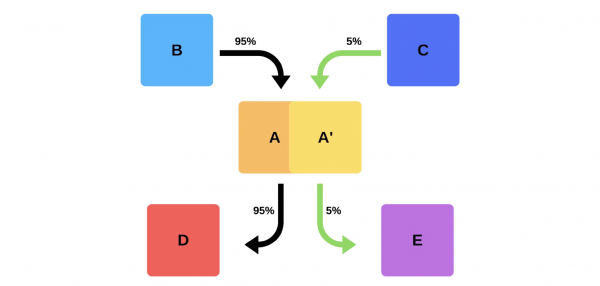
Typický release u nás prebieha takto. Napríklad existujú služby A, B, C, D a E, z ktorých každú vyvíja samostatný tím.
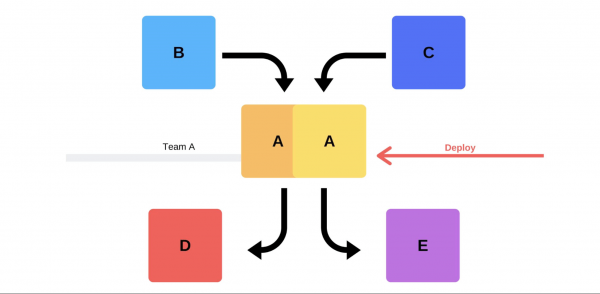
V istom momente tím služby A sa rozhodne nasadiť novú verziu, ale tímy služieb B, C, D a E o tom nevedia. Tím služby A má dve možnosti.
Uskutoční inkrementálny release: najprv nahradí jednu verziu a potom druhú.
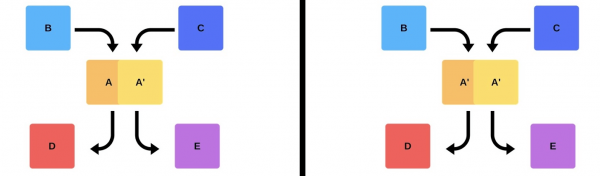
Ale je tu druhá možnosť: tím nájde dodatočné zdroje a stroje, nasadí novú verziu a potom prehne router, takže verzia začne fungovať v produkcii.
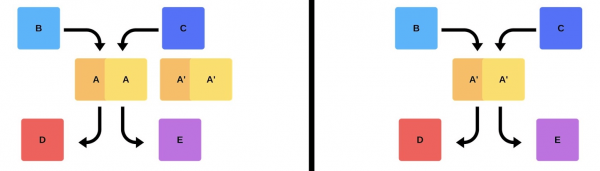
V každom prípade po nasadení takmer vždy vznikajú problémy, aj keď bola verzia otestovaná. Testovať sa dá ručne, automaticky alebo sa nemusí testovať — problémy vzniknú tak či onak. Najjednoduchší a správny spôsob, ako ich vyriešiť, je vrátiť sa späť k funkčnej verzii. Až potom sa môže riešiť škoda, príčiny a ich náprava.
Takže, čo chceme?
Problémy nepotrebujeme. Ak si ich klienti odhalia rýchlejšie ako my, poškodí to našu povesť. Preto musíme nájsť problémy rýchlejšie ako klienti.Prácou na predchádzanie škodám minimalizujeme.
Zároveň chceme urychliť nasadenie, aby sa to dialo rýchlo, jednoducho, prirodzene a bez napätia zo strany tímu. Inžinierov, DevOps inžinierov a programátorov treba chrániť — release novej verzie je stres. Tím nie je spotrebný materiál, snažíme sa racionálne využívať ľudské zdroje..
Problémy s nasadením
Klientský traffic je nepredvídateľný.Nedá sa predpovedať, kedy bude klientský traffic minimálny. Nevieme, kde a kedy klienti začnú svoje kampane — možno dnes v noci v Indii, a zajtra v Hongkongu. Zohľadňujúc veľký časový rozdiel, nasadenie aj o 2 hodine ráno nezaručuje, že klienti nebudú postihnutí.
Problémy s poskytovateľmi.Messengery a poskytovatelia sú naši partneri. Niekedy sa im môžu vyskytnúť výpadky, ktoré spôsobujú chyby počas nasadenia nových verzií.
Rozdelené tímy.Tímy, ktoré vyvíjajú klientskú časť a backend, sa nachádzajú v rôznych časových pásmach. Z tohto dôvodu sa často nemôžu dohodnúť.
Dátové centrá sa nedajú replikovať na stagingu.V jednom dátovom centre je 200 rackov — replikovať to v pieskovisku ani približne nie je možné.
Downtimeis unacceptable! We have an acceptable availability level (Error Budget) when we operate 99.99% of the time, for example, and the remaining percentage is our 'margin for error'. Achieving 100% reliability is impossible, but it is important to constantly monitor for outages and downtime.
Classic solutions
Writing code without bugs. When I was a young developer, managers would approach me asking for a bug-free release, but that is not always possible.
Writing tests. Tests work, but sometimes not in the way the business wants. Making money is not the job of tests.
Testing on stage. In my 3.5 years at Infobip, I never saw the stage environment even partially matching production.
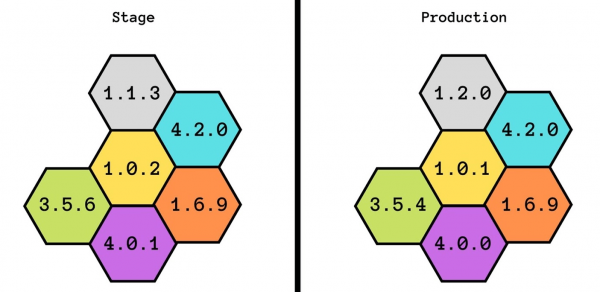
We even tried to develop this idea: first we had a stage, then a pre-production, and then a pre-pre-production. But that didn't help either — they didn't match even in performance. With the stage, we can guarantee basic functionality, but we do not know how it will perform under load.
The release is done by the one who developed it. This is a good practice: even if someone changes the comment title, they immediately add it to production. This helps build accountability and keeps track of changes made.
There are also additional complexities. For a developer, it's stressful to spend a lot of time checking everything manually.
Coordinated releases. This option is usually suggested by management: 'Let's agree that you will test and add new versions every day.' This doesn't work: there is always a team waiting for everyone else or vice versa.
Smoke tests
Another way to solve our deployment problems. Let's consider how smoke tests work using the previous example when Team A wants to deploy a new version.
First, the team deploys one instance to production. Messages in the instance simulate real traffic, so that it matches normal daily traffic. If everything is fine, the team switches the new version to user traffic.
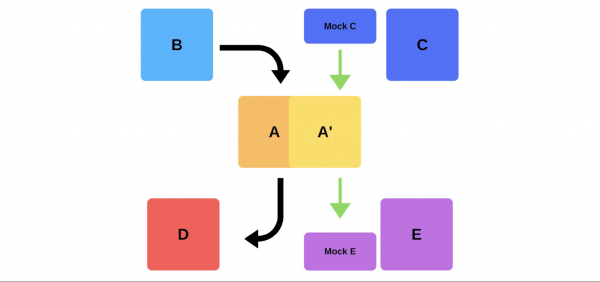
The second option is to deploy with additional hardware. The team tests it in production, then switches it, and everything works.
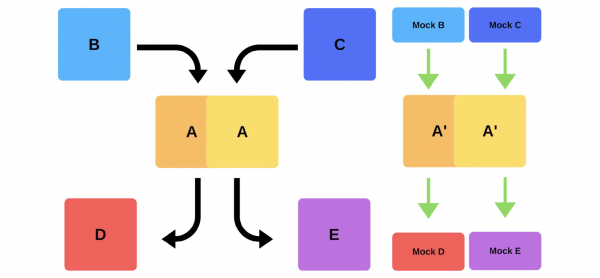
Disadvantages of smoke tests:
- Testom sa nedá dôverovať. Kde získať rovnaký traffic ako na produkcii? Môžeme použiť včerajší alebo týždenný, ale nie vždy sa zhoduje so súčasným.
- Ťažko sa udržiava. Bude potrebné udržiavať testovacie účty, neustále ich resetovať pred každým nasadením, keď sa do úložiska odosielajú aktívne záznamy. Je to zložitejšie, ako napísať test vo svojom pieskovisku.
Jediným bonusom tu je — môžeme overiť výkon.
Canary releasy
Kvôli nedostatkom smoke-testov sme začali používať canary releasy.
Práca podobná tomu, ako baníci používali kanáriky na indikáciu úrovne plynov, sa uplatnila aj v IT. Posielame trochu skutočného produkčného trafficu na novú verziu, pričom sa snažíme dodržať Service Level Agreement (SLA). SLA je naše "právo na chybu", ktoré môžeme využiť raz ročne (alebo v nejakom inom časovom rámci). Ak všetko pôjde dobre, pridáme viac trafficu. Ak nie — vrátime predchádzajúce verzie.
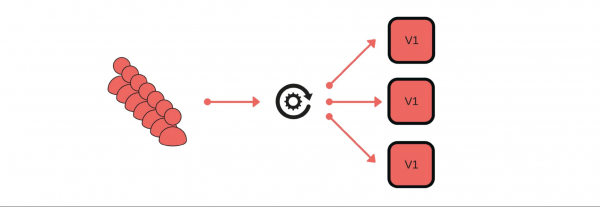
Implementácia a nuansy
Ako sme realizovali canary releasy? Napríklad, skupina zákazníkov posiela správy cez našu službu.
Nasadenie prebieha takto: odstránime jeden uzol z load balancera (1), zmeníme verziu (2) a samostatne pustíme trochu trafficu (3).
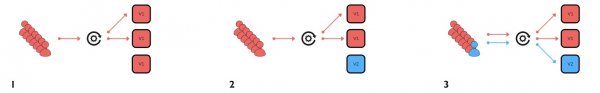
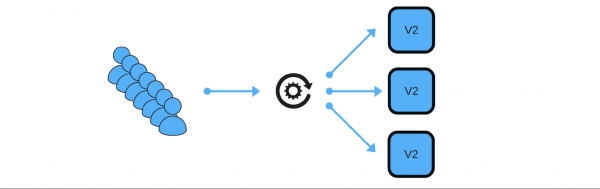
Celkovo, v skupine budú všetci šťastní, aj keď jeden používateľ bude nespokojný. Ak bude všetko v poriadku — zmeníme všetky verzie.
Ukážem schematicky, ako to vyzerá pre mikroservisy vo väčšine prípadov.
Existuje Service Discovery a ešte dva servery: S1N1 a S2. Prvý server (S1N1) upozorňuje Service Discovery, keď sa spúšťa, a Service Discovery si ho zapamätá. Druhý server s dvoma uzlami (S2N1 a S2N2) tiež upozorňuje Service Discovery pri štarte.
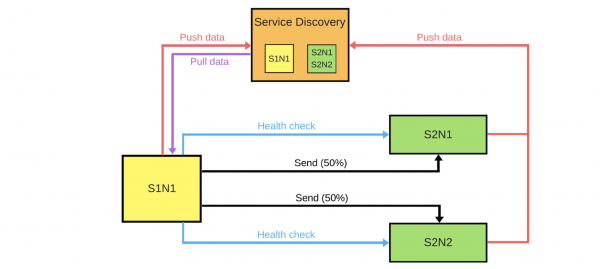
Druhý server pre prvý funguje ako server. Prvý žiada od Service Discovery informácie o svojich serveroch a keď ich dostane — hľadá a kontroluje ich ("health check"). Keď ich skontroluje, pošle im správy.
Keď niekto chce nasadiť novú verziu druhého servera, oznámi Service Discovery, že druhý uzol bude canary uzlom: na neho sa bude posielať menej trafficu, pretože teraz prebieha nasadenie. Odstránime canary uzol z load balancera a prvý server mu neposiela traffic.
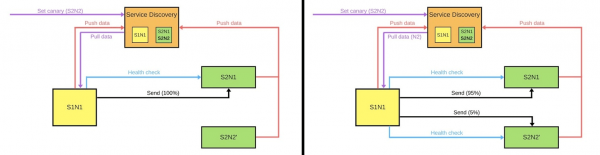
Meníme verziu a Service Discovery vie, že druhý uzol je teraz canary - môžeme mu prideliť menej záťaže (5%). Ak je všetko v poriadku, meníme verziu, vraciame zaťaženie a pokračujeme ďalej.
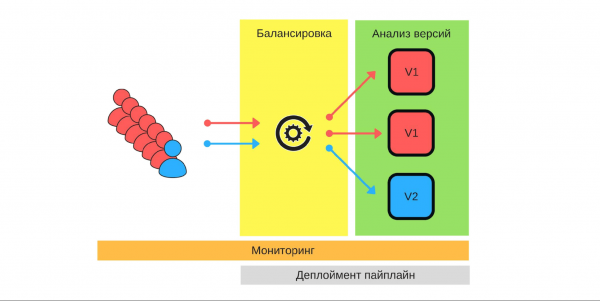
Na realizáciu tohto všetkého potrebujeme:
- vyvažovanie;
- monitorovanie, pretože je dôležité vedieť, čo očakáva každý používateľ a ako detailne fungujú naše služby;
- analýzu verzií, aby sme chápali, ako dobre bude nová verzia fungovať v produkcii;
- automatizáciu — píšeme sekvenciu nasadenia (deployment pipeline).
Vyvažovanie
To je prvé, nad čím by sme mali uvažovať. Existujú dve stratégie vyvažovania.
Najjednoduchšia varianta, keď jeden uzol je vždy canary. Tento uzol vždy dostáva menej prevádzky a začíname nasadenie od neho. V prípade problémov porovnáme jeho výkonnosť pred nasadením a počas neho. Napríklad, ak sa počet chýb zvýšil dvojnásobne, znamená to, že aj škoda sa zvýšila dvojnásobne.
Canary-uzol sa určuje v procese nasadenia. Keď sa nasadenie dokončí a odstránime z neho status canary-uzla, vyváženie prevádzky sa obnoví. S menším počtom strojov dostaneme férové rozdelenie.
Monitorovanie
Kameň úrazu canary-releasov. Musíme presne chápať, prečo to robíme a aké metriky chceme zbierať.
Príklady metrik, ktoré zbierame z našich služieb.
- Počet chýb, ktoré sa zapisujú do logov. To je očividný ukazovateľ toho, že všetko funguje, ako má. Vo všeobecnosti je to dobrá metrika.
- Čas spracovania požiadaviek (latency). Túto metriku sledujú všetci, pretože všetci chcú pracovať rýchlo.
- Veľkosť fronty (throughput).
- Počet úspešných odpovedí za sekundu.
- Čas spracovania 95% všetkých požiadaviek.
- Obchodné metriky: koľko peňazí podnik zarába za určité časové obdobie alebo odliv používateľov. Tieto metriky pre našu novú verziu môžu byť dôležitejšie ako tie, ktoré pridávajú inžinieri.
Príklady metrik vo väčšine populárnych systémov monitorovania.
Counter. Toto je nejaká rastúca hodnota, napríklad počet chýb. Túto metriku je jednoduché interpolovať a sledovať graf: včera bolo 2 chyby, a dnes 500, znamená to, že niečo sa pokazilo.
Počet chýb za minútu alebo sekundu je najdôležitejší ukazovateľ, ktorý možno vypočítať pomocou Counter. Tieto dáta poskytujú jasný prehľad o fungovaní systému na diaľku. Pozrime sa na príklad grafu počtu chýb za sekundu pre dve verzie produkčného systému.
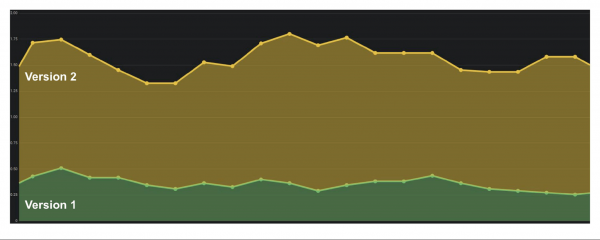
V prvej verzii bolo málo chýb, možno nefungoval audit. V druhej verzii je to oveľa horšie. Môžeme presne povedať, že sú nejaké problémy, preto musíme túto verziu vrátiť späť.
Gauge. Metrix sú podobné ako Counter, ale zapisujeme hodnoty, ktoré sa môžu zvyšovať aj znižovať. Napríklad čas vykonania dotazov alebo veľkosť fronty.
Na grafe je príklad doby odozvy (latency). Na grafe je viditeľné, že verzie sú podobné, s nimi sa dá pracovať. Ale ak sa pozriete pozorne, je zrejmé, ako sa veľkosť mení. Ak sa čas vykonania dotazov zvyšuje pri pridávaní používateľov, je okamžite jasné, že sú tu problémy — predtým tomu tak nebolo.
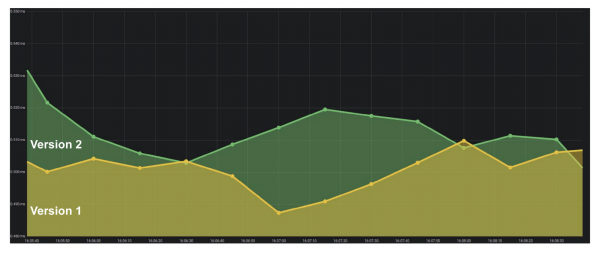
Summary. Jedným z najdôležitejších ukazovateľov pre podnikanie sú percentily. Metrix ukazuje, že v 95% prípadoch náš systém funguje tak, ako chceme. Môžeme sa zmieriť s tým, ak sú niekde problémy, pretože rozumieme celkovému trendu, ako na tom sme.
Nástroje
ELK Stack. Realizáciu canary je možné dosiahnuť použitím Elasticsearch — zapisujeme do neho chyby, keď sa vyskytujú udalosti. Pomocou najjednoduchšieho volania API môžeme získať počet chýb v akomkoľvek okamihu a porovnať ich s predchádzajúcimi úsekmi: GET /applg/_cunt?q=level:errr.
Prometheus. Dobre sa osvedčil v Infobip. Umožňuje implementovať mnohorozmerné metriky, pretože sa používajú štítky.
Môžeme použiť level, instance, service, kombinovať ich v jednom systéme. Pomocou offset môžeme napríklad získať hodnotu veľkosti spred jedného týždňa jedným príkazom GET /api/v1/query?query={query}, kde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analýza verzií
Existuje niekoľko stratégií analýzy verzií.
Sledovanie metrík len canary-nody. Jedným z najjednoduchších variantov: nasadili sme novú verziu a skúmame iba jej fungovanie. Ale ak inžinier v tom čase začne skúmať logy, neustále nervózne refreshujúci stránky, toto riešenie sa ničím nelíši od ostatných.
Canary-noda sa porovnáva s akoukoľvek inou nodou.Toto porovnanie s inými inštanciami, ktoré fungujú s plnou prevádzkou. Napríklad, ak sa s malým prenosom darí horšie alebo sa to nezhoduje s reálnymi inštanciami, niečo nie je v poriadku.
Canary uzol sa porovnáva sám so sebou v minulosti. Uzly vyhradené pre canary možno porovnať s historickými údajmi. Napríklad, ak to pred týždňom išlo dobre, môžeme sa na tieto dáta orientovať, aby sme pochopili aktuálnu situáciu.
Automatizácia
Chceme oslobodiť inžinierov od manuálneho porovnávania, a preto je dôležité implementovať automatizáciu. Proces nasadenia obvykle vyzerá takto:
- začíname;
- odstránime uzol z vyváženia;
- nainštalujeme canary uzol;
- spustíme vyvažovač s obmedzeným množstvom prenosu;
- porovnáme.
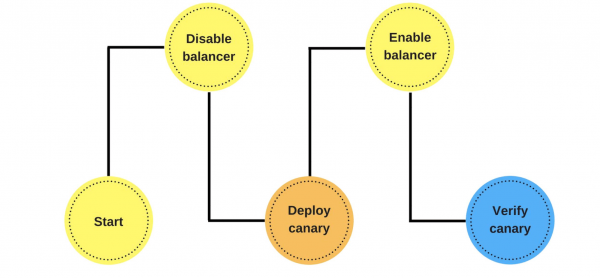
V tomto kroku realizujeme automatické porovnávanie. Aké to môže vyzerať a prečo je to lepšie ako kontrola po nasadení, ukážeme na príklade z Jenkins.
Toto je pipeline do Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary zlyhal, potrebujeme sa vrátiť"
        return false
    }
}
Tu v cykle určujeme, že budeme porovnávať nový uzol počas hodiny. Ak kanársky proces ešte neskončil, zavoláme funkciu. Tá informuje, či je všetko v poriadku, alebo nie: def isOk = compare(srv, canary, time, base, offset, metrics).
Ak je všetko v poriadku — sleep DEFAULT SLEEP, napríklad na sekundu, a pokračujeme. Ak nie, vychádzame — nasadenie sa nepodarilo.
Popis metriky. Pozrime sa, ako môže vyzerať funkcia compare na príklade DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Predpokladajme, že porovnávame počet chýb a chceme zistiť počet chýb za sekundu za posledných 5 minút.
Máme dve hodnoty: základnú a canary uzla. Hodnota canary uzla — aktuálna. Základná je baseValue — táto hodnota patrí akejkoľvek inej ne-canary uzlu. Porovnávame hodnoty medzi sebou podľa vzorca, ktorý nastavujeme na základe svojich skúseností a pozorovaní. Ak je hodnota canaryValue zlá, operácia nasadenia zlyhala a musíme sa vrátiť.
Prečo je toto všetko potrebné?
Človek nemôže skontrolovať stovky a tisíce metrik., tým viac je to rýchle. Automatické porovnávanie pomáha skontrolovať všetky metriky a rýchlo upozorňuje na problémy. Doba upozornenia je kritická: ak sa niečo stalo v posledných 2 sekundách, škoda bude menšia ako keby sa to stalo pred 15 minútami. Kým si niekto všimne problém, napíše na podporu a podpora nám, aby to vrátila späť, môže prísť o zákazníkov.
Ak proces prebehol a všetko je v poriadku, automaticky nasadíme všetky ostatné uzly. Počas tohto času inžinieri nič nerobia. Iba keď spúšťajú canary, rozhodujú, aké metriky vziať, ako dlho robiť porovnanie a akú stratégiu použiť.
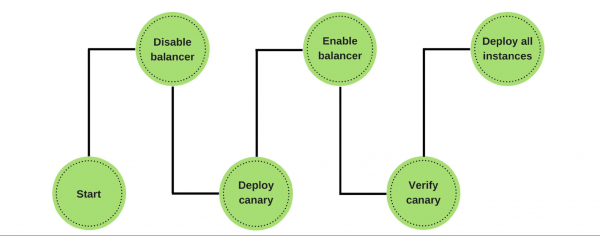
Ak vznikli problémy — automaticky vraciame canary-uzol, pracujeme na predchádzajúcich verziách a opravujeme chyby, ktoré sme našli. Podľa metrík je ich ľahké nájsť a vidieť škodu od novej verzie.
Prekážky
Implementovať to, samozrejme, nie je jednoduché. Predovšetkým je potrebné spoločný systém monitorovania. Inžinieri majú svoje metriky, podpora a analytici — ďalšie, a obchod má tretie. Spoločný systém je spoločný jazyk, ktorým sa rozprávajú obchod a vývoj.
Je potrebné overiť v praxi stabilitu metrík. Kontrola pomáha pochopiť, aký minimálny súbor metriky je potrebný na zabezpečenie kvality.
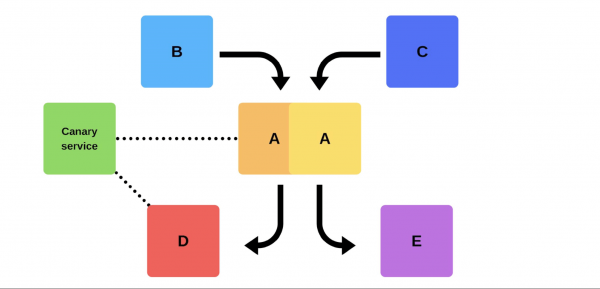
Ako to dosiahnuť? Použiť canary službu nie v momente nasadenia. Pridávame na starú verziu nejakú službu, ktorá v každom okamihu dokáže zobrať akýkoľvek vyhradený uzol, znížiť prenos bez nasadenia. Potom porovnávame: študujeme chyby a hľadáme hranicu, keď dosahujeme kvalitu.
Aký prínos sme získali z canary-verzií
Minimalizovali percento škody od chýb. Väčšina chýb pri nasadení vzniká z dôvodu nesúladnosti niektorých údajov alebo priorít. Týchto chýb sa stalo oveľa menej, pretože môžeme vyriešiť problém v prvých sekundách.
Optimalizovali prácu tímov. Nováčikovia majú "právo na chybu": môžu nasadiť do produkcie bez strachu zo zlyhania, objavuje sa dodatočná iniciatíva, podnet pracovať. Ak niečo pokazia, nebude to kritické a chybný nebude prepustený.
Automatizovali sme nasadenie. Už to nie je ručný proces ako predtým, ale to je skutočne automatizované. Ale prebieha to dlhšie.
Vyznačili sme dôležité metriky. Celá spoločnosť, od obchodných a inženierskych tímov, chápe, čo je v našom produkte naozaj dôležité, aké metriky, napríklad odliv a príliv používateľov. Kontrolujeme proces: testujeme metriky, zavádzame nové, sledujeme, ako fungujú staré, aby sme vytvorili systém, ktorý bude zarábať efektívnejšie.
Máme veľa skvelých praktík a systémov, ktoré nám pomáhajú. Napriek tomu sa snažíme byť profesionálmi a robiť svoju prácu kvalitne, bez ohľadu na to, či máme systém, ktorý nám pomôže, alebo nie.
Inžinierske prístupy a praktiky — . Ak ste dosiahli úspechy na ceste k technickej dokonalosti a ste pripravení povedať, čo vám v tom pomohlo, — .
Plánujeme usporiadať 8. júna. Chápeme, že teraz je ťažké rozhodnúť o účasti na konferencii. Ale zároveň považujeme, že karanténa nie je dôvodom zastaviť profesionálnu komunikáciu a rozvoj. Preto si v každom prípade nájdeme spôsob, ako prediskutovať úlohy technického lídra a prístupy k ich riešeniu — ak bude potrebné, prejdeme do online formátu a rozvineme networking tam!
Zdroj: habr.com
