

Táto poznámka bude zaujímavá pre tých, ktorí používajú knižnicu na spracovanie tabuľkových údajov pre R — data.table, a možno budú radi vidieť flexibilitu jej aplikácie na rôznych príkladoch.
Inšpirovaný dobrým príkladom , a dúfajúc, že ste už prečítali jeho článok, navrhujem hlbšie preskúmať optimalizáciu kódu a výkon na základe data.table.
Úvod: odkiaľ pochádza data.table?
Najlepšie je začať zoznamovanie sa s knižnicou trošku z diaľky, a to so štruktúrami dát, z ktorých môže byť získaný objekt data.table (ďalej DТ).
Pole
Kód
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Jednou z takýchto štruktúr je pole (?base::array). Ako v iných jazykoch sú polia tu viacrozmerné. Zaujímavé však je, že napríklad dvojrozmerné pole začína dediť vlastnosti od triedy matice (?base::matrix), a jednorozmerné pole, čo je tiež dôležité, nededí od vektora (?base::vector).
Pri tom treba chápať, že typ dát, ktoré obsahuje nejaký objekt, treba overiť funkciou base::typeof, ktorá vracia vnútorný popis typu podľa R Internals — spoločného protokolu jazyka, súvisiaceho s primárnym C.
Ďalšia príkaz, na určenie triedy objektu, base::class, vracia v prípade vektorov vektorový typ (líši sa názvom od vnútorného, ale tiež umožňuje pochopiť typ dát).
Zoznam
Z dvojrozmerného poľa, teda matice, môžeme prejsť k zoznamu (?base::list).
Kód
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Pri tom sa odohráva niekoľko vecí naraz:
- Druhé meranie matice sa zhodnocuje, to znamená, že získavame súčasne aj zoznam a vektor.
- Zoznam tak dedí od týchto tried. Treba mať na pamäti, že prvku zoznamu zodpovedá jedna (skalárna) hodnota z bunky matice-pola.
Vďaka tomu, že zoznam je tiež vektor, môžeme naň aplikovať niektoré funkcie pre vektory.
Dátový rámec
Z zoznamu, matice alebo vektora môžeme prejsť k dátovému rámcu (?base::data.frame).
Kód
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Čo je na ňom zaujímavé: dátový rámec dedí od zoznamu! Stĺpce dátového rámca sú bunkami zoznamu. To bude dôležité neskôr, keď budeme používať funkcie aplikované na zoznamy.
data.table
Získať DТ (?data.table::data.table) je možné z dátového rámca, zoznamu, vektora alebo matice. Napríklad, takto (in place).
Kód
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Užitočné je to, že, rovnako ako dátový rámec, DТ dedí vlastnosti zoznamu.
DТ a pamäť
Na rozdiel od všetkých ostatných objektov v R základe, DT sa prenášajú odkazom. Ak potrebujete vytvoriť kópiu do novej oblasti pamäte, potrebujete funkciu data.table::copy alebo musíte spraviť výber zo starého objektu.
Kód
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Týmto končí úvod. DT je pokračovaním vývoja údajových štruktúr v R, ktorý sa prevažne deje prostredníctvom rozšírenia a urýchlenia operácií vykonávaných nad objektmi triedy dataframe. Pri tom sa zachováva dedičstvo z iných primitív.
Niektoré príklady používania vlastností data.table
Ako zoznam...
Iterovať po riadkoch dataframe alebo DT nie je najlepšia idea, pretože kód cyklu v jazyku R je oveľa pomalší C, ale prejsť cyklom po stĺpcoch, ktorých je, zvyčajne, oveľa menej, je celkom možné. Idúc po stĺpcoch, pamätajme, že každý stĺpec je prvkom zoznamu, ktorý obsahuje, zvyčajne, vektor. A operácie nad vektormi sú dobre vektorované v základných funkciách jazyka. Môžeme tiež použiť výberové operátory, špecifické pre zoznamy a vektory: `[[`, `$`.
Kód
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorizácia
Ak je potrebné prejsť po riadkoch veľkého DT, najlepším riešením bude napísanie funkcie s vektorizáciou. Ale ak to nie je možné, mali by ste pamätať, že cyklus vnútri DT je stále rýchlejší ako cyklus v R, pretože sa vykonáva na C.
Skúsme na väčšom príklade so 100K riadkami. Budeme vyťahovať prvé písmeno zo slov, ktoré sú súčasťou vektorového stĺpca w.
Updated
Kód
library(magrittr)
library(microbenchmark)

## Väčší príklad ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorizácia

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# druhý

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# tretí

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Prvý beh s iteráciou po riadkoch:
Jednotka: milisekundy
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Druhý beh, kde sa vektorizácia realizuje cez konverziu zoznamu na maticu a získavanie prvkov na reze s indexom 1 (posledné je vlastne samotná vektorizácia). Oprava: vektorizácia na úrovni funkcie strsplit, ktorý dokáže prijímať vektor ako vstup. Ukazuje sa, že procedúra premeny zoznamu na maticu je oveľa náročnejšia ako samotná vektorizácia, ale aj v tomto prípade je to oveľa rýchlejšie ako nevykonaná verzia.
Jednotka: milisekundy
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Urýchlenie podľa mediánu v 3-krát.
Tretí beh, kde sa zmenila schéma premeny na maticu.
Jednotka: milisekundy
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Urýchlenie podľa mediánu v 13-krát.
S týmto projektom je potrebné experimentovať, čím viac — tým lepšie to bude.
Ešte jeden príklad s vektorizáciou, kde je tiež text, ale je prispôsobený reálnym podmienkam: rôzna dĺžka slov, rôzny počet slov. Je potrebné získať prvé 3 slová. Takto:
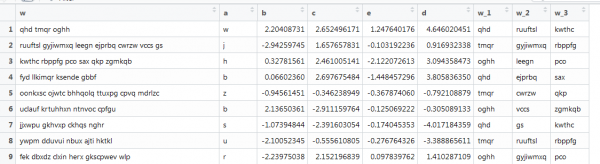
Tu už predchádzajúca funkcia nefunguje, pretože vektory majú rôznu dĺžku, a my sme nastavovali veľkosť matice. Prepracujeme to, prehľadáme internet.
Kód
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Jednotka: milisekundy
expr min lq mean median
{ dt[, `:=`((paste0("w_", 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Skript pracoval priemerne rýchlosťou 1 sekunda. Nie zlé.
Súvisiace jednou reťazou…
S objektmi DT je možné pracovať pomocou chainingu. Vyzerá to ako pripojenie syntaxe zátvoriek sprava, v podstate ide o syntaktický cukor.
Kód
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Tečie potrubím…
Podobné operácie je možné vykonávať cez piping, vyzerá to podobne, ale funkčne je to bohatšie, pretože je možné používať akékoľvek metódy, a nie len DT. Uveďme koeficienty logistickej regresie pre naše syntetické dáta s radom filtrov na DT.
Kód
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Štatistika, strojové učenie a iné vnútri DT
Môžete použiť lambda-funkcie, ale niekedy je lepšie vytvoriť ich samostatne, zapísať celý pipeline analýzy dát, a dopredu — fungujú vnútri DT. Príklad je obohatený všetkými vyššie uvedenými funkciami, plus niekoľko užitočných vecí z arzenálu DT (ako prístup k samotnému DT zo samotného DT odkazom, niekedy vložených nepravidelne, ale aby to bolo).
Kód
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Záver
Dúfam, že sa mi podarilo vytvoriť ucelený, hoci určite nie úplný, obraz takého objektu ako data.table, počnúc jeho vlastnosťami súvisiacimi s dedičstvom z tried R a končiac jeho vlastnými vychytávkami a okolitými prvkami tidyverse. Dúfam, že to pomôže lepšie študovať a aplikovať túto knižnicu na prácu a zábavu.
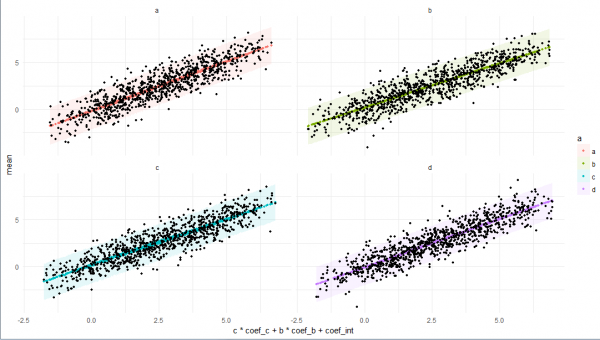
Ďakujeme!
Úplný kód
Kód
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Zdroj: habr.com
