

Pri zložitom spracovávaní veľkých súborov dát (rôznych : importy, konverzie a synchronizácie s externým zdrojom) často vzniká potreba dočasne „zapamätať“ a rýchlo spracovať niečo objemné.
Typická úloha tohto druhu znie zvyčajne takto: „Tu posledné prijaté platby, musíme ich rýchlo nahrať na stránku a priradiť k účtom“
Ale keď objem tohto „niečoho“ začne byť meraný stovkami megabajtov a služba musí fungovať s databázou nepretržite 24×7, objaví sa množstvo vedľajších účinkov, ktoré vám skomplikujú život.
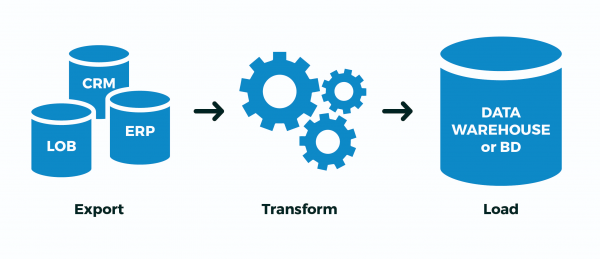
Aby sme sa s nimi vysporiadali v PostgreSQL (a nielen v ňom), môžeme využiť niektoré možnosti optimalizácie, ktoré umožnia spracovať všetko rýchlejšie a s menšou spotrebou zdrojov.
1. Kam nahrávať?
Najskôr si ujasnime, kam môžeme nahrať dáta, ktoré chceme „spracovať“.
1.1. Dočasné tabuľky (TEMPORARY TABLE)
V podstate, pre PostgreSQL sú dočasné tabuľky rovnaké ako akékoľvek iné. Preto sú falošné poverenia ako „tam sa všetko uchováva len v pamäti a tá môže dôjsť“. Ale existujú aj niektoré podstatné rozdiely.
Svoj „menový priestor“ pre každé pripojenie k DB
Ak sa dve pripojenia pokúsia súčasne vykonať CREATE TABLE x, niekto určite získa chybu nejedinečnosti objektov DB.
Ale ak obaja uskutočnia VYTVORIŤ DOČASNÁ TABUĽKA x, obaja to urobia bez problémov a každý dostane svoj exemplár tabuľky. A medzi nimi nebude nič spoločné.
„Samousmrť“ pri odpojení
Pri uzavretí pripojenia sú všetky dočasné tabuľky automaticky odstránené, preto „ručne“ vykonávať DROP TABLE x nemá zmysel, okrem…
Ak pracujete cez pgbouncer v režime transakcie, tak databáza stále považuje, že toto pripojenie je stále aktívne, a v ňom táto dočasná tabuľka naďalej existuje.
Preto pokus o jej opätovné vytvorenie z iného pripojenia k pgbouncer vedie k chybe. Ale toto sa dá obísť pomocou VYTVOŘIT DOČASNOU TABULKU POKUD NEEXISTUJE x.
Pravda, je lepšie to takto nerobiť, pretože potom môžete „nečakane“ objaviť dáta, ktoré zostali po „predchádzajúcom majiteľovi“. Namiesto toho je oveľa lepšie si prečítať manuál a zistiť, že pri vytváraní tabuľky máte možnosť doplniť PRI PRIHLÁSENÍ DROP — to znamená, že po dokončení transakcie sa tabuľka automaticky odstráni.
Nereplikované
Pretože patrí iba k určitému spojeniu, dočasné tabuľky sa nereplikujú. Avšak to zbavuje potreby dvojitého zápisu údajov do heap + WAL, preto sú INSERT/UPDATE/DELETE do nej podstatne rýchlejšie.
Ale pretože dočasná tabuľka je predsa len 'takmer normálna' tabuľka, nie je možné ju vytvoriť ani na replike. Aspoň zatiaľ, hoci príslušný patch sa už dávno pohybuje.
1.2. Nereportovateľné tabuľky (UNLOGGED TABLE)
Ale čo robiť, ak máte nejaký zložitý ETL proces, ktorý sa nedá zrealizovať v rámci jednej transakcie, a máte pgbouncer v režime transakcie?..
Alebo je tok údajov taký veľký, že kapacita jedného spojenia s DB (čítaj, jedného procesu na CPU) nestačí?.
Alebo časť operácií ide asynchrónne v rôznych pripojeniach?.
Tu je len jedna možnosť — dočasne vytvoriť ne-dočasnú tabuľku. Hra so slovami, áno. To znamená:
- vytvoril 'svoje' tabuľky s maximálne náhodnými názvami, aby som sa s nikým nezrazil
- Extract: načítal som do nich údaje z externého zdroja
- Transform: pretransformoval, vyplnil kľúčové prepojené polia
- Load: prelieval pripravené údaje do cieľových tabuliek
- vymazal 'svoje' tabuľky
A teraz — lyžička dechtu. V podstate, celý zápis v PostgreSQL prebieha dvakrát — , potom už do telá tabuliek/indexov. Toto všetko je urobené na podporu ACID a správnej viditeľnosti údajov medzi COMMITvnútornými a ROLLBACKvnútornými transakciami.
Ale to my nepotrebujeme! Náš celý proces buď prebehol úspešne, alebo nie. Nezáleží na tom, koľko v ňom bude medzičlánkov — nezaujíma nás 'pokračovať v procese od polovice', najmä keď nie je jasné, kde bola.
Na to vývojári PostgreSQL ešte vo verzii 9.1 zaviedli takú vec, ako sú :
S týmto ustanovením sa tabuľka vytvára ako nereportovateľná. Údaje zapisované do nereportovateľných tabuliek neprechádzajú cez žurnál predzápisu (pozri Kapitolu 29), a v dôsledku toho také tabuľky fungujú oveľa rýchlejšie ako normálne. Avšak, nie sú chránené pred zlyhaním; pri zlyhaní alebo havarijnom vypnutí servera sa nereportovateľná tabuľka automaticky zruší.Okrem toho obsah nereportovateľnej tabuľky sa nereplikovaný. na riadené servery. Akékoľvek indexy vytvorené pre nezaznamenávanú tabuľku automaticky zostávajú nezaznamenávané.
Krátko, bude to výrazne rýchlejšie, ale ak server DB „spadne“ — bude to nepríjemné. Ale stáva sa to často, a vie váš ETL proces to správne spracovať „z polovice“ po „oživení“ DB?..
Ak sa tak nestane, a vyššie uvedený prípad sa podobá na váš — použite UNLOGGED, ale nikdy nepoužívajte tento atribút na skutočných tabuľkách, ktorých dáta sú pre vás cenné.
1.3. ON COMMIT { DELETE ROWS | DROP }
Tento príkaz umožňuje pri vytváraní tabuľky nastaviť automatické správanie po ukončení transakcie.
O PRI PRIHLÁSENÍ DROP už som napísal vyššie, generuje DROP TABLE, a tu je PRI PRIHLÁSENÍ ZMAZAŤ RIADKY situácia zaujímavejšia — tu sa generuje TRUNCATE TABLE.
Keďže celá infraštruktúra ukladania meta popisov dočasnej tabuľky je presne taká istá, ako u bežnej, neustále vytváranie a mazanie dočasných tabuliek vedie k výraznému „nafukovaniu“ systémových tabuliek pg_class, pg_attribute, pg_attrdef, pg_depend,…
Teraz si predstavte, že máte pracovníka na priamej spojení s DB, ktorý každú sekundu otvára novú transakciu, vytvára, napĺňa, spracováva a maže dočasnú tabuľku… Odpadu v systémových tabulkách sa nahromadí nadmerné množstvo, čo spôsobuje zbytočné spomalenia pri každej operácii.
Všeobecne, nerobte to! V takomto prípade je oveľa efektívnejšie CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS vyniesť mimo cyklu transakcií — vtedy na začiatku každej novej transakcie tabuľky už existujú (šetríme volanie VYTVORIŤ), ale bude prázdna, vďaka TRUNCATE (jeho volanie sme tiež ušetrili) po ukončení predchádzajúcej transakcie.
1.4. LIKE… INCLUDING …
Spomenul som na začiatku, že jedným z typických use case pre dočasné tabuľky je rôzne druhy importov — a vývojár unavene kopíruje zoznam polí cieľovej tabuľky do vyhlásenia svojej dočasnej…
Ale lenivosť je motor pokroku! Preto vytvoriť novú tabuľku „podľa vzoru“ je oveľa jednoduchšie:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Keďže do tejto tabuľky možno generovať naozaj veľa údajov, vyhľadávanie v nej nebude rýchle. Ale proti tomu existuje tradičné riešenie — indexy! A áno, dočasná tabuľka môže mať tiež indexy.
Keďže často, potrebné indexy sa zhodujú s indexami cieľovej tabuľky, možno jednoducho napísať PODOBNÉ ako target_table ZAHŔŇAJÚC INDEXY.
Ak potrebujete ešte aj DEFAULT-hodnoty (napríklad na naplnenie hodnôt primárneho kľúča) môžete využiť PODOBNÉ ako target_table VRÁTANE VYHODNOCOV. Alebo jednoducho — PODOBNÉ ako target_table VRÁTANE VŠETKÉHO — skopíruje predvolené hodnoty, indexy, obmedzenia,…
Ale tu už treba chápať, že ak ste vytvorili importovaciu tabuľku hneď s indexmi, tak sa dáta budú importovať dlhšie, ako keby ste najprv všetko importovali a až potom nasadili indexy — pozrite sa napríklad, ako to robí .
Všeobecne, !
2. Ako písať?
Poviem to jednoducho — používajte -prúd namiesto «balíka» INSERT, . Môžete dokonca priamo z predtým vytvoreného súboru.
3. Ako spracovávať?
Dajme tomu, že náš vstup vyzerá približne takto:
- ukladáte v databáze tabuľku s klientskými dátami na 1M záznamov
- každý deň vám klient posiela nový úplný «obraz»
- podľa skúsenosti viete, že sa zvyčajne mení maximálne 10K záznamov Klasickým príkladom takejto situácie je
databáza KĽADR 3.1. Algoritmus úplnej synchronizácie
Pre jednoduchosť predpokladajme, že nemusíte ani reštukturalizovať dáta — stačí uviesť tabuľku do požadovaného stavu, teda:
odstrániť
- všetko, čo už neexistuje aktualizovať
- všetko, čo už bolo a treba aktualizovať vložiť
- všetko, čo ešte nebolo Prečo by ste mali vykonávať operácie presne v tomto poradí? Pretože len tak sa veľkosť tabuľky zvýši minimálne (
nezabudnite na MVCC!).
Nie, samozrejme, môžete sa obísť s iba dvoma operáciami:
) celú tabuľku
- všetko, čo už neexistuje (
DELETEvšetko z nového obrazu - všetko, čo ešte nebolo Ale pritom, vďaka MVCC,
sa veľkosť tabuľky zvýši presne na dvojnásobok ! Získať +1M obrazov záznamov v tabuľke z dôvodu aktualizácie 10K — to je dosť nadbytočné…TRUNCATE dst
Skúsenejší vývojári vedia, že celú tabuľku je možné dosť lacno vyčistiť:
) celú tabuľku
- vyčistiť (
TRUNCATEMetóda je účinná, - všetko, čo ešte nebolo Ale pritom, vďaka MVCC,
niekedy celkom aplikovateľná A to znamená:
začína nám
- dlhá transakcia kladie
TRUNCATEAccessExclusive -zámokdlho robíme vkladanie, a všetci ostatní v tom čase- nemôžu ani Nič dobré sa nezdá…
SELECT
Niečo nie je v poriadku...
ALTER TABLE… RENAME… / DROP TABLE …
Ako možnosť – nahrať všetko do novej tabuľky a potom jednoducho premenovať na miesto starej. Niekoľko nepríjemných drobností:
- tiež -zámok, aj keď podstatne menej z časového hľadiska
- všetky plány dotazov/štatistiky tejto tabuľky sa resetujú,
- všetky vonkajšie kľúče sa poškodia (FK) na tabuľku
Bol WIP-patch od Simona Riggsa, ktorý navrhoval vykonať ALTER-operáciu na výmenu tela tabuľky na úrovni súborov, bez dotknutia sa štatistiky a FK, ale nezískal kvórum.
DELETE, UPDATE, INSERT
Takže sa zastavujeme na neblokujúcej možnosti z troch operácií. Téměř tři... Ako to spraviť najefektívnejšie?
-- všetko robíme v rámci transakcie, aby nikto nevidel "medzi" stavy
BEGIN;

-- vytvoríme dočasnú tabuľku s importovanými údajmi
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- podľa vzoru, spolu s indexmi
) ON COMMIT DROP; -- mimo transakcie ju nepotrebujeme

-- rýchlo a rýchlo nakrmíme nový obraz cez COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- odstraňujeme chýbajúce
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- polia primárneho kľúča
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "antijoin"

-- aktualizujeme zostávajúce
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- netreba aktualizovať zhodujúce sa

-- vkladáme chýbajúce
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Postprocessing importu
V rovnakom KĽADRi je potrebné všetky zmenené záznamy dodatočne spracovať – normalizovať, vyčleniť kľúčové slová, uviesť do požadovaných štruktúr. Ale ako zistiť – čo presne sa menilo, bez toho, aby sa týmto skomplikoval kód synchronizácie, ideálne, vôbec ho netrápiac?
Ak je v momente synchronizácie prístup na zápis len vo vašom procese, môžete využiť trigger, ktorý zhromaždí všetky zmeny:
-- cieľové tabuľky
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabuľky s históriou zmien
CREATE TABLE kladr$log(
  ro kladr, -- tu sú celé obrazy záznamov starých/nových
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- všeobecná funkcia logovania zmien
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- kontrolujeme potrebu logovania pri aktualizácii záznamu
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- vytvárame záznam logu
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Teraz môžeme skôr ako začneme so synchronizáciou aplikovať (alebo zapnúť prostredníctvom ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
A potom si pokojne z log-tabúľ vyberieme všetky potrebné zmeny a prehneme ich cez dodatočné spracovatele.
3.3. Import súvisiacich súborov
Už sme sa zaoberali prípadmi, keď štruktúry údajov zdroja a prijímača sa zhodujú. Ale čo robiť, ak export z externého systému má formát odlišný od štruktúry, ktorú máme v našej databáze?
Vezmeme si ako príklad uchovávanie klientov a ich faktúr, klasický variant „mnoho-k-jednému“:
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
A export z externého zdroja k nám prichádza vo forme „všetko v jednom“:
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Je zrejmé, že údaje o klientoch sa v takomto prípade môžu duplikovať a hlavným záznamom je „faktúra“:
0123456789;Václav;A-01;2020-03-16;1000.00
9876543210;Peter;A-02;2020-03-16;666.00
0123456789;Václav;B-03;2020-03-16;9999.00
Pre model jednoducho vložíme naše testovacie údaje, ale pamätáme si — KOPÍROVAŤ efektívnejšie!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Václav', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Peter', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Václav', 'B-03', '2020-03-16', 9999.00);
Najprv vyberieme tie „prerezania“, na ktoré sa naše „fakty“ odkazujú. V našom prípade sa faktúry odkazujú na klientov:
VYTVORTE DOČASNÚ TABUĽKU client_import AS
VYBERTE DISTINCT NA(client_inn)
-- môžete jednoducho použiť SELECT DISTINCT, ak sú údaje od začiatku konzistentné
  client_inn inn
, client_name "name"
Z
  invoice_import;
Aby sme správne prepojili faktúry s ID klientov, musíme najprv tieto identifikátory zistiť alebo vygenerovať. Pridáme pre ne polia:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
Využijeme vyššie opísaný spôsob synchronizácie tabuliek s malou úpravou — nebudeme nič aktualizovať ani mazať v cieľovej tabuľke, pretože import klientov je u nás "append-only":
-- priradíme v tabuľke importu ID už existujúcich záznamov
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  client D
WHERE
  T.inn = D.inn; -- unikátny kľúč

-- vložíme chýbajúce záznamy a priradíme ich ID
WITH ins AS (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  FROM
    client_import
  WHERE
    client_id IS NULL -- ak ID nebolo priradené
  RETURNING *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  ins D
WHERE
  T.inn = D.inn; -- unikátny kľúč

-- priraďujeme ID klientov k záznamom faktúr
UPDATE
  invoice_import T
SET
  client_id = D.client_id
FROM
  client_import D
WHERE
  T.client_inn = D.inn; -- aplikovaný kľúč
Vlastne, to je všetko — v invoice_import teraz máme vyplnené pole pre prepojenie client_id, pomocou ktorého vložíme faktúru.
Zdroj: habr.com
