

Berkeley Packet Filters (BPF) sú technológia jadra Linux, ktorá sa už niekoľko rokov neustále objavuje na prvých stránkach anglicky písaných technických publikácií. Konferencie sú plné prezentácií o využití a vývoji BPF. David Miller, správca sieťového subsystému Linux, nazýva svoju prednášku na Linux Plumbers 2018 (XDP je jedným z variantov využitia BPF). Brendan Gregg číta prezentácie pod názvom . Toke Høiland-Jørgensen , že jadro je teraz microkernel. Thomas Graf propaguje myšlienku, že .
Na HAbre stále neexistuje systematický popis BPF, a preto sa v sérii článkov pokúsim prerozprávať históriu technológie, popísať architektúru a vývojové nástroje, načrtnúť oblasti aplikácie a praktiky využívania BPF. V tomto, nulovom, článku cyklu sa rozpráva história a architektúra klasického BPF, ako aj odhaľujú tajomstvá princípov jeho fungovania tcpdump, seccomp, strace, a mnoho ďalšieho.
Vývoj BPF je riadený sieťovou komunitou Linux, základné existujúce aplikácie BPF sú viazané na siete a preto, so súhlasom , som nazval sériu "BPF pre najmenších", na počesť veľkej série .
Krátky kurz histórie BPF (c)
Moderná technológia BPF je vylepšená a rozšírená verzia starej technológie so rovnakým názvom, nazývanej v súčasnosti, aby sa predišlo zmätku, classic BPF. Na základe klasického BPF boli vytvorené všetkým známe nástroje tcpdump, mechanizmus seccomp, ako aj menej známy modul xt_bpf pre iptables a klasifikátor cls_bpf. V súčasnom Linuxe klasické programy BPF sú automaticky transponované do novej formy, avšak z pohľadu používateľa API zostalo na mieste a nové aplikácie klasického BPF, ako uvidíme v tomto článku, sú stále prítomné. Z tohto dôvodu, a taktiež preto, že sledovanie histórie vývoja klasického BPF v Linuxe objasní, ako a prečo sa vyvinulo do súčasnej formy, som sa rozhodol začať svoj článok práve s klasickým BPF.
Na konci osemdesiatych rokov minulého storočia sa inžiniéri z renomovanej Lawrence Berkeley Laboratory zaujímali o to, ako správne filtrovať sieťové pakety na vtedajších moderných zariadeniach. Základná idea filtrovania, realizovaná pôvodne v technológii CSPF (CMU/Stanford Packet Filter), spočívala v tom, aby sa zbytočné pakety filtrovali čo najskôr, t.j. v priestore jadra, pretože to zabraňuje kopírovaniu zbytočných údajov do priestoru používateľa. Na zabezpečenie bezpečnosti času vykonávania pre spustenie používateľského kódu v priestore jadra sa používala virtuálna mašina — pieskovisko.
Virtuálne stroje pre existujúce filtre však boli navrhnuté na spúšťanie na zariadeniach so zásobníkovou architektúrou a na nových RISC strojoch nefungovali tak efektívne. Nakoniec sa zásluhou inžinierov z Berkeley Labs vyvinula nová technológia BPF (Berkeley Packet Filters), ktorej architektúra virtuálnej mašiny bola navrhnutá na základe procesora Motorola 6502 — pracovnej kone, ktorá stála za takými známymi produktmi ako alebo . Nová virtuálna mašina zvyšovala výkon filtrov desiatkykrát v porovnaní s existujúcimi riešeniami.
Architektúra stroja BPF
S architektúrou sa oboznámime na praktických príkladoch. Na úvod však povedzme, že stroj mal dva dostupné 32-bitové registre pre používateľa, akumulátor A a indexový register X, 64 bajtov pamäte (16 slov), ktorá bola dostupná na zápis a následné čítanie, a malý systém inštrukcií na prácu s týmito objektmi. V programoch boli k dispozícii aj inštrukcie presmerovania na realizáciu podmienkových výrazov, avšak pre zaručenie včasného ukončenia práce programu sa mohlo presmerovať iba vpred, t.j. sa zakazovalo vytvárať slučky.
Celkový plán spustenia stroja je nasledujúci. Používateľ vytvorí program pre architektúru BPF a pomocou nejakého mechanizmu jadra (napríklad systémového volania) načíta a pripojí program k nejakému generátoru udalostí v jadre (napríklad udalosť — to je príchod ďalšieho paketu na sieťovú kartu). Pri vzniku udalosti jadro spustí program (napr. v interpreteri), pričom pamäť stroja zodpovedá nejakému regionu pamäti jadra (napríklad, údajom prichádzajúceho balíka).
Spomínané je dostatočné na to, aby sme začali rozoberať príklady: oboznámime sa so systémom a formátom príkazov podľa potreby. Ak sa však chcete okamžite zaoberať systémom príkazov virtuálneho stroja a dozvedieť sa o všetkých jeho možnostiach, môžete si prečítať pôvodný článok a/alebo prvú polovicu súboru z dokumentácie jadra. Okrem toho si môžete preštudovať prezentáciu , v ktorej McCanne, jeden z autorov BPF, hovorí o histórii vytvárania libpcap.
Prechádzame k preskúmaniu všetkých podstatných príkladov aplikácie klasického BPF v Linuxe: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
Vývoj BPF prebiehal paralelne s vývojom frontendu na filtrovanie paketov — všetkým známej utilitky tcpdump. A, keďže je to najstarší a najznámejší príklad využitia klasického BPF, dostupný na mnohých operačných systémoch, od neho začneme s učením tejto technológie.
(Všetky príklady v tomto článku som spustil na Linuxe 5.6.0-rc6. Výstup niektorých príkazov bol upravený pre vyššiu čitateľnosť.)
Príklad: sledujeme IPv6 pakety
Predpokladajme, že chceme sledovať všetky IPv6 pakety na rozhraní eth0. Na to môžeme spustiť program tcpdump s najjednoduchším filtrom ip6:
$ sudo tcpdump -i eth0 ip6Pri tom tcpdump skompiluje filter ip6 do bajtkódu architektúry BPF a pošle ho do jadra (pozrite si podrobnosti v sekcii ). Načítaný filter sa spustí pre každý paket, ktorý prechádza cez rozhranie eth0. Ak filter vráti nenulovú hodnotu n, potom do n bajtov paketu sa skopíruje do priestoru užívateľa a uvidíme ho vo výstupe tcpdump.
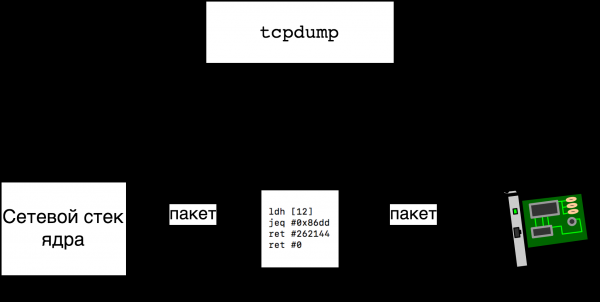
Ukazuje sa, že môžeme ľahko zistiť, aký konkrétny bajtkód bol poslaný do jadra tcpdump pomocou samotného tcpdump, ak ho spustíme s voľbou -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
Na nulovom riadku spúšťame príkaz ldh [12], ktorý sa dekóduje ako „načítanie do registra A pol-slova (16 bitov), nachádzajúcich sa na adrese 12“ a jediná otázka — akú pamäť adresujeme? Odpoveď spočíva v tom, že na adrese x začína (x+1)-ty bajt analyzovaného sieťového paketu. Načítavame pakety z Ethernet rozhrania eth0, a to , že balík vyzerá nasledovne (pre jednoduchosť predpokladáme, že v balíku nie sú VLAN tagy):
       6              6          2
|Destination MAC|Source MAC|Ether Type|...|
To znamená, že po vykonaní príkazu ldh [12] v registri A bude pole Ether Type — typ prenášaného balíka v tomto Ethernetovom rámci. V riadku 1 porovnávame obsah registra A (typ balíka) s 0x86dd, a to nás zaujímajúci typ IPv6. V riadku 1 okrem príkazu porovnania sú ešte dva stĺpce — jt 2 a jf 3 — značky, na ktoré je potrebné prejsť v prípade úspešného porovnania (A == 0x86dd) a neúspešného. Takže v úspešnom prípade (IPv6) prechádzame na riadok 2, a v neúspešnom — na riadok 3. V riadku 3 program končí s kódom 0 (nekopíruj balík), v riadku 2 program končí s kódom 262144 (skopíruj mi maximálne 256 kilobajtov balíka).
Príklad komplikovanejší: pozrime sa na TCP balíky podľa cieľového portu
Pozrime sa, ako vyzerá filter, ktorý kopíruje všetky TCP balíky s cieľovým portom 666. Preskúmame prípad IPv4, pretože prípad IPv6 je jednoduchší. Po naštudovaní tohto príkladu môžete ako cvičenie sami preskúmať filter pre IPv6 (ip6 and tcp dst port 666) a filter pre všeobecný prípad (tcp dst port 666). Takže, zaujímajúci nás filter vyzerá nasledovne:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Čo robia riadky 0 a 1 už vieme. V riadku 2 sme už overili, že ide o IPv4 balík (Ether Type = 0x800) a načítame do registra A 24. bajt balíka. Náš balík vyzerá ako
       14            8      1     1
|ethernet header|ip fields|ttl|protocol|...
a to znamená, že načítame do registra A pole Protocol hlavičky IP, čo je logické, veď chceme kopírovať iba TCP balíky. Porovnávame Protocol s 0x6 () v riadku 3.
V riadkoch 4 a 5 načítame polslová nachádzajúce sa na adrese 20, a pomocou príkazu jset overujeme, či nie je nastavený jeden z troch — v maske vygenerovanej jset sú vyčistené tri najvyššie bity. Dva bity z troch nám hovoria, či je balík súčasťou fragmentovaného IP balíka, a ak áno, či je posledným fragmentom. Tretí bit je rezervovaný a mal by byť nula. Nechceme kontrolovať ani neúplné, ani poškodené balíky, a preto kontrolujeme všetky tri bity.
Riadok 6 je najzaujímavejší v tomto zozname. Výraz ldxb 4*([14]&0xf) znamená, že načítavame do registra X štyri najnižšie bity pätnásteho bytu paketu, vynásobené 4. Štyri najnižšie bity pätnásteho bytu sú pole hlavičky IPv4, v ktorom sa uchováva dĺžka hlavičky v slovách, takže je potrebné ju potom vynásobiť 4. Zaujímavé je, že výraz 4*([14]&0xf) je označenie špeciálnej adresovacej schémy, ktorú je možné použiť len takto a iba pre register X, t.j. nemôžeme povedať ani ldb 4*([14]&0xf) ani ldxb 5*([14]&0xf) (môžeme iba uviesť iný offset, napríklad ldxb 4*([16]&0xf)). Je jasné, že táto adresovacia schéma bola pridaná do BPF práve na to, aby sme získavali v X (indexový register) dĺžku hlavičky IPv4.
Takže sa na riadku 7 snažíme načítať pol-slovo na adrese (X+16). Pamätajúc na to, že 14 bytov zaberá hlavička Ethernetu a X obsahuje dĺžku hlavičky IPv4, chápeme, že v A sa načítava cieľový port TCP:
       14           X           2             2
|ethernet header|ip header|source port|destination port|
Nakoniec, na riadku 8 porovnávame cieľový port so hľadanou hodnotou a na riadkoch 9 alebo 10 vraciame výsledok — skopírovať paket alebo nie.
Tcpdump: načítanie
V predchádzajúcich príkladoch sme sa špeciálne nezaoberali podrobnosťami o tom, ako presne načítavame BPF bajtkód do jadra na filtrovanie paketov. V podstate tcpdump je portovaný na mnoho systémov a na prácu s filtrami využíva knižnicu . Stručne povedané, aby ste umiestnili filter na rozhranie pomocou libpcap, musíte vykonať nasledujúce kroky:
- vytvoriť deskriptor typu
pcap_tz názvu rozhrania: , - aktivovať rozhranie: ,
- skompilovať filter: ,
- pripojiť filter: .
Aby sme videli, ako je funkcia pcap_setfilter implementovaná v Linuxe, používame strace (niektoré riadky boli odstránené):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Na prvých dvoch riadkoch výstupu vytvárame na čítanie všetkých Ethernetových rámcov a viažeme ho na rozhranie eth0. Z vieme, že filter ip bude pozostávať zo štyroch BPF inštrukcií a na treťom riadku vidíme, ako pomocou možnosti systémového volania setsockopt nahrádzame a pripájame filter dĺžky 4. Toto je náš filter.
Je dôležité poznamenať, že v klasickom BPF sa načítanie a pripojenie filtruje vždy ako atomárna operácia, zatiaľ čo v novej verzii BPF je načítanie programu a jeho pripojenie k generátorovi udalostí časovo oddelené.
Skrytá pravda
Trochu podrobnejšia verzia výstupu vyzerá takto:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Resource temporarily unavailable)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Ako sme povedali vyššie, nahrádzame a pripájame k socketu náš filter na riadku 5, ale čo sa deje na riadkoch 3 a 4? Ukazuje sa, že toto libpcap sa o nás postará — aby sa do výstupu nášho filtra nedostali pakety, ktoré mu nevyhovujú, knižnica fiktívny filter ret #0 (zahoď všetky pakety), prevedie socket do nebločeného režimu a snaží sa prečítať všetky pakety, ktoré mohli zostať od predchádzajúcich filtrov.
Celkovo, aby sme filtrovali pakety na Linuxe pomocou klasického BPF, potrebujeme mať filter vo forme štruktúry typu struct sock_fprog a otvorený socket, po čom už môžeme filter pripojiť k socketu pomocou systémového volania. setsockopt.
Zaujímavé je, že filter môžeme pripojiť k akémukoľvek socketu, nielen k raw. Tu je programu, ktorý odstráni všetko, okrem dvoch prvých bajtov zo všetkých prichádzajúcich UDP dátagramov. (Komentáre som pridal do kódu, aby som nepreplnil článok.)
Podrobnejšie informácie o používaní setsockopt na pripájanie filtrov nájdete v , a o písaní vlastných filtrov typu struct sock_fprog bez pomoci tcpdump budeme hovoriť v časti .
Klasický BPF a XXI. storočie
BPF bol zahrnutý do Linuxu v roku 1997 a dlho zostal pracovným koňom libpcap bez výrazných zmien (zmeny špecifické pre Linux samozrejme , ale nezmenili globálny obraz). Prvé vážne známky toho, že BPF bude evolvovať sa objavili v roku 2011, keď Eric Dumazet navrhol , ktorý do jadra pridáva Just In Time Compiler — prekladač na preklad BPF bytekódu do natívneho x86_64 kódu.
JIT kompilátor bol prvý v reťazci zmien: v roku 2012 možnosť písať filtre pre , pomocou BPF, v januári 2013 bol modul xt_bpf, ktorý umožňuje písať pravidlá pre iptables pomocou BPF, a v októbri 2013 bol ešte aj modul cls_bpf, ktorý umožňuje písať pomocou BPF klasifikátory prevádzky.
Čoskoro sa podrobnejšie pozrieme na všetky tieto príklady, ale najprv bude užitočné naučiť sa písať a kompilovať ľubovoľné programy pre BPF, lebo možnosti poskytované knižnicou libpcap sú obmedzené (jednoduchý príklad: filtrovanie, ktoré bolo vytvorené libpcap , môže vrátiť len dve hodnoty — 0 alebo 0x40000) alebo sú v prípade seccomp vôbec neaplikovateľné.
Programovanie BPF vlastnými rukami
Oboznámme sa s binárnym formátom inštrukcií BPF, je veľmi jednoduchý:
   16    8    8     32
| kód | jt | jf |  k  |
Každá inštrukcia zaberá 64 bitov, pričom prvých 16 bitov sú kód príkazu, potom nasledujú dve osem bitové posuny, jt a jf, a 32 bitov pre argument K, ktorého účel sa mení podľa príkazu. Napríklad príkaz ret, ktorý ukončuje program, má kód 6, a vracajúca hodnota sa berie z konštanty K. V jazyku C sa jedna inštrukcia BPF zobrazuje ako štruktúra
struct sock_filter {
        __u16   kód;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
a celý program — ako štruktúra
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Týmto spôsobom už môžeme písať programy (kódy inštrukcií, povedzme, poznáme z ). Takto bude vyzerať filter ip6 z :
struct sock_filter kód[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(kód),
        .filter = kód,
};
Program prog môžeme legálne použiť vo volaní
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Písať programy vo forme strojového kódu nie je veľmi pohodlné, ale niekedy je to nutné (napríklad pre ladenie, tvorbu jednotkových testov, písanie článkov na habrei a pod.). Pre pohodlie v súbore <linux/filter.h> sú definované makrá-pomocníci — ten istý príklad, čo a vyššie, by sa dal prepísať ako
struct sock_filter kód[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Avšak aj tento variant nie je príliš pohodlný. Takto uvažovali aj programátori jadra Linux a preto v adresári jadra sa dajú nájsť assembler a debuggery na prácu s klasickým BPF.
Jazyk assemblera je veľmi podobný ladeniu výstupu tcpdump, ale navyše môžeme uvádzať symbolické štítky. Napríklad, tu je program, ktorý zamieta všetky pakety okrem TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Predvolene assembler generuje kód vo formáte , ,..., pre náš príklad s TCP to bude
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Pre pohodlie C programátorov sa dá použiť iný formát výstupu:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Tento text je možné skopírovať do definície štruktúry typu struct sock_filter, ako sme to urobili na začiatku tejto časti.
Rozšírenia Linux a netsniff-ng
Okrem štandardných inštrukcií BPF podporujú Linux a tools/bpf/bpf_asm tiež . V zásade, inštrukcie slúžia na prístup k poliam štruktúry struct sk_buff, ktorá popisuje sieťový paket v jadre. Avšak existujú aj pomocné inštrukcie iného typu, napríklad ldw cpu nahrá do registra A výsledok spustenia funkcie jadra raw_smp_processor_id(). (V novej verzii BPF sa tieto nestandardné rozšírenia rozšírili vo forme poskytovania programom súboru kernel helpers pre prístup k pamäti, štruktúram a generovanie udalostí.) Tu je zaujímavý príklad filtra, ktorý kopíruje do používateľského priestoru iba hlavičky paketov pomocou rozšírenia poff, offset payloadu:
ld poff
ret a
Rozšírenia BPF nebude možné použiť v tcpdump, ale je to dobrý dôvod na zoznámenie sa s balíkom utilít , ktorý okrem iného obsahuje pokročilý program netsniff-ng, ktorý, okrem filtrovania pomocou BPF, obsahuje aj efektívny generátor prevádzky, a pokročilejší, ako tools/bpf/bpf_asm, assembler BPF s názvom bpfc. Balík obsahuje dosť podrobnú dokumentáciu, pozri tiež odkazy na konci článku.
seccomp
Takže už vieme písať BPF programy ľubovoľnej zložitosti a sme pripravení pozrieť sa na nové príklady, prvý z nich — technológia seccomp, ktorá umožňuje pomocou filtrov BPF regulovať množstvo a sadu argumentov systémových volaní, dostupných tomuto procesu a jeho potomkom.
Prvá verzia seccomp bola pridaná do jadra v roku 2005 a netešila sa veľkej popularite, pretože poskytovala iba jedinú možnosť — obmedziť množstvo systémových volaní, dostupných procesu, na nasledujúce: read, write, exit a sigreturn, a proces, ktorý porušil pravidlá, bol ukončený pomocou SIGKILL. Avšak v roku 2012 bola do seccomp pridaná možnosť používať BPF filtre, ktoré umožňujú definovať množstvo povolených systémových volaní a dokonca vykonávať kontroly nad ich argumentmi. (Zaujímavé je, že jedným z prvých používateľov tejto funkčnosti bol Chrome a v súčasnosti sa ľudia z Chrome vyvíjajú mechanizmus KRSI, založený na novej verzii BPF, ktorý umožňuje prispôsobené Linux Security Modules.) Odkazy na ďalšiu dokumentáciu nájdete na konci článku.
Upozorňujeme, že na habre už boli články o používaní seccomp, možno niekto bude chcieť prečítať ich pred (alebo namiesto) čítania nasledujúcich podkapitol. V článku sú uvedené príklady používania seccomp, ako verzie z roku 2007, tak aj verzie s využitím BPF (filtre sú generované pomocou libseccomp), rozoberá sa súvislosť seccomp s Dockerom a tiež je tu veľa užitočných odkazov. V článku sa hovorí najmä o tom, ako pridávať čierne alebo biele zoznamy systémových volaní pre démonov riadených systemd.
Ďalej sa pozrieme, ako písať a načítať filtre pre seccomp v holom C a pomocou knižnice libseccomp a aké sú výhody a nevýhody každého variantu, a nakoniec sa pozrieme, ako sa seccomp používa programom strace.
Píšeme a načítavame filtre pre seccomp
Už vieme písať BPF programy, a preto sa najprv pozrieme na aplikačné rozhranie seccomp. Filter je možné nastaviť na úrovni procesu, pričom všetky podriadené procesy budú obmedzenia dedičmi. To sa robí pomocou systémového volania :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)kde &filter — to je ukazovateľ na už známu štruktúru struct sock_fprog, t.j. program BPF.
Čím sa programy pre seccomp líšia od programov pre sokety? Prenášaným kontextom. V prípade socketov nám bola prenášaná oblasť pamäte obsahujúca paket, a v prípade seccomp nám je prenášaná štruktúra typu
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Tu nr — to je číslo spúšťaného systémového volania, arch — aktuálna architektúra (o tom nižšie), args — až šesť argumentov systémového volania, a instruction_pointer — jež je označením na pokyn v uživatelském prostoru, který provedl tento systémový hovor. Takže například, abychom nahráli číslo systémového volání do registru, A musíme říci
ldw [0]Pro programy seccomp existují i další zvláštnosti, například přístup k kontextu je možný pouze po 32-bitovém zarovnání a nelze načítat půl slova nebo byte — při pokusu o načtení filtru ldh [0] systémový hovor seccomp vrátí EINVAL. Kontrolu načítaných filtrů provádí funkce jádra. (Zajímavé je, že v původním commitě, který přidal funkčnost seccomp, byla do této funkce zapomenuta přidat povolení pro použití instrukce mod (zbytek po dělení) a nyní není k dispozici pro programy seccomp BPF, protože její přidání ABI.)
V zásadě již víme vše, co je potřeba k psaní a čtení seccomp programů. Obvykle je logika programu nastavena jako bílý nebo černý seznam systémových hovorů, například program
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
prověřuje černý seznam ze čtyř systémových hovorů s čísly 304, 176, 239, 279. Co to jsou za systémové hovory? Nemůžeme říci přesně, protože nevíme, pro jakou architekturu byl program napsán. Proto autoři seccomp začít všechny programy kontrolou architektury (aktuální architektura je uvedena v kontextu jako pole arch struktury struct seccomp_data). S kontrolou architektury by začátek příkladu vypadal takto:
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
a pak by naše čísla systémových hovorů získala určitá hodnoty.
Píšeme a nahráváme filtry pro seccomp pomocí libseccomp
Psaní filtrů v strojových kódech nebo pro assembler BPF umožňuje získat plnou kontrolu nad výsledkem, ale zároveň je někdy výhodnější mít přenosný a/nebo čitelný kód. S tím nám pomůže knihovna , která poskytuje standardní rozhraní pro psaní černých nebo bílých filtrů.
Pojďme například napsat program, který spouští binární soubor vybraný uživatelem, přičemž předtím nastavíme černý seznam systémových hovorů z (program byl zjednodušen pro větší čitelnost, kompletní verzi lze nalézt ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
Na začátku definujeme pole sys_numbers z 40+ čísiel systémových volaní pre blokovanie. Potom inicializujeme kontext ctx a hovoríme knižnici, že chceme povoliť (SCMP_ACT_ALLOW) všetky systémové volania predvoleným spôsobom (je jednoduchšie budovať čierne zoznamy). Potom, jeden po druhom, pridáme všetky systémové volania z čierneho zoznamu. Na reakciu na systémové volanie z tohto zoznamu požiadame SCMP_ACT_TRAP, v tomto prípade seccomp pošle procesu signál SIGSYS s popisom toho, ktoré systémové volanie porušilo pravidlá. Nakoniec načítame program do jadra pomocou seccomp_load, ktorá skompiluje program a pripojí ho k procesu pomocou systémového volania seccomp(2).
Na úspešnú kompiláciu je potrebné program prelinkovať s knižnicou libseccomp, napríklad:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Príklad úspešného spustenia:
$ .\/seccomp_lib echo ok
ok
Príklad zablokovaného systémového volania:
$ sudo .\/seccomp_lib mount -t bpf bpf \/tmp
Zlé systémové volanie
Používame strace, aby sme zistili podrobnosti:
$ sudo strace -e seccomp .\/seccomp_lib mount -t bpf bpf \/tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ zabitý signálom SIGSYS (core dumped) +++
Zlé systémové volanie
odkiaľ môžeme zistiť, že program bol ukončený z dôvodu použitia zakázaného systémového volania mount(2).
Takže sme napísali filter pomocou knižnice libseccomp, umiestnili netriviálny kód do štyroch riadkov. V uvedenom príklade, ak je veľa systémových volaní, môže sa doba vykonávania výrazne znížiť, pretože kontrola je jednoducho zoznam porovnaní. Na optimalizáciu nedávno v libseccomp bol , ktorý pridáva podporu atribútu filtra SCMP_FLTATR_CTL_OPTIMIZE. Ak nastavíte tento atribút na hodnotu 2, filter sa pretransformuje na program binárneho vyhľadávania.
Ak chcete vidieť, ako sú nastavené filtre s binárnym vyhľadávaním, môžete sa pozrieť na , ktorý generuje takéto programy v assembleri BPF na základe sady čísel systémových volaní, napríklad:
$ echo 1 3 6 8 13 | .\/generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Nič výrazne rýchlejšie napísať nemožno, pretože programy BPF nemôžu vykonávať skoky po odsadení (nemôžeme, napríklad, jmp A alebo jmp [label+X]) a preto sú všetky skoky statické.
seccomp a strace
Všetci poznajú utilitu strace — nenahraditeľný nástroj pri skúmaní správania procesov na Linuxe. Mnohí však počuli aj o pri používaní tohto nástroja. Ide o to, že strace je realizovaný pomocou ptrace(2), a v tomto mechanizme nemôžeme určiť, na akom presnom súbore systémových volaní sa má proces zastaviť, t.j. napríklad príkazy
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
a
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
sa vykonávajú približne za rovnaký čas, aj keď v druhom prípade chceme sledovať iba jeden systémový hovor.
Nová možnosť --seccomp-bpf, pridaná vo strace verzii 5.3, umožňuje mnohonásobné zrýchlenie procesu a čas spustenia pod trasovaním jedného systémového volania je už porovnateľný s časom bežného spustenia:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Tu, samozrejme, existuje mierne klamstvo v tom, že nesledujeme základný systémový hovor tohto príkazu. Ak by sme sledovali, napríklad, newfsstat, tak strace by spomaľoval rovnako silno ako bez toho. --seccomp-bpf.)
Ako táto možnosť funguje? Bez nej strace sa pripája k procesu a spúšťa ho pomocou PTRACE_SYSCALL. Keď riadený proces spúšťa (akýkoľvek) systémový hovor, kontrola sa odovzdáva strace, ktorý sa pozrie na argumenty systémového volania a spúšťa ho pomocou PTRACE_SYSCALL. Po určitom čase proces ukončuje systémový hovor a pri jeho ukončení sa kontrola opäť odovzdáva strace, ktorý sa pozrie na návratové hodnoty a spúšťa proces pomocou PTRACE_SYSCALL, atď.
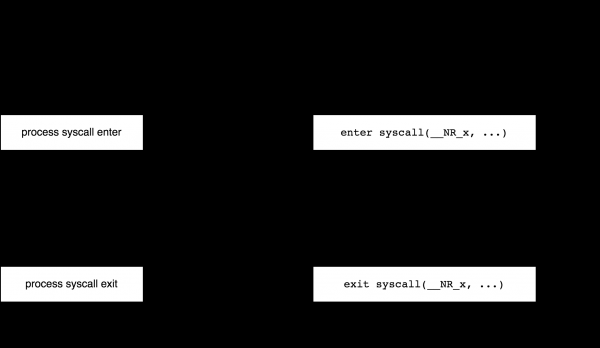
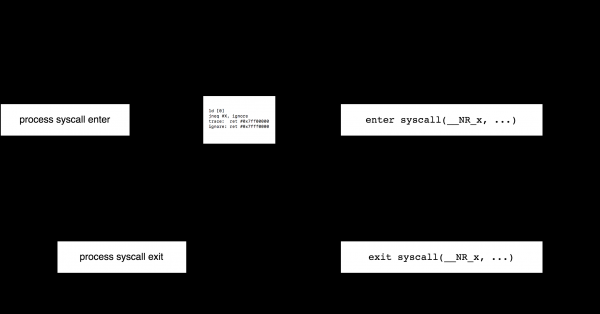
Pomocou seccomp, avšak, tento proces môžeme optimalizovať presne tak, ako by sme chceli. Ak chceme sledovať iba systémový hovor X, môžeme napísať BPF filter, ktorý pre X vracia hodnotu SECCOMP_RET_TRACE, a pre nezaujímavé volania — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
V tomto prípade strace najprv spúšťa proces ako PTRACE_CONT, na každý systémový hovor tento náš filter reaguje, ak systémový hovor nie je X, proces pokračuje v chode, ale ak je to X, tak seccomp odovzdá kontrolu strace, ktorý sa pozrie na argumenty a spustí proces ako PTRACE_SYSCALL (keďže v seccomp nie je možnosť spustiť program na výstupe zo systémového volania). Keď sa systémové volanie vráti, strace znovu spustí proces pomocou PTRACE_CONT a bude čakať na nové správy od seccomp.
Pri použití možnosti --seccomp-bpf existujú dve obmedzenia. Po prvé, nie je možné pripojiť sa k už existujúcemu procesu (možnosť -p programu strace), pretože to seccomp nepodporuje. Po druhé, nie je možné nie pozerať sa na podriadené procesy, pretože seccomp filtre sa dedia všetkými podriadenými procesmi bez možnosti to vypnúť.
Trochu podrobnejšie informácie o tom, ako presne strace funguje s seccomp je možné zistiť z . Pre nás je však najzaujímavejším faktom, že klasický BPF v podobe seccomp nachádza uplatnenie dodnes.
xt_bpf
Teraz sa vrátime späť do sveta sietí.
Pozadie: dávno, v roku 2007, bol do jadra pridaný modul xt_u32 pre netfilter. Bol napísaný na podobne ako ešte starší klasifikátor premávky cls_u32 a umožnil písať ľubovoľné binárne pravidlá pre iptables pomocou nasledujúcich jednoduchých operácií: načítať 32 bitov z paketu a vykonať s nimi súbor aritmetických operácií. Napríklad,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Načíta 32 bitov hlavičky IP, začínajúc od posunu 6, a použije na nich masku 0xFF (získať najnižší bajt). Toto je pole protocol hlavičky IP a porovnávame ho s 1 (ICMP). V jednom pravidle je možné kombinovať mnoho kontrol, navyše je možné vykonávať operátor @ — prejsť o X bajtov doprava. Napríklad, pravidlo
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"kontroluje, či sa TCP Sequence Number nerovná 0x29. Nebudem sa dosť podrobne rozpisovať, pretože už je jasné, že písať takéto pravidlá ručne nie je veľmi pohodlné. V článku , je niekoľko odkazov s príkladmi použitia a generovania pravidiel pre xt_u32. Pozri tiež odkazy na konci tohto článku.
Od roku 2013 je možné namiesto modulu xt_u32 použiť modul založený na BPF. xt_bpfVšetkým, ktorí sa dostali až sem, by mal byť jasný princíp jeho fungovania: spúšťať bajtkód BPF ako pravidlá iptables. Nové pravidlo je možné vytvoriť napríklad takto:
iptables -A INPUT -m bpf --bytecode <bajtkód> -j LOGtu <bajtkód> je kód v formáte výstupu assembleru bpf_asm podľa predvolenia, napríklad,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
V tomto príklade filtrujeme všetky UDP pakety. Kontext pre BPF program v module xt_bpf, samozrejme, ukazuje na údaje balíka, v prípade iptables – na začiatok hlavičky IPv4. Vracaná hodnota z BPF programu , kde nepravda znamená, že balík sa nezhoduje.
Je jasné, že modul xt_bpf podporuje zložitejšie filtre ako v uvedenom príklade. Pozrime sa na skutočné príklady od spoločnosti Cloudfare. Do nedávna používali modul xt_bpf na ochranu pred DDoS útokmi. V článku rozprávajú ako (a prečo) generujú BPF filtre a publikujú odkazy na súbor utilít na vytváranie takých filtrov. Napríklad pomocou nástroja bpfgen môžete vytvoriť BPF program, ktorý zodpovedá DNS dopytu na názov habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
V programe najprv načítame do registru X adresu začiatku reťazca x04habrx03comx00 vnútri UDP datagramu a potom overujeme dopyt: 0x04686162 "x04hab" a pod.
Netrvalo dlho a Cloudfare zverejnilo kód kompilátora p0f -> BPF. V článku rozprávajú o tom, čo je p0f a ako prevádzať p0f podpisy na BPF:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
V súčasnosti Cloudfare už nepoužíva xt_bpf, pretože prešli na XDP – jeden z variantov využitia novej verzie BPF, pozri. .
cls_bpf
Posledný z príkladov použitia klasického BPF v jadre – to je klasifikátor cls_bpf pre subsystém riadenia prevádzky v Linuxe, pridaný do Linuxu na konci roka 2013 a konceptuálne nahradil starý cls_u32.
Nehovoriac o tom, že teraz nebudeme opisovať jeho fungovanie cls_bpf, pretože z pohľadu znalostí o klasickom BPF to nám nič neprinesie – už sme sa oboznámili so všetkou funkcionalitou. Okrem toho, v nasledujúcich článkoch, ktoré rozprávajú o Extended BPF, sa s týmto klasifikátorom ešte stretneme.
Ďalší dôvod, prečo nezačať rozprávať o použití klasického BPF cls_bpf je ten, že v porovnaní s Extended BPF sa v tomto prípade dramaticky zúži oblasť použitia: klasické programy nemôžu meniť obsah paketov a nemôžu si uchovávať stav medzi volaniami.
Takže prišiel čas rozlúčiť sa s klasickým BPF a nahliadnuť do budúcnosti.
Rozlúčka s classic BPF
Pozreli sme na to, ako technológia BPF, vyvinutá na začiatku deväťdesiatych rokov, úspešne prežila štvrťstoročie a neustále nachádzala nové uplatnenia. Avšak, podobne ako prechod z zásobníkových strojov na RISC, ktorý podnietil vývoj klasického BPF, v dvoch tisíckach došlo k prechodu z 32-bitových na 64-bitové stroje a klasické BPF sa začalo stávať zastaraným. Okrem toho sú schopnosti klasického BPF veľmi obmedzené, a okrem zastaranej architektúry nemáme možnosť uchovávať stav medzi volaniami BPF programov, nemáme možnosť priamej interakcie s používateľom, nemáme možnosť interakcie s jadrom, okrem čítania obmedzeného počtu polí štruktúry. sk_buff a spustenia najjednoduchších pomocných funkcií, nie je možné meniť obsah paketov a preposielať ich.
V skutočnosti, v súčasnosti z klasického BPF v Linuxe zostal iba rozhraní API, a vo vnútri jadra sa všetky klasické programy, či už ide o filtre soketov alebo filtre seccomp, automaticky prekladajú do nového formátu, Extended BPF. (O tom, ako sa to presne deje, budeme hovoriť v nasledujúcom článku.)
Prechod na novú architektúru sa začal v roku 2013, keď Alexej Starovoitov navrhol schému aktualizácie BPF. V roku 2014 sa príslušné záplaty v jadre. Pokiaľ viem, pôvodne sa plánovalo len optimalizovať architektúru a JIT-compiler na efektívnejšiu prácu na 64-bitových strojoch, ale namiesto toho tieto optimalizácie otvorili novú kapitolu vo vývoji Linuxu.
Ďalšie články v tejto sérii sa budú venovať architektúre a aplikáciám novej technológie, pôvodne známej ako internal BPF, potom extended BPF, a teraz jednoducho ako BPF.
Odkazy
- Steven McCanne a Van Jacobson, "The BSD Packet Filter: A New Architecture for User-level Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: An Architecture and Optimization Methodology for Packet Capture",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — zabudnutý bajtkód:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Predstavenie nástroja BPF:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- Prehľad seccomp:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: pohľad pod kapotu",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Zdroj: habr.com
