

Jedným z typických scenárov vo všetkých bežných aplikáciách je vyhľadávanie údajov podľa určitých kritérií a ich zobrazenie v ľahko čitateľnej forme. Môžu tu byť aj ďalšie možnosti, ako je triedenie, skupinovanie a stránkovanie. Úloha je v zásade triviálna, avšak pri jej riešení mnohí vývojári robia množstvo chýb, ktoré následne ovplyvňujú výkon. Pokúsime sa preskúmať rôzne varianty riešenia tejto úlohy a formulovať odporúčania na výber najefektívnejšej implementácie.
Variant stránkovania #1
Najjednoduchší variant, ktorý napadne na prvý pohľad, je stránkovanie výsledkov vyhľadávania v jeho najklasickejšej podobe.
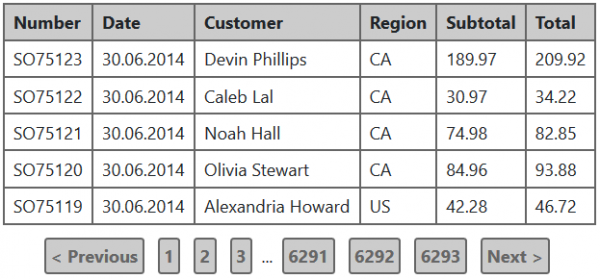
Predpokladajme, že v aplikácii sa používa relačná databáza. V tomto prípade na zobrazenie informácií v takto formáte bude potrebné vykonať dva SQL dotazy:
- Získať riadky pre aktuálnu stránku.
- Vypočítať celkový počet riadkov, ktoré spĺňajú vyhľadávacie kritériá — to je potrebné na zobrazenie stránok.
Pozrime sa na prvý dotaz na príklade testovacej MS SQL databázy pre server 2016. Na tento účel použijeme tabuľku Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Uvedený dotaz vyberie prvých 50 objednávok zo zoznamu, zoradených podľa dátumu pridania zostupne, inými slovami — 50 najnovších objednávok.
V testovacej databáze sa vykonáva rýchlo, ale poďme sa pozrieť na plán vykonania a štatistiku vstupu a výstupu:
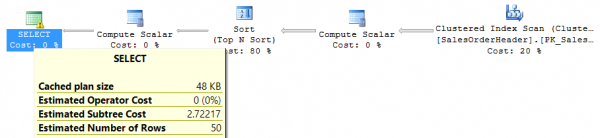
Tabuľka 'SalesOrderHeader'. Počet skenovaní 1, logické čítania 698, fyzické čítania 0, predbežné čítania 0, logické čítania LOB 0, fyzické čítania LOB 0, predbežné čítania LOB 0.Získať štatistiku vstupu/výstupu pre každý dotaz je možné vykonaním príkazu SET STATISTICS IO ON v prostredí vykonávania dotazov.
Ako je vidieť z plánu vykonania, najnáročnejšou operáciou je triedenie všetkých riadkov pôvodnej tabuľky podľa dátumu pridania. A problém je v tom, že čím viac riadkov sa v tabuľke objaví, tým ťažšie bude triedenie. V praxi by sa takýmto situáciám malo vyhnúť, preto pridáme index na dátum pridania a pozrieme sa, či sa zmenila spotreba zdrojov:
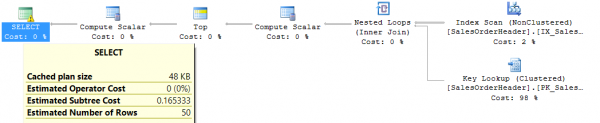
Tabuľka 'SalesOrderHeader'. Počet skenovaní 1, logické čítania 165, fyzické čítania 0, predbežné čítania 5, logické čítania LOB 0, fyzické čítania LOB 0, predbežné čítania LOB 0.
Je zrejmé, že je to oveľa lepšie. Ale sú všetky problémy vyriešené? Zmeníme dopyt na vyhľadávanie objednávok, kde celková cena tovaru presahuje 100 dolárov:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
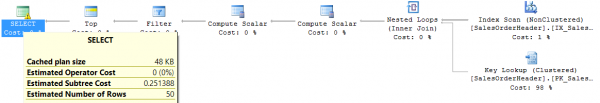
Tabuľka 'SalesOrderHeader'. Počet skenovaní 1, logické čítania 1081, fyzické čítania 0, čítania vopred 0, logické čítania lob 0, fyzické čítania lob 0, čítania vopred lob 0.Máme zábavnú situáciu: plán dopytu nie je výrazne horší ako predchádzajúci, ale skutočný počet logických čítaní je takmer dvakrát vyšší ako pri úplnom skenovaní tabuľky. Riešením je vytvoriť z existujúceho indexu zložený index a pridať ako druhé pole celkovú cenu tovaru, potom opäť získame 165 logických čítaní:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Túto sériu príkladov môžeme pokračovať dlho, ale dve hlavné myšlienky, ktoré tu chcem vyjadriť, sú:
- Pridanie akéhokoľvek nového kritéria alebo poradia triedenia do dopytu môže výrazne ovplyvniť rýchlosť jeho vykonania.
- Ale ak potrebujeme získať len časť údajov, a nie všetky výsledky, ktoré sú vhodné pre vyhľadávacie podmienky, existuje mnoho spôsobov, ako optimalizovať taký dopyt.
Teraz prejdime k druhému dopytu, spomenutému na začiatku – k tomu, ktorý počíta počet záznamov, ktoré spĺňajú vyhľadávaciu podmienku. Vezmime ten istý príklad – vyhľadávanie objednávok, ktoré sú drahšie ako 100 dolárov:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Pri existujúcom zloženom indexe, uvedenom vyššie, získame:
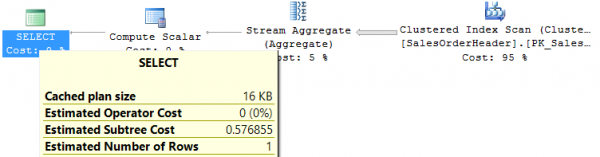
Tabuľka 'SalesOrderHeader'. Počet skenovaní 1, logické čítania 698, fyzické čítania 0, predbežné čítania 0, logické čítania LOB 0, fyzické čítania LOB 0, predbežné čítania LOB 0.Nie je prekvapením, že dopyt prechádza celým indexom, pretože pole SubTotal nie je na prvej pozícii, takže dopyt to nemôže využiť. Problém sa rieši pridaním ďalšieho indexu na pole SubTotal, a na záver to dá už len 48 logických čítaní.
Môžeme uviesť ešte niekoľko príkladov dopytov na počítanie, ale podstata zostane rovnaká: získanie dávky údajov a počítanie celkového počtu – to sú dva zásadne odlišné dopyty, a každý vyžaduje svoje opatrenia na optimalizáciu. Všeobecne nie je možné nájsť kombináciu indexov, ktorá by rovnako dobre fungovala pre oba dopyty.
Jedným z dôležitých požiadaviek, ktoré je potrebné objasniť pri vývoji takého vyhľadávacieho riešenia, je, či je pre podnik dôležité vidieť celkový počet nájdených objektov. Často sa ukáže, že nie. A navigácia podľa konkrétnych čísel stránok je podľa mňa riešením s veľmi úzkou oblasťou aplikácie, pretože väčšina scenárov s stránkovaním vyzerá ako „prejsť na ďalšiu stránku“.
Možnosť stránkovania #2
Predpokladajme, že užívateľom nezáleží na vedomosti o celkovom počte nájdených objektov. Pokúsme sa zjednodušiť vyhľadávaciu stránku:
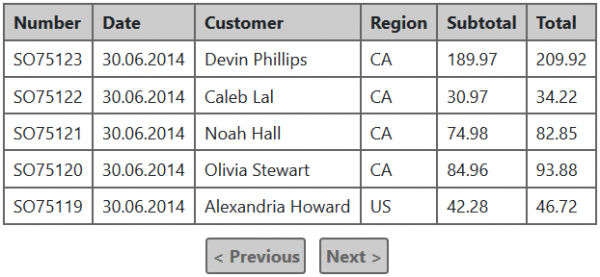
V skutočnosti sa zmenilo iba to, že už nie je možné prechádzať podľa konkrétnych čísel stránok, a teraz nie je potrebné, aby tento tabuľka vedela, koľko ich celkovo môže byť. Ale vzniká otázka — ako tabuľka zistí, či existujú údaje pre nasledujúcu stránku (aby správne zobrazila odkaz „Ďalšie“)?
Odpoveď je veľmi jednoduchá: môžete načítať z databázy o jeden záznam viac, než je potrebné na zobrazenie, a existencia tohto „ďalšieho“ záznamu ukáže, či je k dispozícii ďalšia dávka. Týmto spôsobom na získanie jednej stránky údajov bude potrebné vykonať iba jeden dotaz, čo výrazne zlepšuje výkon a uľahčuje podporu takejto funkčnosti. Mal som praktický prípad, keď vzdanie sa počítania celkového počtu záznamov zrýchlilo výstup výsledkov 4-5 krát.
Pre tento prístup existuje niekoľko variantov používateľského rozhrania: tlačidlá „späť“ a „dopredu“, ako v uvedenom príklade, tlačidlo „načítať viac“, ktoré jednoducho pridáva novú dávku do zobrazených výsledkov, „nekonečné posúvanie“, ktoré funguje na princípe „načítať viac“, ale signálom na získanie nasledujúcej dávky je posúvanie užívateľom všetkých vyvedených výsledkov až do konca. Nech je už vizuálne riešenie akékoľvek, princíp výberu údajov zostáva rovnaký.
Nuansy implementácie stránkovania
Vo všetkých príkladoch dopytov uvedených vyššie sa používa prístup „posun + počet“, keď sa v samotnom dopyte uvádza, z ktorej poradia riadkov výsledku a aké množstvo riadkov je potrebné vrátiť. Najprv sa pozrime, ako najlepšie organizovať prenos parametrov v tomto prípade. V praxi som sa stretol niekoľkými spôsobmi:
- Číselný index požadovanej stránky (pageIndex), veľkosť stránky (pageSize).
- Číselný index prvej položky, ktorú treba vrátiť (startIndex), maximálny počet položiek vo výsledku (count).
- Číselný index prvej položky, ktorú treba vrátiť (startIndex), číselný index poslednej položky, ktorú treba vrátiť (endIndex).
Na prvý pohľad sa môže zdať, že je to také jednoduché, že na tom nezáleží. Ale nie je to tak — najpohodlnejšou a najuniverzálnejšou možnosťou je druhá (startIndex, count). Na to existuje niekoľko dôvodov:
- Pre prístup s odčítaním +1 položky, ktorý bol uvedený vyššie, je prvá možnosť s pageIndex a pageSize mimoriadne nepraktická. Napríklad chceme zobraziť 50 položiek na stránke. Podľa uvedeného algoritmu je potrebné prečítať o jednu položku viac, než je potrebné. Ak tento „+1“ nie je zakomponovaný na serveri, dostaneme sa k tomu, že pre prvú stránku musíme žiadať položky od 1 do 51, pre druhú — od 51 do 101 atď. Ak stanovíme veľkosť stránky na 51 a zvyšujeme pageIndex, druhá stránka vráti položky od 52 do 102 atď. Preto v prvej možnosti je jediný spôsob, ako normálne implementovať tlačidlo pre prechod na ďalšiu stránku, zakomponovať na serveri oddelené „zbytočnú“ položku, čo bude veľmi nevypovedaný nuans.
- Tretia možnosť vôbec nemá zmysel, pretože pre vykonávanie dotazov vo väčšine databáz bude aj tak potrebné prenášať počet, nie index poslednej položky. Nech je odčítanie startIndex z endIndex a jednoduchá aritmetická operácia, ale tu je zbytočná.
Teraz je potrebné opísať nevýhody implementácie stránkovania cez „posun + množstvo“:
- Získanie každej nasledujúcej stránky bude nákladnejšie a pomalšie než predchádzajúcej, pretože databáze bude aj tak potrebné prejsť všetkými položkami „od začiatku“ podľa kritérií vyhľadávania a triedenia, a potom sa zastaviť na potrebnom úseku.
- Nie všetky SGBD môžu podporovať tento prístup.
Alternatívy existujú, ale ani tie nie sú dokonalé. Prvý z týchto prístupov sa nazýva „keyset paging“ alebo „seek method“ a spočíva v nasledujúcom: po získaní dávky si môžete zapamätať hodnoty polí v poslednej položke na stránke, a potom ich použiť na získanie nasledujúcej dávky. Napríklad, vykonali sme takýto dotaz:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
V poslednom zápise sme získali hodnotu dátumu objednávky ‘2014-06-29’. Ak sa chceme pokúsiť získať ďalšiu stránku, môžeme vykonať nasledujúce:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Problém je v tom, že OrderDate nie je unikátne pole a podmienka uvedená vyššie s veľkou pravdepodobnosťou preskočí veľa potrebných riadkov. Aby sme spravili tento dotaz jednoznačným, musíme k podmienke pridať unikátne pole (predpokladajme, že 75074 je posledná hodnota primárneho kľúča z prvej dávky):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Tento variant bude fungovať správne, ale vo všeobecnosti bude ťažké ho optimalizovať, pretože podmienka obsahuje operátor OR. Ak s rastom OrderDate rastie aj hodnota primárneho kľúča, podmienku môžeme zjednodušiť a ponechať len filter podľa SalesOrderID. Ale ak medzi hodnotami primárneho kľúča a poľom, podľa ktorého je výsledok zoradený, neexistuje prísna korelácia — v väčšine DBMS sa tomuto OR vyhnúť nedá. Mne známe výnimky sú PostgreSQL, kde je plne podporované porovnávanie k-tíc, a danú podmienku môžeme zapísať ako „WHERE (OrderDate, SalesOrderID) < (‘2014-06-29’, 75074)“. Pri prítomnosti zloženého kľúča s týmito dvoma poľami by mal byť takýto dopyt dostatočne jednoduchý.
Druhý alternatívny prístup môžeme vidieť napríklad v alebo — kde dopyt okrem údajov vracia špeciálny identifikátor, pomocou ktorého môžeme získať ďalšiu várku údajov. Ak má tento identifikátor neobmedzenú životnosť (ako v Comsos DB), je to vynikajúci spôsob implementácie stránkovania s postupným prechodom medzi stránkami (možnosť #2 uvedená vyššie). Jeho možné nevýhody: nie je podporovaný vo všetkých DBMS; získaný identifikátor ďalšej dávky môže mať obmedzenú životnosť, čo vo všeobecnosti nie je vhodné na realizáciu interakcie s používateľom (ako napríklad ElasticSearch scroll API).
Zložitá filtrácia
Súťaž zložíme ďalej. Predpokladajme, že sa objavil požiadavok implementovať tzv. faceted search, všetkým známe z internetových obchodov. Predchádzajúce príklady založené na tabuľke objednávok nie sú v tomto prípade veľmi pútavé, preto prejdeme na tabuľku Produkt z databázy AdventureWorks:
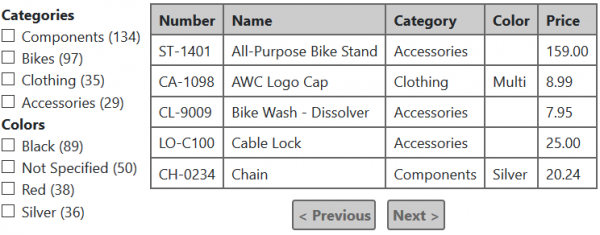
O čo ide vo faceted search? O to, že pre každý prvok filtra sa zobrazuje počet zaznamenaní, ktoré zodpovedajú tomuto kritériu. s ohľadom na filtre zvolených vo všetkých ostatných kategóriách..
Napríklad, ak vyberieme v tomto príklade kategóriu Bicykle a farbu Čierna, tabuľka zobrazí len bicykle čiernej farby, ale zároveň:
- Pre každý kritérium skupiny «Kategórie» sa zobrazí počet produktov z tejto kategórie čiernej farby.
- Pre každý kritérium skupiny «Farby» sa zobrazí počet bicyklov tejto farby.
Tu je príklad výstupu výsledkov pre takéto podmienky:
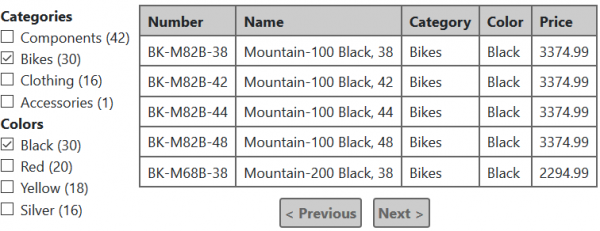
Ak navyše zaškrtneme kategóriu «Odevy», tabuľka zobrazí aj oblečenie čiernej farby, ktoré je k dispozícii. Počet produktov čiernej farby v sekcii «Farba» sa tiež prepočíta podľa nových podmienok, len v sekcii «Kategórie» sa nič nezmení… Dúfam, že týchto príkladov je dosť na pochopenie bežného algoritmu fungovania faceted search.
Teraz si predstavme, ako to môžeme implementovať v relačnej databáze. Každá skupina kritérií, ako je Kategória a Farba, si vyžaduje samostatný dopyt:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
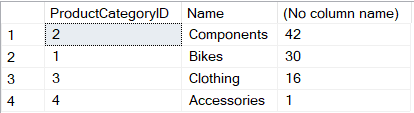
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bicykle
GROUP BY Color
ORDER BY COUNT(1) DESC
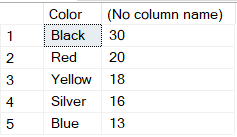
Čo je na tomto riešení zlé? Veľmi jednoducho — je ním zle škálovateľné. Každá sekcia filtra vyžaduje samostatný dopyt na počítanie množstiev a tieto dopyty nie sú práve najľahšie. V internetových obchodoch môžu byť v niektorých rubrikách aj niekoľko desiatok sekcií filtra, čo môže predstavovať vážny problém pre výkonnosť.
Obvykle po týchto tvrdeniach mi ponúkajú niektoré riešenia, a to:
- Spojiť všetky počty do jedného dotazu. Z technického hľadiska je to možné pomocou kľúčového slova UNION, ale výkonu to veľmi nepomôže — databáza bude musieť každý z fragmentov vykonať "od nuly".
- Kešovať počty. Toto mi navrhujú prakticky zakaždým, keď popisujem problém. Nuansa je v tom, že to je vo všeobecnosti nemožné. Predpokladajme, že máme 10 „fás” s 5 hodnotami v každej. To je veľmi „skromná“ situácia v porovnaní s tým, čo je možné vidieť v rovnakých internetových obchodoch. Výber jedného prvku fázy ovplyvňuje počty v 9 iných, inými slovami, pre každú kombináciu kritérií môžu byť počty rôzne. Celkovo v našom príklade existuje 50 kritérií, ktoré si môže používateľ vybrať, a teda existuje 250 možných kombinácií. Na naplnenie takejto dátovej štruktúry nebude dostatok pamäte ani času. Tu sa dá namietať a povedať, že nie všetky kombinácie sú reálne a používateľ zriedka vyberie viac ako 5-10 kritérií. Áno, je možné urobiť lenivú načítanie a kešovať počty len pre to, čo bolo kedy vybrané, ale čím viac bude možností výberu, tým menej efektívny bude taký keš a tým viditeľnejšie budú problémy s časom odozvy (najmä ak sa súbor údajov pravidelne mení).
Našťastie, podobná úloha už dávno má dostatočne efektívne riešenia, ktoré predvídateľne fungujú na veľkých objemoch údajov. Pre ktorúkoľvek z týchto možností má zmysel rozdeliť prepočet fás a získanie stránky výsledkov na dva paralelné požiadavky na server a usporiadať používateľské rozhranie tak, aby načítanie údajov o fázach „neprekážalo“ zobrazovaniu výsledkov vyhľadávania.
- Vyžaduje sa, aby bol celý prepočet „fásiek“ vykonávaný čo najr menos. Napríklad, netreba znova prepočítavať všetko pri každej zmene vyhľadávacích kritérií, namiesto toho nájdite celkový počet výsledkov, ktoré zodpovedajú aktuálnym podmienkam, a navrhnite používateľovi ich zobraziť — „Bolo nájdených 1425 záznamov, zobraziť?“ Používateľ môže buď pokračovať v zmene podmienok vyhľadávania, alebo stlačiť tlačidlo „zobraziť“. Iba v druhom prípade budú splnené všetky požiadavky na získanie výsledkov a prepočet počtov na všetkých „fáskach“. Pri tom, ako nie je ťažké si všimnúť, budeme musieť zvládnuť požiadavku na získanie celkového počtu výsledkov a jeho optimalizáciu. Tento prístup možno vidieť v mnohých malých internetových obchodoch. Je zrejmé, že to nie je všeliek na tento problém, ale v jednoduchých prípadoch môže byť celkom dobrým kompromisom.
- Použite vyhľadávací engin na vyhľadávanie výsledkov a počítanie fásiek, ako sú Solr, ElasticSearch, Sphinx a ďalšie. Všetky sú navrhnuté na konštrukciu „fásiek“ a robia to dostatočne efektívne vďaka inverznému indexu. Ako sú usporiadané vyhľadávacie systémy, prečo sú v týchto prípadoch účinnejšie než databázy všeobecného určenia, aké sú tu praktiky a úskalia — to je téma na samostatný článok. Chcem však poukázať na to, že vyhľadávací engin nemôže nahradiť hlavné úložisko dát, používa sa ako doplnok: akékoľvek zmeny v hlavnej databáze, ktoré sú dôležité pre vyhľadávanie, sa synchronizujú do vyhľadávacieho indexu; mechanizmus vyhľadávania bežne interaguje iba s vyhľadávacím enginom a neobráti sa na hlavnú databázu. Jeden z najdôležitejších aspektov tu — ako organizovať túto synchronizáciu spoľahlivo. Všetko závisí od požiadaviek na „čas reakcie“. Ak čas medzi zmenou v hlavnej databáze a jej „prejavením“ vo vyhľadávaní nie je kritický, je možné vytvoriť službu, ktorá každých pár minút hľadá nedávno zmenené záznamy a ich indexuje. Ak je potrebný minimálne možný čas reakcie, môžete implementovať niečo ako na odosielanie aktualizácií do vyhľadávacieho servisu.
Zhrnutie
- Implementácia stránkovania na strane servera je vážnym zložitým procesom a má zmysel ju aplikovať iba pre rýchlo rastúce alebo jednoducho veľké dáta. Neexistuje presný recept, ako posúdiť, čo je 'veľké' alebo 'rýchlo rastúce', ale ja by som sa držal tohto prístupu:
- Ak získanie celej kolekcie údajov s ohľadom na čas servera a prenos po sieti normálne spadá do požiadaviek na výkon, nemá zmysel realizovať stránkovanie na strane servera.
- Môže nastať situácia, že v blízkej dobe sa nepredpokladajú problémy s výkonom, pretože dáta sú málo, ale kolekcia údajov neustále rastie. Ak nejaký súbor údajov bude v budúcnosti pravdepodobne prestávať vyhovovať predchádzajúcemu bodu, je lepšie zahrnúť stránkovanie hneď.
- Ak z pohľadu podnikania neexistuje prísne požiadavky na zobrazenie celkového množstva výsledkov alebo na zobrazenie čísel stránok a vo vašom systéme nie je vyhľadávací engine, je lepšie tieto aspekty nerealizovať a zvážiť možnosť č. 2.
- Ak existuje jasné požiadavka na faceted search, máte dve možnosti, ako nestratiť výkon:
- Nemusíte prepočítavať všetky množstvá pri každej zmene kritérií vyhľadávania.
- Použiť vyhľadávací engine ako Solr, ElasticSearch, Sphinx a iné. Ale treba si uvedomiť, že nemôže byť náhradou za hlavnú databázu a mal by byť použitý ako doplnok k hlavnému úložisku na riešenie vyhľadávacích úloh.
- Rovnako pri faceted search má zmysel rozdeliť získanie stránok výsledkov vyhľadávania a prepočítanie množstva na dva paralelné dotazy. Prepočítanie množstva môže trvať dlhšie ako získanie výsledkov, pričom výsledky sú pre používateľa dôležitejšie.
- Ak používate SQL databázu na vyhľadávanie, akákoľvek zmena kódu týkajúca sa tejto časti by mala byť dôkladne testovaná z hľadiska výkonu na príslušnom objeme údajov (prevyšujúcom objem v 'živé' databáze). Odporúča sa tiež používať monitorovanie časov vykonávania dotazov na všetkých inštanciách databázy, a najmä — na 'živom'. Aj keď v štádiu vývoja plány dotazov vychádzali dobre, s rastom objemu dát sa situácia môže výrazne zmeniť.
Zdroj: habr.com
