

S Elasticsearch sa stretávajú mnohí. Ale čo sa stane, keď chceš s jeho pomocou ukladať logy „v osobitne veľkom objeme“? A navyše bezbolestne prežiť výpadok ktoréhokoľvek z viacerých dátových centier? Akú architektúru by si mal zvoliť a na aké nástrahy narazíš?
V Odnoklassnikách sme sa rozhodli vyriešiť otázku správy logov pomocou ElasticSearch a teraz sa delíme s Habróm o naše skúsenosti: ako o architektúre, tak aj o nástrahách.
Ja som Peter Zajcev, pracujem ako systémový administrátor v Odnoklassnikách. Predtým som bol tiež administrátorom a pracoval som s Manticore Search, Sphinx search a Elasticsearch. Možno, ak sa objaví nejaké ďalšie …search, pravdepodobne budem pracovať aj s ním. Takisto sa podieľam na viacerých open-source projektoch na dobrovoľnej báze.
Keď som prišiel do Odnoklassnikov, povedal som na pohovore, že viem pracovať s Elasticsearch. Po tom, čo som sa oboznámil a robil niektoré jednoduché úlohy, mi dali veľkú úlohu na reformovanie systému správy logov, ktorý v tom čase existoval.
Požiadavky
Požiadavky na systém boli formulované nasledovne:
- Ako front-end mal byť použitý Graylog, pretože v spoločnosti už mali skúsenosti s používaním tohto produktu, programátori a testeri ho poznali, bol pre nich známy a pohodlný.
- Objem údajov: v priemere 50-80 tisíc správ za sekundu, ale ak niečo zlyhá, tak prenos nie je nijako obmedzený, môže to byť 2-3 milióny riadkov za sekundu.
- Po diskusii s klientmi o požiadavkách na rýchlosť spracovania vyhľadávacích dotazov sme pochopili, že typický model používania takejto sústavy je taký: ľudia vyhľadávajú logy svojich aplikácií za posledné dva dni a nechcú čakať na výsledok dotazu dlhšie ako jednu sekundu.
- Administrátori trvali na tom, aby sa systém v prípade potreby ľahko škáloval, bez potreby hlbokého prenikania do jeho fungovania.
- Aby bola jediná úloha údržby, ktorá sa týmto systémom občas vyžadovala — to je zmeniť nejaký hardvér.
- Okrem toho, v Odnoklassnikách existuje skvelá technická tradícia: akýkoľvek servis, ktorý spúšťame, musí prežiť výpadok dátového centra (náhly, neplánovaný a úplne kedykoľvek).
Posledné požiadavky na realizáciu tohto projektu nám spôsobovali najväčšie ťažkosti, o čom sa ešte podrobnejšie zmienim.
Prostredie
Pracujeme na štyroch dátových centrách, pričom dátové uzly Elasticsearch môžu byť umiestnené iba v troch (z rôznych netechnických dôvodov).
V týchto štyroch dátových centrách sa nachádza približne 18 tisíc rôznych zdrojov logov – hardvérové zariadenia, kontajnery, virtuálne stroje.
Dôležitou vlastnosťou je, že klaster sa spúšťa v kontajneroch nie na fyzických strojoch, ale na . Kontajnerom sa garantuje 2 jadrá, podobné 2,0Ghz v4, s možnosťou využitia ostatných jadier v prípade ich nečinnosti.
Inými slovami:
Topológia
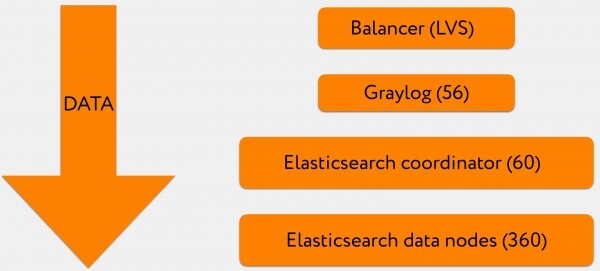
Celkový vzhľad riešenia sa mi na začiatku javil takto:
- 3-4 VIP sú za A-záznamom domény Graylog, to je adresa, na ktorú sa posielajú logy.
- každý VIP predstavuje load balancer LVS.
- Potom logy putujú na batériu Graylog, niektoré dáta idú vo formáte GELF, iné v formáte syslog.
- Následne sa to všetko vo veľkých dávkach zapisuje do batérie koordinátorov Elasticsearch.
- A tí zase odosielajú požiadavky na zápis a čítanie na relevantné dátové uzly.
Terminológia
Možno nie všetci podrobne rozumejú terminológii, preto by som sa rád na nej chvíľu zastavil.
V Elasticsearch existuje niekoľko typov uzlov – master, coordinator, data node. Sú tam aj ďalšie dva typy na rôzne transformácie logov a spojenie rôznych klastrov, ale my sme použili iba uvedené.
Master
Pingujú všetky uzly prítomné v klastri, udržujú aktuálnu mapu klastra a šíria ju medzi uzlami, spracovávajú logiku udalostí a zaisťujú rôznorodé správy na úrovni klastra.
Coordinator
Plní jednu jedinú úlohu: prijíma požiadavky od klientov na čítanie alebo zápis a smeruje tento prenos. V prípade, že ide o požiadavku na zápis, pravdepodobne sa opýta master, do ktorého shardu relevantného indexu to má umiestniť, a ďalej presmeruje požiadavku.
Data node
Uskladňuje dáta, vykonáva vyhľadávacie požiadavky prichádzajúce z vonku a operácie na umiestnených shardoch.
Graylog
Je to niečo podobné ako zliatina Kibana s Logstash v ELK stacku. Graylog kombinuje UI a spracovateľskú pipeline logov. Pod kapotou Graylog pracujú Kafka a Zookeeper, ktoré zabezpečujú konektivitu Graylog ako klaster. Graylog dokáže ukladať logy do vyrovnávacej pamäte (Kafka) pre prípad nedostupnosti Elasticsearch a opakovať neúspešné požiadavky na čítanie a zápis, grupovať a označovať logy podľa stanovených pravidiel. Rovnako ako Logstash, Graylog má funkčnosť na úpravu riadkov pred zápisom do Elasticsearch.
Okrem toho Graylog obsahuje vstavané nástroje na objavovanie služieb, ktoré umožňujú na základe jednej dostupnej uzly Elasticsearch získať celú mapu klasteru a filtrovať ju podľa konkrétneho tagu, čo umožňuje smerovať požiadavky na konkrétne kontajnery.
Vizualizácia vyzerá približne takto:

Toto je snímka obrazovky z konkrétneho inštancie. Tu vytvárame histogram na základe vyhľadávacieho dotazu a zobrazujeme relevantné riadky.
Indexy
Pri návrhu architektúry systému by som sa chcel podrobnejšie venovať tomu, ako sme konštruovali model indexov, aby to všetko fungovalo správne.
Na predchádzajúcej schéme to je najnižšia úroveň: Elasticsearch data nodes.
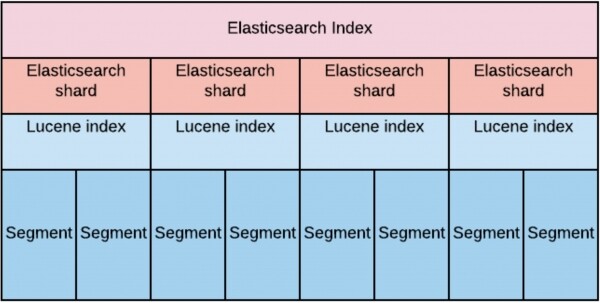
Index je veľká virtuálna entita pozostávajúca zo shardov Elasticsearch. Každý z shardov je ničím iným ako Lucene indexom. A každý Lucene index sa zase skladá z jedného alebo viacerých segmentov.
Pri projektovaní sme odhadovali, že na zabezpečenie požiadavky na rýchlosť čítania pri veľkom objeme dát je potrebné rovnomerne 'rozprestrieť' tieto dáta po dátových nodoch.
To vyústilo do toho, že počet shardov na index (s replikami) by mal byť presne rovný počtu dátových nodov. Po prvé, aby sme zabezpečili factor replikácie rovný dva (t.j. môžeme stratiť polovicu klasteru). A po druhé, aby sme mohli spracovávať požiadavky na čítanie a zápis aspoň na polovici klasteru.
Čas uchovávania sme najprv stanovili na 30 dní.
Rozdelenie shardov je možné graficky znázorniť nasledovne:
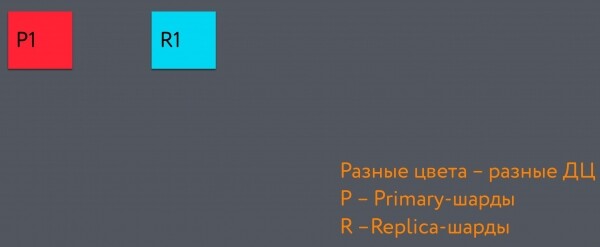
Celý tmavosivý obdĺžnik je index. Ľavý červený štvorec v ňom je primárny shard, prvý v indexe. A modrý štvorec je replica shard. Nachádzajú sa v rôznych dátových centrách.
Keď pridáme ďalší shard, umiestni sa do tretieho dátového centra. Nakoniec získame takúto štruktúru, ktorá umožňuje stratu dátového centra bez straty konzistencie údajov:
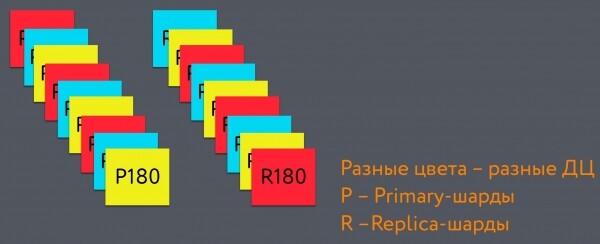
Rotáciu indexov, t.j. vytvorenie nového indexu a odstránenie najstaršieho, sme nastavili na 48 hodín (na základe vzoru používania indexu: za posledných 48 hodín sa hľadá najčastejšie).
Takýto interval rotácie indexov súvisí s nasledujúcimi dôvodmi:
Keď konkrétna dátová nód prijme vyhľadávací dotaz, z pohľadu výkonu je výhodnejšie, keď sa dotazuje len jeden shard, ak jeho veľkosť je porovnateľná s veľkosťou hromady nód. To umožňuje uchovávať "horúcu" časť indexu v hromade a rýchlo k nej pristupovať. Keď je veľa "horúcich častí", rýchlosť vyhľadávania v indexe sa zhoršuje.
Keď nód začína vykonávať vyhľadávací dotaz na jednom sharde, prideľuje počet vlákien rovný počtu hyper-threadingových jadier fyzického stroja. Ak vyhľadávací dotaz zasahuje do veľkého počtu shardov, počet vlákien rastie úmerne. To negatívne ovplyvňuje rýchlosť vyhľadávania a má zlý vplyv na indexáciu nových údajov.
Aby sme zabezpečili potrebnú latenciu vyhľadávania, rozhodli sme sa použiť SSD. Pre rýchle spracovanie dotazov museli mať stroje, na ktorých boli umiestnené tieto kontajnery, aspoň 56 jadier. Číslo 56 bolo vybrané ako podmienečne dostatočné množstvo, určujúce počet vlákien, ktoré Elasticsearch vytvorí počas práce. V Elasticsearch mnoho parametrov vlákien závisí priamo od počtu dostupných jadier, čo zas priamo ovplyvňuje potrebný počet nód v klastri podľa princípu "menej jadier — viac nód".
Nakoniec sme dostali, že v priemere shard váži približne 20 gigabajtov a na 1 index pripadá 360 shardov. Teda, ak ich rotujeme raz za 48 hodín, máme ich 15. Každý index obsahuje údaje za 2 dni.
Schémy zápisu a čítania údajov
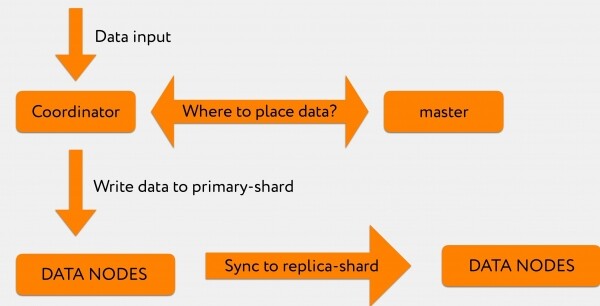
Pozrime sa, ako sa v tomto systéme zapisujú údaje.
Predpokladajme, že k nám z Graylogu prichádza na koordinátor nejaký dotaz. Napríklad, chceme indexovať 2-3 tisíce riadkov.
Koordinátor, ktorý dostal požiadavku z Graylogu, sa pýta mastera: „V požiadavke na indexovanie sme mali konkrétne uvedený index, ale do ktorého shardu to zapísať — nie je uvedené.“
Master odpovedá: „Zapíš tieto informácie do shardu číslo 71“, po čom je odoslaná priamo na relevantnú dátovú uzol, kde sa nachádza primary-shard číslo 71.
Potom sa log transakcií replikoval na replica-shard, ktorý sa už nachádza v inom dátovom centre.
Z Graylogu k koordinátorovi prichádza vyhľadávací dotaz. Koordinátor ho presmeruje podľa indexu, pričom Elasticsearch podľa princípu round-robin rozdeľuje dotazy medzi primary-shard a replica-shard.
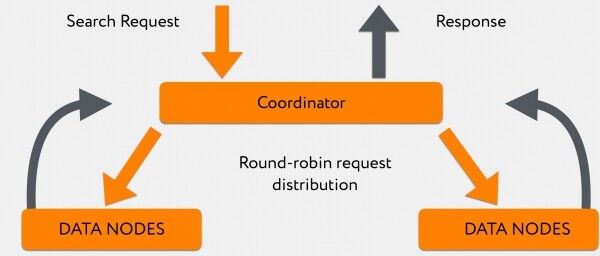
Uzly v počte 180 kusov odpovedajú nerovnomerne, a kým odpovedajú, koordinátor zhromažďuje informácie, ktoré už do neho „vypluvali“ rýchlejšie dátové uzly. Potom, keď buď všetky informácie prišli, alebo bol dosiahnutý timeout požiadavky, všetko odovzdá priamo klientovi.
Celý tento systém v priemere spracúva vyhľadávacie dotazy za posledných 48 hodín za 300-400ms, s výnimkou tých dotazov, ktoré majú leading wildcard.
„Kvety“ s Elasticsearch: nastavenie Javy
Aby to všetko fungovalo tak, ako sme pôvodne chceli, veľmi dlho sme dolaďovali najrôznejšie veci v klustri.
Prvá časť zistených problémov bola spojená s tým, ako je v Elasticsearch prednastavená Java.
Problém prvý
Pozorovali sme veľmi veľké množstvo hlásení, že na úrovni Lucene, keď sú spustené background joby, sa zlúčenia segmentov Lucene končia chybou. Pri tom bolo v logoch vidieť, že ide o OutOfMemoryError. Podľa telemetry sme videli, že hromada bola voľná a nebolo jasné, prečo táto operácia zlyháva.
Ukázalo sa, že zlúčenia indexov Lucene sa uskutočňujú mimo hromady. A kontajnery sú dosť prísne obmedzené vo využívaných zdrojoch. Do týchto zdrojov sa zmestila len hromada (hodnota heap.size bola približne rovná RAM), a nejaké off-heap operácie zlyhávali s chybou alokácie pamäte, ak nejakým spôsobom nevyhovovali tým ~500MB, ktoré zostávali do limitu.
Oprava bola celkom triviálna: dostupný objem RAM pre kontajner bol zvýšený, po čom sme zabudli na to, že takéto problémy sme vôbec mali.
Druhá problém
Po 4-5 dňoch po spustení klastru sme si všimli, že dátové uzly začínajú občas vypadávať z klastru a po 10-20 sekundách sa doňho opäť vracajú.
Keď sme sa začali ponárať do problému, zistili sme, že táto off-heap pamäť v Elasticsearch nie je prakticky vôbec kontrolovaná. Keď sme kontajneru pridali viac pamäte, získali sme možnosť naplniť priamy buffer pool rôznymi informáciami, a táto bola vyčistená iba po spustení explicitného GC zo strany Elasticsearch.
V niektorých prípadoch sa táto operácia odohrávala dosť dlho, a za tú dobu klaster stihol označiť túto uzol ako už neaktívnu. Tento problém je dobre zdokumentovaný. .
Riešenie bolo nasledovné: obmedzili sme Java schopnosť používať väčšinu pamäte mimo heap pre tieto operácie. Omezili sme ju na 16 gigabajtov (-XX:MaxDirectMemorySize=16g), a dosiahli sme to, že explicitný GC bol volaný výrazne častejšie a fungoval výrazne rýchlejšie, čím prestal destabilizovať klaster.
Tretí problém
Ak si myslíte, že problémy s "uzlami, ktoré opúšťajú klaster v najneočakávanejšom momente" sa týmto skončili, mýlite sa.
Keď sme konfigurovali prácu s indexmi, zamerali sme sa na mmapfs, aby v čerstvých shardoch s vysokou segmentáciou. To bola celkom hrubá chyba, pretože pri použití mmapfs je súbor namapovaný do operačnej pamäte, a potom pracujeme už s namapovaným súborom. Z tohto dôvodu pri pokuse GC zastaviť vlákna v aplikácii veľmi dlho smerujeme do safepointu, a po ceste tam aplikácia prestáva reagovať na požiadavky majstra týkajúce sa toho, či je stále aktívna. Pr accordingly, majster predpokladá, že uzol už nie je v klastri prítomný. Potom, po 5-10 sekundách, garbage collector funguje, uzol ožíva, opäť vstupuje do klastra a začína inicializáciu shardov. Všetko to veľmi pripomínalo "produkciu, ktorú sme si zaslúžili" a nehodilo sa na nič vážne.
Aby sme sa zbavili takého správania, najprv sme prešli na štandardný niofs a potom, keď sme z piatych verzií Elastic prešli na šieste, sme vyskúšali hybridfs, kde sa tento problém nevyskytoval. Podrobnejšie informácie o typoch úložiska nájdete tu. .
Štvrtý problém
Potom bola ešte veľmi zaujímavá situácia, ktorú sme riešili rekordne dlho. Lovili sme ju 2-3 mesiace, pretože sedel absolútne nejasný jej vzor.
Niekedy naši koordinátori prechádzali do Full GC, obvykle niekde po obede, a odtiaľ sa už nevrátili. Pri logovaní oneskorení GC to vyzeralo takto: všetko šlo dobre, dobre, dobre, a potom raz — a všetko bolo zrazu zlé.
Najprv sme si mysleli, že máme zlého používateľa, ktorý spúšťa nejaký dotaz, ktorý vyháňa koordinátora z pracovného režimu. Dlho sme logovali dotazy, snažiac sa zistiť, čo sa deje.
Nakoniec sa ukázalo, že v momente, keď nejaký používateľ spúšťa obrovský dotaz a ten sa dostane na konkrétneho koordinátora Elasticsearch, niektoré uzly reagujú dlhšie ako ostatné.
A ten čas, kým koordinátor čaká na odpoveď všetkých uzlov, si uchováva výsledky, ktoré posielajú už odpovedajúce uzly. Pre GC to znamená, že sa nám veľmi rýchlo mení vzor využívania heapu. A ten GC, ktorý sme používali, si s touto úlohou neporadil.
Jediné riešenie, ktoré sme našli na to, aby sme zmenili správanie klastra v takejto situácii — migrácia na JDK13 a použitie garbage collectora Shenandoah. To vyriešilo problém, koordinátori u nás už nepadali.
Na tomto sa problémy s Java skončili a začali problémy s priepustnosťou.
„Jahôdky“ s Elasticsearch: priepustnosť
Problémy s priepustnosťou znamenajú, že náš klaster funguje stabilne, ale v špičkách počtu indexovaných dokumentov a v okamihu manévrov je výkon nedostatočný.
Prvý zaznamenaný symptóm: pri nejakých „výbuchoch“ na produkcii, keď sa zrazu generuje veľmi veľké množstvo logov, sa v Graylog začína často objavovať chyba indexovania es_rejected_execution.
To sa dialo kvôli tomu, že thread_pool.write.queue na jednom data node do momentu, kým Elasticsearch stihne spracovať žiadosť na indexovanie a vložiť informácie do shardu na disk, predvolene môže cacheovať iba 200 žiadostí. A v o tomto parametri sa hovorí veľmi málo. Uvádza len maximálny počet vlákien a predvolené veľkosti.
Samozrejme, išli sme toto nastavenie upraviť a zistili sme nasledovné: konkrétne v našom nastavení sa celkom dobre cacheuje až 300 žiadostí, a vyššia hodnota je spojená s tým, že opäť prejdeme do Full GC.
Okrem toho, keďže ide o balíky správ, ktoré prichádzajú v rámci jednej požiadavky, bolo potrebné prispôsobiť Graylog, aby zapisoval nie často a malými dávkami, ale obrovskými dávkami alebo raz za 3 sekundy, ak dávka ešte nie je plná. V takom prípade informácie, ktoré zapisujeme do Elasticsearch, nie sú dostupné za dve sekundy, ale za päť (čo nám vyhovuje), ale znižuje sa počet retrie, ktoré musíme vykonať, aby sme posunuli väčší balík informácií.
To je obzvlášť dôležité v momentoch, keď nám niečo niekde spadne a bez prestania o tom informuje, aby sme nedostali úplne spamovaný Elastic a po nejakom čase, aby nefungovali uzly Graylog kvôli upchatým bufferom.
Okrem toho, keď sa na produkcii vyskytli tieto výbuchy, dostávali sme sťažnosti od programátorov a testerov: v momente, keď potrebovali tieto logy, boli im poskytované veľmi pomaly.
Začali sme sa zaoberať situáciou. Z jednej strany bolo jasné, že vyhľadávacie požiadavky aj požiadavky na indexáciu spracovávajú v podstate na rovnakých fyzických strojoch, a tak či onak budú určité poklesy.
Ale toto sa dalo čiastočne obísť tým, že v šiestych verziách Elasticsearch bol zavedený algoritmus, ktorý umožňuje rozdeľovať požiadavky medzi relevantné dátové uzly, nie náhodne podľa round-robin (kontajner, ktorý sa zaoberá indexovaním a drží primary-shard, môže byť veľmi zaťažený, a nebude mať možnosť rýchlo odpovedať), ale nasmerovať túto požiadavku na menej zaťažený kontajner s replica-shard, ktorý odpovie podstatne rýchlejšie. Inými slovami, prešli sme na use_adaptive_replica_selection: true.
Obraz čítania začína vyzerať takto:
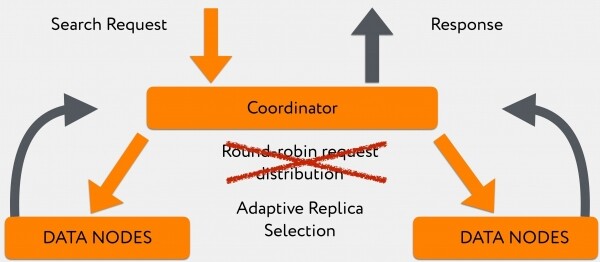
Prechod na tento algoritmus umožnil výrazne zlepšiť čas dotazovania v momentoch, keď sme mali veľký tok logov na zápis.
Nakoniec, hlavný problém spočíval v bezbolestnom vytiahnutí dátového centra.
Čo sme chceli od klastra hneď po strate spojenia s jedným DČ:
- Ak máme v odpadnutej dátovom centre aktuálny master, bude opätovne vybraný a presunie sa ako rola na iný uzol v inom DČ.
- Master rýchlo vyhodí zo klastra všetky nedostupné uzly.
- Na základe zostávajúcich shárd pochopí: v stratenej dátovom centre sme mali takéto primary shardy, rýchlo promuťujeme komplementárne replica shardy v zostávajúcich dátových centrách a budeme pokračovať v indexovaní dát.
- V dôsledku toho nám bude plynule degradovať priepustnosť klastera na zápis a čítanie, avšak celkovo všetko bude fungovať pomaly, ale stabilne.
Ako sa ukázalo, chceli sme niečo takéto:
A dostali sme nasledovné:
Ako sa to stalo?
V momente pádu dátového centra sa naším úzkym miestom stal master.
Prečo?
Ide o to, že v masteri je TaskBatcher, ktorý zodpovedá za rozšírenie určitých úloh a eventov v klastri. Každý výpadok nody, každý prechod shardu z replica na primary, akákoľvek úloha na vytvorenie nejakého shardu — toto všetko najprv prechádza cez TaskBatcher, kde je spracované postupne a v jednom vlákne.
V momente výpadku jedného dátového centra sa všetky dátové nody v prežívajúcich dátových centrách považovali za svoju povinnosť informovať mastera, že "nám sa stratili takéto shardy a takéto dátové nody".
Pri tom prežívajúce dátové nody posielali všetky tieto informácie aktuálnemu masterovi a snažili sa počkať na potvrdenie, že ho prijal. To sa im nedarilo, pretože master dostával úlohy rýchlejšie, než stihol odpovedať. Nody opakovali požiadavky po timeoutoch, zatiaľ čo master už vlastne ani nesnažil odpovedať, bol úplne pohltený úlohou triedenia požiadaviek podľa prioritného poradia.
V terminálnom pohľade to vyzeralo tak, že dátové nody spamovali mastera až do bodu, že prešiel do full GC. Po tom sa naša rola mastera presunula na nejakú nasledujúcu nodu, s ňou sa dialo presne to isté a nakoniec sa klaster úplne rozpadol.
Robili sme merania a do verzie 6.4.0, kde to bolo opravené, nám stačilo vypnúť súčasne len 10 dátových nodov zo 360, aby sme úplne zrazili klaster.
Vyzeralo to približne takto:
Po verzii 6.4.0, kde opravili tento strašný bug, dátové nody prestali zabíjať mastera. Ale „inteligentnejší“ sa od toho nestal. A síce: keď vypneme 2, 3 alebo 10 (akékoľvek množstvo okrem jedného) dátových nodov, master dostane nejakú prvú správu, ktorá hovorí, že noda A sa vypnula, a snaží sa o tom informovať nodu B, nodu C, nodu D.
A moment ago, the only way to tackle this was to set a timeout for attempts to inform someone about something, roughly equal to 20-30 seconds, thus managing the data center's output speed from the cluster.
In principle, this aligns with the requirements that were initially laid out for the final product within the framework of the project, but from a ‘pure science’ standpoint, this is a bug. By the way, it was successfully fixed by the developers in version 7.2.
Moreover, when a particular data node went down, it turned out that disseminating information about its exit was more important than informing the entire cluster that certain primary shards were on it (to promote the replica shard in another data center to primary, where information could be written).
Therefore, once everything has 'settled down', the outgoing data nodes are not immediately marked as stale. Consequently, we are forced to wait until all pings to the exited data nodes timeout, and only after that, our cluster starts to report that information should continue to be written in various locations. You can read more about this. .
As a result, the operation for removing the data center currently takes us around 5 minutes during peak hours. For such a large and unwieldy machine, that’s quite a good result.
Eventually, we arrived at the following solution:
- We have 360 data nodes with disks of 700 gigabytes each.
- 60 coordinators for routing traffic across these data nodes.
- 40 masters, which we retained as a sort of legacy from versions prior to 6.4.0 — to endure the data center’s exit, we were mentally prepared to lose a few machines to ensure that even in the worst-case scenario we would have a quorum of masters.
- Any attempts to combine roles in one container faced the issue that sooner or later, the node would fail under load.
- In the entire cluster, a heap.size of 31 gigabytes is used: all attempts to reduce the size led to either some nodes being killed on heavy search queries with leading wildcard or a circuit breaker being tripped in Elasticsearch itself.
- Additionally, to ensure search performance, we tried to keep the number of objects in the cluster as minimal as possible, in order to handle as few events as we could in the narrowest part, which we experienced in the master.
Lastly, regarding monitoring
Aby to všechno fungovalo tak, jak má, monitorujeme následující:
- Každé datové uzel hlásí do našeho cloudu, že existuje, a na něm se nacházejí určité shard. Když někde něco vypneme, cluster během 2-3 sekund reportuje, že v centru A jsme vypnuli uzly 2, 3 a 4 — to znamená, že v jiných datových centrech nesmíme vypínat ty uzly, na kterých zůstaly shardy v jediném exempláři.
- Vzhledem k chování masteru velmi pečlivě sledujeme počet pending úloh. Protože i jedna visící úloha, pokud se včas neodstaví, teoreticky v nějaké krizové situaci může být příčinou, proč neproběhne například propagace replica shardu do primary, což způsobí zastavení indexace.
- Dále velmi pečlivě sledujeme zpoždění garbage collector, protože jsme s tím už měli velké problémy při optimalizaci.
- Zamítání podle vláken, abychom předem zjistili, kde se nachází "úzké hrdlo".
- No a standardní metriky, jako heap, RAM a I/O.
Při budování monitoringu je nutné zohlednit specifika Thread Pool v Elasticsearch. popisuje možnosti nastavení a výchozí hodnoty pro vyhledávání, indexaci, ale zcela mlčí o thread_pool.management. Tyto vlákna zpracovávají mimo jiné dotazy typu _cat/shards a další podobné, které jsou pohodlné pro psaní monitorování. Čím větší je cluster, tím více těchto dotazů je vykonáváno za jednotkový čas, a výše zmíněný thread_pool.management, nejen že není zastoupen v oficiální dokumentaci, ale navíc je podle defaultu limitován na 5 vláken, což se velmi rychle využije, po čemž monitorování přestává správně fungovat.
Co bychom chtěli říci na závěr: uspěli jsme! Dokázali jsme našim programátorům a vývojářům poskytnout nástroj, který v podstatě v jakékoli situaci dokáže rychle a spolehlivě poskytnout informace o tom, co se děje v produkci.
Ano, bylo to docela složité, ale přesto se nám podařilo naše požadavky zakomponovat do již existujících produktů, které nebylo nutné patchovat a přepisovat.
Zdroj: habr.com
