

V správe sú uvedené niektoré prístupy, ktoré umožňujú sledovať výkon SQL dotazov, keď ich je milióny denne, a spravovaných serverov PostgreSQL — stovky.
Aké technické riešenia nám umožňujú efektívne spracovávať taký objem informácií a ako to uľahčuje život bežného vývojára.
Koho zaujíma rozbor konkrétnych problémov a rôzne techniky optimalizácie SQL dotazov a riešenia typických úloh DBA v PostgreSQL — môžete sa tiež na túto tému.
Volám sa Kirill Borovikov, zastupujem . Konkrétne sa špecializujem na prácu s databázami v našej spoločnosti.
Dnes vám poviem, ako sa zaoberáme optimalizáciou dotazov, keď potrebujete nie „rozpitvať“ výkon nejakého jedného dotazu, ale riešiť problém hromadne. Keď je dotazov milióny a potrebujete nájsť nejaké prístupy k riešeniu tohto veľkého problému.
Vo všeobecnosti, „Tensor“ pre milión našich klientov — to je : firemná sociálna sieť, riešenia pre videohovory, pre vnútorné a vonkajšie obehy dokumentov, účtovné systémy pre účtovníctvo a sklad,... Teda akýsi „megakombajn“ pre komplexné riadenie podnikania, v ktorom je viac ako 100 rôznych interných projektov.
Aby všetky fungovali normálne a rozvíjali sa — máme 10 vývojových centier po celej krajine, v nich — viac 1000 vývojárov.
S PostgreSQL pracujeme od roku 2008 a nazbierali sme veľký objem dát, ktoré spracovávame — sú to klientské údaje, štatistické, analytické, údaje z externých informačných systémov — viac ako 400TB. Iba „v produkcii“ máme okolo 250 serverov, a celkovo DB serverov, ktoré monitorujeme — okolo 1000.
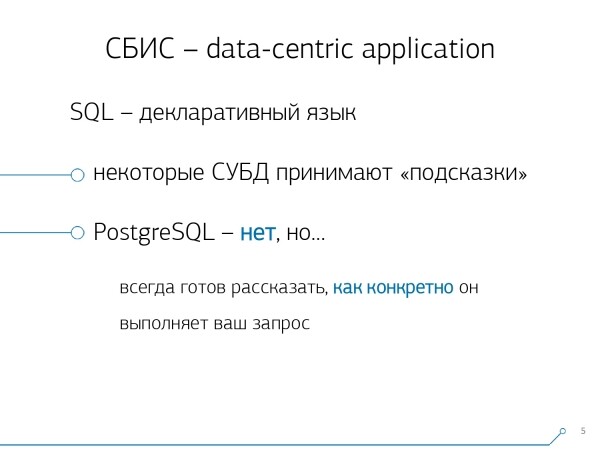
SQL je deklaratívny jazyk. Popisujete nie „ako“ by malo niečo fungovať, ale „čo“ chcete získať. DBMS lepšie vie, ako robiť JOIN — ako spojiť vaše tabuľky, aké podmienky uložiť, čo pôjde podľa indexu, čo nie...
Niektoré DBMS prijímajú nápovedy: „Nie, tieto dve tabuľky spoj v určitej poradí“, ale PostgreSQL to takto nevie. To je zámerná pozícia hlavných vývojárov: „Radšej doladíme optimalizátor dotazov, ako by sme dovolili vývojárom používať nejaké tipy“.
Ale, aj keď PostgreSQL nedáva „zvonku“ spravovať seba, veľmi dobre umožňuje vidieť, čo sa deje vo vnútri, keď vykonávate svoj dopyt, a kde sa v ňom objavujú problémy.
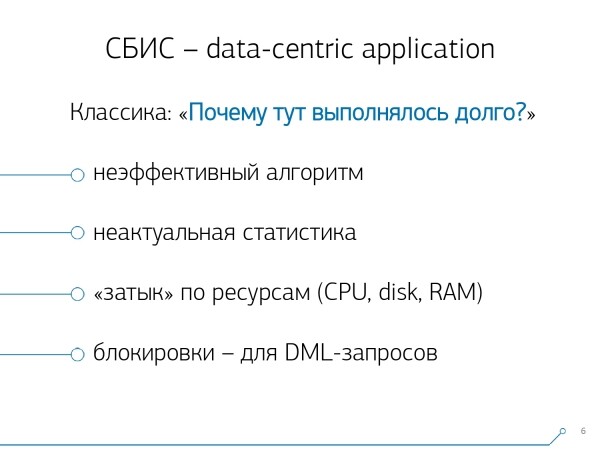
Pri klasických problémoch, s ktorými sa vývojári [sú DBA] zvyčajne stretávajú, sú: „Tu sme vykonali dopyt a všetko nám ide pomaly, všetko zamrzlo, niečo sa deje... Nešťastie!“Dôvody sú takmer vždy rovnaké:
neefektívny algoritmus dopytu
- Vývojár: „Práve teraz v SQL robím 10 tabuliek cez JOIN...“ — a očakáva, že sa jeho podmienky zázračne „vyriešia“ a dostane výsledky rýchlo. Ale zázraky sa nedejú, a akýkoľvek systém pri takej variabilite (10 tabuliek v jednom FROM) vždy spôsobí nejakú chybu. [
Tento moment je veľmi aktuálny pre PostgreSQL, keď ste na server nahrali veľký dátový súbor, robíte dopyt — a on vám „sekvenčne skenuje“ tabuľku. Pretože včera v nej bolo 10 záznamov, ale dnes 10 miliónov, no PostgreSQL o tom ešte nevie, a je potrebné mu to oznámiť. [] - neaktuálna štatistika
Nainštalovali ste veľkú a ťažkú zaťaženú databázu na slabý server, ktorému chýba miesto na disku, pamäť, výkon procesora. A koniec... Kdekoľvek je strop výkonu, nad ktorý sa už nedá preskočiť.] - problém so zdrojmi
Zložitý moment, ale sú najaktuálnejšie pre rôzne modifikačné dopyty (INSERT, UPDATE, DELETE) — to je samostatná veľká téma. - zámky
Získanie plánu
… A na všetko ostatné potrebujeme
plán! Musíme vidieť, čo sa deje vo vnútri servera.Plán vykonania dopytu pre PostgreSQL — je to strom algoritmu vykonania dopytu v textovej podobe. Práve ten algoritmus, ktorý výsledkom analýzy plánovačom bol považovaný za najefektívnejší.
Každý uzol stromu — operácia: získavanie údajov z tabuľky alebo indexu, vytvorenie bitovej mapy, spojenie dvoch tabuliek, zlúčenie, priesečník alebo vylúčenie výberov. Vykonanie dopytu — prechod cez uzly tohto stromu.
Najjednoduchší spôsob, ako získať plán dopytu, je vykonať príkaz
EXPLAIN . Ak chcete získať so všetkými skutočnými atribútmi, t.j. naozaj vykonať dopyt na databáze —EXPLAIN (ANALYZE, BUFFERS) SELECT ... EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Zlá situácia: keď to vykonávate, deje sa to „tu a teraz“, takže je to vhodné len na lokálnu ladenie. Ak vezmete nejaký silne zaťažený server, ktorý čelí silnému toku zmien dát, a vidíte: „Au! Tu nám pomaly vykonávalsa dopyt.“ Pol hodiny, hodinu dozadu — kým ste behali a vyťahovali tento dopyt z logov, znovu ste ho preniesli na server, váš celý dataset a štatistika sa zmenili. Vykonávate ho na ladenie — a vykonáva sa rýchlo! A nemôžete pochopiť „prečo“, prečo bolo pomalý.
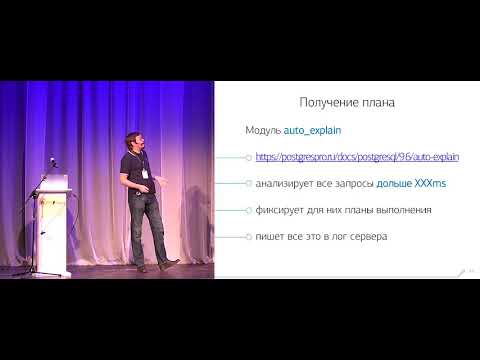
Aby ste pochopili, čo sa presne stalo v okamihu, keď sa dopyt vykonáva na serveri, múdri ľudia napísali . Tento modul je prítomný prakticky vo všetkých najpopulárnejších distribúciách PostgreSQL a dá sa jednoducho aktivovať v konfiguračnom súbore.
Ak zistí, že nejaký dopyt sa vykonáva dlhšie, ako je hranica, ktorú ste mu pridelili, urobí „snapshot“ plánu tohto dopytu a zapíše ich spoločne do logu.
Zdá sa, že všetko je teraz v poriadku, ideme do logu a vidíme tam… [nával textu]. Ale nemôžeme o ňom povedať nič iné, len to, že je to skvelý plán, pretože sa vykonával 11ms.
Zdá sa, že všetko je v poriadku - ale nič nie je jasné, čo sa naozaj deje. Okrem celkového času osobitne nič nevidíme. Pretože sa na takúto „latuchu“ plain text navrhuje vôbec nepozerať.
Ale aj keď je to neprehľadné, a aj keď je to nepohodlné, existujú vážnejšie problémy:
- V uzle sa uvádza suma zdrojov celého podstromu pod ním. To znamená, že nemôžeme jednoducho zistiť, koľko bolo konkrétne na tomto Index Scan vynaloženého času - ak pod ním existuje nejaká vnorená podmienka. Musíme dynamicky sledovať, či neexistujú vnútorné „deti“ a podmienené premenné, CTE - a všetko to „v hlave“ odpočítať.
- Druhým bodom je: čas, ktorý je uvedený na uzle, je čas jednorazového vykonania uzla. Ak sa tento uzol vykonával ako výsledok napríklad cyklu po záznamoch tabuľky viackrát, potom sa v pláne zvyšuje počet slučiek - cyklov tohto uzla. Ale samotný čas atomárneho vykonania zostáva v pláne rovnaký. To znamená, aby sme pochopili, koľko sa tento uzol celkovo vykonával, musíme jedno vynásobiť iným - opäť „v hlave“.
S takýmito predpokladmi je prakticky nemožné pochopiť, kto je "najslabším článkom". Preto aj samotní vývojári v "manuáli" uvádzajú, že "Porozumenie plánu je umenie, ktoré sa treba učiť, skúsenosť...".
Ale máme 1000 vývojárov a každému z nich túto skúsenosť nemôžeš vložiť do hlavy. Ja, ty, on — vieme, ale niekto tam vzadu — už nie. Možno sa naučí, a možno aj nie, ale pracovať musí už teraz — a odkiaľ by mal získať túto skúsenosť.
Vizualizácia plánu
Preto sme pochopili — aby sme sa s týmito problémami vyrovnali, potrebujeme dobrú vizualizáciu plánu.
Najskôr sme sa pozreli "na trh" — poďme sa na internete pozrieť, čo vôbec existuje.
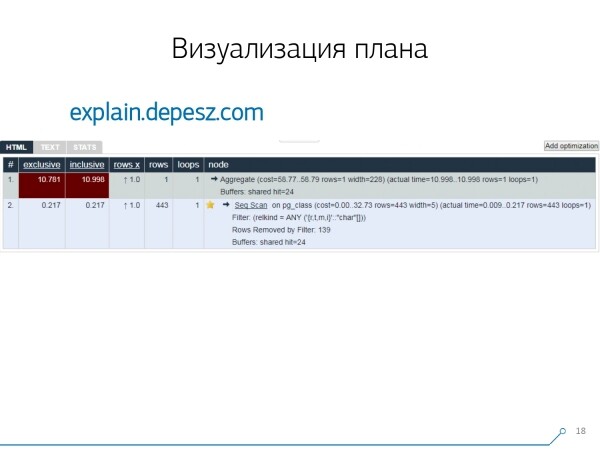
Ale ukázalo sa, že relatívne "živé" riešenia, ktoré sa nejako vyvíjajú, sú veľmi málo — doslova jedno: od Huberta Lubaczewského. Na vstup do poľa "vkladáš" textovú reprezentáciu plánu, on ti zobrazí tabuľku so spracovanými údajmi:
- vlastný čas spracovania uzla
- čas súhrnného celku celého podstromu
- počet záznamov, ktoré boli extrahované a ktoré sa štatisticky očakávali
- samotné telo uzla
Tento servis má tiež možnosť zdieľať archív odkazov. Hodíš tam svoj plán a povieš: "Hej, Vašo, tu máš odkaz, tam je niečo zle."
Ale sú aj malé problémy.
Po prvé, obrovské množstvo "kopírovania a vkladania". Berieš kus logu, vkladáš to tam a znova, a znova.
Po druhé, nie je analýza počtu prečítaných údajov - tých istých buffers, ktoré vyhodnocuje EXPLAIN (ANALYZE, BUFFERS), tu nevidíme. Jednoducho nevie analyzovať, porozumieť a pracovať s nimi. Keď čítaš veľa údajov a uvedomíš si, že môžeš nesprávne "rozložiť" na disku a v pamäťovom cache, táto informácia je veľmi dôležitá.
Tretí negatívny bod — veľmi slabý rozvoj tohto projektu. Comity sú veľmi maličké, dobre ak raz za pol roka, a kód je na Perl.
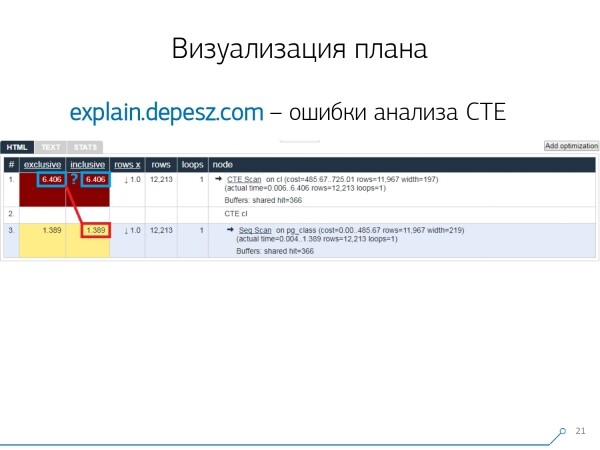
Ale to všetko sú "lyriku", s tým by sa dalo nejako žiť, ale je tu jedna vec, ktorá nás silno od tohto servisu odradila. To sú chyby analýzy Common Table Expression (CTE) a rôznych dynamických uzlov ako InitPlan/SubPlan.
Ak veríme tejto obrázku, tak súhrnný čas vykonania každého jednotlivého uzla je väčší, než celkový čas vykonania celého dopytu. Všetko je jednoduché — z uzla CTE Scan nebol odpočítaný čas generovania tejto CTE. Preto už nevieme správnu odpoveď, koľko času samotné skenovanie CTE zaberalo.
Tu sme si uvedomili, že je čas písať svoje — hurá! Každý vývojár hovorí: „Teraz napíšeme svoje, bude to super jednoduché!“
Vzali sme typický pre webové služby stack: jadro na Node.js + Express, natiahli Bootstrap a pre krásne diagramy — D3.js. A naše očakávania sa celkom naplnili — prvý prototyp sme dostali za 2 týždne:
- vlastný parser plánu
To znamená, že teraz môžeme analyzovať akýkoľvek plán z tých, ktoré generuje PostgreSQL. - správna analýza dynamických uzlov — CTE Scan, InitPlan, SubPlan
- analýza rozdelenia buffers — kde sa stránky dát čítajú z pamäte, kde z lokálneho cache, kde z disku
- dostali sme prehľadnosť
Aby sme nemuseli v logu hľadať všetko toto „kopaním“, ale videli „najslabšie miesto“ hneď na obrázku.
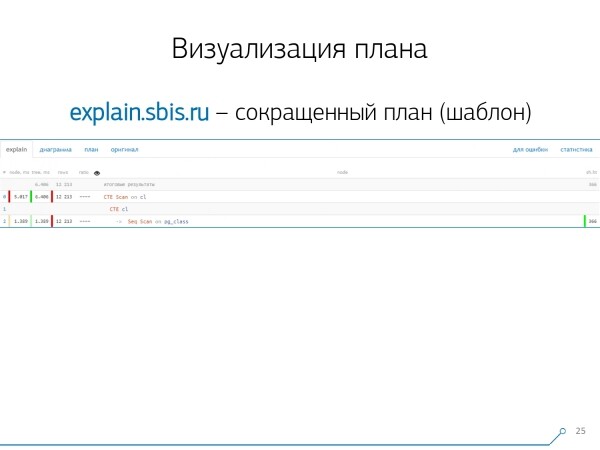
Dostali sme približne takýto obrázok — hneď s farebným zvýraznením syntaxe. Ale zvyčajne naši vývojári pracujú už nie s kompletným zobrazením plánu, ale s tým, čo je kratšie. Pretože všetky čísla sme už rozparsovali a hodili doľava-doprava, a uprostred sme nechali iba prvý riadok, ktorý uzol je: CTE Scan, generovanie CTE alebo Seq Scan pre nejakú tabuľku.
Toto skrátené zobrazenie nazývame šablónou plánu.
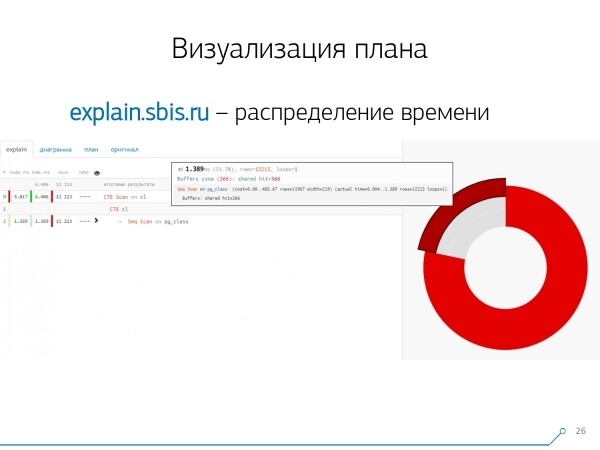
Čo by ešte bolo pohodlné? Bola by to výhoda vidieť, aký podiel na ktorý uzol od celkového času nám pripadá — a jednoducho „prilepili“ sme to na bok koláčový graf.
Naznačíme na uzol a vidíme — teda, Seq Scan z celkového času zabral menej ako štvrtinu, zatiaľ čo ostatné 3/4 nám zaberajú CTE Scan. Hrôza! Toto je malé upozornenie na „rýchlosť“ CTE Scan, ak ich aktívne používate vo svojich dotazoch. Nie sú veľmi rýchle — prehrávajú aj pred bežným tabuľkovým skenovaním.
Ale zvyčajne takéto diagramy bývajú zaujímavejšie, zložitejšie, keď hneď naznačujeme na segment a vidíme, že viac ako polovica celkového času „zjedol“ nejaký Seq Scan. A navyše tam bol nejaký Filter, množstvo záznamov bolo odhodených na tomto základe... Môžeme ten obrázok poslať priamo vývojárovi a povedať: „Václav, tu máš úplne zle! Pozeraj, niečo nie je v poriadku!“
Prírodzene, bez „potkýňania“ sa to nezaobišlo.
Prvá vec, na ktorú sme narazili, bola problém s zaokrúhľovaním. Čas uzla pre každý jednotlivý plán je uvedený s presnosťou na 1μs. A keď počet cyklov uzla presiahne napríklad 1000 — po vykonaní PostgreSQL sa to rozdelí „s presnosťou na“, pri spätnom výpočte dostaneme celkový čas „niekde medzi 0.95ms a 1.05ms“. Keď ide o mikrosekundy — to ešte nie je nič, ale keď ide o [milisekundy] — musíme pri „uvoľňovaní“ zdrojov podľa uzlov plánu „kto koľko spotreboval“ túto informáciu zohľadniť.
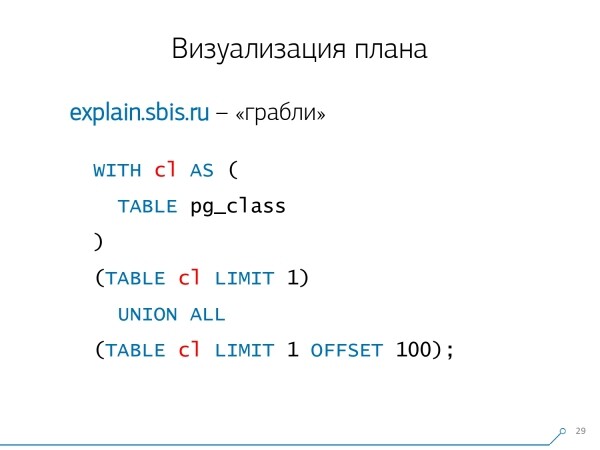
Druhý moment, oveľa zložitejší, je rozdelenie zdrojov (tých bufferov) podľa dynamických uzlov. To nám prinieslo počas prvých 2 týždňov na prototyp ešte plus 4 týždne.
Získať takýto problém je pomerne jednoduché — robíme CTE a v ňom akoby niečo čítame. V skutočnosti je PostgreSQL „inteligentný“ a nič tam priamo čítať nebude. Potom berieme z nej prvý záznam a k nemu – stý z tej istej CTE.
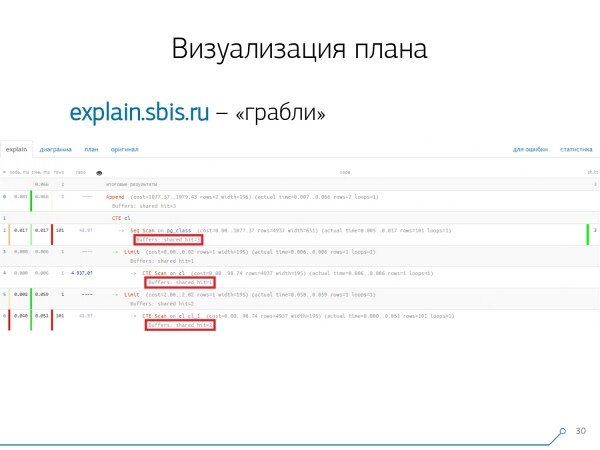
Pozrieme sa na plán a chápeme — divné, mali sme 3 buffery (údajové stránky), ktoré boli „spotrebované“ v Seq Scan, ďalší 1 v CTE Scan a ešte 2 v druhom CTE Scan. To znamená, že ak to všetko jednoducho zhrnieme, dostaneme 6, ale z tabuľky sme prečítali iba 3! CTE Scan predsa nič nikde nečíta, ale pracuje priamo s pamäťou procesu. Takže tu je jasne niečo v neporiadku!
V skutočnosti to vychádza tak, že všetkých 3 stránok údajov, ktoré boli požadované v Seq Scan, najprv 1 požiadal 1. CTE Scan, a potom 2., a mu dočítali ešte 2. Takže celkovo bolo prečítaných 3 stránky údajov, nie 6.
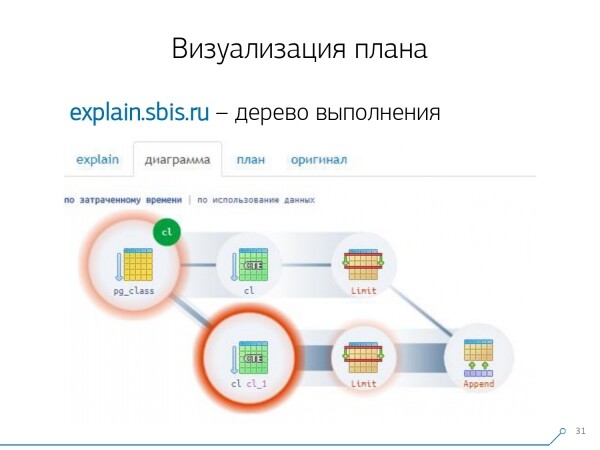
A táto situácia nás priviedla k pochopeniu, že vykonanie plánu už nie je strom, ale len akýsi acyklický graf. A dostali sme takúto približne diagram, aby sme pochopili „čo-odkiaľ vôbec prišlo“. To znamená, že tu sme vytvorili CTE z pg_class a dvakrát sme si ho požiadali, a prakticky celý čas sme strávili na vetve, keď sme ho požadovali 2. raz. Je jasné, že prečítať 101. záznam – to je oveľa drahšie ako jednoducho 1. z tabuľky.

Na chvíľu sme si vydýchli. Povedali sme: „Teraz, Neo, vieš kung-fu! Teraz je naša skúsenosť priamo na tvojej obrazovke. Teraz s ňou môžeš manipulovať.“
Konsolidácia logov
Naši 1000 vývojárov si vydýchli. Ale my sme si uvedomovali, že máme len stovky „bojových“ serverov a tento „kopipast“ od vývojárov je úplne nepohodlný. Uvedomili sme si, že si to musíme poskladať sami.
V skutočnosti existuje štandardný modul, ktorý dokáže zhromažďovať štatistiky, avšak aj ten je potrebné v konfigurácii aktivovať — ide o . Ale nevyhovuje nám.
Po prvé, tým istým dopytom priraďuje rôzne QueryIdv rôznych schémach v rámci jednej databázy. To znamená, že ak najprv vykonám SET search_path = '01'; SELECT * FROM user LIMIT 1;, a potom SET search_path = '02'; a taký istý dopyt, tak v štatistike tohto modulu budú rôzne záznamy a nebudem schopný zhromaždiť celkovú štatistiku práve v rámci tohto profilu dopytu, nezohľadňujúc schémy.
Druhý aspekt, ktorý nám prekážal v jeho používaní — nedostatok plánov. To znamená, že plán neexistuje, je len samotný dopyt. Vidíme, čo spomaľovalo, ale nevieme prečo. A tu sa vraciame k problému rýchlo sa meniacich dátových súborov.
A posledný bod — nedostatok „faktov“. To znamená, že nemôžeme odkazovať na konkrétny exemplár vykonania dopytu — ten neexistuje, je len agregovaná štatistika. S tým sa síce dá pracovať, ale je to veľmi komplikované.
Preto sme sa rozhodli bojovať proti „kopipaste“ a začali sme písať kollektor.
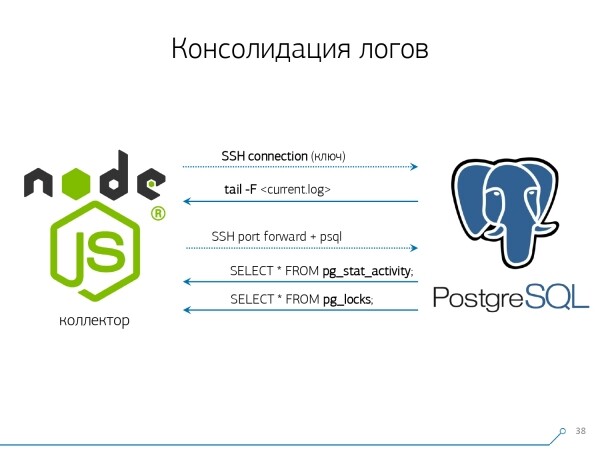
Kollektor sa pripája cez SSH, „natiahne“ pomocou certifikátu zabezpečené spojenie až k serveru s databázou a tail -F sa „pripojí“ k logovému súboru. Týmto spôsobom v tejto relácii získavame úplné „zrkadlo“ všetkého logového súboru, ktorý generuje server. Zaťaženie samotného servera je pritom minimálne, pretože tam nič neparsingujeme, len zrkadlíme traffic.
Keďže sme už začali písať rozhranie na Node.js, pokračovali sme na ňom aj v písaní kollektora. A táto technológia sa osvedčila, pretože na prácu so slabopreformátovanými textovými údajmi, ktorými log je, je použitie JavaScriptu veľmi pohodlné. A samotná infraštruktúra Node.js ako backendová platforma umožňuje jednoducho a pohodlne pracovať so sieťovými spojeniami a vo všeobecnosti s rôznymi tokmi údajov.
Podľa toho „natiahujeme“ dve pripojenia: prvé, aby sme „počúvali“ samotný log a brali ho k sebe, a druhé — aby sme sa občas pýtali databázy. „Aha, v logu prišlo, že tabuľka s oid 123 je zablokovaná“, ale vývojárovi to nič nepovedalo, a bolo by dobré opýtať sa databázy „Čo vlastne znamená OID = 123?“ A tak sa občas pýtame databázy na to, čo ešte nevieme.
„Len jedno si nezohľadnil, existuje druh slonopodobných včiel!..“ Začali sme vyvíjať tento systém, keď sme chceli monitorovať 10 serverov. Tých najkritickejších v našom pohľade, na ktorých sa objavovali nejaké problémy, s ktorými sa ťažko pracovalo. Ale v priebehu prvého kvartálu sme dostali na monitoring stovku — pretože systém „zafungoval“, všetci chceli, všetkým to vyhovovalo.
Všetko to treba agregovať, tok dát je veľký, aktívny. Vo vlastne monitorujeme to, s čím vieme pracovať — to aj využívame. Ako úložisko dát tiež používame PostgreSQL. Nič rýchlejšie, aby sme do neho „nalievali“ dáta, ako operátor KOPÍROVAŤ momentálne nie je.
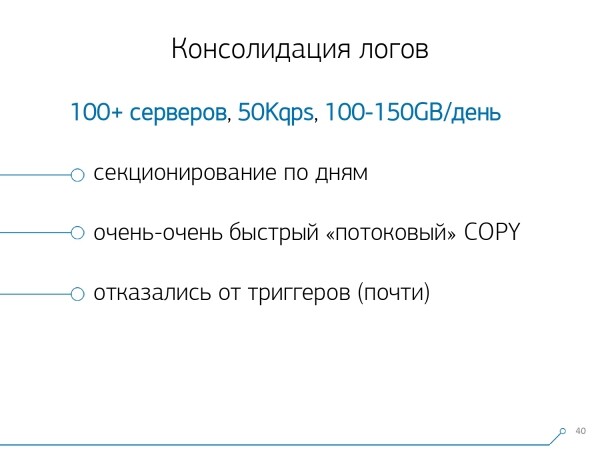
Ale len tak „nalievať“ údaje — to nie je celkom naša technológia. Pretože ak máte na stovke serverov približne 50k požiadaviek za sekundu, generuje vám to 100-150GB logov denne. Preto sme museli databázu opatrne „rozrezať“.
Najprv sme urobili sekcionovanie podľa dní, pretože, vo veľkom, nikoho nezaujíma korelácia medzi dňami. Aký je rozdiel, čo ste mali včera, ak ste dnes v noci vydali novú verziu aplikácie — a už nejaká nová štatistika.
Po druhé, naučili sme sa (museli sme) veľmi, veľmi rýchlo písať pomocou KOPÍROVAŤ. To znamená nie len KOPÍROVAŤ, pretože je rýchlejšie ako INSERT, ale ešte rýchlejšie.
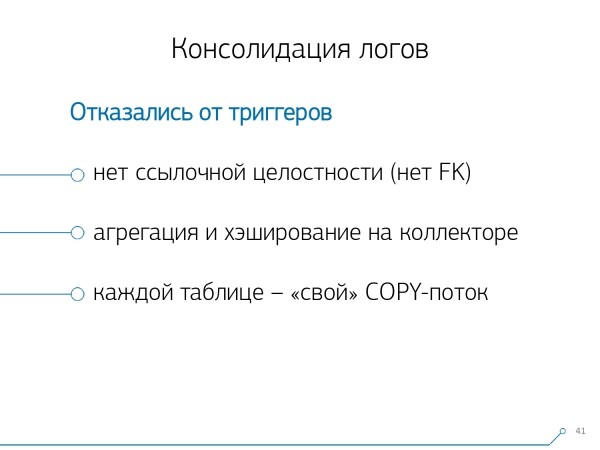
Tretí moment — museli sme vzdať sa triggerov, a teda aj Foreign Keys. Teda nemáme žiadnu referenčnú integritu. Pretože ak máte tabuľku, na ktorej je pár FK, a hovoríte v štruktúre DB, že „toto záznam z logu sa odkazuje po FK napríklad na skupinu záznamov“, keď ju vkladáte, PostgreSQL nemá na výber, len si vezme a poctivo vykoná SELECT 1 FROM master_fk1_table WHERE ... s tým identifikátorom, ktorý sa snažíte vložiť — len preto, aby ste skontrolovali, že tento záznam tam je prítomný, že svojou vložkou „neporušujete“ tento Foreign Key.
Dostávame namiesto jedného záznamu do cieľovej tabuľky a jeho indexov, navyše čítanie zo všetkých tabuliek, na ktoré odkazuje. A to nepotrebujeme – našou úlohou je zapiš čo najviac a čo najrýchlejšie s najmenším zaťažením. Takže FK – preč s tým!
Ďalšia vec – agregácia a hashovanie. Pôvodne sme ich mali implementované v DB – veď je to pohodlné, keď prichádza záznam, urobiť to hneď v nejakej tabuľke „plus jedna“ priamo v triggere. Dobre, pohodlné, ale zlé tým, že vložíte jeden záznam a musíte prečítať a zapísať ešte niečo z inej tabuľky. A nielen prečítať a zapísať – musíte to spraviť každý raz.
A teraz si predstavte, že máte tabuľku, v ktorej jednoducho počítate počet požiadaviek, ktoré prešli cez konkrétny hostiteľ: +1, +1, +1, ..., +1. A to vlastne nepotrebujete – to všetko môžete sčítať v pamäti na zberači a poslať do databázy naraz +10.
Áno, v prípade nejakých problémov sa môže "zrútiť" logická celistvosť, ale to je prakticky nerealistický prípad – pretože máte normálny server, má v ňom batériu v kontroléri, máte žurnál transakcií, žurnál na súborovom systéme... V skratke, nestojí to za to. Nestojí to za tú stratu výkonu, ktorú dostávate kvôli práci triggerov/FK, tie náklady, ktoré s tým nesiete.
To isté sa týka hashovania. Prichádza k vám nejaká požiadavka, od nej vypočítate v DB nejaký identifikátor, zapíšete ho do databázy a všetkým ho potom oznámite. Všetko je v poriadku, pokiaľ v čase zápisu k vám nepríde druhý záujemca, ktorý sa chce zapísať – a vznikne vám blokovanie, a to je už zlé. Preto, ak môžete generáciu nejakých ID presunúť na klienta (vzhľadom na databázu), radšej to spravte.
Nám sa jednoducho perfektne hodilo používať MD5 z textu – požiadavky, plánu, šablóny,... Vypočítavame ho na strane zberača a „lejeme“ do databázy už hotový ID. Dĺžka MD5 a denné delenie nám umožňujú nezapodievať sa možnými kolíziami.
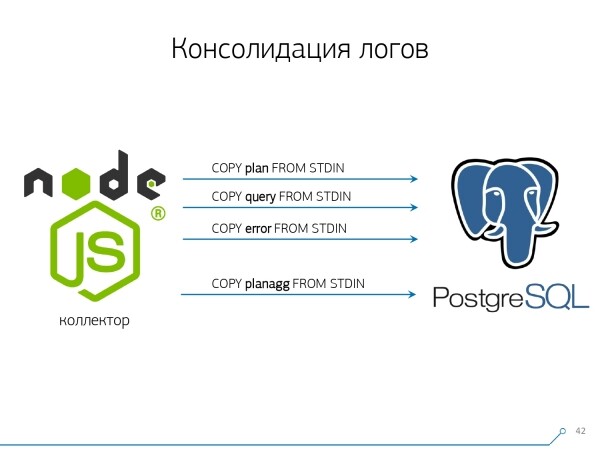
Ale aby sme to všetko zapísali rýchlo, potrebovali sme upraviť samotný postup zápisu.
Ako zvyčajne zapisujeme dáta? Máme nejaký dataset, rozložíme ho na niekoľko tabuliek a potom COPY — najprv do prvej, potom do druhej, do tretej… Je to nepraktické, pretože akoby sme písali jeden tok dát v troch krokoch. Je to nepríjemné. Môžeme to spraviť rýchlejšie? Môžeme!
Na to stačí len rozložiť tie toky paralelne vedľa seba. Takto nám letia v samostatných tokoch chyby, požiadavky, šablóny, zámky,… — a píšeme to všetko paralelne. Na to stačí udržiavať stále otvorený COPY-kanál na každú samostatnú cieľovú tabuľku..
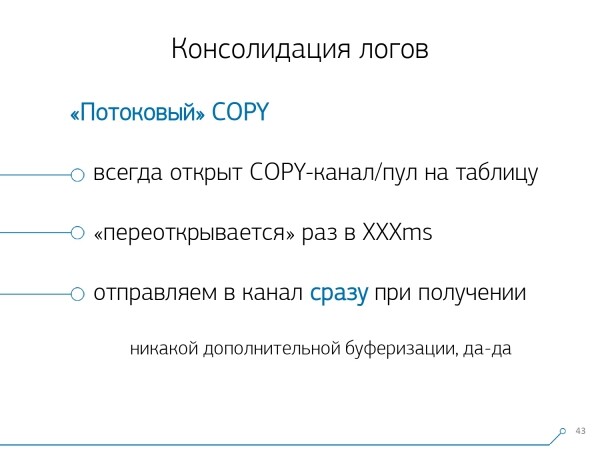
To znamená, že zberateľ má vždy stream,, do ktorého môžem zapísať potrebné údaje. Ale aby ich databáza videla, a niekto nebol zablokovaný čakaním na zapísanie týchto údajov, COPY treba pravidelne prerušovať. Pre nás sa ukázal ako najefektívnejší interval okolo 100 ms — zatvoríme a hneď znova otvoríme na tú istú tabuľku. A ak nám jeden tok nestačí pri určitých špičkách, robíme pooling do určitého limitu.
Okrem toho sme zistili, že pre taký profil zaťaženia je akákoľvek agregácia, keď sa záznamy zhromažďujú do balíkov — to je zlo. Klasické zlo je INSERT ... VALUES a potom 1000 záznamov. Pretože v tom momente máte špičku zapisovania na médium a všetci ostatní, ktorí sa snažia niečo zapísať na disk, budú čakať.
Aby ste sa zbavili takých anomálií, jednoducho nič neagregujte, vôbec nezobrazujte. A ak predsa len nastane buffering na disk (naf šťastie, Stream API v Node.js to umožňuje zistiť) — odložte to spojenie. Keď dostanete udalosť, že je opäť voľné — píšte doňho z hromadiacej sa fronty. Kým je zaneprázdnené — berte z poolu ďalšie, voľné, a píšte doňho.
Pred zavedením takéhoto prístupu k zapisovaniu dát sme mali približne 4K write ops, a týmto spôsobom sme znížili zaťaženie štyrikrát. Teraz sme sa zvýšili ďalších šesťkrát vďaka novým pozorovaným databázam — na 100 MB/s. A teraz uchovávame záznamy za posledné 3 mesiace v objeme cca 10-15 TB, dúfajúc, že za tri mesiace každý problém dokáže ktorýkoľvek vývojár vyriešiť.
Chápeme problémy
Zbieranie všetkých týchto údajov je dobré, užitočné a relevantné, ale je to málo — je potrebné ich pochopiť. Pretože ide o milióny rôznych plánov za deň.
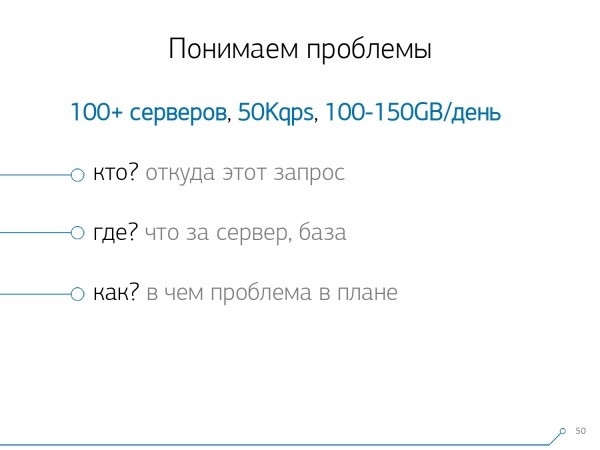
Milióny sú nejaké nezvládnuteľné, najprv musíme spraviť "menšie". A predovšetkým musí byť jasné, ako tú "menšiu" organizáciu vytvoríme.
Vyčlenili sme si tri kľúčové body:
- kto tento požiadavok bol zaslaný
To znamená, z akej aplikácie "priletel": webové rozhranie, backend, platobný systém alebo niečo iné. - kde to sa stalo
Na ktorom konkrétnom serveri. Pretože ak máte pod jednou aplikáciou niekoľko serverov a náhle jeden "spomaluje" (pretože "disk zlyhal", "pamäť klesla", a iná nepríjemnosť), musíte sa presne odvolať na server. - ako problém sa presne prejavil v tomto alebo inom pláne
Aby sme pochopili "kto" nám poslal požiadavku, používame štandardný nástroj — nastavenie premennej relácie: SET application_name = '{bl-host}:{bl-method}'; — uchovávame názov hostiteľa obchodnej logiky, z ktorého prichádza požiadavka, a názov metódy alebo aplikácie, ktorá ju iniciovala.
Po tom, čo sme predali "majiteľa" požiadavky, musíme ho zapísať do logu — na to nastavíme premennú log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Kto má záujem, môže , čo to všetko znamená. Zistíme, že v logu vidíme:
- čas
- identifikátory procesu a transakcie
- názov databázy
- IP adresu toho, kto poslal tento požiadavok
- a názov metódy
Ďalej sme si uvedomili, že nie je príliš zaujímavé sledovať koreláciu jedného požiadavku medzi rôznymi servermi. Rídkou situáciou je, keď vaše jedno приложение rovnakým spôsobom "zlyháva" tu a tam. Ale aj keď je to rovnaké — pozrite sa na akýkoľvek z týchto serverov.
Takže, rozrezať "jeden server — jeden deň" sa nám ukázalo ako dostatočné pre akúkoľvek analýzu.
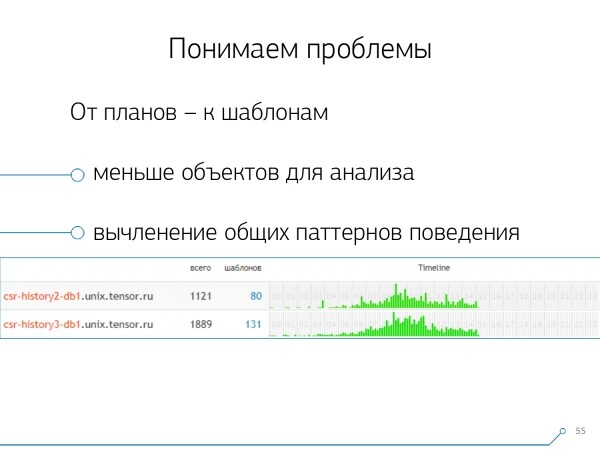
Prvý analytický rez — to je ten "šablóna" — skrátená forma zobrazenia plánu, vyčistená od všetkých numerických údajov. Druhý rez — aplikácia alebo metóda, a tretí — konkrétny uzol plánu, ktorý spôsobil naše problémy.
Keď sme prešli od konkrétnych prípadov k šablónam, získali sme hneď dve výhody:
- značne znížený počet objektov na analýzu
Musíme sa zaoberať problémom už nie po tisíckach požiadaviek alebo plánov, ale po desiatkach šablón. - časová os
Teda, zhrnieme 'fakty' v rámci nejakého rozmedzia, môžeme zobraziť ich výskyt počas dňa. A tu môžete pochopiť, že ak máte nejaký vzor, ktorý sa deje, napríklad raz za hodinu, a mal by byť raz za deň, stojí za to zamyslieť sa, čo sa stalo — kto a prečo ho vyvoláva, možno by sem ani nemal patriť. Toto je ďalší nečíselný, čisto vizuálny spôsob analýzy.
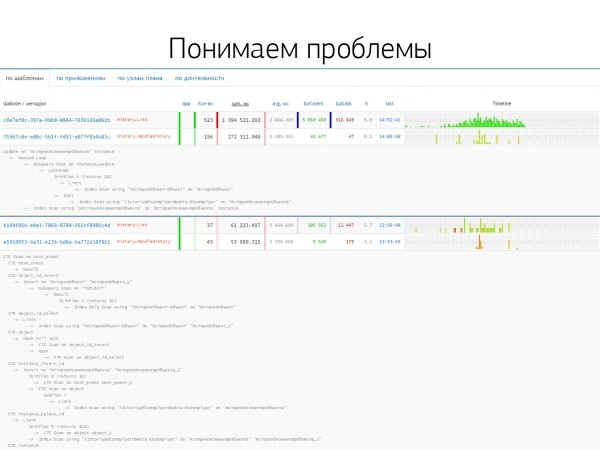
Ostatné spôsoby sú založené na tých ukazovateľoch, ktoré získavame z plánu: koľkokrát sa tento vzor objavil, celkový a priemerný čas, koľko dát sa prečítalo z disku a koľko z pamäte...
Pretože prídete na stránku analýzy hostiteľa, pozeráte — niečo sa začalo príliš často čítať z disku. Disk na serveri nezvláda — a kto z neho číta?
A môžete zoradiť podľa ľubovoľného stĺpca a rozhodnúť sa, čomu sa budete práve teraz venovať — zaťaženiu procesora alebo disku, alebo celkovému počtu požiadaviek... Zoradené, pozreli ste sa na 'topové', opravili — vydali novú verziu aplikácie.
A hneď môžete vidieť rôzne aplikácie, ktoré komunikujú s rovnakým vzorom od požiadavky typu SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, spracovanie... A zamyslíte sa, prečo by spracovanie malo čítať používateľa, ak s ním neinteraguje.
Opačný spôsob — hneď vidieť, čo aplikácia robí. Napríklad, frontend — toto, toto, a ešte toto raz za hodinu (presne tak časová os pomáha). A hneď vzniká otázka — akosi to nie je úloha frontendu robiť niečo raz za hodinu...
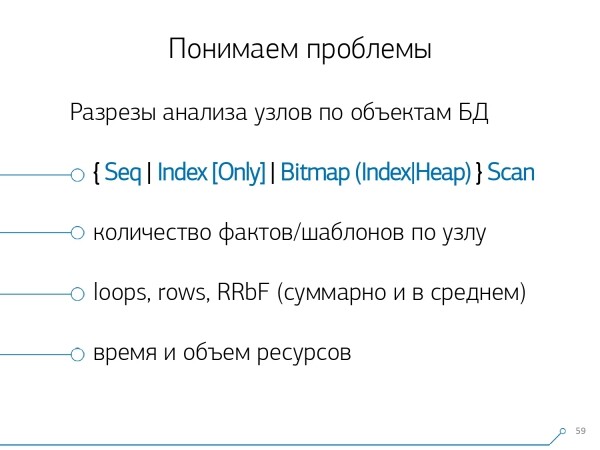
Po nejakom čase sme si uvedomili, že nám chýba agregovaná štatistika v rámci uzlov plánu.Vytiahli sme z plánov len tie uzly, ktoré niečo robia s údajmi samotných tabuliek (čítajú/píšu ich podľa indexu alebo nie). V podstate, k predchádzajúcemu obrázku sa pridáva iba jeden aspekt — koľko záznamov tento uzol nám prinesie, a koľko zahodil (Rows Removed by Filter).
Nemáte vhodný index na tabulke, robíte na ňu požiadavku, preletí to okolo indexu, spadne do Seq Scan... všetky záznamy okrem jedného ste odfilterovali. A načo vám za deň 100M odfilterovaných záznamov, nebolo by lepšie pridať index?
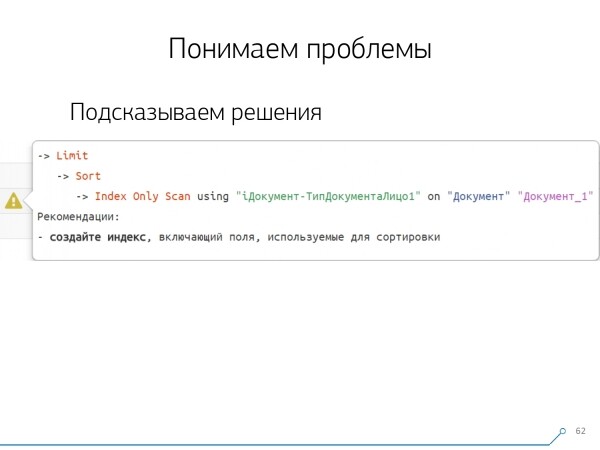
Po preskúmaní všetkých plánov uzlov sme zistili, že existujú určité typické štruktúry v plánoch, ktoré s mimoriadne veľkou pravdepodobnosťou vyzerajú podozrivo. A nebolo by zlé vývojárovi odporučiť: „Priateľ, tu najprv čítaš podľa indexu, potom triediš a nakoniec odrezávaš“ — zvyčajne tam je iba jeden záznam.
Všetci, ktorí písali dopyty s takýmto vzorom, sa určite stretli s niečím takým: „Daj mi poslednú objednávku po Vaskovi, jeho dátum.“ A ak nemáte index podľa dátumu, alebo vo použitom indexe nie je dátum, tak presne na také „hrable“ aj stúpnete.
Ale predsa vieme, že sú to „hrable“ — tak prečo by sme hneď nepovedali vývojárovi, čo by mal spraviť? V súvislosti s tým, keď teraz otvorí plán, náš vývojár hneď vidí pekný obrázok s tipmi, ktoré mu rovno hovoria: „Tu a tu máš problémy, a takto a takto sa dajú vyriešiť.“
Výsledkom je, že objem skúseností potrebných na riešenie problémov na začiatku a teraz sa znížil niekoľkonásobne. Takýto nástroj sa nám podaril.
Zdroj: habr.com
