

Doporučuji se seznámit s přepisem zprávy z počátku roku 2020 Georgije Rylova "WAL-G: nové možnosti a rozšíření komunity"
U maintainerů open-source vzniká mnoho problémů, jak rostou. Jak psát stále více požadovaných funkcí, opravovat stále více problémů a stíhat se dívat na stále více pull requestů? Na příkladu WAL-G (backup-tool pro PostgreSQL) vám povím, jak jsme tyto problémy řešili, když jsme spustili kurz o Open-source vývoji na univerzitě, co jsme dosáhli a kam se chystáme dál.
Ahoj všem znovu! Jsem vývojář v Yandexu z Jekatěrinburgu. A dnes vám povím o WAL-G.
V názvu zprávy nebylo uvedeno, že by to mělo něco společného s zálohami. Někdo neví, co je WAL-G? Nebo to všichni vědí? Zvedněte ruku, kdo neví. Úžasné, přišli jste na zprávu a nevíte, o čem je.
Dovolte mi říct, co bude dnes. Tak se stalo, že náš tým se tímto tématem zabývá poměrně dlouho. A to je ještě jedna zpráva v sérii, kde vyprávíme o tom, jak bezpečně, spolehlivě, pohodlně a efektivně uchováváme data.
V předchozích epizodách bylo mnoho zpráv od Andreje Borodina, Vladimíra Leskova. Bylo nás hodně. A už mnoho let jsme všichni vyprávěli o WAL-G.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Tato zpráva se trochu liší od ostatních, protože tam bylo více technické části, a tady vám povím, jak jsme se setkali s problémy spojenými s růstem komunity. A jak jsme vymysleli malý nápad, který nám pomáhá to zvládnout.
Před několika lety byl WAL-G poměrně malý projekt, který jsme zdědili od Citus Data. A my jsme ho jen převzali. A vyvíjel ho jeden člověk.
A jediné, co ve WAL-G chybělo:
- Záloha z repliky.
- Chyběly inkrementální zálohy.
- Chyběly WAL-Delta zálohy.
- A ještě spousta dalších věcí chybělo.
Za těch pár let WAL-G značně vyrostl.
A do roku 2020 již existovalo všechno výše uvedené. A k tomu se přidalo to, že nyní máme:
- Více než 1 000 hvězdiček na GitHubu.
- 150 forků.
- Přibližně 15 otevřených PR.
- A ještě mnoho přispěvatelů.
- A neustále otevřené problémy. A to vše při tom, že tam prakticky každý den chodíme a něco s tím děláme.
A dospeli sme k záveru, že tento projekt si vyžaduje našu väčšiu pozornosť, aj keď nám samým nie je potrebné realizovať niečo pre našu službu Managed Databases v YandeXe.
A niekedy na jeseň 2018 nám napadla myšlienka. Zvyčajne má tím niekoľko spôsobov, ako vyvinúť nejaké funkcie, opraviť chyby, ak máte nedostatok rúk. Napríklad, môžete najať ďalšieho vývojára a platiť mu peniaze. Alebo môžete získať stážistu na určitý čas a tiež mu platiť nejaký plat. Existuje však aj pomerne veľká skupina ľudí, z ktorej niektorí už naozaj vedia písať kód. Lenže neviete vždy, akú kvalitu má tento kód.
Pomysleli sme si a rozhodli sme sa vyskúšať prilákať študentov. Ale študenti sa nebudú podieľať na všetkom. Budú robiť len určitú časť práce. Napríklad budú písať testy, opravovať chyby, realizovať funkcie, ktoré sa netýkajú základnej funkčnosti. Základná funkčnosť – to je vytváranie záloh a obnova záloh. Ak sa dopustíte chyby pri vytváraní zálohy, stratíme dáta. A nikto to, samozrejme, nechce. Všetci chcú, aby všetko bolo veľmi spoľahlivé. Preto kód, ktorému dôverujeme menej, ako svojmu vlastnému, určite nechceme pustiť dovnútra. T. j. akýkoľvek nekritický kód – to je to, čo by sme chceli získať od našich dodatočných pracovných síl.
Za akých podmienok sa prijíma PR študenta
- Musí pokryť svoj kód testami. Všetko musí prebiehať v CI.
- A tiež prechádzame 2 recenziami. Jedna od Andreja Borodina a jedna moja.
- A navyše, aby som skontroloval, že to nepoškodí nič v našej službe, osobitne nahrávam zostavu s týmto commitom. A kontrolujeme v end-to-end testoch, že nám nič nepadá.
Špeciálny kurz o Open Source
Trochu o tom, prečo je to potrebné a prečo sa mi to zdá ako skvelá myšlienka.
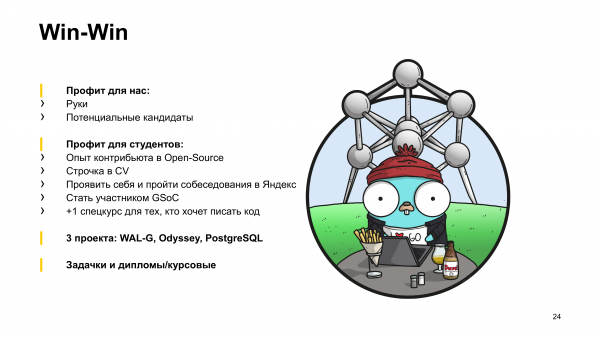
Pre nás je zisk očividný:
- Získavame dodatočné ruky.
- A hľadáme kandidátov do tímu medzi schopnými študentmi, ktorí píšu kvalitný kód.
Aký zisk pre študentov?
Môžu byť menej očividné, pretože študenti, aspoň, nedostávajú peniaze za ten kód, ktorý píšu, ale iba známky do svojej kreditnej knihy.
Spýtal som sa ich na to. A z ich slov:
- Skúsenosť prispievateľa v Open Source.
- Získať riadok v CV.
- Prejavte sa a prejdite pohovorom v Yandexe.
- Staňte sa účastníkom GSoC.
- +1 špeciálny kurz pre tých, ktorí chcú písať kód.
Nebudem rozprávať o tom, ako bol kurz usporiadaný. Poviem len to, že WAL-G bol hlavným projektom. A okrem toho sme do tohto kurzu zahrnuli také projekty ako Odyssey, PostgreSQL a ClickHouse.
A úlohy sme dávali nielen v tomto kurze, ale aj vydávali diplomy a bakalárske práce.
A aký je prínos pre používateľov?
Teraz prejdeme k časti, ktorá vás pravdepodobne zaujíma. Aký z toho máte osoh? Osoh je v tom, že študenti opravili množstvo chýb. A vytvorili požiadavky na funkcie, ktoré ste nás žiadali, aby sme ich urobili.
A poďme si povedať o veciach, ktoré ste dávno chceli a ktoré boli implementované.
Podpora tablespaces. Tablespaces v WAL-G sa očakávali pravdepodobne od momentu uvoľnenia WAL-G, pretože WAL-G je nástupcom iného nástroja na zálohovanie WAL-E, v ktorom boli podporované zálohy databáz s tablespaces.
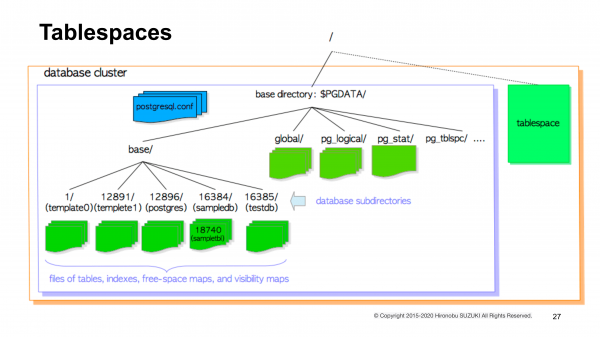
Na margo pripomeniem, čo to vlastne je a na čo je to dobré. Zvyčajne sú všetky vaše dáta Postgres umiestnené v jednom adresári na súborovom systéme, ktorý sa nazýva základný. A tento adresár už obsahuje všetky súbory a podadresáre potrebné pre Postgres.
Tablespaces sú adresáre, v ktorých sú uložené dáta Postgres, ale nie sú uložené mimo základného adresára. Na slajde vidíte, že tablespace sú umiestnené mimo základného adresára.
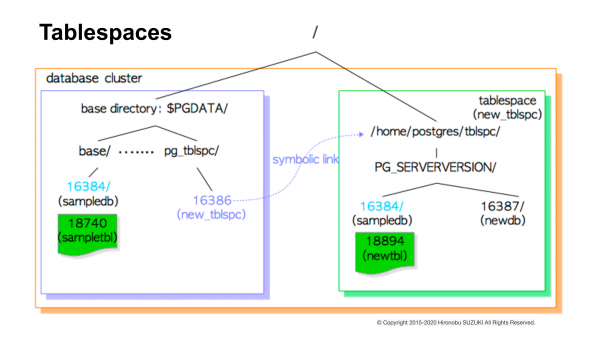
Ako to vyzerá pre samotný Postgres? V základnom adresári existuje samostatný podadresár pg_tblspc. A v ňom sú uložené symbolické odkazy na adresáre, v ktorých sa skutočne nachádzajú dáta Postgres mimo základného adresára.
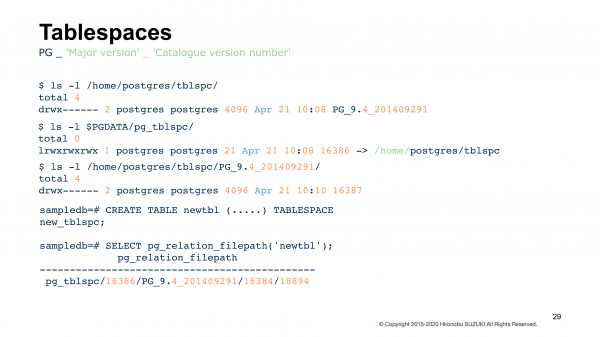
Keď používate všetky tieto príkazy, môžu vyzerať takto. T. j. vytvoríte tabuľku v určitej špecifikovanej tablespace a potom sa pozriete, kde teraz je. Tieto dva posledné riadky, dva posledné vyvolané príkazy. A tam je vidieť, že existuje nejaká cesta. Ale v skutočnosti – to nie je skutočná cesta. Je to cesta s prefixom zo základného adresára k tablespace. A odtiaľ je zamapovaná symbolickým odkazom, ktorý vedie k vašim skutočným dátam.
My to všetko nepoužívame v našej tímu, ale mnohí iní používatelia WAL-E to používali, ktorí nám písali, že chcú prejsť na WAL-G, ale to im bránilo. Teraz je to podporované.
Ďalšou funkciou, ktorú nám priniesol náš špeciálny kurz, je catchup. O catchup vedia ľudia, ktorí pravdepodobne pracovali viac s Oracle ako s Postgresom.
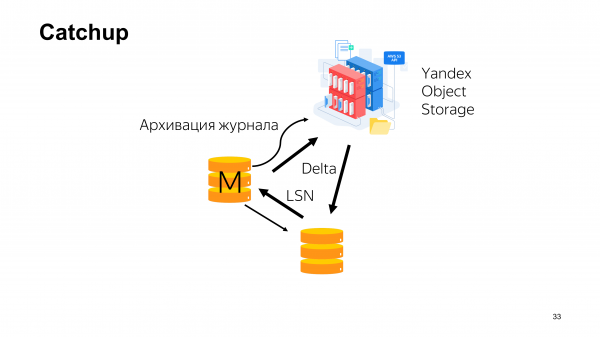
Stručne o tom, čo to je. Takto môže vyzerať topológia klastera v našej službe. Máme majstra. Je tu replikátor, ktorý streamuje od neho write-ahead log. A replikátor hovorí majstrovi, na ktorom LSN sa práve nachádza. Paralelne s tým môže byť archívovaný žurnál. Okrem archívovania žurnálu sa do cloudu odosielajú zálohy. A sú zasielané delta-zálohy.
Aký môže byť problém? Keď máte dostatočne veľkú databázu, môže sa stať, že replikátor začne výrazne zaostávať za majstrom. A zaostáva tak silno, že ho už nikdy nedoženie. Tento problém sa zvyčajne musí nejako riešiť.
A najjednoduchší spôsob je odstrániť replikátor a nanovo ho naladiť, pretože už nikdy nedoženie, a je potrebné sa vysporiadať s problémom. Ale to trvá dosť dlho, pretože obnovenie celej zálohy databázy o veľkosti 10 TB je veľmi, veľmi zdĺhavé. A chceme to urobiť čo najrýchlejšie, ak takéto problémy nastanú. A presne na to je určený catchup.
Catchup umožňuje využívať delta-zálohy, ktoré sa ukladajú do cloudu týmto spôsobom. Hovoríte, na ktorom LSN sa teraz nachádza zaostávajúci replikátor a uvádzate ho v príkaze catchup, aby ste vytvorili delta-zálohu medzi týmto LSN a LSN, na ktorom sa teraz vaše klaster nachádza. A potom obnovíte túto zálohu na replikátore, ktorý zaostával.
Iné databázy
Ešte nám študenti priniesli veľa funkcií. Keďže v Yandexe robíme nielen s Postgres, máme tiež MySQL, MongoDB, Redis, ClickHouse, v určitej chvíli sme potrebovali, aby sme mohli robiť zálohy s point-in-time recovery pre MySQL a aby sme mali možnosť odoslať ich do cloudu.
A chceli sme to robiť podobným spôsobom, akým to robí WAL-G. A rozhodli sme sa experimentovať a pozrieť sa, ako to všetko bude vyzerať.
A na začiatku sme túto logiku nijako nerozdeľovali a napísali sme kód vo fork. Videli sme, že máme nejaký funkčný model a že to môže fungovať. Potom sme si pomysleli, že naše hlavné spoločenstvo sú postgresisti, ktorí používajú WAL-G. A preto je potrebné tieto časti nejako rozdeliť. T. j. keď opravujeme kód pre Postgres, neporušujeme MySQL, a keď opravujeme MySQL, neporušujeme Postgres.
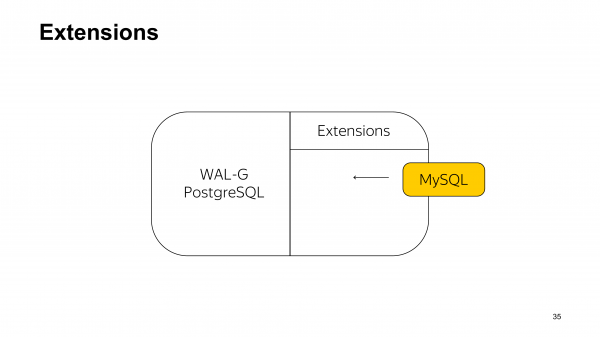
Prvá myšlienka, ako to rozdeliť, bola použiť rovnaký prístup, aký sa používa v rozšíreniach PostgreSQL. A vlastne, aby ste vytvorili zálohu MySQL, museli by ste nainštalovať akúsi dynamickú knižnicu.
Ale tu je okamžite viditeľná asymetria tohto prístupu. Keď zálohujete Postgres, nainštalujete naň normálnu zálohovaciu aplikáciu pre Postgres a všetko je v poriadku. Pre MySQL to znamená, že nainštalujete zálohovaciu aplikáciu pre Postgres a k nej ešte dynamickú knižnicu pre MySQL. Znie to čudne. Aj my sme si to mysleli a rozhodli sme sa, že to nie je to riešenie, ktoré potrebujeme.
Rozličné zostavy pre Postgres, MySQL, MongoDB, Redis
Ale to nám, ako sa zdá, umožnilo dosiahnuť správne riešenie – vyčleniť rôzne zostavy pre rôzne databázy. To umožnilo izolovať logiku týkajúcu sa záloh rôznych databáz, ktoré budú komunikovať s celkovým API, ktoré implementuje WAL-G.
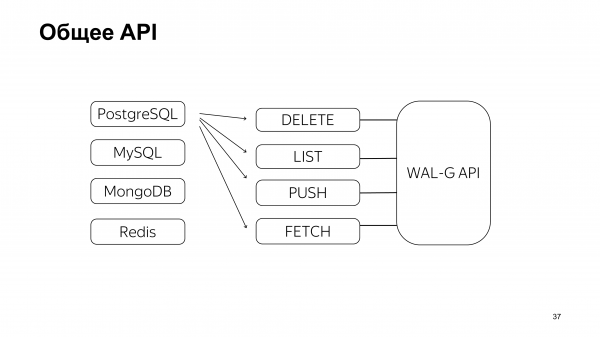
To je tá časť, ktorú sme napísali sami – predtým, ako sme dali študentom úlohy. T. j. to je presne tá časť, kde mohli spraviť niečo zle, a preto sme sa rozhodli, že je lepšie, ak urobíme niečo my a všetko bude v poriadku.
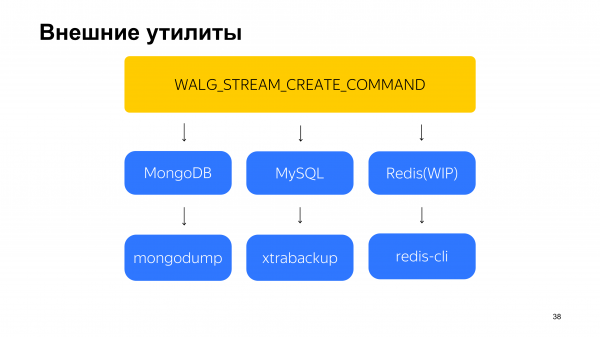
Potom sme vydali úlohy. Okamžite sa rozobrali. Od študentov sa vyžadovalo, aby podporili tri databázy.
To je MySQL, ktorú zálohujeme pomocou WAL-G týmto spôsobom už viac ako rok.
A teraz už aj MongoDB sa blíži k produkcii, tam ho ešte doladia. V podstate, kostra pre toto všetko bola napísaná nami. Potom študenti napísali nejaké funkčné veci. A potom ich uvedieme do stavu, ktorý môžeme prijať do našej produkcie.
Tieto úlohy nevyzerali tak, že by študenti museli napísať celé zálohovacie nástroje pre každú z týchto databáz. Nemali sme takýto problém. Náš problém bol v tom, že sme chceli obnovu do určitého bodu v čase a chceli sme zálohovať do cloudu. A požiadali sme študentov, aby napísali nejaký kód, ktorý to vyrieši. Študenti využili už existujúce zálohovacie nástroje, ktoré nejakým spôsobom vytvárajú zálohy, a potom to spojili s WAL-G, ktorý to posielal do cloudu. A taktiež k tomu pridali obnovu do určitého bodu v čase.
Čo ešte priniesli študenti? Priniesli do WAL-G podporu šifrovania Libsodium.
Tiež sme zaviedli politiky uchovávania záloh. Teraz je možné označiť zálohy ako trvalé. A je to nejako pohodlnejšie pre váš servis automatizovať proces ich uchovávania.
Čo sa na záver experimentu podarilo dosiahnuť?
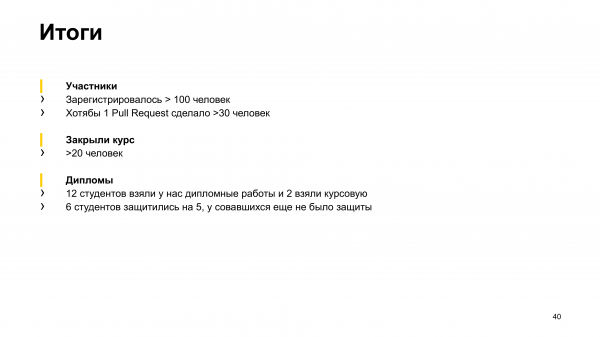
Na kurz sa pôvodne zaregistrovalo viac ako 100 ľudí. Na začiatku som nespomenul, že univerzita v Jekaterinburgu je Uralská federálna univerzita. Tam sme to všetko oznámili. 100 ľudí sa zaregistrovalo. V skutočnosti začalo niečo robiť oveľa menej, asi 30 ľudí.
Ešte menej ľudí kurz ukončilo, pretože tam bolo potrebné napísať testy k už existujúcim kódom. A tiež opraviť nejakú chybu alebo pridať nejakú funkciu. A časť študentov predsa len kurz úspešne ukončila.
V súčasnosti študenti v tomto kurze opravili približne 14 problémov a vyrobili 10 funkcií rôznych veľkostí. A, ako sa domnievam, to je plnohodnotná náhrada jedného alebo dvoch vývojárov.
Okrem toho sme odovzdávali diplomy a záverečné práce. A 12 ich získalo diplomy. 6 z nich už obhájilo na "5". U ostatných obhajoby ešte neboli, ale myslím, že aj oni to zvládnu.
Plány do budúcnosti
Aké máme plány do budúcnosti?
Aspoň tie požiadavky na funkcie, ktoré sme už od používateľov počuli a ktorých realizáciu plánujeme. To sú:
- Sledovanie správnosti sledovania časovej osi v archíve záloh HA-klastra. S pomocou WAL-G je to možné. A myslím, že nájdeme študentov, ktorí sa toho ujmú.
- Za prenášanie záloh a WAL-u medzi cloudmi už máme zodpovednú osobu.
- A nedávno sme zverejnili myšlienku, že môžeme urýchliť WAL-G ešte viac pomocou rozbaľovania inkrementálnych záloh bez prepisovania stránok a optimalizácie archívov, ktoré tam posielame.
Môžete sa o ne podeliť tu.
K čomu bola táto prezentácia? K tomu, že teraz, okrem nás štyroch, ktorí tento projekt podporujú, máme aj ďalšie ruky, ktorých je dosť, najmä ak im napíšete osobne. A ak zálohujete svoje údaje a robíte to pomocou WAL-G alebo by ste chceli prejsť na WAL-G, vaše želania môžeme celkom ľahko zohľadniť.
Toto je qr-kód a odkaz. Môžete cez ne prejsť a napísať všetky vaše požiadavky. Napríklad, ak nejakú chybu neopravujeme. Alebo ak nejakú funkciu veľmi chcete, ale z nejakého dôvodu ešte nie je v žiadnom zálohovacom riešení, vrátane nášho. Určite o tom dajte vedieť.
Otázky
Dobrý deň! Ďakujem za prednášku! Mám otázku ohľadom WAL-G, ale nie o Postgres. WAL-G zálohuje MySQL a spúšťa extra-zálohu. Ak vzídu moderné inštalácie na CentOS a ak vykonáte yum install MySQL, nainštaluje sa MariDB. Od verzie 10.3 sa extra-záloha nepodporuje, podporuje sa MariDB-záloha. Ako to máte s týmto?
Momentálne sme sa nepokúšali zálohovať MariDB. Mali sme žiadosti o podporu FoundationDB, ale vo všeobecnosti, ak takáto žiadosť existuje, môžeme nájsť ľudí, ktorí to urobia. Nie je to tak dlhé a nie je to také zložité, ako si myslím.
Dobrý deň! Ďakujem za prednášku! Mám otázku ohľadom potenciálnych nových funkcií. Ste pripravení nechať WAL-G fungovať s páskami, aby sme mohli robiť zálohy na pásku?
Záloha na páskovom úložisku sa asi myslí?
Áno.
Na túto otázku môže lepšie odpovedať Andrej Borodin.
(Andrej) Áno, ďakujem za otázku! Mali sme žiadosť o presun zálohy na pásku z cloudového úložiska. A na to presun medzi cloudmi. Pretože presun medzi cloudmi je určitá zovšeobecnená verzia presunu na pásku. Okrem toho máme rozšíriteľnú architektúru čo sa týka úložísk. Mimochodom, mnohé úložiská boli napísané študentami. A ak napíšete úložisko pre pásku, bude samozrejme podporované. Sme pripravení zvážiť pull request. Je potrebné zapísať súbor, prečítať súbor. Ak sa tieto veci urobia v Go, obvykle to vyjde na 50 riadkov kódu. A potom bude páska podporovaná v WAL-G.
Ďakujem za prednášku! Zaujímavý proces vývoja. Záloha – to je vážna časť funkčnosti, ktorá by mala byť dobre pokrytá testami. Pri realizácii funkčnosti pre nové databázy, písali testy tiež študenti alebo ste to napísali vy sami a potom odovzdali realizáciu študentom?
Testy písali tiež študenti. Ale študenti písali viac pre také funkcie, ako sú nové databázy. Písali integračné testy. A písali unit-testy. Ak integračné prejdú, t. j. aktuálne – to je scenár, ktorý vykonávate ručne alebo to robí cron, napríklad. T. j. tam je scenár veľmi zrozumiteľný.
Študenti nemajú veľa skúseností. Koľko času ide na revíziu?
Áno, preskúmanie zaberá dosť času. T. j. zvyčajne, keď prídu hneď niekoľkí komitenti a hovoria, že ja som spravil to, ja som spravil ono, je potrebné premýšľať a vyčleniť si niekde pol dňa na to, aby som sa vysporiadal s tým, čo napísali. Pretože kód treba čítať dôkladne. Predsa len neprešli pohovorom. Neznáme ich dobre, preto to zabera značný čas.
Ďakujem za prezentáciu! Predtým Andrej Borodin uviedol, že archive_command v WAL-G by sa mal volať priamo. Ale v prípade nejakého patron klastera potrebujeme dodatočnú logiku na určenie uzla, s ktorým poslať WALy. Ako túto problematiku riešite vy?
V čom máte problém? Predpokladajme, že máte synchronnú replikáciu, z ktorej robíte zálohu? Alebo čo?
(Andrej) Faktom je, že WAL-G skutočne predpokladá použitie bez obšírnych shell skriptov. Ak niečo chýba, tak napíšme logiku, ktorá by mala byť vo vnútri WAL-G. Čo sa týka toho, odkiaľ by mala byť archivácia, považujeme za správne, aby archivácia prebiehala z aktuálneho mastera v klasteri. Archivácia z repliky je zlá myšlienka. Môžu sa vyskytnúť rôzne scenáre s ťažkosťami. Predovšetkým problémy s archiváciou časových línií a ďalších údajov. Ďakujem za otázku!
(Objasnenie: Od obšírnych shell skriptov sme upustili )
Dobrý večer! Ďakujem za prezentáciu! Zaujala ma funkcia catchup, o ktorej ste hovorili. Stretli ste sa so situáciou, kedy replikácia zaostáva a nijako nedokáže dobehnúť. A v WAL-G som nenašiel popis tejto funkcie v dokumentácii.
Catchup sa objavil doslova koncom januára 2020. S dokumentáciou by sa možno malo pracovať dôkladnejšie. My ju sami píšeme a nepisujeme ju úplne dokonale. A od študentov by sa možno malo začať požadovať, aby ju písali.
Je už v vydaní?
Pull request už bol zlúčený, t. j. skontroloval som ho. Skúsil som to na testovacom klastri. Zatiaľ sme nemali situáciu, kedy by sme to mohli overiť na reálnom príklade.
Kedy očakávať?
Neviem. Počkajte mesiac, určite overíme.
Zdroj: habr.com
