

Efekt zväčšovania tabuliek a indexov (bloat) je široko známym javom a vyskytuje sa nielen v Postgres. Existujú spôsoby, ako s ním bojovať „z krabice“, ako napríklad VACUUM FULL alebo CLUSTER, ale tieto metódy blokujú tabuľky počas vykonávania a preto nemusia byť vždy použiteľné.
V článku bude trochu teórie o tom, ako vzniká bloat, ako s ním možno bojovať, o deferred constraints a o problémoch, ktoré prinášajú pri použití rozšírenia pg_repack.
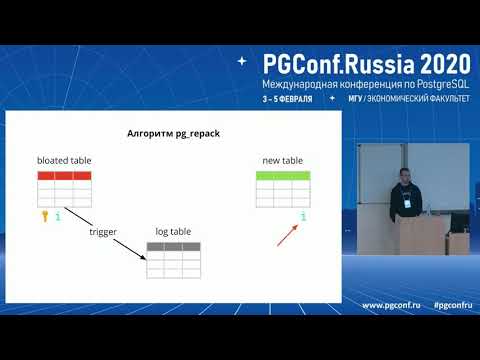
Tento článok je napísaný na základe na PgConf.Russia 2020.
Prečo vzniká bloat
Základom Postgres je viacverzionálny model (). Jeho podstatou je to, že každý riadok v tabuľke môže mať niekoľko verzií, pričom transakcie vidia nie viac ako jednu z týchto verzií, ale nie vždy tú istú. To umožňuje viacerým transakciám pracovať súčasne a prakticky neovplyvňovať jedna druhú.
Je zrejmé, že všetky tieto verzie je potrebné uchovávať. Postgres pracuje s pamäťou po stránkach a stránka je minimálny objem dát, ktorý možno načítať z disku alebo zapísať. Pozrime sa na malý príklad, aby sme pochopili, ako to prebieha.
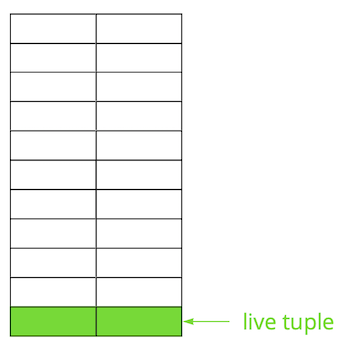
Predpokladajme, že máme tabuľku, do ktorej sme pridali niekoľko záznamov. Na prvej stránke súboru, kde je tabuľka uložená, sa objavili nové údaje. Tieto sú aktuálne verzie riadkov, ktoré sú prístupné ostatným transakciám po potvrdení (pre jednoduchosť predpokladajme, že úroveň izolácie je Read Committed).
Potom sme aktualizovali jeden záznam a tým sme označili starú verziu ako neaktuálnu.
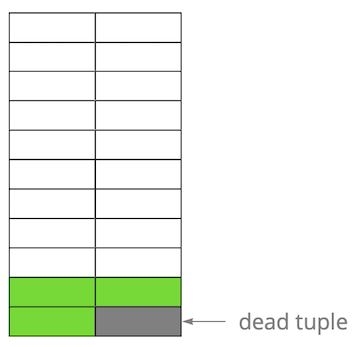
Kroky po kroku, aktualizovaním a odstraňovaním verzií riadkov, sme získali stránku, na ktorej je približne polovica údajov „odpad“. Tieto údaje nie sú viditeľné pre žiadnu transakciu.
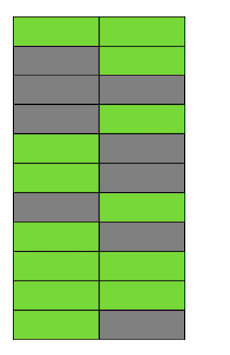
V Postgres existuje mechanizmus , ktorý čistí neaktuálne verzie a uvoľňuje miesto pre nové údaje. Ale ak nie je nastavený dostatočne agresívne alebo je zaneprázdnený prácou v iných tabuľkách, „odpadové údaje“ zostávajú a musíme používať ďalšie stránky pre nové údaje.
Tak v našom príklade v nejakom okamihu tabuľka bude pozostávať z štyroch stránok, ale živých údajov bude len polovica. Výsledkom bude, že pri prístupe k tabuľke načítame oveľa viac údajov, než je potrebné.
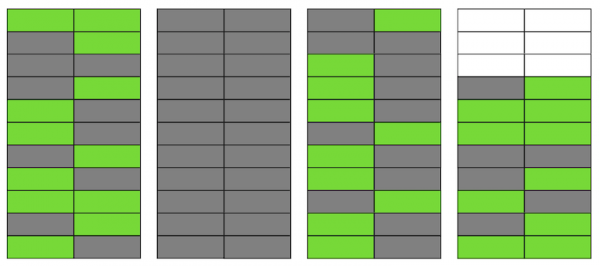
Aj keď teraz VACUUM odstráni všetky neaktuálne verzie riadkov, situácia sa nezhrozí. Získame voľné miesto na stránkach alebo dokonca celé stránky pre nové riadky, ale stále budeme čítať viac údajov, než je potrebné.
Mimochodom, keby úplne prázdna stránka (druhá v našom príklade) bola na konci súboru, VACUUM by ju mohol orezať. Ale momentálne sa nachádza uprostred, takže s ňou nič neurobíme.
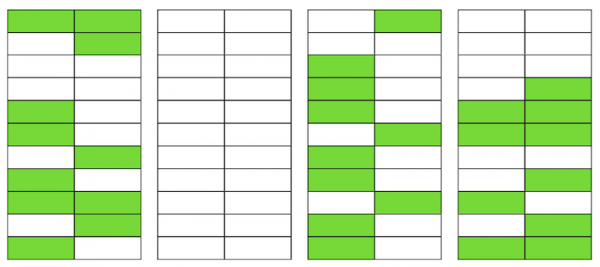
Keď počet takýchto prázdnych alebo veľmi riedkych stránok narastie, čo sa nazýva bloat, začne to ovplyvňovať výkon.
Všetko vyššie uvedené je mechanika vzniku bloat v tabuľkách. V indexoch sa to deje približne rovnako.
Mám bloat?
Existuje niekoľko spôsobov, ako zistiť, či máte bloat. Myšlienka prvého je používanie vnútorných štatistík Postgres, ktoré obsahujú približné informácie o počte riadkov v tabuľkách, množstve 'živých' riadkov atď. Na internete nájdete množstvo variácií už hotových skriptov. My sme vychádzali z od PostgreSQL Experts, ktorý môže posúdiť bloat tabuliek spolu s toastom a bloat btree-indexami. Podľa našich skúseností jeho chybovosť je 10-20%.
Ďalší spôsob je použiť rozšírenie , ktoré umožňuje nahliadnuť do stránok a získať ako odhadované, tak aj presné hodnoty bloat. Ale v druhom prípade bude treba preskenovať celú tabuľku.
Malá hodnota bloat, do 20%, sa považuje za prijateľnú. Môže sa považovať za analóg fillfactor pre a . Pri 50% a viac môžu začať problémy s výkonom.
Spôsoby boja proti bloat
V Postgres existuje niekoľko spôsobov, ako bojovať proti bloat 'z krabice', avšak nie sú vždy vhodné pre každého.
Nastaviť AUTOVACUUM, aby bloat nevznikal. A ak chcete byť presnejší, aby sa držal na pre vás prijateľnej úrovni. Zdá sa to ako „kapitánsky“ tip, ale v skutočnosti sa to vždy ľahko dosiahnuť nedá. Napríklad, ak prebieha aktívny vývoj so zákazkami na pravidelnú zmenu dátových schém alebo prebieha nejaká migrácia dát. Dôsledkom je, že váš profil zaťaženia sa môže často meniť a zvyčajne je odlišný pre rôzne tabuľky. To znamená, že musíte neustále pracovať trochu v predstihu a prispôsobovať AUTOVACUUM meniacemu sa profilu každej tabuľky. Ale je jasné, že urobiť to nie je jednoduché.
Ďalším rozšíreným dôvodom, prečo AUTOVACUUM nestíha spracovávať tabuľky, sú dlhé transakcie, ktoré mu nedovoľujú čistiť dáta, pretože sú dostupné týmto transakciám. Odporúčanie je tu opäť zrejmé – zbaviť sa „visiacich“ transakcií a minimalizovať čas aktívnych transakcií. Ale ak je zaťaženie vašej aplikácie hybridom OLAP a OLTP, môže sa naraz vyskytovať veľa častých aktualizácií a krátkych dotazov, ako aj dlhé operácie – napríklad vytváranie nejakého reportu. V takejto situácii sa oplatí zvážiť rozdelenie zaťaženia na rôzne databázy, čo umožní vykonať jemnejšie nastavenie každej z nich.
Ďalší príklad – aj keď je profil homogénny, ale databáza je pod veľmi vysokým zaťažením, tak aj maximálne agresívny AUTOVACUUM nemôže stihnúť a bloat sa bude objavovať. Škálovanie (vertikálne alebo horizontálne) je jediným riešením.
Čo robiť v situácii, keď ste nastavili AUTOVACUUM, ale bloat naďalej rastie.
Tím VACUUM FULL prestavuje obsah tabuliek a indexov a necháva v nich len aktuálne údaje. Pre odstránenie bloat funguje dokonale, ale počas jej vykonávania sa získava exkluzívna blokácia na tabuľku (AccessExclusiveLock), ktorá neumožňuje vykonávať dotazy na túto tabuľku, ani select-y. Ak si môžete dovoliť zastaviť vašu službu alebo jej časť na určitý čas (od desiatok minút po niekoľko hodín v závislosti od veľkosti databázy a vášho hardvéru), tak táto možnosť je najlepšia. Bohužiaľ, nestíhame spustiť VACUUM FULL včas počas naplánovanej údržby, takže taký spôsob nie je pre nás vhodný.
Tím CLUSTER Rovnako reorganizuje obsah tabuliek ako VACUUM FULL, pričom umožňuje určiť index, podľa ktorého budú dáta fyzicky usporiadané na disku (ale v budúcnosti poradie pre nové riadky nie je zaručené). V určitých situáciách je to dobrá optimalizácia pre niekoľko dotazov – pri čítaní viacerých záznamov podľa indexu. Nedostatok tejto príkazu je rovnaký ako u VACUUM FULL – počas vykonávania blokuje tabuľku.
Tím REINDEX je podobná dvom predchádzajúcim, ale vykonáva prestavbu konkrétneho indexu alebo všetkých indexov tabuľky. Zámky sú trochu slabšie: ShareLock na tabuľku (bráni modifikáciám, ale umožňuje vykonávať select) a AccessExclusiveLock na prestavovaný index (blokuje dotazy, ktoré používajú tento index). Avšak v 12. verzii Postgres sa objavil parameter , ktorý umožňuje prestavbu indexu bez blokovania paralelného pridávania, zmeny alebo odstraňovania záznamov.
V starších verziách Postgres sa dá dosiahnuť výsledok podobný REINDEX CONCURRENTLY pomocou . Umožňuje vytvoriť index bez prísneho zablokovania (ShareUpdateExclusiveLock, ktorý nebráni paralelným dotazom), potom vymeniť starý index za nový a odstrániť starý index. To umožňuje odstrániť bloat indexov bez rušenia práce vašej aplikácie. Dôležité je zohľadniť, že pri prestavbe indexov bude dodatočná záťaž na diskovú subsystému.
Takže, ak existujú spôsoby pre indexy na odstránenie bloat „za behu“, pre tabuľky také možnosti nie sú. Tu prichádzajú do hry rôzne externé rozšírenia: (predtým pg_reorg), , a ďalšie. V rámci tohto článku ich nebudem porovnávať a poviem len o pg_repack, ktoré po niektorých vylepšeniach používame u seba.
Ako funguje pg_repack
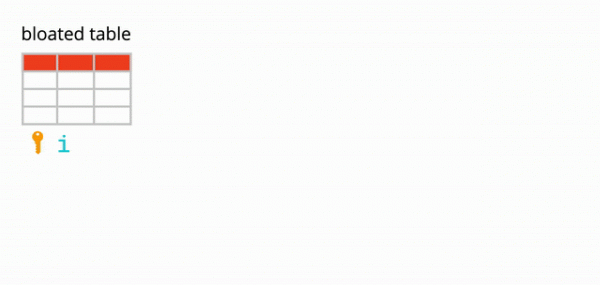
Predpokladajme, že máme celkom bežnú tabuľku – s indexmi, obmedzeniami a, žiaľ, s bloat. Prvým krokom pg_repack vytvorí log-tab tú, aby uchovávala dáta o všetkých zmenách počas vykonávania. Spúšťač bude replikovať tieto zmeny na každý insert, update a delete. Potom sa vytvorí tabuľka, ktorá je štrukturálne podobná pôvodnej, ale bez indexov a obmedzení, aby sa nezrýchlil proces vkladania dát.
Následne pg_repack presunie do novej tabuľky dáta zo starej, automaticky filtrujúc všetky neaktuálne riadky a potom vytvorí indexy pre novú tabuľku. Počas vykonávania všetkých týchto operácií sa v logovej tabuľke hromadia zmeny.
Nasledujúci krok je presunúť zmeny do novej tabuľky. Presun sa vykonáva v niekoľkých iteráciách a keď v logovej tabuľke zostane menej ako 20 záznamov, pg_repack získa prísnu zámku, presunie posledné dáta a v systémových tabuľkách Postgres nahradí starú tabuľku novou. Je to jediný a veľmi krátky okamih, keď nebudete môcť pracovať s tabuľkou. Potom sa stará tabuľka a tabuľka s logmi vymažú a vo filesystéme sa uvoľní miesto. Proces je dokončený.
Teoreticky to vyzerá skvele, ale čo v praxi? Testovali sme pg_repack bez zaťaženia aj pod zaťažením, overili sme jeho prevádzku v prípade predčasného zastavenia (jednoducho povedané, cez Ctrl+C). Všetky testy boli úspešné.
Vyšli sme na produkciu – a tu sa všetko vymklo spod kontroly.
Prvý pokus na produkcii
Na prvom klastri sme dostali chybu o porušení unikátneho obmedzenia:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Toto obmedzenie malo automaticky vygenerované meno index_16508 – vytvoril ho pg_repack. Podľa atribútov, ktoré sú jeho súčasťou, sme určili "naše" obmedzenie, ktoré mu zodpovedá. Problém spočíval v tom, že to nie je celkom bežné obmedzenie, ale oneskorené (), t.j. jeho overenie sa vykonáva neskôr, ako je sql príkaz, čo vedie k neočakávaným dôsledkom.
Oneskorené obmedzenia: na čo sú potrebné a ako fungujú
Trochu teórie o oneskorených obmedzeniach.
Zvážme jednoduchý príklad: máme tabuľku s referenciou na automobily s dvoma atribútmi – názvom a poradím automobilu v referenčnom zozname.
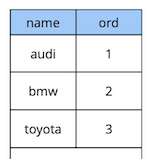
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Povedzme, že potrebujeme prehodiť prvé a druhé automobily. Riešenie "násilím" – aktualizovať prvú hodnotu na druhú a druhú na prvú:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Ale pri vykonávaní tohto kódu očakávane dostaneme porušenie obmedzenia, pretože poradie hodnôt v tabuľke je unikátne:
[23305] CHYBA: duplicitná hodnota kľúča porušuje jedinečný obmedzenie “uk_cars”
Podrobnosti: Kľúč (ord)=(2) už existuje.
Ako to spraviť inak? Prvá možnosť: pridať ďalšiu zmenu hodnoty na poradí, ktorá v tabuľke určite neexistuje, napríklad “-1”. V programovaní sa tomu hovorí “výmena hodnôt dvoch premenných cez tretiu”. Jedinou nevýhodou tohto spôsobu je dodatočný update.
Druhá možnosť: preprojektovať tabuľku tak, aby používala typ dát s plávajúcou desatinnou čiarkou pre hodnotu poradia namiesto celých čísel. Potom sa pri aktualizácii hodnoty z 1, napríklad, na 2.5 prvý záznam automaticky “postaví” medzi druhý a tretí. Toto riešenie funguje, no existujú dve obmedzenia. Po prvé, nebude to pre vás fungovať, ak sa hodnota niekde používa v rozhraní. Po druhé, v závislosti od presnosti typu dát budete mať obmedzený počet možných vložení pred vykonaním prepočtu hodnôt všetkých záznamov.
Tretia možnosť: nastaviť obmedzenie ako odložené, aby sa kontrolovalo iba v momente commitu:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Keďže logika nášho pôvodného dotazu zaručuje, že k momentu commitu budú všetky hodnoty jedinečné, úspešne sa vykoná.
Uvažovaný príklad je síce veľmi syntetický, ale ideu odhaľuje. V našej aplikácii používame odložené obmedzenia na implementáciu logiky, ktorá sa zaoberá riešením konfliktov pri súčasnom práci používateľov s rôznymi spoločnými objektmi-widgetmi na tabuli. Použitie takýchto obmedzení nám umožňuje trochu zjednodušiť aplikačný kód.
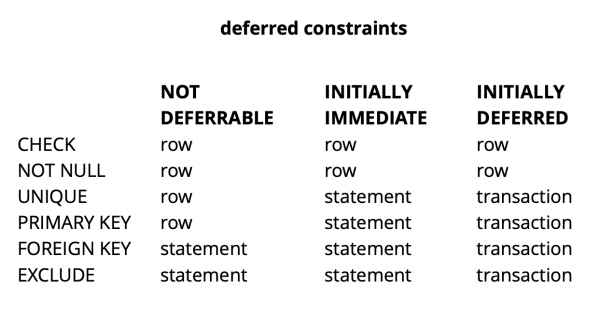
Celkovo, v závislosti od typu obmedzenia v Postgres existujú tri úrovne granularizácie ich kontroly: úroveň riadku, transakcie a výrazu.
Zdroj:
CHECK a NOT NULL sa vždy kontrolujú na úrovni riadku, pre ostatné obmedzenia, ako je vidieť z tabuľky, existujú rôzne možnosti. O podrobnostiach sa dá viac prečítať. .
Ak to stručne zhrnieme, tak odložené obmedzenia v niektorých situáciách prinášajú prehľadnejší kód a menej príkazov. Avšak za to sa musíme zaplatiť komplikovaním procesu ladenia, pretože čas vzniku chyby a chvíľa, keď sa o nej dozvieme, sú časovo oddelené. Ďalším možným problémom je, že plánovač nemusí vždy vytvoriť optimálny plán, ak je v dopyte zahrnuté odložené obmedzenie.
Úprava pg_repack
Rozobrali sme, čo sú to odložené obmedzenia, ale aký súvis majú s naším problémom? Pripomeňme si chybu, ktorú sme dostali skôr:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Tá nastáva v okamihu kopírovania údajov z logovej tabuľky do novej tabuľky. Vyzerá to zvláštne, pretože údaje v logovej tabuľke sa commitujú spolu s údajmi v pôvodnej tabuľke. Ak spĺňajú obmedzenia pôvodnej tabuľky, ako môžu porušovať tie isté obmedzenia v novej?
Ako sa ukazuje, korene problému sú v predchádzajúcom kroku práce pg_repack, v ktorom sa vytvárajú len indexy, ale nie obmedzenia: v starej tabuľke bolo jedinečné obmedzenie, a v novej miesto neho vznikol jedinečný index.
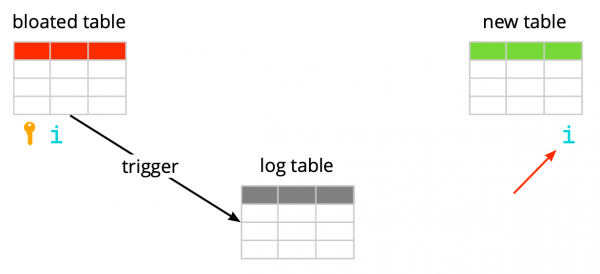
Tu je dôležité poznamenať, že ak je obmedzenie bežné, a nie odložené, potom vytvorený jedinečný index je ekvivalentný tomuto obmedzeniu, pretože jedinečné obmedzenia v Postgres sa realizujú pomocou vytvorenia jedinečného indexu. Ale v prípade odloženého obmedzenia sa správanie nelíši, pretože index nemôže byť odložený a vždy sa kontroluje v okamihu vykonania sql príkazu.
Takže podstatou problému je „odloženosť“ kontroly: v pôvodnej tabuľke dochádza k nej v okamihu commitu, zatiaľ čo v novej sa kontroluje v momente vykonania sql príkazu. To znamená, že musíme zabezpečiť, aby sa kontroly vykonávali rovnako v oboch prípadoch: buď vždy odložene, alebo vždy hneď.
Takže, aké nápady sme mali.
Vytvoriť index, podobný deferred
Prvá myšlienka – vykonávať obe kontroly v režime okamžitého vyhodnocovania. To môže vyvolať niekoľko falošne pozitívnych reakcií obmedzenia, ale ak ich bude len zopár, nemalo by to ovplyvniť prácu používateľov, pretože pre nich sú takéto konflikty bežnou situáciou. K tomu dochádza napríklad, keď dvaja používateľia začnú súčasne upravovať ten istý widget a klient druhého používateľa nestihne získať informácie o tom, že widget už bol uzamknutý na úpravy prvým používateľom. V takejto situácii server odpovie druhému používateľovi zamietnutím a jeho klient vráti zmeny a uzamkne widget. O niečo neskôr, keď prvý používateľ dokončí úpravy, druhý dostane informácie, že widget už nie je uzamknutý a môže svoje akcie zopakovať.
Aby boli kontroly vždy v naliehavom režime, vytvorili sme nový index, ktorý je podobný originálnemu odloženému obmedzeniu:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- spustiť pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
Na testovacom prostredí sme dostali iba niekoľko očakávaných chýb. Úspech! Znovu sme spustili pg_repack na produkcii a za hodinu sme dostali 5 chýb na prvom klasteri. To je prijateľný výsledok. Avšak už na druhom klasteri sa počet chýb zvýšil niekoľkokrát a museli sme zastaviť pg_repack.
Prečo sa to stalo? Pravdepodobnosť výskytu chyby závisí od toho, koľko používateľov pracuje súčasne s tými istými widgetmi. Podľa všetkého, v tom momente bolo s údajmi, ktoré sú uložené na prvom klasteri, oveľa menej konkurentných zmien ako na ostatných, t.j. mali sme jednoducho "šťastie".
Myšlienka nevyšla. V tom momente sme videli dve ďalšie možnosti riešenia: prepísať náš aplikačný kód, aby sme sa vzdali odložených obmedzení, alebo "naučiť" pg_repack pracovať s nimi. Vybrali sme druhú možnosť.
Nahradiť indexy v novej tabuľke odloženými obmedzeniami z pôvodnej tabuľky
Cieľ úpravy bol zrejmý – ak má pôvodná tabuľka odložené obmedzenie, pre novú treba vytvoriť také obmedzenie a nie index.
Aby sme testovali naše zmeny, napísali sme jednoduchý test:
- tabuľka s odloženým obmedzením a jedným záznamom;
- vložíme do cyklu dáta, ktoré konfliktné s existujúcim záznamom;
- robíme update – údaje už nekonflikujú;
- komitujeme zmeny.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Pôvodná verzia pg_repack vždy spadla na prvom insert, vylepšená verzia fungovala bez chýb. Skvelé.
Ideme na produkciu a opäť dostávame chybu v tej istej fáze kopírovania údajov z logovacej tabuľky do novej:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Klasická situácia: na testovacích prostrediach všetko funguje, ale na produkcii – nie?!
APPLY_COUNT a prepojenie dvoch dávok
Začali sme analyzovať kód doslova po riadkoch a objavili sme dôležitý moment: prelievanie údajov z logovacej tabuľky do novej prebieha dávkami, konštanta APPLY_COUNT určovala veľkosť dávky:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* možno je stále nejaké tuple, opakuj. */
...
}
Problém je v tom, že údaje pôvodnej transakcie, v ktorej môže niekoľko operácií potenciálne porušiť obmedzenie, sa pri prenose môžu dostať na prepojenie dvoch dávok – polovica príkazov bude potvrdená v prvej dávke a druhá polovica – v druhej. A tu ako sa to podarí: ak príkazy v prvej dávke nič neporušujú, všetko je v poriadku, a ak porušujú – nastáva chyba.
APPLY_COUNT je 1000 záznamov, čo vysvetľuje, prečo naše testy prešli úspešne – nepokrývali prípad “prepojenia dávok”. Použili sme dva príkazy – insert a update, takže presne 500 transakcií po dva príkazy sa vždy vošlo do dávky a nemali sme problémy. Po pridaní druhého update naša úprava prestala fungovať:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- ešte jeden update
    COMMIT;
  END;
END LOOP;
Takže ďalšou úlohou je zabezpečiť, aby údaje z pôvodnej tabuľky, ktoré sa menili v jednej transakcii, sa dostali do novej tabuľky taktiež v rámci jednej transakcie.
Zrieknutie sa dávkovania
A opäť sme mali dva varianty riešenia. Prvý: vzdajme sa rozdelenia na batch a presuňme dáta jednou transakciou. Tento prístup mal tú výhodu, že bol jednoduchý – požadované zmeny v kóde boli minimálne (mimochodom, v starších verziách vtedy ešte pg_reorg fungoval presne takto). Ale existuje problém – vytvárame dlhú transakciu, a to je, ako bolo predtým uvedené, hrozba pre vznik nového bloatu.
Druhým riešením je zložitejšie, ale pravdepodobne správnejšie: vytvoriť v logovej tabuľke stĺpec s identifikátorom transakcie, ktorá pridala dáta do tabuľky. Potom pri kopírovaní dát môžeme tieto dáta skupinovať podľa tohto atribútu a zaručiť, že súvisiace zmeny budú presúvané spoločne. Batch sa bude skladať z niekoľkých transakcií (alebo jednej veľkej) a jeho veľkosť sa bude meniť v závislosti od toho, koľko dát bolo v týchto transakciách zmenených. Je dôležité poznamenať, že keďže dáta rôznych transakcií sa dostávajú do logovej tabuľky v náhodnom poradí, už nebude možné čítať ju sekvenčne ako predtým. seqscan pri každom dotaze s filtrovaním podľa tx_id – to je príliš drahé, potrebujeme index, ale ten spomalí prácu metódy kvôli režijným nákladom na jeho aktualizáciu. V podstate, ako vždy, je potrebné za niečo obetovať.
Takže sme sa rozhodli začať s prvým variantom, ktorý bol jednoduchší. Najprv bolo potrebné zistiť, či bude dlhá transakcia skutočným problémom. Keďže hlavný presun dát zo starej tabuľky do novej sa takisto robí v jednej dlhej transakcii, otázka sa pretransformovala na 'o koľko túto transakciu predĺžime?' Dĺžka prvej transakcie závisí hlavne od veľkosti tabuľky. Dĺžka novej transakcie závisí od toho, koľko zmien sa nahromadí v tabuľke počas presunu dát, teda od intenzity záťaže. Spustenie pg_repack sa uskutočnilo počas minimálneho zaťaženia na službe a objem zmien bol neporovnateľne malý v porovnaní s pôvodným objemom tabuľky. Rozhodli sme sa, že môžeme prehliadnuť čas novej transakcie (na porovnanie, priemerne to je 1 hodina a 2-3 minúty).
Experimenti boli pozitívne. Spustenie na produkcii tiež. Pre prehľadnosť – obrázok s veľkosťou jednej z databáz po spustení:
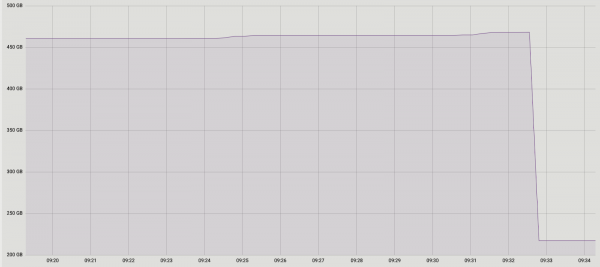
Keďže nás to rozhodnutie úplne uspokojilo, nezkúšali sme implementovať druhé, ale zvažujeme možnost jeho diskusie s vývojármi rozšírenia. Naša aktuálna úprava, žiaľ, zatiaľ nie je pripravená na publikáciu, pretože sme vyriešili problém len s unikátnymi odloženými obmedzeniami, a pre plnohodnotný patch je potrebné zabezpečiť aj podporu ďalších typov. Dúfame, že sa nám to podarí spraviť v budúcnosti.
Možno máte otázku, prečo sme sa vôbec pustili do tejto histórie s úpravou pg_repack a nezačali sme napríklad používať jeho alternatívy? V určitom momente sme o tom tiež uvažovali, no pozitívna skúsenosť s jeho používaním zatiaľ na tabuľkách bez odložených obmedzení nás motivovala k tomu, aby sme sa pokúsili pochopiť podstatu problému a opraviť ho. Okrem toho aj na využívanie iných riešení je potrebný čas na vykonanie testov, preto sme sa rozhodli, že najprv skúsime opraviť problém v ňom, a ak zistíme, že sa nám to nepodarí spraviť v rozumnom čase, potom začneme zvažovať alternatívy.
Zhrnutie
Čo môžeme odporučiť na základe vlastných skúseností:
- Sledujte svoj bloat. Na základe údajov monitorovania budete schopní pochopiť, ako dobre je nastavený autovacuum.
- Nastavujte AUTOVACUUM, aby ste udržali bloat na prijateľnej úrovni.
- Ak bloat predsa len rastie a nemôžete ho poraziť s pomocou prostriedkov „z krabice“, nebojte sa používať externé rozšírenia. Najdôležitejšie je všetko dôkladne testovať.
- Nebojte sa vylepšiť externé riešenia podľa svojich potrieb – niekedy to môže byť efektívnejšie a dokonca jednoduchšie, než meniť vlastný kód.
Zdroj: habr.com
