

Všetkým prajem dobre!
Volám sa Nikita, som tímový vedúci tímu inžinierov Cian. Jednou z mojich úloh v spoločnosti je znížiť počet incidentov súvisiacich s infraštruktúrou na produkcii na nulu.
To, o čom sa bude hovoriť ďalej, nám prinieslo veľa bolesti a cieľom tohto článku je zabrániť iným ľuďom opakovať naše chyby alebo aspoň minimalizovať ich vplyv.
Preámbula
Kedysi dávno, keď Cian pozostával z monolitov a o mikroslužbách sa ešte ani len neuvažovalo, sme merali dostupnosť zdroja kontrolou 3–5 stránok.
Odpovedajú — všetko je v poriadku, neodpovedajú dlhší čas — alert. Koľko času musia nepracovať, aby to bolo považované za incident, rozhodovali ľudia na poradách. Tím inžinierov sa vždy zúčastňoval na vyšetrovaní incidentu. Keď bolo vyšetrovanie ukončené, napísali sme post mortem — akýsi report posielaný e-mailom v formáte: čo sa stalo, ako dlho to trvalo, čo sme robili v danej chvíli a čo urobíme v budúcnosti.
Hlavné stránky webu alebo ako vieme, že sme udreli na dno
Aby sme mohli nejako posúdiť prioritu chyby, vyčlenili sme najkritickejšie stránky webu pre obchodné funkcie. Na nich počítame počet úspešných/neúspešných požiadaviek a časových limitov. Týmto spôsobom meriame uptime.
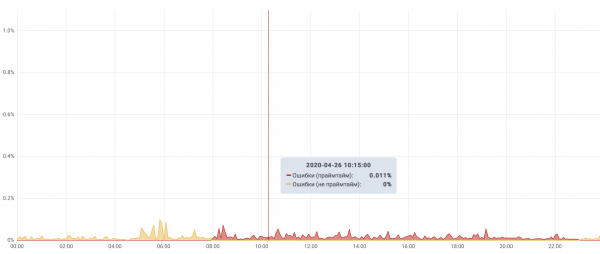
Povedzme, že sme zistili, že existuje niekoľko superdôležitých sekcií webu, ktoré sú zodpovedné za hlavný servis — vyhľadávanie a podávanie inzerátov. Ak počet požiadaviek, ktoré skončili chybou, presiahne 1%, je to kritický incident. Ak sa v priebehu 15 minút v peak čase percento chýb presiahne 0,1%, aj to sa považuje za kritický incident. Tieto kritériá pokrývajú väčšinu incidentov, ostatné presahujú rámec tohto článku.
Top najlepších incidentov Cian
Takže sme sa určite naučili určiť, že incident sa stal.
Teraz je každý incident u nás podrobne opísaný a zaznačený v epike Jira. Mimochodom, na to sme založili samostatný projekt, nazvali sme ho FAIL — v ňom je možné vytvárať len epiky.
Ak by sme zhromaždili všetky neúspechy za posledné roky, najviac by prevládali:
- incidenty súvisiace s mssql;
- incidenty spôsobené vonkajšími faktormi;
- chyby administrátora.
Zamerajme sa podrobnejšie na chyby administrátorov, ako aj na niektoré ďalšie zaujímavé neúspechy.
Piate miesto — „Upratujeme v DNS“
Bol to pochmúrny utorok. Rozhodli sme sa upratať v DNS klastri.
Chceli sme prejsť na interné DNS servery z bind na powerdns, pričom sme vyhradili úplne samostatné servery, na ktorých okrem DNS nič nie je.
Umístili jsme po jednom DNS serveru na každé miesto našich dátových centier a nastal čas presunúť zóny z bind do powerdns a prepnúť infraštruktúru na nové servery.
V najväčšej chvíli presunu zostal zo všetkých serverov, ktoré boli uvedené v lokálnych cache-och bind na všetkých serveroch, len jeden, ktorý bol v dátovom centre v Petrohrade. Toto DC bolo pôvodne deklarované ako pre nás nekritické, no zrazu sa stalo jediným bodom zlyhania.
Práve v takomto období presunu spadol kanál medzi Moskvou a Petrohradom. Fakticky sme zostali bez DNS na päť minút a obnovili sme sa, keď hoster odstránil problémy.
Vývody:
Ak sme predtým zanedbávali vonkajšie faktory počas prípravy na práce, teraz ich tiež zahrnuli do zoznamu toho, na čo sa pripravujeme. A teraz sa snažíme o to, aby všetky komponenty boli rezervované n-2, a počas prác môžeme tento úroveň znížiť na n-1.
- Pri vytváraní akčného plánu si všimnite body, kde môže servis zlyhať, a premyslite si scenár, kde všetko ide "horšie neexistuje" vopred.
- Rozdeľte interné DNS servery do rôznych geografických lokalít/dátových centier/staníc/prepínačov/vstupov.
- Na každom serveri nainštalujte lokálny cache-ovací DNS server, ktorý presmerováva požiadavky na hlavné DNS servery, a v prípade jeho nedostupnosti bude odpovedať z cache.
Štvrté miesto - "Upratujeme v Nginx"
Jedného krásneho dňa sa náš tím rozhodol, že "stačilo to znášať", a začal proces refaktoringu konfigurácií nginx. Hlavným cieľom je priniesť konfigurácie do intuitívnej štruktúry. Predtým to všetko bolo "historicky dané" a neneslo v sebe žiadnu logiku. Teraz sme každý server_name vytrhli do rovnomenného súboru a rozdelili všetky konfígy do priečinkov. Mimochodom, konfigurácia obsahuje 253949 riadkov alebo 7836520 znakov a zabera takmer 7 megabajtov. Horná úroveň štruktúry:
Štruktúra Nginxu
├── prístup
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Výrazne sa to zlepšilo, ale počas premenovania a rozdeľovania konfigurácií mala časť z nich nesprávne prípony a nedostala sa do direktívy include *.conf. Následkom toho sa časť hostiteľov stala nedostupná a vracala 301 na hlavnú stránku. Pretože kód odpovede nebol 5xx/4xx, nevšimli si to hneď, ale až skoro ráno. Po tom sme začali písať testy na kontrolu infraštruktúrnych komponentov.
Vývody:
- Správne štruktúrujte konfigurácie (nielen nginx) a premyslite štruktúru v ranom štádiu projektu. Týmto spôsobom ich spravíte zrozumiteľnejšími pre tím, čo zase zníži TTM.
- Pre niektoré infraštruktúrne komponenty píšte testy. Napríklad: overenie, že všetky kľúčové server_name vracajú správny status, + telo odpovede. Stačí mať po ruke niekoľko skriptov, ktoré kontrolujú základné funkcie komponentu, aby ste sa v noci 3:00 nezúfalo snažili spomenúť, čo ešte treba skontrolovať.
Tretie miesto — „Zrazu sa minulo miesto v Cassandre“
Dáta rástli postupne, a všetko bolo v poriadku, kým v klastre Cassandre nezačali zlyhávať opravy veľkých keyspace, pretože na nich nemôže prebehnúť kompakcia.
Jedného pochmúrneho dňa sa klaster takmer premenil na tekvicu, a to konkrétne:
- miesto zostalo približne 20% celkovo v klastri;
- nie je možné plne pridať uzly, pretože po pridaní uzla neprebieha cleanup kvôli nedostatku miesta na oddieloch;
- výkon pomaly klesá, pretože nefunguje kompakcia;
- klaster pracuje v havarijnom režime.
Odchod — pridali sme ďalších 5 uzlov bez údržby, po čom sme začali postupne odoberať z clustra a opäť zavádzať, ako prázdne uzly, na ktorých sa minulo miesto. Času bolo stráveného oveľa viac, ako by sme chceli. Bol tam riziko čiastočnej alebo úplnej nedostupnosti clustra.
Vývody:
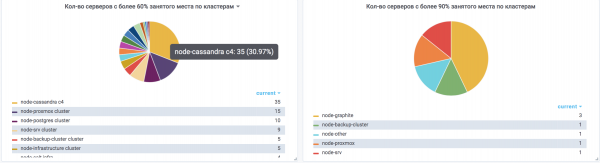
- Na všetkých serveroch cassandra by nemalo byť obsadené viac ako 60% miesta na každej jednotke.
- Mali by byť zaťažené maximálne na 50% podľa CPU.
- Nie je dobré zanedbávať plánovanie kapacity a treba ho premýšľať pre každú zložku, vychádzajúc z jej špecifík.
- Čím viac uzlov je v clustri — tým lepšie. Servery, ktoré obsahujú malý objem dát, sa rýchlejšie obnovujú a taký clust je ľahšie oživiť.
Druhé miesto — „Zmizli dáta z consul key-value úložiska“
Na zistenie služieb používame consul, rovnako ako mnohí iní. Ale náš key-value je používaný aj pre blue-green nasadenie monolitu. Uchováva tam informácie o aktívnych a neaktívnych upstreamoch, ktoré sa pri nasadení menia. Na to bol napísaný nasadzovací servis, ktorý komunikoval s KV. V nejakom momente dáta z KV zmizli. Obnovili sme ich z pamäti, ale s radom chýb. V dôsledku toho sa pri nasadení záťaž na upstreamy rozdelila nerovnomerne, a dostali sme veľa chýb 502 kvôli preťaženiu backendov podľa CPU. Nakoniec sme prešli z consul KV na postgres, odkiaľ ich odstrániť už nie je také jednoduché.
Vývody:
- Služby bez akejkoľvek autorizácie by nemali obsahovať kritické údaje pre fungovanie webu. Napríklad, ak nemáte autorizáciu v ES — bolo by lepšie zakázať prístup na úrovni siete z miesta, kde nie je potrebný, ponechať len nevyhnutné a nastaviť action.destructive_requires_name: true.
- Pracujte na mechanizme zálohovania a obnovy vopred. Napríklad si dopredu urobte skript (napríklad na python), ktorý dokáže zálohovať a obnovovať.
Prvé miesto — „Kapitán neviditeľnosť“
V určitom momente sme si všimli, že zaťaženie na upstreamy nginx nie je rovnomerne rozložené, keď bol v backend-e 10 a viac serverov. Pretože round-robin smeroval požiadavky od prvého po posledný upstream v poradí a každý reload nginx začal odznova, prvé upstreamy dostávali vždy viac požiadaviek ako ostatné. Ako dôsledok — fungovali pomalšie a celý web trpel. Toto sa stávalo čoraz markantnejšie so zvyšujúcim sa objemom prevádzky. Jednoduché aktualizovanie nginx na zapnutie random nepomohlo — bolo potrebné predeliť množstvo lua kódu, ktorý nefungoval vo verzii 1.15 (v tom čase). Museli sme upraviť náš nginx 1.14.2 a implementovať do neho podporu random. To vyriešilo problém. Tento bug vyhráva v kategórii „kapitán neviditeľnosť”.
Vývody:
Bolo veľmi zaujímavé a vzrušujúce skúmať tento bug).
- Nastavte monitorovanie tak, aby pomáhalo rýchlo nájsť podobné fluktuácie. Napríklad, môžete použiť ELK na sledovanie rps pre každý backend každého upstreamu, sledujte ich čas odpovede z pohľadu nginx. V tomto prípade nám to pomohlo odhaliť problém.
Väčšine zlyhaní by sa dalo predísť pri precíznejšom prístupe k tomu, čo robíte. Treba si vždy pamätať zákon Murphya: Anything that can go wrong will go wrong, a budovať komponenty s tým na pamäti.
Zdroj: habr.com
