

Ahoj, Habr!
Máte radi lietanie lietadlom? Ja milujem, ale počas samoizolácie som si obľúbil aj analyzovanie údajov o letenkách z jedného známeho zdroja — Aviasales.
Dnes sa pozrieme na prácu Amazon Kinesis, postavíme streamovaciu systém s real-time analytikou, nasadíme NoSQL databázu Amazon DynamoDB ako hlavný úložný priestor a nastavíme upozornenia cez SMS na zaujímavé letenky.
Všetky podrobnosti nájdete nižšie! Poďme na to!
Úvod
Na príklad budeme potrebovať prístup k . Prístup k nemu je poskytovaný zadarmo a bez obmedzení, stačí sa len zaregistrovať v sekcii 'Pre vývojárov', aby ste získali svoj API token na prístup k údajom.
Hlavným cieľom tohto článku je poskytnúť základné porozumenie používaniu prenosu informácií v AWS. Prechádzame na vedľajšiu koľaj s tým, že údaje vracané použitým API nie sú striktne aktuálne a sú odosielané z cache, ktorá je vytvorená na základe vyhľadávaní používateľov stránok Aviasales.ru a Jetradar.com za posledných 48 hodín.
Údaje o letenkách získané prostredníctvom API bude Kinesis-agent, nainštalovaný na produkujúcom stroji, automaticky spracovávať a posielať do správneho prúdu cez Kinesis Data Analytics. Neošetrená verzia tohto prúdu bude priamo zapisovaná do úložiska. Implementované v DynamoDB úložisko 'surových' údajov umožní hlbšiu analýzu leteniek pomocou BI nástrojov, ako napríklad AWS Quick Sight.
Pozrieme sa na dve možnosti nasadenia celej infraštruktúry:
- Ručné — prostredníctvom AWS Management Console;
- Infraštruktúra z kódu Terraform — pre lenivých automatizátorov;
Architektúra vyvíjanej systému
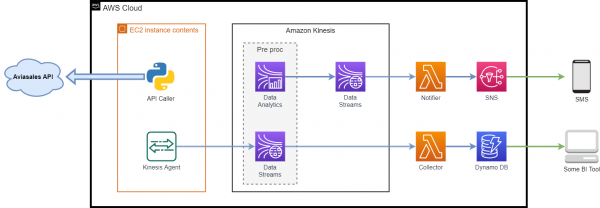
Používané komponenty:
- — údaje, ktoré tento API vracia, budú používané pre celú ďalšiu prácu;
- — bežný virtuálny stroj v cloude, na ktorom sa bude generovať vstupný prúd údajov:
- — je to Java aplikácia, ktorá sa inštaluje lokálne na stroj a poskytuje jednoduchý spôsob zbierania a odosielania údajov do Kinesis (Kinesis Data Streams alebo Kinesis Firehose). Agent neustále sleduje súborový systém v určených adresároch a posiela nové údaje do Kinesis;
- — Python skript, ktorý vykonáva požiadavky na API a ukladať odpoveď do zložky, ktorú monitoruje Kinesis Agent;
- — služba pre streamovanie dát v reálnom čase s rozsiahlymi možnosťami škálovania;
- — serverless služba, ktorá zjednodušuje analýzu streamovaných dát v reálnom čase. Amazon Kinesis Data Analytics prispôsobuje zdroje na prevádzku aplikácií a automaticky sa škáluje pre spracovanie akýchkoľvek objemov prichádzajúcich dát;
- — služba, ktorá umožňuje spúšťať kód bez rezervácie a nastavenia serverov. Všetka výpočtová kapacita sa automaticky škáluje na každý volanie;
- — databáza párov "kľúč-hodnota" a dokumentov, ktorá zabezpečuje latenciu menej ako 10 milisekúnd na akomkoľvek rozsahu. Pri používaní DynamoDB nie je potrebné prideľovať žiadne servery, inštalovať na ne opravy alebo spravovať ich. DynamoDB automaticky škáluje tabuľky, upravujúc objem dostupných zdrojov a zachovávajúc vysoký výkon. Nie sú potrebné žiadne činnosti správy systému;
- — úplne spravovaná služba zasielania správ podľa modelu "publisher-subscriber" (Pub/Sub), s ktorou je možné izolovať mikroslužby, distribuované systémy a serverless aplikácie. SNS sa môže použiť na rozosielanie informácií koncovým používateľom pomocou mobilných push notifikácií, SMS správ a emailov.
Úvodná príprava
Na simuláciu streamu dát som sa rozhodol použiť informácie o letenkách, ktoré vracia API Aviasales. V dosť rozsiahly zoznam rôznych metód, vezmeme jednu z nich — „Kalendár cien na mesiac“, ktorá vracia ceny za každý deň v mesiaci, usporiadané podľa počtu prestupov. Ak sa v požiadavke neodošle mesiac hľadania, vráti sa informácia za mesiac nasledujúci po aktuálnom.
Takže sa zaregistrujeme, získame svoj token.
Príklad požiadavky nižšie:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIVyššie uvedený spôsob získavania dát z API s uvedením tokenu v žiadosti bude fungovať, ale mne sa viac páči prenášať prístupový token cez hlavičku, preto v skripte api_caller.py budeme používať práve tento spôsob.
Príklad odpovede:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
V príklade odpovede API vyššie je zobrazený lístok z Petrohradu do Phuketu... Ach, o čom to snívame...
Keďže som z Kazane a Phuket je teraz len „v našich snoch“, poďme hľadať lístky z Petrohradu do Kazane.
Predpokladá sa, že už máte účet v AWS. Hneď chcem upozorniť, že Kinesis a zasielanie upozornení cez SMS nie sú zahrnuté v ročnom . Ale aj napriek tomu, ak do rozpočtu zarátate pár dolárov, môžete si vybudovať navrhnutý systém a experimentovať s ním. A samozrejme nezabudnite odstrániť všetky zdroje, keď už nebudú potrebné.
Našťastie, DynamoDb a lambda funkcie budú pre nás podmienene bezplatné, ak sa zmestíme do mesačných bezplatných limitov. Napríklad pre DynamoDB: 25 GB úložného priestoru, 25 WCU/RCU a 100 miliónov požiadaviek. A milión vyvolaní lambda funkcií za mesiac.
Ručný deploy systému
Nastavenie Kinesis Data Streams
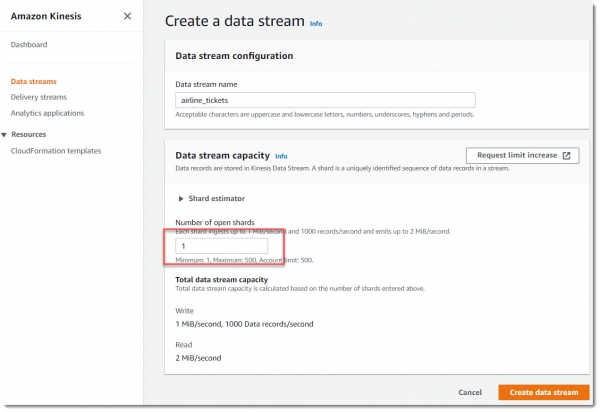
Prejdeme do služby Kinesis Data Streams a vytvárame dva nové prúdy po jednom sharde na každý.
Čo je shard?
Shard je základná jednotka prenosu dát prúdu Amazon Kinesis. Jeden shard zabezpečuje prenos vstupných dát rýchlosťou 1 MB/s a prenos výstupných dát rýchlosťou 2 MB/s. Jeden shard podporuje až 1000 PUT záznamov za sekundu. Pri vytváraní prúdu dát je potrebné uviesť požadovaný počet shardov. Napríklad, môžete vytvoriť prúd dát so štyrmi shardami. Tento prúd dát zabezpečí prenos vstupných dát rýchlosťou 4 MB/s a prenos výstupných dát rýchlosťou 8 MB/s s podporou až 4000 PUT záznamov za sekundu.
Čím viac shardov vo vašom prúde, tým väčšia je jeho priepustnosť. V podstate sa prúdy škálujú pridaním shardov. Ale čím viac shardov máte, tým vyššia je aj cena. Každý shard stojí 1,5 centu za hodinu a navyše 1,4 centa za každých milión operácií pridania do prúdu (PUT payload units).
Vytvoríme nový prúd s názvom airline_tickets, jemu bude stačiť 1 shard:
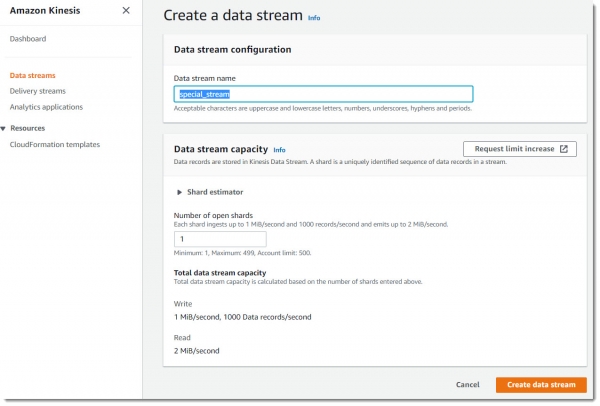
Teraz vytvoríme ďalší prúd s názvom special_stream:
Nastavenie producenta
Ako producent dát na spracovanie úlohy postačuje použiť bežný EC2 inštanc. Nemusí to byť mocný drahý virtuálny stroj, vhodný bude aj spotový t2.micro.
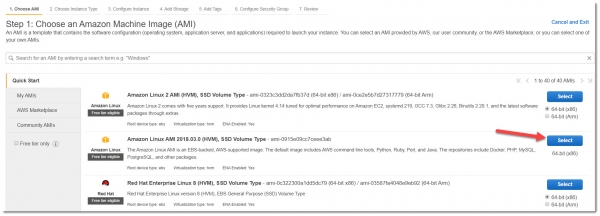
Dôležitá poznámka: ako príklad by sa mala použiť image — Amazon Linux AMI 2018.03.0, s ktorým je menej nastavení pre rýchle spustenie Kinesis Agenta.
Prechádzame do služby EC2, vytvárame novú virtuálnu mašinu, vyberáme požadovaný AMI s typom t2.micro, ktorý patrí do Free Tier:
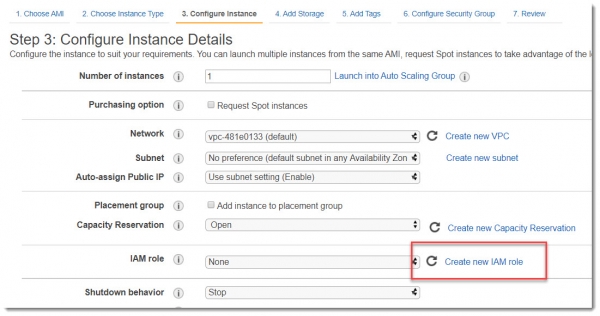
Aby novovytvorená virtuálna mašina mohla interagovať so službou Kinesis, je potrebné jej na to udeliť práva. Najlepší spôsob, ako to urobiť, je priradiť IAM rolu. Preto na obrazovke Krok 3: Konfigurácia podrobností inštancie by sa mala vybrať Vytváranie novej IAM role:
Vytvorenie IAM role pre EC2
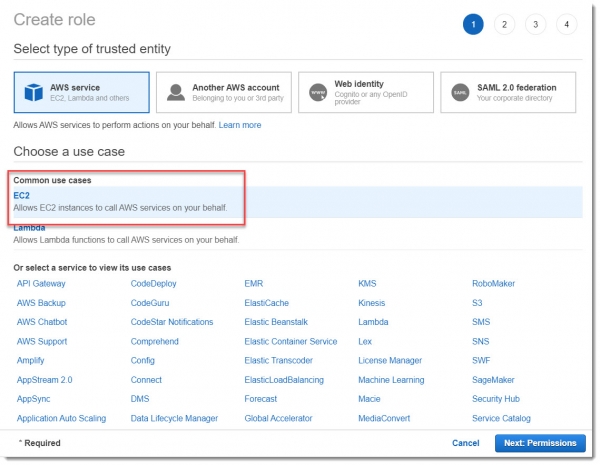
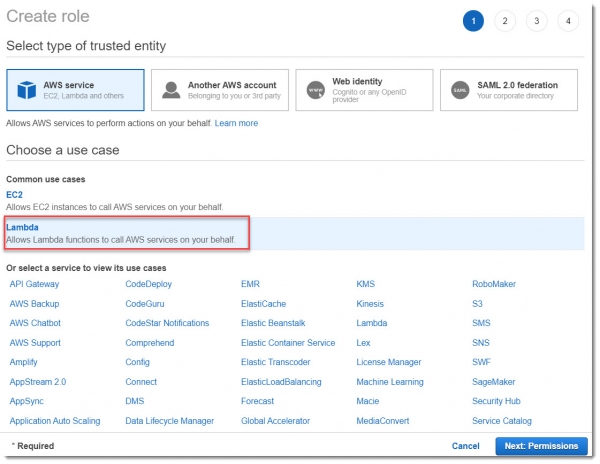
V otvorenom okne vyberáme, že novú rolu vytvárame pre EC2 a prechádzame do sekcie Oprávnenia:
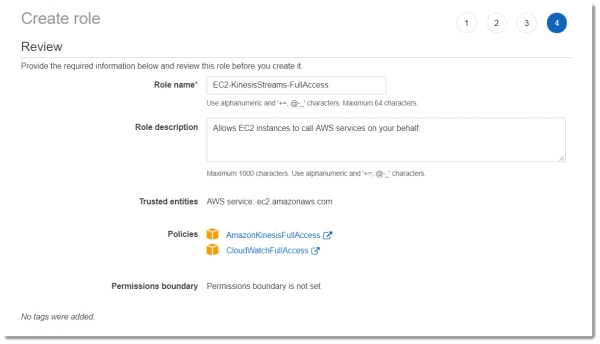
Na vzdelávacom príklade sa nemôžeme zaoberať všetkými detailmi granularného nastavenia práv na zdroje, preto vyberieme prednastavené politiky od Amazonu: AmazonKinesisFullAccess a CloudWatchFullAccess.
Dáme nejaké zmysluplné meno pre túto rolu, napríklad: EC2-KinesisStreams-FullAccess. Ako výsledok by to malo vyzerať rovnako ako je uvedené na obrázku nižšie:
Po vytvorení tejto novej roly nezabudnite ju priradiť k vytváranému inštanciu virtuálnej mašiny:
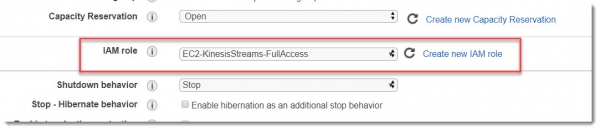
Na tejto obrazovke už nič nemenieme a prechádzame na nasledujúce okná.
Parametre pevného disku môžeme nechať predvolené, tagy tiež (aj keď dobrá prax je používať tagy, aspoň určiť meno inštancie a uviesť prostredie).
Teraz sme na záložke Krok 6: Konfigurácia bezpečnostnej skupiny, kde je potrebné vytvoriť novú alebo uviesť existujúcu bezpečnostnú skupinu, ktorá umožňuje pripojenie cez ssh (port 22) na inštanciu. Vyberte tam Source —> My IP a môžete spustiť inštanciu.
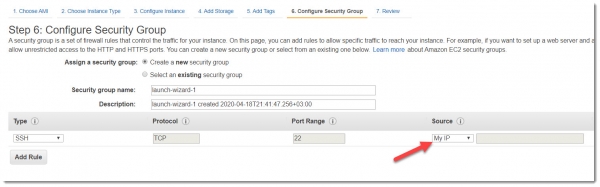
Keď sa dostane do stavu running, môžete sa pokúsiť pripojiť k nemu cez ssh.
Aby ste získali možnosť práce s Kinesis Agentom, po úspešnom pripojení k stroju je potrebné zadať nasledujúce príkazy v termináli:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Vytvoríme priečinok pre uloženie odpovedí API:
sudo mkdir /var/log/airline_ticketsPred spustením agenta je potrebné nastaviť jeho konfiguráciu:
sudo vim /etc/aws-kinesis/agent.jsonObsah súboru agent.json by mal mať nasledujúcu podobu:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "\/var\/log\/airline_tickets\/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Ako vyplýva z konfiguračného súboru, agent bude monitorovať v adresári \/var\/log\/airline_tickets\/ súbory s príponou .log, parsovať ich a prenášať do streamu airline_tickets.
Reštartujeme službu a uistíme sa, že sa spustila a funguje:
sudo service aws-kinesis-agent restartTeraz stiahneme Python skript, ktorý bude žiadať dáta z API:
REPO_PATH=https:\/\/raw.githubusercontent.com\/igorgorbenko\/aviasales_kinesis\/master\/producer

wget $REPO_PATH\/api_caller.py -P \/home\/ec2-user\/\nwget $REPO_PATH\/requirements.txt -P \/home\/ec2-user\/\nsudo chmod a+x \/home\/ec2-user\/api_caller.py
sudo \/usr\/local\/bin\/pip3 install -r \/home\/ec2-user\/requirements.txt
Skript api_caller.py žiada dáta od Aviasales a ukladá prijatú odpoveď do adresára, ktorý skenuje Kinesis agent. Realizácia tohto skriptu je dosť štandardná, existuje trieda TicketsApi, ktorá umožňuje asynchrónne volať API. Do tejto triedy posielame hlavičku s tokenom a parametre požiadavky:
class TicketsApi:
    """Trieda volajúca API."""

    def __init__(self, headers):
        """Inicializačná metóda."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Získať údaje z API požiadavky."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Status odpovede %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Jejda! Vyskytla sa HTTP chyba: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Jejda! Vyskytla sa chyba: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Vráti hlavičky a dotaz pre API požiadavku."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Spustiť kód."""
    if len(sys.argv) != 2:
        print('Použitie: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API vrátilo %s položiek', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s riadkov bolo uložených do %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Jejda! Výsledok požiadavky nebol uložený do súboru. %s',
                         str(e))
    else:
        LOGGER.error('Jejda! API požiadavka zlyhala %s!', response)
Pre testovanie správnosti nastavení a funkčnosti agenta vykonáme testovací beh skriptu api_caller.py:
sudo ./api_caller.py TOKEN 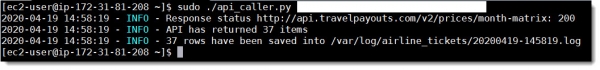
A sledujeme výsledok behu v logoch Agenta a na záložke Monitoring v toku dát airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 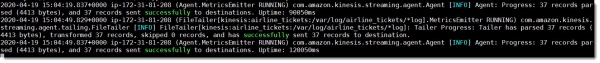
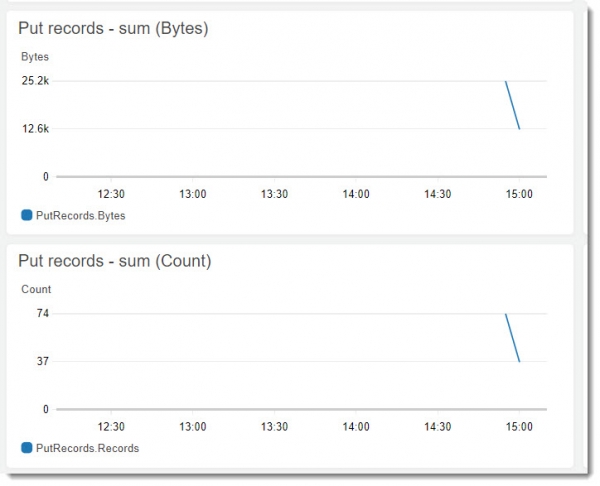
Ako vidno, všetko funguje a Kinesis Agent úspešne odosiela údaje do toku. Teraz nastavíme consumer.
Nastavenie Kinesis Data Analytics
Prejdeme k centrálnej súčasti celej sústavy — vytvoríme novú aplikáciu v Kinesis Data Analytics s názvom kinesis_analytics_airlines_app:
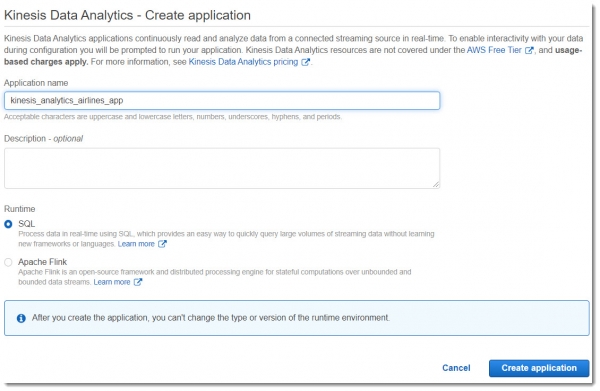
Kinesis Data Analytics umožňuje vykonávať analytiku údajov v reálnom čase z Kinesis Streams pomocou jazyka SQL. Ide o plne automaticky škálovateľnú službu (na rozdiel od Kinesis Streams), ktorá:
- umožňuje vytvárať nové toky (Output Stream) na základe dotazov k zdrojovým údajom;
- poskytuje tok s chybami, ktoré vznikli počas behu aplikácií (Error Stream);
- dokáže automaticky určiť schému vstupných údajov (môže sa manuálne predefinovať, ak je to potrebné).
Toto nie je lacná služba — 0.11 USD za hodinu, preto by sa mala používať opatrne a po dokončení práce by sa mala odstrániť.
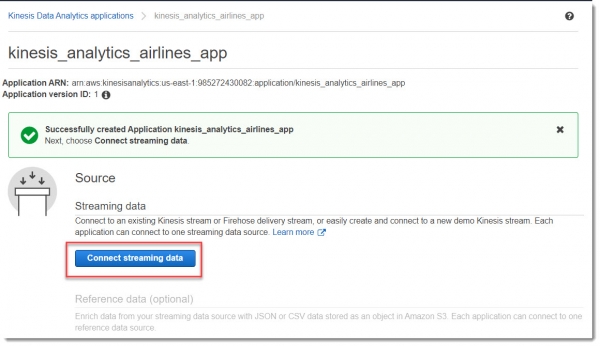
Pripojíme aplikáciu k zdroju údajov:
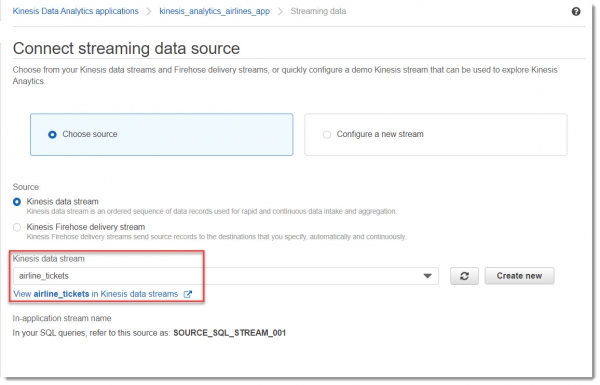
Vyberáme tok, ku ktorému sa chystáme pripojiť (airline_tickets):
Potom je potrebné pripojiť novú IAM rolu, aby aplikácia mohla čítať z toku a zapisovať do toku. Na to stačí nič nemeniť v bloku Access permissions:
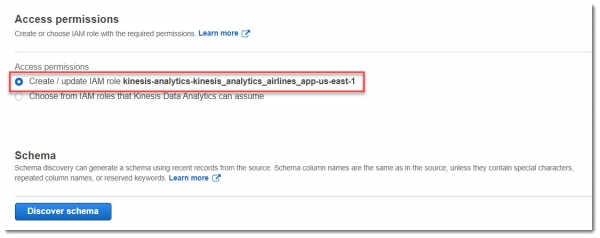
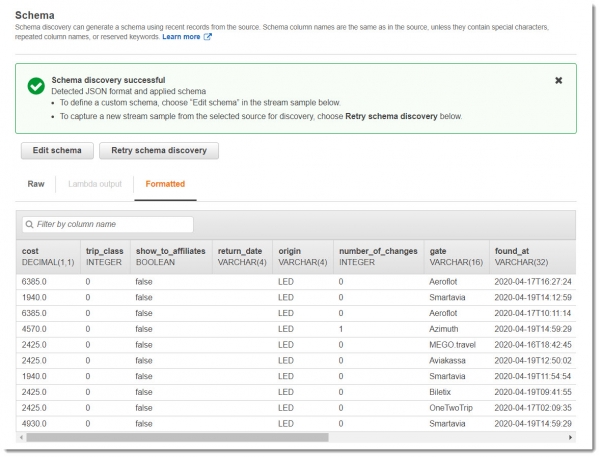
Teraz požiadame o odhalenie schémy údajov v toku, za týmto účelom stlačíme tlačidlo „Discover schema“. V dôsledku toho sa aktualizuje (vytvorí nová) IAM rola a spustí sa odhaľovanie schémy z údajov, ktoré už prišli do toku:
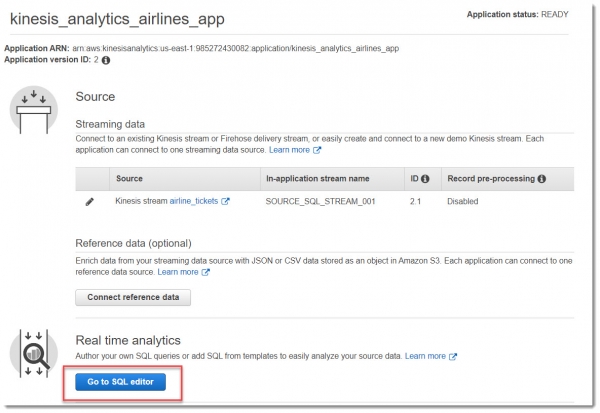
Teraz je potrebné prejsť do SQL editora. Po stlačení tohto tlačidla sa otvorí okno s otázkou o spustení aplikácie — vyberáme, čo chceme spustiť:
Do okna SQL editora vložíme takýto jednoduchý dotaz a stlačíme Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
V relačných databázach pracujete s tabuľkami pomocou operátorov INSERT na pridávanie záznamov a operátora SELECT na dotazovanie údajov. V Amazon Kinesis Data Analytics pracujete s tokmi (STREAM) a „čerpacími zariadeniami“ (PUMP) — nepretržitými dotazmi na vklad, ktoré vkladajú údaje z jedného toku v aplikácii do druhého toku.
V uvedenom SQL dotaze prebieha vyhľadávanie leteniek Aeroflot s cenou nižšou ako päť tisíc rubľov. Všetky záznamy, ktoré spĺňajú tieto podmienky, budú umiestnené do toku DESTINATION_SQL_STREAM.
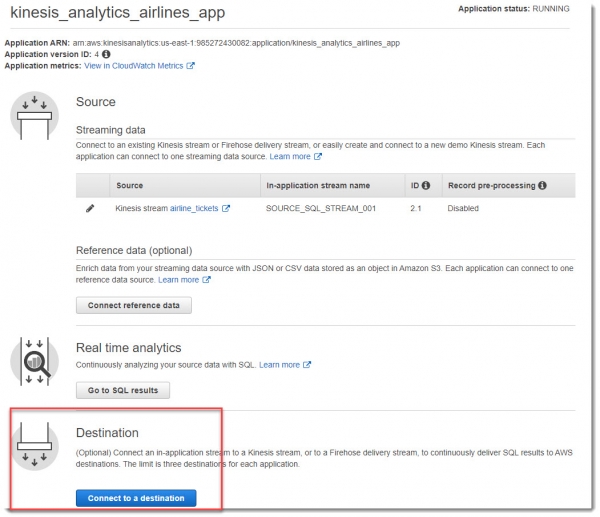
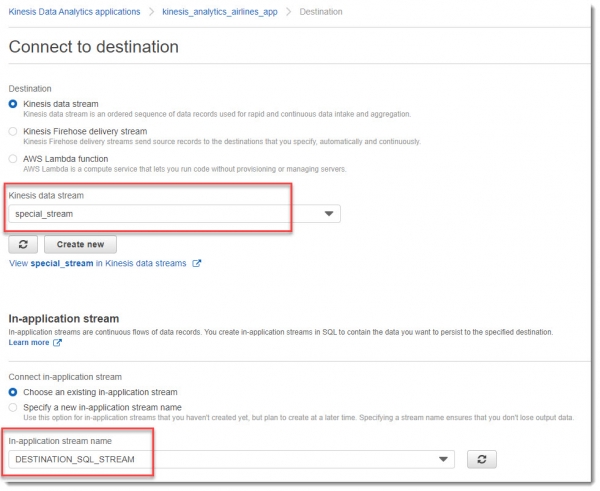
V bloku Destination vyberieme tok special_stream a v rozbaľovacom zozname In-application stream name DESTINATION_SQL_STREAM:
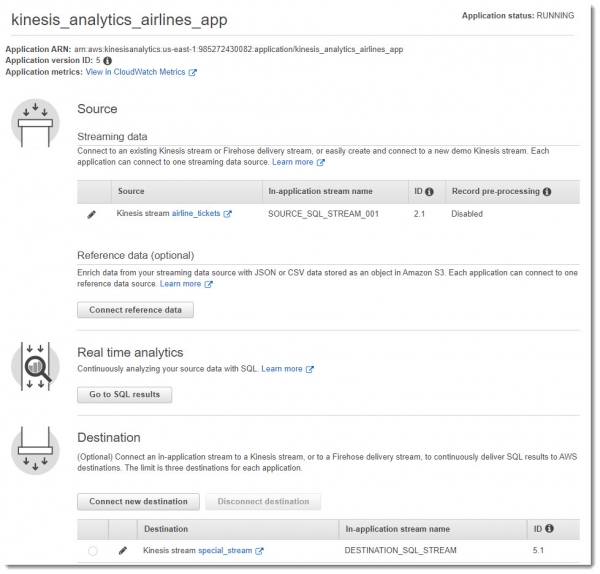
Výsledkom všetkých manipulácií by malo byť niečo podobné obrázku nižšie:
Vytvorenie a prihlásenie na tému SNS
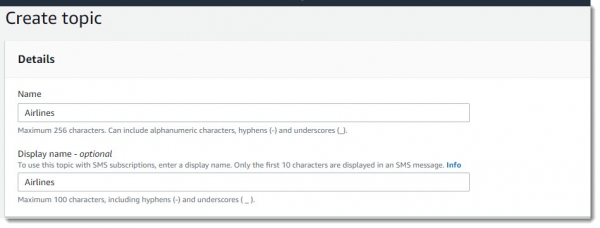
Prechádzame do služby Simple Notification Service a vytvárame tam novú tému s názvom Airlines:
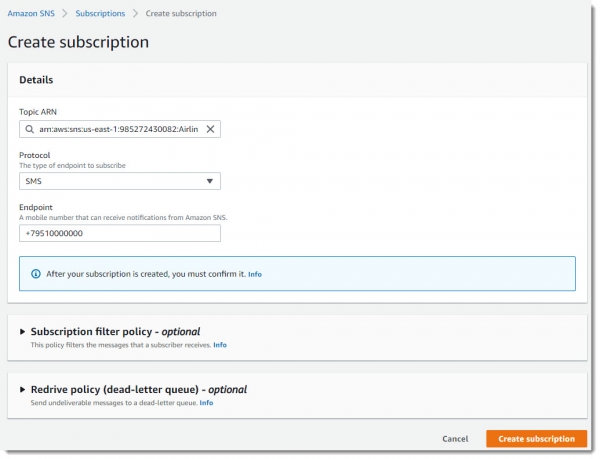
Vytvárame prihlášku na túto tému, v ktorej uvádzame číslo mobilného telefónu, na ktorý budú prichádzať SMS oznámenia:
Vytvorenie tabuľky v DynamoDB
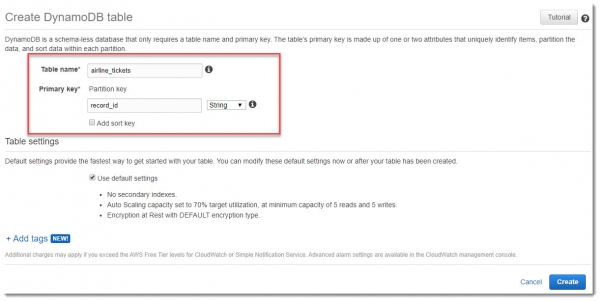
Aby sme uložili nespracované údaje z toku airline_tickets, vytvoríme tabuľku v DynamoDB s rovnakým názvom. Ako primárny kľúč budeme používať record_id:
Vytvorenie lambda funkcie collector
Vytvoríme lambda funkciu s názvom Collector, ktorej úlohou bude prieskum toku airline_tickets a v prípade nájdenia nových záznamov ich vložiť do tabuľky DynamoDB. Je zrejmé, že okrem predvolených práv musí mať táto lambda prístup na čítanie toku údajov Kinesis a zápis do DynamoDB.
Vytvorenie IAM role pre lambda funkciu collector
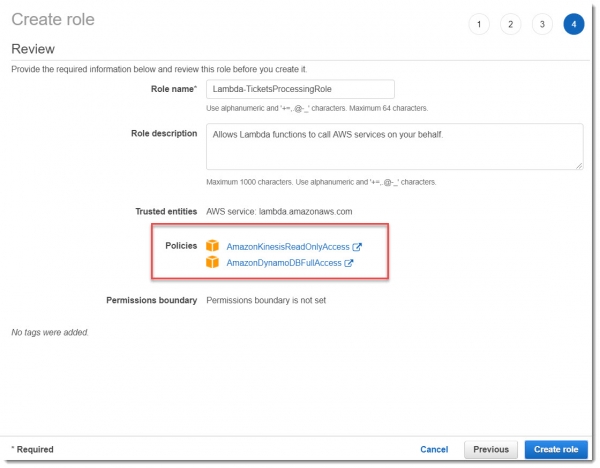
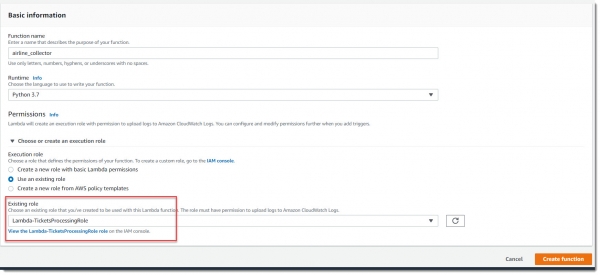
Najskôr vytvoríme novú IAM rolu pre lambdu s názvom Lambda-TicketsProcessingRole:
Pre testovací príklad budú vhodné prednastavené politiky AmazonKinesisReadOnlyAccess a AmazonDynamoDBFullAccess, ako je znázornené na obrázku nižšie:
Táto lambda by sa mala spúšťať na základe spúšťača z Kinesis pri pridaní nových záznamov do toku airline_stream, preto je potrebné pridať nový spúšťač:
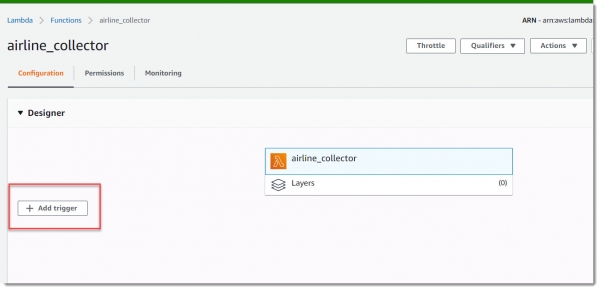
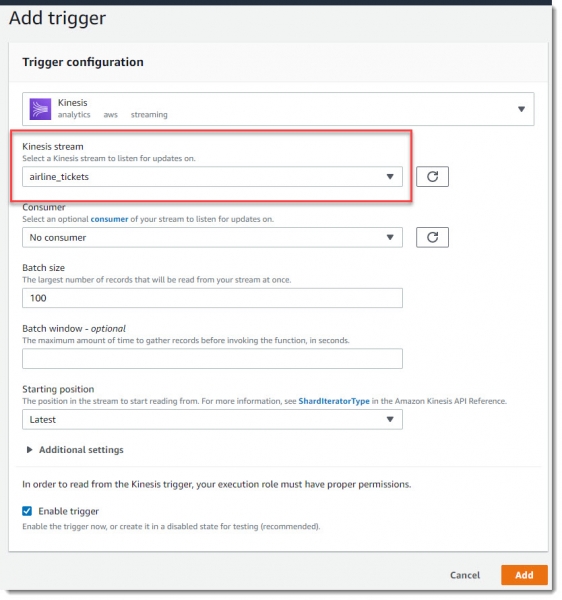
Teraz stačí vložiť kód a uložiť lambdu.
"""Skriptuje tok a vkladá do tabuľky DynamoDB."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Skriptuje informácie z toku."""

    def __init__(self, table_name, records):
        """Init metóda."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Vracia deserializované údaje z toku."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Predspracováva json údaje."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Hromadný zápis do tabuľky."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Bolo pridaných', len(self.json_data), 'položiek')

def lambda_handler(event, context):
    """Skriptuje tok a vkladá do tabuľky DynamoDB."""
    print('Dostal udalosť:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Vytvorenie lambda funkcie notifier
Druhá lambda funkcia, ktorá bude monitorovať druhý tok (special_stream) a posielať oznámenie do SNS, sa vytvára podobne. Táto lambda by mala mať prístup na čítanie z Kinesis a posielanie správ do zadaného SNS kanála, ktorý potom služba SNS pošle všetkým odberateľom tohto kanála (email, SMS atď.).
Vytvorenie IAM role
Najprv vytvoríme IAM rolu Lambda-KinesisAlarm pre túto lambdu a potom priradíme túto rolu k vytvorenej lambde alarm_notifier:
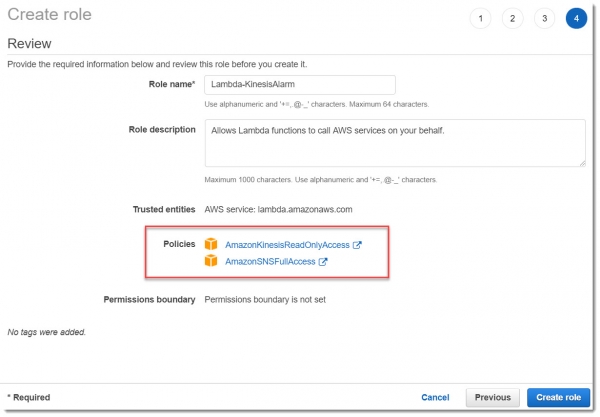
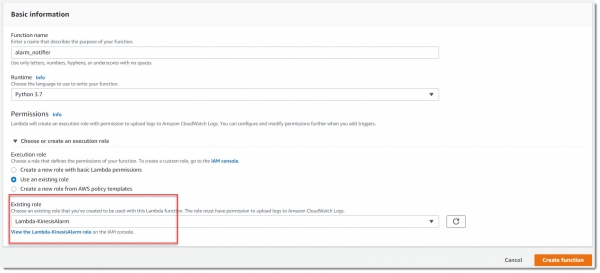
Táto lambda by mala fungovať na spúšťači pri príchode nových záznamov do toku special_stream, preto je potrebné nastaviť spúšťač podobne ako sme to robili pre lambdu Collector.
Pre usnadnenie nastavenia tejto lambdy zavedieme novú premennú prostredia — TOPIC_ARN, do ktorej uložíme ANR (Amazon Resource Names) kanála Airlines:
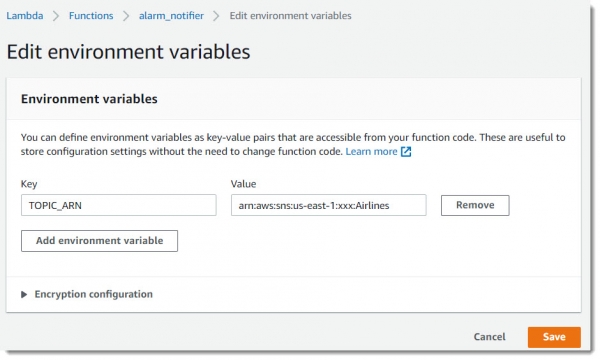
A vložíme kód lambdy, ktorý nie je vôbec zložitý:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Ahoj! Našiel som zaujímavé veci!',
                           Subject='Alarm leteniek')
        print('Správa o alarme bola úspešne doručená')
    except Exception as err:
        print('Zlyhanie doručenia', str(err))
Zjavne týmto končí ručné nastavenie systému. Zostáva len otestovať a uistiť sa, že sme všetko nastavili správne.
Nasadenie z kódu Terraform
Potrebná príprava
— veľmi užitočný open-source nástroj na nasadzovanie infraštruktúry z kódu. Má svoj vlastný syntaktický jazyk, ktorý sa ľahko osvojuje a množstvo príkladov, ako a čo nasadiť. V editore Atom alebo Visual Studio Code je mnoho užitočných pluginov, ktoré uľahčujú prácu s Terraform.
Distribúciu si môžete stiahnuť . Podrobný prehľad všetkých možností Terraform presahuje rámec tohto článku, preto sa obmedzíme na základné momenty.
Ako spustiť
Celý kód projektu je uložený . Klonujeme si repozitár. Pred spustením je potrebné zabezpečiť, že máte nainštalovaný a nastavený AWS CLI, pretože Terraform bude hľadať poverenia v súbore ~\/ .aws\/ credentials.
Dobrou praxou je pred nasadením celej infraštruktúry spustiť príkaz plan, aby sme videli, čo nám Terraform teraz nasadí v cloude:
terraform.exe planBude navrhnuté zadať telefónne číslo na posielanie oznámení. V tomto kroku jeho zadanie nie je nevyhnutné.
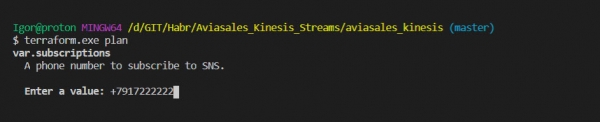
Analyzujúc plán práce programu môžeme spustiť vytváranie zdrojov:
terraform.exe applyPo odoslaní tohto príkazu sa opäť objaví výzva na zadanie telefónneho čísla, zadajte "yes", keď sa objaví otázka o skutočnom vykonaní akcií. To umožní zdvihnúť celú infraštruktúru, vykonať všetky potrebné nastavenia EC2, nasadiť lambda funkcie atď.
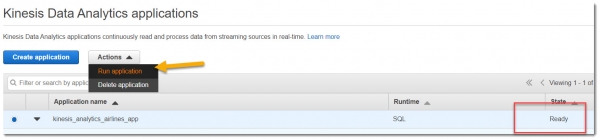
Po úspešnom vytvorení všetkých zdrojov pomocou kódu Terraform je potrebné sa prihlásiť do detailov aplikácie Kinesis Analytics (žiaľ, nenašiel som spôsob, ako to urobiť priamo z kódu).
Spúšťame aplikáciu:
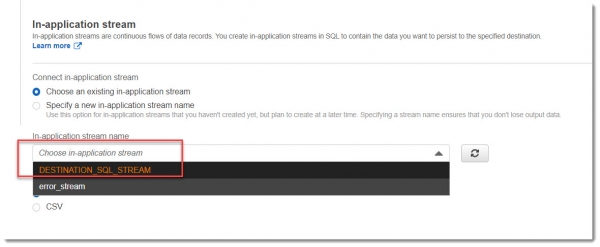
Potom je potrebné explicitne zadať in-application stream name, výberom z rozbaľovacieho zoznamu:
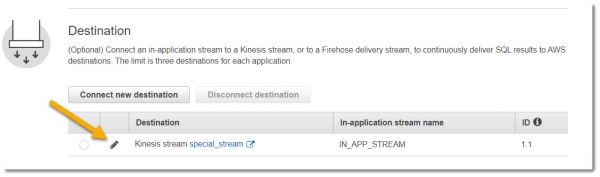
Teraz je všetko pripravené na prácu.
Testovanie fungovania aplikácie
Nezávisle na tom, ako ste systém nasadili, ručne alebo pomocou kódu Terraform, bude fungovať rovnako.
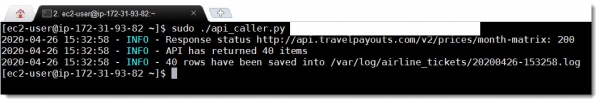
Prihlásime sa pomocou SSH na virtuálny stroj EC2, kde je nainštalovaný Kinesis Agent, a spustíme skript api_caller.py
sudo ./api_caller.py TOKENTeraz stačí počkať na SMS na vašom čísle:
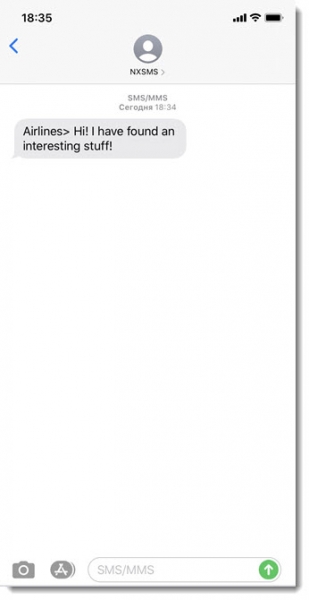
SMS – správa prichádza na telefón takmer za 1 minútu:
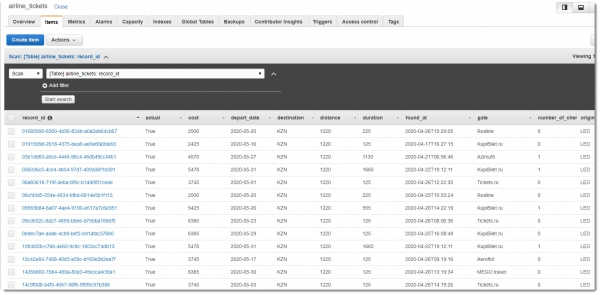
Zostáva skontrolovať, či sa záznamy uložené v databáze DynamoDB zachovali pre neskoršiu, podrobnejšiu analýzu. Tabuľka airline_tickets obsahuje približne takéto údaje:
Záver
V priebehu vykonanej práce bola postavená systém online spracovania údajov založený na Amazon Kinesis. Boli preskúmané možnosti využitia Kinesis Agent v spojení s Kinesis Data Streams a reálnou analytikou Kinesis Analytics pomocou SQL príkazov, ako aj interakcia Amazon Kinesis s ďalšími službami AWS.
Predstavovaný systém sme nasadili dvoma spôsobmi: dostatočne dlhým manuálnym a rýchlym cez kód Terraform.
Celý zdrojový kód projektu je dostupný , ponúkam vám s ním oboznámiť.
Rád by som prediskutoval článok, teším sa na vaše komentáre. Dúfam v konštruktívnu kritiku.
Prajem vám veľa úspechov!
Zdroj: habr.com
