

Volám sa Denis Rožkov, som vedúci vývoja softvéru v spoločnosti „Gazinformservis“, v produktovom tíme . Zákonodarstvo a firemné normy ukladajú určité požiadavky na bezpečnosť ukladania údajov. Nikto nechce, aby k dôverným informáciám mali prístup tretie strany, a preto sú pre akýkoľvek projekt dôležité nasledujúce otázky: identifikácia a autentifikácia, správa prístupov k údajom, zabezpečenie integrity informácií v systéme, registrácia bezpečnostných udalostí. Chcel by som preto hovoriť o niektorých zaujímavých aspektoch týkajúcich sa bezpečnosti DBMS.
Článok bol pripravený na základe vystúpenia na organizovanom . Ak nechcete čítať, môžete sa pozrieť na:
V článku budú tri časti:
- Ako chrániť pripojenia.
- Čo je audit činnosti a ako zaznamenávať, čo sa deje zo strany databázy a pripojenia k nej.
- Ako chrániť údaje v samotnej databáze a aké technológie sú na to k dispozícii.
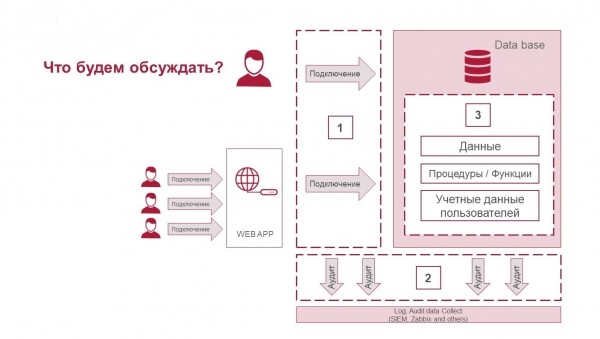
Tri zložky bezpečnosti DBMS: ochrana pripojení, audit činností a ochrana údajov
Ochrana pripojení
K databáze sa môžete pripojiť priamo alebo nepriamo prostredníctvom webových aplikácií. Zvyčajne používateľ z biznisu, teda osoba, ktorá pracuje s DBMS, neinteraguje s ňou priamo.
Predtým, ako budeme hovoriť o ochrane pripojení, musíme odpovedať na dôležité otázky, od ktorých závisí, ako budú bezpečnostné opatrenia nastavené:
- je rovný jeden biznis používateľ jednému používateľovi DBMS;
- je zabezpečený prístup k údajom DBMS len cez API, ktoré kontrolujete, alebo existuje prístup k tabuľkám priamo;
- je DBMS vyčlenená do samostatného chráneného segmentu, kto a ako s ním interaguje;
- používa sa pooling/proxy a medzivrstvy, ktoré môžu meniť informácie o tom, ako je pripojenie nastavené a kto používa databázu.
Teraz sa pozrime, aké nástroje možno použiť na ochranu pripojení:
- Použite riešenia triedy database firewall. Ďalšia vrstva ochrany, minimálne, zvýši priehľadnosť toho, čo sa deje v DBMS, maximálne — budete môcť zabezpečiť dodatočnú ochranu údajov.
- Používajte politiky hesiel. Ich uplatnenie závisí od toho, ako je vaša architektúra postavená. V každom prípade — jedno heslo v konfiguračnom súbore webovej aplikácie, ktorá sa pripája k DBMS, nestačí na ochranu. Existuje niekoľko nástrojov DBMS, ktoré umožňujú kontrolovať, ako a kedy sa má aktualizovať používateľské meno a heslo.
Prečítajte si viac o funkciách hodnotenia používateľov. , rovnako ako o MS SQL Vulnerability Assessment sa dá dozvedieť. .
- Obohacujte kontext relácie potrebnými informáciami. Ak je relácia nepriehľadná, nemusíte chápať, kto v jej rámci pracuje s DBMS, a môžete doplniť informácie o tom, kto, čo a prečo robí. Tieto informácie môžete vidieť v audite.
- Nastavte SSL, ak nemáte sieťové rozdelenie DBMS od koncových používateľov, ktoré nie je v samostatnom VLAN. V takýchto prípadoch je nevyhnutné chrániť kanál medzi spotrebiteľom a samotným DBMS. Ochranné nástroje sú dostupné aj medzi open source.
Aký vplyv to bude mať na výkon DBMS?
Pozrieme sa na príklad PostgreSQL, ako SSL ovplyvňuje záťaž CPU, zvyšovanie časov a zníženie TPS, nezabudne sa, aké veľa zdrojov sa vynaloží pri jeho zapnutí.
Zatěžujeme PostgreSQL pomocou pgbench — ide o jednoduchý program na spúšťanie testov výkonnosti. Opakovane vykonáva jednu sekvenciu príkazov, možno v paralelných databázových reláciách, a potom vypočíta priemernú rýchlosť transakcií.
Test 1 bez SSL a s použitím SSL — pripojenie sa vytvára pri každej transakcii:
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Test 2 bez SSL a s použitím SSL — všetky transakcie sa vykonávajú v jednom pripojení:
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Ostatné nastavenia:
faktor škálovania: 1
mód dotazu: jednoduchý
počet klientov: 10
počet threadov: 1
počet transakcií na klienta: 5000
počet transakcií skutočne spracovaných: 50000/50000
Výsledky testovania:
ŽIADNE SSL
SSL
Pripojenie sa vytvára pri každej transakcii.
priemerná latencia
171.915 ms
187.695 ms
tps vrátane vytvárania pripojení
58.168112
53.278062
tps bez vytvárania pripojení
64.084546
58.725846
CPU
24%
28%
Všetky transakcie sa vykonávajú v jednom pripojení
priemerná latencia
6.722 ms
6.342 ms
tps vrátane vytvárania pripojení
1587.657278
1576.792883
tps bez vytvárania pripojení
1588.380574
1577.694766
CPU
17%
21%
Pri nízkych zaťaženiach je vplyv SSL porovnateľný s chybou merania. Ak je objem prenášaných údajov veľmi veľký, situácia môže byť iná. Ak vytvárame jedno spojenie na každú transakciu (čo sa stáva zriedka, zvyčajne sa spoje delia medzi používateľmi), počet pripojení/odpojení je vysoký, vplyv môže byť o niečo väčší. Tým pádom môžu existovať riziká zníženia výkonu, avšak rozdiel nie je natoľko veľký, aby sa ochrana nemohla použiť.
Všimnite si — existuje výrazný rozdiel, ak porovnávate režimy práce: v rámci jednej relácie pracujete alebo v rôznych. To je jasné: na vytvorenie každého spojenia sú potrebné zdroje.
Mali sme prípad, keď sme pripojili Zabbix v režime dôvery, to znamená, že sme nekontrolovali md5 a autentifikácia nebola potrebná. Následne zákazník požiadal o zapnutie režimu md5 autentifikácie. To vyvolalo veľké zaťaženie CPU, výkon klesol. Začali sme hľadať cesty na optimalizáciu. Jedným z možných riešení problému je implementovať sieťové obmedzenie, vytvoriť pre DBMS samostatné VLAN, pridať nastavenia, aby bolo jasné, kto a odkiaľ sa pripája a odstrániť autentifikáciu. Taktiež je možné optimalizovať nastavenia autentifikácie, aby sa znížili náklady pri zapínaní autentifikácie, ale vo všeobecnosti má použitie rôznych metód autentifikácie vplyv na výkon a je potrebné zohľadniť tieto faktory pri navrhovaní výpočtových výkonov serverov (hardvéru) pre DBMS.
Záver: v niektorých riešeniach môžu aj malé nuansy v autentifikácii významne ovplyvniť projekt a je zlé, keď sa to ukáže až pri nasadení do produkcie.
Audit činností
Audit nemusí byť len DBMS. Audit je získavanie informácií o tom, čo sa deje na rôznych segmentoch. Môže to byť aj database firewall, aj operačný systém, na ktorom je postavený DBMS.
V komerčných DBMS úrovne Enterprise je audit v poriadku, v open source — nie vždy. Tu sú možnosti v PostgreSQL:
- default log — vstavané logovanie;
- extensions: pgaudit — ak vám chýba predvolené logovanie, môžete využiť samostatné nastavenia, ktoré riešia časť úloh.
Doplnok k prezentácii vo videu:
Základná registrácia operátorov môže byť zabezpečená štandardným nástrojom na vedenie denníka s log_statement = all.
Je to prijateľné pre monitorovanie a iné typy využitia, ale nezabezpečuje úroveň detailov, ktorá je zvyčajne potrebná na audit.
Nemožno mať len zoznam všetkých operácií vykonaných s databázou.
Musí existovať aj možnosť nájsť konkrétne tvrdenia, ktoré sú pre audítora zaujímavé.
Štandardný nástroj na vedenie denníka ukazuje, čo používateľ požiadal, zatiaľ čo pgAudit sa zameriava na detaily toho, čo sa stalo, keď databáza vykonala dopyt.
Napríklad audítor môže chcieť zabezpečiť, že konkrétna tabuľka bola vytvorená v zdokumentovanom okne údržby.
Môže sa to zdať ako jednoduchá úloha pre základný audit a grep, ale čo ak narazíte na niečo podobné (úmyselne zamotané) príklad:
DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Štandardné vedenie denníka vám dá toto:
LOG: statement: DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Vyzerá to, že pre hľadanie zaujímavej tabuľky môže byť potrebné určité poznanie kódu v prípadoch, keď sa tabuľky vytvárajú dynamicky.
Nie je to ideálne, pretože by bolo lepšie jednoducho hľadať podľa názvu tabuľky.
Tu prichádza na pomoc pgAudit.
Pre ten istý vstup by poskytol tento výstup do denníka:
AUDIT: SESSION,33,1,FUNCTION,DO,,,'DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;'
AUDIT: SESSION,33,2,DDL,CREATE TABLE,TABLE,public.important_table,CREATE TABLE important_table (id INT)
Zaznamenáva sa nielen blok DO, ale aj celý text CREATE TABLE s typom operátora, typom objektu a celým menom, čo uľahčuje hľadanie.
Pri vedení denníka operátorov SELECT a DML môže byť pgAudit nakonfigurovaný tak, aby zaznamenával osobitný záznam pre každý vzťah, na ktorý sa odkazuje v operátore.
Nie je potrebná syntaktická analýza na nájdenie všetkých operátorov, ktoré sa týkajú konkrétnej tabuľky ()».
Aký vplyv to bude mať na výkon DBMS?
Poďme vykonať testy so zapnutým úplným auditom a pozrime sa, čo sa stane s výkonom PostgreSQL. Zapneme maximálne logovanie DB pre všetky parametre.
V konfiguračnom súbore takmer nič nemeníme, z dôležitých vecí zapneme režim debug5, aby sme získali maximum informácií.
postgresql.conf
log_destination = ‘stderr’
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = zapnuté
log_checkpoints = zapnuté
log_connections = zapnuté
log_disconnections = zapnuté
log_duration = zapnuté
log_hostname = zapnuté
log_lock_waits = zapnuté
log_replication_commands = zapnuté
log_temp_files = 0
log_timezone = 'Európa/Moskva'
Na databázovom systéme PostgreSQL s parametrami 1 CPU, 2,8 GHz, 2 GB RAM, 40 GB HDD vykonávame tri záťažové testy pomocou príkazov:
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
Výsledky testovania:
Bez logovania
S logovaním
Konečný čas načítania DB
43,74 s
53,23 s
RAM
24%
40%
CPU
72%
91%
Test 1 (50 pripojení)
Počet transakcií za 10 minút
74169
32445
Transakcií/s
123
54
Priemerné oneskorenie
405 ms
925 ms
Test 2 (150 pripojení pri 100 možných)
Počet transakcií za 10 minút
81727
31429
Transakcií/s
136
52
Priemerné oneskorenie
550 ms
1432 ms
O veľkostiach
Veľkosť DB
2251 MB
2262 MB
Veľkosť logov DB
0 MB
4587 MB
Celkovo: kompletný audit je dosť zlý. Údaje z auditu budú mať objem ako údaje v samotnej databáze, ak nie väčší. Taký objem logovania, ktorý sa generuje pri práci s databázovým systémom, je bežným problémom v produkcii.
Pozrime sa na ďalšie parametre:
- Rýchlosť sa výrazne nemení: bez logovania — 43,74 s, s logovaním — 53,23 s.
- Výkon RAM a CPU bude klesať, pretože je potrebné vytvoriť súbor s auditom. To je tiež znateľné v produkcii.
Pri zvyšovaní počtu pripojení sa, samozrejme, miera výkonu mierne zhorší.
Vo firmách s auditom je to ešte komplikovanejšie:
- údajov je veľa;
- audit je potrebný nielen cez syslog v SIEM, ale aj do súborov: čo keď sa s syslog niečo stane, mal by byť súbor blízko databázy, v ktorom sa uchovávajú údaje;
- na audit je potrebná samostatná polica, aby nedošlo k preťaženiu I/O diskov, pretože zaberá veľa miesta;
- stáva sa, že pracovníci odboru informačnej bezpečnosti potrebujú všade normy, vyžadujú identifikáciu podľa štandardov.
Obmedzenie prístupu k údajom
Pozrime sa na technológie, ktoré sa používajú na ochranu údajov a prístup k nim v komerčných databázových systémoch a open source.
Čo sa celkovo dá použiť:
- Šifrovanie a obfuskovanie procedúr a funkcií (Wrapping) — to sú nástroje a utilitky, ktoré robia čitateľný kód nečitateľným. Pravda je, že ho už nie je možné zmeniť ani refaktorovať späť. Takýto prístup je niekedy potrebný aspoň na strane databázového systému — logika licenčných obmedzení alebo logika autorizácie je šifrovaná práve na úrovni procedúry a funkcií.
- Obmedzenie viditeľnosti údajov po riadkoch (RLS) je situácia, keď rôzni používatelia vidia jednu tabuľku, ale rôzne zostavy riadkov v nej, t.j. niektorým používateľom niečo nemožno zobraziť na úrovni riadkov.
- Úprava zobrazených údajov (Masking) je situácia, keď používatelia v jednom stĺpci tabuľky vidia buď údaje, alebo iba hviezdičky, t.j. pre niektorých používateľov bude informácia uzavretá. Technológia určuje, akému používateľovi čo zobraziť s ohľadom na úroveň prístupu.
- Rozdelenie prístupu Security DBA/Application DBA/DBA je skôr o obmedzení prístupu k samotnej DBMS, t.j. zamestnancov IT možno oddeliť od administrátorov databázy a administrátorov aplikácií. V open source takých technológií je málo, v komerčných DBMS ich je dostatok. Sú potrebné, keď je veľa používateľov s prístupom k samotným serverom.
- Obmedzenie prístupu k súborom na úrovni súborového systému. Môžete priradiť práva, privilegované prístupy k adresárom, aby každý administrátor mal prístup iba k potrebným údajom.
- Mandátový prístup a vymazávanie pamäte sa tieto technológie používajú zriedka.
- End-to-end encryption priamo DBMS je šifrovanie na strane klienta s riadením kľúčov na serverovej strane.
- Šifrovanie údajov. Napríklad stĺpcové šifrovanie je situácia, keď používate mechanizmus, ktorý šifruje jednotlivý stĺpec databázy.
Ako to ovplyvňuje výkon DBMS?
Pozrime sa na príklad stĺpcového šifrovania v PostgreSQL. Existuje modul pgcrypto, ktorý umožňuje uchovávať vybrané polia v zašifrovanej podobe. Je to užitočné, keď je hodnotná iba určitá časť údajov. Aby ste prečítali zašifrované polia, klient odovzdá dešifrovací kľúč, server dešifruje údaje a vydá ich klientovi. Bez kľúča s vašimi údajmi nikto nič neurobí.
Vykonajme test s pgcrypto. Vytvoríme tabuľku so zašifrovanými údajmi a bežnými údajmi. Nižšie sú príkazy na vytvorenie tabuliek, v prvej riadku je užitočný príkaz — vytvorenie samotnej rozšírenia s registráciou DBMS:
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
Ďalej sa pokúsime získať dáta z každej tabuľky a pozrieme sa na časy vykonávania.
Výber dát z tabuľky bez funkcie šifrovania:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
Stopky sú spustené.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 riadkov)
Čas: 1,386 ms
Výber dát z tabuľky s funkciou šifrovania:
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
Stopky sú spustené.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 riadkov)
Čas: 50,203 ms
Výsledky testovania:
Bez šifrovania
Pgcrypto (decrypt)
Výber 1000 riadkov
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
Šifrovanie má výrazný vplyv na výkon. Je jasné, že čas vykonávania vzrástol, pretože operácie dešifrovania zašifrovaných dát (a dešifrovanie je zvyčajne ešte obalené vo vašej logike) vyžadujú značné zdroje. Teda myšlienka zašifrovať všetky stĺpce, ktoré obsahujú dáta, je viazaná na zníženie výkonu.
Šifrovanie nie je strieborná guľka, ktorá rieši všetky problémy. Dešifrované dáta a kľúč dešifrovania sú počas dešifrovania a prenášania dát na serveri. Preto môžu byť kľúče zachytené tým, kto má plný prístup k serveru databáz, napríklad systémovým administrátorom.
Keď existuje jeden kľúč pre celú tabuľku pre všetkých používateľov (aj keď nie pre všetkých, ale pre obmedzenú skupinu klientov), nie je to vždy dobré a správne. Preto sa začalo robiť end-to-end šifrovanie, v SÚBD sa začali zvažovať možnosti šifrovania dát zo strany klienta a servera, objavili sa tzv. kľúčové trezory — samostatné produkty, ktoré zabezpečujú správu kľúčov na strane SÚBD.

Bezpečnostné nástroje v komerčných a open source SÚBD
Funkcie
Typ
Politika hesiel
Audit
Ochrana zdrojového kódu procedúr a funkcií
RLS
Šifrovanie
Oracle
Komerčné
+
+
+
+
+
MsSql
Komerčné
+
+
+
+
+
Komerčné
+
+
+
+
rozšírenia
PostgreSQL
Bezplatné
rozšírenia
rozšírenia
—
+
rozšírenia
MongoDb
Bezplatné
—
+
—
—
Dostupné iba v MongoDB Enterprise
Tabuľka nie je úplná, ale situácia je taká: v komerčných produktoch sa úlohy bezpečnosti riešia už dávno, v open source sa zvyčajne na zabezpečenie používajú nejaké nadstavby, mnohé funkcie chýbajú, niekedy je potrebné niečo dopísať. Napríklad politiky hesiel — v PostgreSQL je veľa rôznych rozšírení (, , , , ), ktoré implementujú politiky hesiel, ale všetky potreby domáceho podnikateľského segmentu zatiaľ nijaké nepokryli.
Čo robiť, ak nikde nie je to, čo potrebujete? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
Potom môžete použiť externé riešenia, ktoré pracujú s rôznymi DBMS, ako napríklad „Krypto DB“ alebo „Garda DB“. Ak ide o riešenia z domáceho segmentu, tam o normách GOST vedia lepšie ako v open source.
Druhou možnosťou je napísať si, čo potrebujete, a implementovať prístup k dátam a šifrovanie na úrovni procedúr v aplikácii. Pravda, s normou GOST bude ťažšie. Ale vo všeobecnosti — môžete skryť dáta podle svojich požiadaviek, uložiť ich do DBMS, potom ich vybrať a dešifrovať podľa potreby priamo na úrovni aplikácie. Pri tom okamžite zvažujte, ako budete chrániť tieto algoritmy na úrovni aplikácie. Podľa nášho názoru je potrebné to robiť na úrovni DBMS, pretože to bude pracovať rýchlejšie.
Tento príspevok bol prvýkrát prednesený na od Mail.ru Cloud Solutions. Pozrite sainé vystúpenia a prihláste sa na oznámenia udalostí v Telegrame .
Čo ďalšie si prečítať na túto tému:
- .
- .
Zdroj: habr.com
