

Preklad článku bol pripravený špeciálne pre študentov kurzu .
— softvérový vývojár, fanúšik Go a nadšenec riešenia komplexných problémov. Taktiež je udržiavateľom Prometheus a spoluzakladateľom Kubernetes SIG instrumentation. V minulosti bol production inžinierom v SoundCloud a viedol monitorovaciu skupinu v CoreOS. V súčasnosti pracuje v Google.
— infraštruktúrny inžinier v Improbable. Zaujíma sa o nové technológie a problémy distribuovaných systémov. Má skúsenosti s nízkoúrovňovým programovaním v Intel, ako prispievateľ v Mesos a globálne production skúsenosti SRE v Improbable. Pracuje na zlepšení sveta mikroslužieb. Jeho tri lásky: Golang, open source a volejbal.
Pri pohľade na náš vlajkový produkt SpatialOS si môžete domyslieť, že pre Improbable je potrebná vysoko dynamická cloudová infraštruktúra globálneho rozsahu s desiatkami klastrov Kubernetes. Boli sme jedni z prvých, ktorí začali používať monitorovací systém . Prometheus dokáže sledovať milióny metrík v reálnom čase a je dodávaný s výkonným dotazovacím jazykom, ktorý umožňuje extrahovať potrebné informácie.
Jednoduchosť a spoľahlivosť Prometheus je jednou z jeho hlavných výhod. Avšak, pri určitom rozsahu sme sa stretli s niekoľkými nevýhodami. Na riešenie týchto problémov sme vyvinuli — projekt s otvoreným zdrojovým kódom, vytvorený spoločnosťou Improbable, na bezproblémovú transformáciu existujúcich klastrov Prometheus do jedného monitorovacieho systému s neobmedzeným úložiskom historických dát. Thanos je dostupný na Github .
Naše ciele s Thanos
Pri určitom rozsahu vznikajú problémy, ktoré prekračujú možnosti vanilkového Prometheus. Ako bezpečne a hospodárne uchovávať petabajty historických dát? Dá sa to dosiahnuť bez poškodenia času odpovede na dotaz? Je možné získať prístup ku všetkým metrikám umiestneným na rôznych serveroch Prometheus pomocou jedného API dotazu? Je možné zlúčiť replikované dáta, zhromaždené pomocou Prometheus HA?
Na vyriešenie týchto otázok sme vytvorili Thanos. V nasledujúcich častiach sa popisuje, ako sme pristúpili k vyriešeniu týchto otázok a objasňujú sa ciele, ktoré sme sledovali.
Dotazovanie dát z viacerých inštancií Prometheus (global query)
Prometheus ponúka funkčný prístup k shardingu. Dokonca aj jeden server Prometheus zabezpečuje dostatočnú škálovateľnosť, aby oslobodil používateľov od zložitostí horizontálneho shardingu takmer vo všetkých prípadoch použitia.
Hoci je to skvelý model nasadenia, často je potrebné získať prístup k dátam na rôznych serveroch Prometheus cez jednotné API alebo UI — global view. Samozrejme, existuje možnosť zobraziť viacero dopytov na jednom paneli Grafana, ale každý dopyt môže byť vykonaný iba na jednom serveri Prometheus. Na druhej strane, pomocou Thanos môžete dotazovať a agregovať dáta z niekoľkých serverov Prometheus, keďže všetky sú dostupné z jedného koncového bodu.
Predtým, aby sme získali global view v Improbable, sme organizovali naše inštancie Prometheus do viacúrovňovej . To znamenalo vytvorenie jedného meta-servera Prometheus, ktorý zhromažďuje časť metrík z každého 'listového' servera.
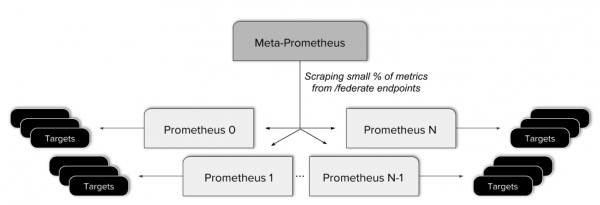
Tento prístup sa ukázal byť problematický. Viedol k zložitosti konfigurácie, pridaniu ďalšieho potenciálneho bodu zlyhania a uplatneniu zložitých pravidiel na poskytnutie federovanej koncovej bodu iba pre potrebné dáta. Okrem toho, takáto federácia neumožňuje získať skutočný global view, pretože nie všetky dáta sú dostupné z jedného API dopytu.
S tým úzko súvisí jednotné zobrazenie dát, zhromaždených na vysoko dostupných (high-availability, HA) serveroch Prometheus. HA model Prometheus nezávisle zhromažďuje dáta dvakrát, čo je tak jednoduché, že to nemôže byť jednoduchšie. Avšak, použiť kombinované a deduplikované zobrazenie oboch tokov by bolo oveľa pohodlnejšie.
Samozrejme, vo vysoko dostupných serveroch Prometheus existuje potreba. V Improbable sa skutočne vážne zaoberáme minútovým monitorovaním dát, ale mať jeden exemplár Prometheus v klátri je jediný bod zlyhania. Akákoľvek chyba v konfigurácii alebo porucha hardvéru môže potenciálne viesť k strate dôležitých dát. Dokonca aj jednoduché nasadenie môže spôsobiť drobné poruchy v zhromažďovaní metrík, pretože reštart môže byť výrazne dlhší ako interval scrapingu.
Spoľahlivé uchovávanie historických dát
Cenovo, rýchlo a dlhodobé ukladanie metrík – to je náš sen (zdieľaný väčšinou používateľov Prometheus). V spoločnosti Improbable sme museli nastaviť dobu uchovávania metrík na deväť dní (pre Prometheus 1.8). To pridáva zjavné obmedzenia na to, ako ďaleko môžeme pozrieť späť.
Prometheus 2.0 sa v tomto ohľade zlepšil, pretože počet časových sérií už nemá vplyv na celkový výkon servera (pozri ). Napriek tomu Prometheus uchováva údaje na lokálnom disku. Hoci vysoko účinné kompresie dát môžu významne znížiť používanie lokálneho SSD, nakoniec tu stále existuje obmedzenie na objem uchovávaných historických dát.
Okrem toho sa v Improbable staráme o spoľahlivosť, jednoduchosť a náklady. Veľké lokálne disky sú zložitejšie na prevádzku a zálohovanie. Stoja viac a vyžadujú viac nástrojov na zálohovanie, čo vedie k zbytočnej zložitosti.
Downsampling
Akonáhle sme začali pracovať s historickými dátami, pochopili sme, že existujú základné komplikácie s O-velkým, ktoré spôsobujú, že dotazy sú stále pomalšie, ak pracujeme s dátami za týždne, mesiace a roky.
Štandardným riešením tejto problémy bude (downsampling) – zníženie frekvencie vzorkovania signálu. Pomocou znižovania vzorkovania môžeme "zmenšiť mierku" na väčšie časové obdobie a udržiavať predchádzajúci počet vzoriek, čo umožní zachovať reakčnosť dotazov.
Downsampling starých dát je nevyhnutným požiadavkom akéhokoľvek riešenia pre dlhodobé uchovávanie a presahuje rámec vanilkového Prometheus.
Ďalšie ciele
Jedným z počiatočných cieľov projektu Thanos bola bezproblémová integrácia so všetkými existujúcimi inštaláciami Prometheus. Druhý cieľ spočíval v jednoduchosti prevádzky s minimálnou bariérou pre vstup. Akékoľvek závislosti by mali byť ľahko splniteľné pre malé aj veľké užívateľov, čo tiež znamená malú základnú cenu.
Architektúra Thanos
Po tom, čo boli v predchádzajúcej časti uvedené naše ciele, poďme sa na ne sústrediť a pozrieť sa, ako Thanos tieto problémy rieši.
Globálny pohľad
Aby sme získali globálny pohľad na existujúce inštancie Prometheus, potrebujeme spojiť jednotný bod vstupu požiadaviek so všetkými servermi. To je úloha komponentu Thanos. . Rozmiestňuje sa vedľa každého servera Prometheus a funguje ako proxy, poskytujúca miestne údaje Prometheus prostredníctvom gRPC rozhrania Store API, čo umožňuje vyhľadávať časové rady podľa značiek a časového rozsahu.
Na druhej strane je horizontálne škálovateľný komponent Querier bez uchovávania stavu, ktorý robí o niečo viac, než len odpovedá na požiadavky PromQL cez štandardné HTTP API Prometheus. Komponenty Querier, Sidecar a ďalšie Thanos interagujú prostredníctvom .
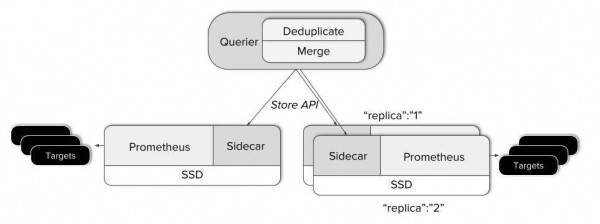
- Querier, keď dostane požiadavku, sa pripojí k príslušnému serveru Store API, teda k našim Sidecarom, a získa časové rady z príslušných serverov Prometheus.
- Následne zlúči odpovede a vykoná na nich PromQL dopyt. Querier dokáže zlúčiť ako neprekrývajúce sa údaje, tak aj duplicitné údaje z HA serverov Prometheus.
Týmto sa rieši väčšina našej hádanky – zlúčenie údajov z izolovaných serverov Prometheus do jednotného zobrazenia. V skutočnosti sa Thanos môže používať len kvôli tejto funkčnosti. Nie je potrebné meniť existujúce servery Prometheus!
Neobmedzené obdobie uchovávania!
Avšak skôr či neskôr budeme chcieť uchovať údaje, ktoré presahujú bežné obdobie uchovávania Prometheus. Na uchovávanie historických údajov sme si zvolili objektové úložisko. To je široko dostupné v akomkoľvek cloude, ako aj v miestnych dátových centrách a je veľmi ekonomické. Navyše takmer akékoľvek objektové úložisko je dostupné cez dobre známe S3 API.
Prometheus zapisuje údaje z operačnej pamäte na disk približne každé dve hodiny. Blok uchovávaných údajov obsahuje všetky dáta za stanovený časový úsek a je nemenný. To je veľmi výhodné, pretože Thanos Sidecar môže jednoducho sledovať adresár údajov Prometheus a ako sa objavujú nové bloky, nahrávať ich do vedier objektového úložiska.
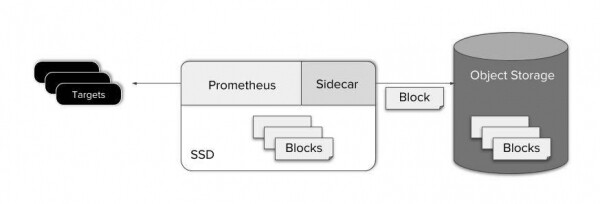
Nahrávanie do objektového úložiska hneď po zápise na disk tiež umožňuje zachovať jednoduchosť „scraperu“ (Prometheus a Thanos Sidecar). To zjednodušuje údržbu, náklady a dizajn systému.
Ako vidíte, zálohovanie údajov je veľmi jednoduché. Ale čo tak požiadavky na údaje v objektovom úložisku?
Komponent Thanos Store pôsobí ako proxy na získavanie údajov z objektového úložiska. Rovnako ako Thanos Sidecar, je súčasťou gossip klasteru a implementuje Store API. Takto môžu existujúce Querier považovať jeho za Sidecar ako ďalší zdroj údajov časovej rady — nevyžaduje žiadnu špeciálnu konfiguráciu.
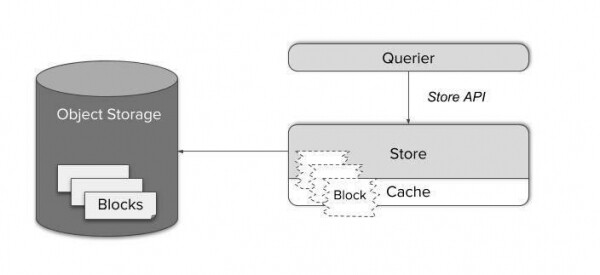
Bloky údajov časovej rady pozostávajú z niekoľkých veľkých súborov. Načítanie ich na požiadanie by bolo pomerne neefektívne a miestne cachovanie by vyžadovalo obrovské množstvo pamäte a diskového priestoru.
Namiesto toho Store Gateway vie, ako pracovať s formátom ukladania Prometheus. Vďaka inteligentnému plánovaču požiadaviek a cachovaniu iba potrebných indexových častí blokov sa podarilo znížiť zložené požiadavky na minimálny počet HTTP požiadaviek na súbory objektového úložiska. Takto je možné znížiť počet požiadaviek o štyri až šesť rádov a dosiahnuť čas odozvy, ktorý je celkovo ťažké odlišit od požiadaviek na údaje na miestnom SSD.
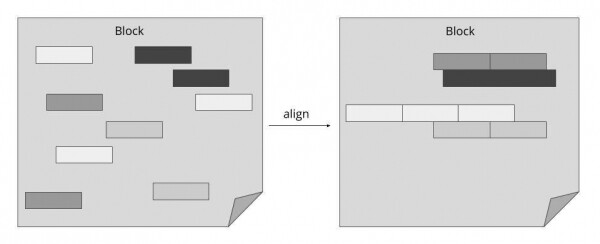
Ako je znázornené na vyššej diagrame, Thanos Querier výrazne znižuje náklady na jednu požiadavku na údaje v objektovom úložisku, pričom používa formát ukladania Prometheus a umiestňuje súvisiace údaje blízko seba. Použitím tohto prístupu môžeme zlúčiť množstvo jednotlivých požiadaviek na minimálny počet hromadných operácií.
Kompakcia a downsamping
Akonáhle je nový blok údajov časovej rady úspešne nahratý do objektového úložiska, považujeme ho za 'historické' údaje, ktoré sú okamžite k dispozícii cez Store Gateway.
Avšak po chvíli sa bloky z jedného zdroja (Prometheus so Sidecar) hromadia a už nevyužívajú celý potenciál indexovania. Na vyriešenie tohto problému sme zaviedli ešte jednu komponentu nazývanú Compactor. Jednoducho aplikuje miestny mechanizmus kompakcie Prometheus na historické údaje v objektovom úložisku a môže byť spustený ako jednoduchá periodická dávková úloha.
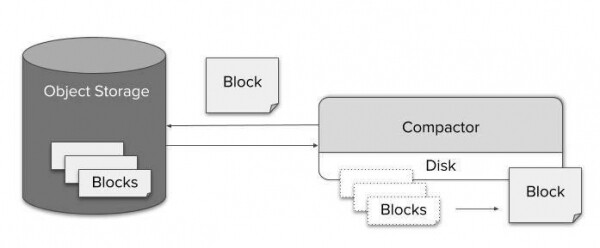
Vďaka efektívnemu stlačeniu nezapôsobí dopyt do úložiska na dlhú dobu problém z hľadiska veľkosti údajov. Avšak potenciálne náklady na rozbalenie miliardy hodnôt a ich spracovanie cez dotazovaciu agenta nevyhnutne povedú k výraznému zvýšeniu času vykonávania dopytu. Na druhej strane, pretože na každý pixel obrazovky pripadá stovky bodov údajov, stáva sa nemožným aj vizualizovať údaje v plnom rozlíšení. Takže downsampling nie je len možný, ale ani nevedie k znateľnej strate presnosti.
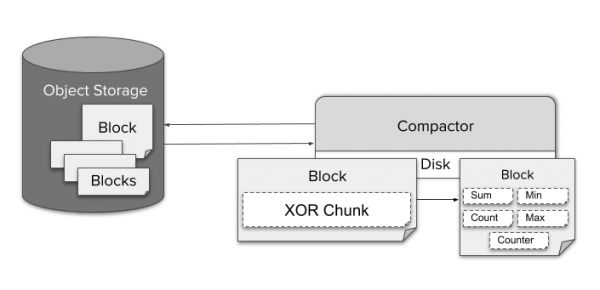
Pre downsampling údajov Compactor neustále agreguje údaje s rozlíšením päť minút a jednu hodinu. Pre každý neopracovaný fragment, zakódovaný pomocou TSDB XOR-kompresie, sú uložené rôzne typy agregovaných údajov, ako min, max alebo sum pre jeden blok. To umožňuje Querier automaticky vybrať agregát, ktorý je vhodný pre daný PromQL dopyt.
Na používanie údajov s nižšou presnosťou používateľ nepotrebuje žiadnu špeciálnu konfiguráciu. Querier sa automaticky prepína medzi rôznymi rozlíšeniami a neopracovanými údajmi pri zväčšovaní a zmenšovaní mierky používateľom. Ak chce, používateľ môže spravovať tento priamo cez parameter “step” v dopyte.
Keďže náklady na ukladanie jedného GB sú malé, Thanos v predvolenom nastavení uchováva pôvodné údaje, údaje s rozlíšením päť minút a jednu hodinu. Nie je potrebné odstrániť pôvodné údaje.
Pravidlá nahrávania
Aj s Thanos sú pravidlá nahrávania významnou súčasťou monitorovacieho stacku. Znižujú zložitosti, oneskorenie a náklady na dopyty. Sú tiež užitočné pre používateľov, aby získali agregované údaje o metrikách. Thanos je založený na vanilkových inštanciách Prometheus, takže je celkom prijateľné uchovávať pravidlá nahrávania a alerting pravidlá na existujúcom serveri Prometheus. Avšak v niektorých prípadoch to môže byť nedostatočné:
- Globálne alert a pravidlo (napríklad upozornenie, keď služba nefunguje na viac ako dvoch z troch klastrov).
- Pravidlo pre údaje mimo lokálne úložisko.
- Tendencia uchovávať všetky pravidlá a alerty na jednom mieste.
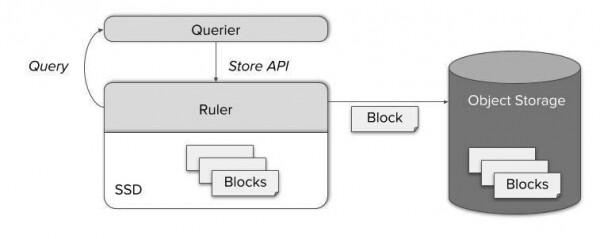
Pre všetky tieto prípady Thanos obsahuje samostatnú zložku nazývanú Ruler, ktorá vypočítava pravidlá a upozornenia prostredníctvom Thanos Queries. Poskytovaním dobre známeho StoreAPI môže uzol Query pristupovať k čerstvo vypočítaným metrikám. Neskôr sú tiež uložené v objektovom úložisku a sú dostupné prostredníctvom Store Gateway.
Sila Thanos
Thanos je dostatočne flexibilný, aby sa dal prispôsobiť vašim požiadavkám. To je obzvlášť užitočné pri migrácii z jednoduchého Prometheus. Rýchlo si pripomeňme, čo sme sa naučili o komponentoch Thanos. Takto prenesiete váš vanilkový Prometheus do sveta „neobmedzeného uloženia metrík“:
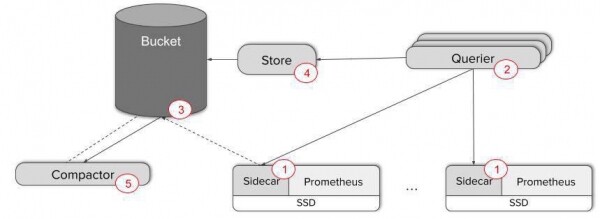
- Pridajte Thanos Sidecar k vašim serverom Prometheus — napríklad susedný kontajner v Kubernetes pude.
- Nasadte niekoľko replik Thanos Querier na prehliadanie dát. V tomto štádiu je jednoduché nastaviť gossip medzi Scraper a Querier. Na overenie interakcie komponentov použite metriku 'thanos_cluster_members'.
Len tieto dva kroky sú dostatočné na zabezpečenie globálneho pohľadu a plynulej deduplikácie dát z potenciálnych HA replik Prometheus! Jednoducho pripojte svoje dashboardy k HTTP endpointu Querier alebo používajte Thanos UI priamo.
Ak však potrebujete zálohovanie metrík a dlhodobé uloženie, budete musieť vykonať ešte tri kroky:
- Vytvorte bucket AWS S3 alebo GCS. Nastavte Sidecar na kopírovanie dát do týchto bucketov. Znížte lokálne uloženie dát na minimum.
- Nasadte Store Gateway a pripojte ho k existujúcemu gossip klastrom. Teraz môžete posielať požiadavky na dáta v zálohách!
- Nasadte Compactor, aby ste zvýšili účinnosť požiadaviek na dlhé časové obdobia, pričom použijete kompresiu a znižovanie vzorky.
Ak sa chcete dozvedieť viac, neváhajte sa pozrieť na naše a !
V piatich jednoduchých krokoch sme premenili Prometheus na spoľahlivý systém monitorovania s globálnym pohľadom, neobmedzeným časom uchovávania a potenciálnou vysokou dostupnosťou metrík.
Pull request: potrebujeme vás!
od začiatku bol projektom s otvoreným kódom. Bezproblémová integrácia s Prometheus a možnosť využívať iba časť Thanos robí z neho vynikajúcu voľbu na škálovanie systému monitorovania bez zbytočného úsilia.
Sme vždy radi za GitHub Pull Requesty a Issues. Zároveň sa neváhajte na nás obrátiť cez Github Issues alebo Slack., ak máte otázky alebo pripomienky, alebo sa chcete podeliť o svoju skúsenosť! Ak sa vám páči to, čo robíme v Improbable, neváhajte nás kontaktovať — !
Zdroj: habr.com
