

V Siti Mobil používame databázu MySQL ako hlavný ukladací priestor pre trvalé dáta. Máme niekoľko databázových klastrov pre rôzne služby a účely.
Trvalá dostupnosť majstra je kritickým ukazovateľom funkčnosti celého systému a jeho jednotlivých častí. Automatické obnovenie klastru v prípade zlyhania majstra značne znižuje čas reakcie na incident a prestoj systému. V tomto článku preskúmam schému zabezpečenia vysokej dostupnosti (HA) klastru MySQL na základe a virtuálnych IP adries (VIP).
HA-riešenie na báze VIP
Najprv sa stručne zmienim o tom, čo predstavuje náš systém ukladania dát.
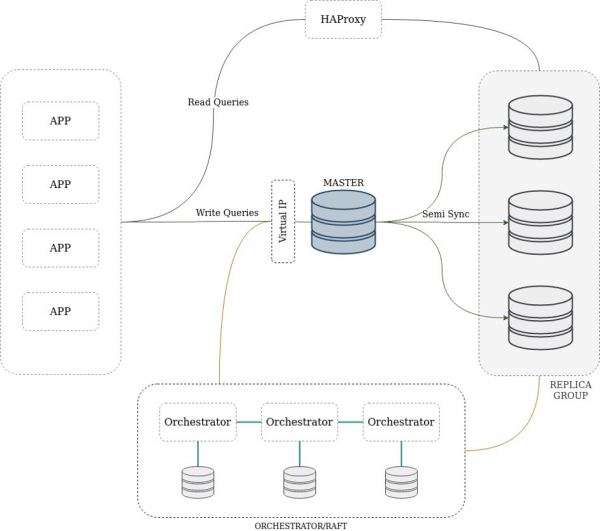
Používame klasickú schému replikácie s jedným majstrom, ktorý je prístupný na zápis, a množstvom replik, ktoré sa používajú iba na čítanie. Klaster môže obsahovať medzičlánkového majstra — uzol, ktorý je súčasne replikou aj majstrom pre iné. Klienti sa obracajú na repliky cez HAProxy, čo umožňuje rovnomerné rozloženie záťaže a ľahké škálovanie. Použitie HAProxy je spôsobené historickými dôvodmi, a teraz sme v procese migrácie na ProxySQL.
Replikácia prebieha v polusynchronnom režime na základe GTID. To znamená, že aspoň jedna replikácia musí zapísať transakciu do protokolu, skôr ako bude považovaná za úspešnú. Takýto režim replikácie zabezpečuje optimálny balanc medzi výkonom a integritou údajov v prípade zlyhania hlavného uzla. V podstate sa všetky zmeny prenášajú od majstra k replikám pomocou Row Based Replication (RBR), no niektoré uzly môžu mať mixed binlog format.
Orkestrátor periodicky aktualizuje stav topológie klastru, analyzuje prijaté informácie a v prípade problémov môže spustiť procedúru automatického obnovenia. Za samotnú procedúru zodpovedá vývojár, pretože ju je možné implementovať rôznymi spôsobmi: na báze VIP, DNS, s použitím služieb objavovania služieb (service discovery) alebo vlastnými mechanizmami.
Jedným z jednoduchých spôsobov, ako obnoviť majstra v prípade jeho zlyhania, je použitie plávajúcich VIP adries.
Čo potrebujete vedieť o tomto riešení, predtým ako budeme pokračovať:
- VIP je IP adresa, ktorá nie je viazaná na konkrétne fyzické sieťové rozhranie. Pri poruche uzla alebo počas plánovaných prác môžeme prepnúť VIP na iný zdroj s minimálnym časom výpadku.
- Osvojenie a vydanie virtuálnej IP adresy sú lacné a rýchle operácie.
- Na prácu s VIP je potrebný prístup na server cez SSH, alebo použitie špeciálnych utilít, ako napríklad
keepalived.
Pozrime sa na možné problémy s naším majstrom a predstavme si, ako by mal fungovať mechanizmus automatickej obnovy.
Stratila sa sieťová konektivita k majstrovi, alebo vznikol problém na úrovni hardvéru a server nie je dostupný.
- Orkestrátor aktualizuje topológiu klastru, každý replikát hlási nedostupnosť majstra. Orkestrátor spúšťa proces voľby replikátu, ktorý sa stane novým majstrom, a začína obnovu.
- Snažíme sa uvoľniť VIP zo starého majstra — neúspešne.
- Replikát prechádza na rolu majstra. Topológia sa prekonštruuje.
- Pridávame nové sieťové rozhranie s VIP. Keďže uvoľnenie VIP sa nepodarilo, v pozadí spúšťame periodické odosielanie požiadaviek gratuitous ARP. Tento typ požiadavky/odpovede umožňuje aktualizovať na pripojených prepínačoch tabuľku zodpovednosti medzi IP a MAC adresami, a tým upozorňuje na presun nášho VIP. Tým sa minimalizuje pravdepodobnosť
split brainpri návrate starého majstra. - Všetky nové pripojenia sú okamžite presmerované na nového majstra. Staré pripojenia zlyhávajú, vykonávajú sa opakované pokusy o pripojenie na úrovni aplikácie k databáze.
Server pracuje v normálnom režime, došlo k zlyhaniu na úrovni DBMS.
Algoritmus je rovnaký ako v predchádzajúcom prípade: aktualizácia topológie a spustenie procesu obnovy. Keďže je server dostupný, úspešne uvoľňujeme VIP na starom majstrovi, prenášame ho na nový a odosielame niekoľko ARP požiadaviek. Možný návrat starého majstra by nemal ovplyvniť prekonštruovaný klaster a prácu aplikácie.
Iné problémy
Zlyhanie replikátov alebo medzi-mastrov nevedie k automatickým akciám a vyžaduje ručný zásah.
Virtuálny sieťový rozhranie sa vždy pridáva dočasne, to znamená, že po reštartovaní servera VIP sa automaticky nepridáva. Každý inštanci dátovej bázy sa štandardne spúšťa v režime iba na čítanie, orchestrátor automaticky prepne nového majstra na zápis a pokúša sa nastaviť iba na čítanie na starom majstrovi. Tieto akcie sú zamerané na zníženie pravdepodobnosti split brain.
Počas obnovy môžu nastať problémy, o ktorých by sa tiež malo informovať prostredníctvom UI orchestrátora okrem štandardných monitorovacích nástrojov. Rozšírili sme REST API, pridávajúc túto možnosť ( teraz je v procese posudzovania).
Celková schéma HA riešenia je uvedená nižšie.
Výber nového majstra
Orchestrátor je dostatočne inteligentný a snaží sa vybrať ako nového majstra na základe nasledujúcich kritérií:
- zmeškanie repliky za majstrom;
- verzia MySQL majstra a repliky;
- typ replikácie (RBR, SBR alebo zmiešaný);
- umiestnenie v jednom alebo viacerých dátových centrách;
- existenci
errant GTID— transakcie, ktoré boli vykonané na replikácii a chýbajú na majstrovi; - tiež sa zohľadňujú používateľské pravidlá výberu.
Nie každá replikácia je ideálnym kandidátom na úlohu majstra. Napríklad, replikácia môže byť použitá na zálohovanie údajov, alebo server má slabšiu konfiguráciu „hardvéru“. Orchestrátor ručné pravidlá, pomocou ktorých si môžete nastaviť svoje preferencie výberu kandidátov od najpreferovanejších po ignorované.
Čas reakcie a obnovenia
V prípade incidentu je dôležité minimalizovať dobu nečinnosti systému, preto zvažujeme parametre MySQL, ktoré ovplyvňujú výstavbu a aktualizáciu topológie clustra orchestrátorom:
- — počet sekúnd, počas ktorých replikácia čaká na prijatie nových údajov alebo heartbeat-signálu od majstra, skôr než sa spojenie uzná za stratené a vykoná prepojenie. Čím menšia hodnota, tým rýchlejšie replikácia dokáže určiť, že spojenie s majstrom je narušené. Nastavujeme túto hodnotu na 5 sekúnd.
- — počet sekúnd medzi pokusmi o opätovné pripojenie. Pri sieťových problémoch nízka hodnota tohto parametra umožní rýchlo sa pripojiť a zabrániť spusteniu procesu obnovy klastru. Odporúčaná hodnota je 1 sekunda.
MASTER_RETRY_COUNT— maximálny počet pokusov o opätovné pripojenie.MASTER_HEARTBEAT_PERIOD— interval v sekundách, po ktorom master odosiela heartbeat signál. Predvolene sa rovná polovici hodnotyslave_net_timeout.
Parametre orchestrátora:
DelayMasterPromotionIfSQLThreadNotUpToDate— ak je rovnýtrue, tak sa rola majstra neaplikuje na replikáciu kandidát, kým SQL vlákno repliky nevykoná všetky neaplikované transakcie z Relay Log. Túto možnosť používame, aby sme nestratili transakcie v podmienkach oneskorenia všetkých replikových kandidátov.InstancePollSeconds— frekvencia budovania a aktualizácie topológie.RecoveryPollSeconds— frekvencia analýzy topológie. V prípade zistenia problému sa spúšťa obnova topológie. To je, rovná 1 sekunde.
Každý uzol klastru sa orchestrátorom opytuje raz za InstancePollSeconds sekúnd. Pri zistení problému sa stav klastru nútene, a potom sa prijíma konečné rozhodnutie o vykonaní obnovy. Experimentovaním s rôznymi parametrami DB a orchestrátora sa nám podarilo znížiť dobu reakcie a obnovy na 30 sekúnd.
Testovací stánok
Testovanie HA schémy sme začali s vývojom miestneho a následným zavedením do testovacieho a produkčného prostredia. Místne prostredie je plne automatizované na základe Dockeru a umožňuje experimentovať s konfiguráciou orchestrátora a siete, škálovať klaster od 2-3 serverov po niekoľko desiatok a vykonávať cvičenia v bezpečnom prostredí.
Počas cvičení si vyberáme jednu z metód emulácie problému: okamžite odstrelíme majstra pomocou kill -9, jemne ukončíme proces a zastavíme server (docker-compose stop), simulujeme problémy so sieťou pomocou iptables -j REJECT alebo iptables -j DROP.Očakávame takéto výsledky:
- orchestrátor zistí problémy s majstrom a aktualizuje topológiu nie viac ako za 10 sekúnd;
- automaticky sa spustí procedúra obnovy: zmení sa sieťová konfigurácia, rola majstra prejde na repliku, topológia sa prestaví;
- Nový master sa stane dostupným pre zápis, živé repliky nebudú počas prebudovania stratené;
- Údaje začnú byť zapisované do nového mastera a replikované;
- Celkový čas na obnovenie bude maximálne 30 sekúnd.
Ako viete, systém sa môže v testovacom a produkčnom prostredí správať odlišne kvôli odlišnej konfigurácii hardvéru a siete, rozdielom v syntetickej a reálnej záťaži atď. Preto pravidelne vykonávame cvičenia v reálnych podmienkach, aby sme skontrolovali, ako sa systém správa pri strate sieťovej konektivity alebo degradácii jeho jednotlivých častí. V budúcnosti chceme vybudovať úplne identickú infraštruktúru pre obe prostredia a automatizovať jej testovanie.
Zhrnutie
Funkčnosť hlavného uzla systému ukladania údajov je jednou z hlavných úloh tímu SRE a údržby. Zavedenie orchestrátora a HA riešenia na báze VIP umožnilo dosiahnuť nasledujúce výsledky:
- spoľahlivé zisťovanie problémov s topológiou klastrov DB;
- automatické a rýchle reagovanie na incidenty súvisiace s masterom, čo znižuje prestoje systému.
Riešenie má však svoje obmedzenia a nedostatky:
- škálovanie HA schémy na niekoľko DC vyžaduje existenciu jednotnej L2 siete medzi nimi;
- pred priradením VIP k novému masteru musíme uvoľniť na starom. Proces je sekvenčný, čo predlžuje čas na obnovu;
- uvoľnenie VIP vyžaduje SSH prístup k serveru, alebo iný spôsob volania vzdialených procedúr. Keďže server alebo DB čelí problémom, ktoré spustili proces obnovy, nemôžeme si byť istí, že uvoľnenie VIP sa vydarí. To môže viesť k vzniku dvoch serverov s rovnakou virtuálnou IP adresou a k problému.
split brain.
Aby sme predišli split brain, môžeme použiť metódu („Vystreľte druhý uzol do hlavy“), ktorá úplne izoluje alebo odpojí problémový uzol. Existujú aj iné spôsoby realizácie vysokej dostupnosti klastrov: kombinácia VIP a DNS, zisťovanie služieb a proxy služby, synchronná replikácia a iné metódy, ktoré majú svoje nedostatky a výhody.
Hovoril som o našom prístupe k vytváraniu vysoko dostupného MySQL clustera. Je jednoduchý na realizáciu a zabezpečuje prijateľnú úroveň spoľahlivosti v súčasných podmienkach. S rastom celej systémovej infraštruktúry sa tento prístup určite vyvinie.
Zdroj: habr.com
