

Od editora blogu Google: Skôr vás niekedy zaujímalo, ako inžinieri technických riešení Google Cloud (TSE) spracovávajú vaše požiadavky na technickú podporu? Inžinieri technickej podpory TSE majú na starosti identifikáciu a riešenie problémov určených používateľmi. Niektoré z týchto problémov sú celkom jednoduché, ale niekedy sa objaví požiadavka, ktorá si vyžaduje pozornosť viacerých inžinierov. V tomto článku nám jeden zo zamestnancov TSE prerozpráva veľmi zložitý problém z jeho nedávnej praxe — . Počas tohto rozprávania uvidíme, ako sa inžinierom podarilo situáciu vyriešiť, a čo nové sa naučili pri odstraňovaní chyby. Dúfame, že tento príbeh nielenže osvetlí hlboko zakorenenú chybu, ale aj prinesie pochopenie procesov, ktoré prebiehajú pri podávaní požiadaviek na podporu Google Cloud.
Odstraňovanie problémov je zároveň vedou a umením. Všetko sa začína formulovaním hypotézy o príčine neštandardného správania systému, po ktorej nasleduje jej testovanie. Avšak predtým, než formulujeme hypotézu, musíme presne definovať a formulovať problém. Ak je otázka príliš nejasná, budete musieť všetko dôkladne analyzovať; v tomto spočíva „umenie“ odstraňovania problémov.
V prostredí Google Cloud sú takéto procesy značne zložité, pretože Google Cloud sa snaží zabezpečiť dôvernosť svojich používateľov. Z tohto dôvodu inžinieri TSE nemajú prístup k úprave vašich systémov, ani možnosť tak široko skúmať konfigurácie, ako to robia používatelia. Preto na overenie akejkoľvek z našich hypotéz (inžinieri) nemôžeme rýchlo modifikovať systém.
Niektorí používatelia si myslia, že všetko opravíme ako mechanici v autoservise a jednoducho nám posielajú id virtuálneho stroja, pričom v skutočnosti prebieha proces formou rozhovoru: zber informácií, formulácia a potvrdenie (alebo vyvrátenie) hypotéz, a nakoniec riešenie problému sa buduje na komunikácii s klientom.
Zvažovaný problém
Dnes pred nami stojí príbeh s dobrým koncom. Jedným z dôvodov úspešného vyriešenia navrhnutého prípadu je veľmi podrobné a presné opísanie problému. Nižšie je možné vidieť kópiu prvého tiketu (upraveného s cieľom skryť dôverné informácie):
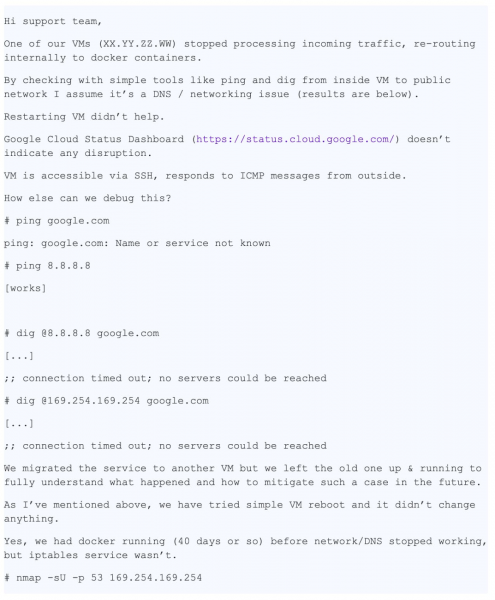
V tejto správe je veľa užitočných informácií pre nás:
- Je uvedená konkrétna VM
- Je uvedený samotný problém — nefunguje DNS
- Je uvedené, kde sa problém prejavuje — VM a kontajner
- Sú uvedené kroky, ktoré používateľ vykonal na identifikáciu problému
Žiadosť bola zaregistrovaná ako „P1: Kritický dopad — služba je nepoužiteľná v produkcii“, čo znamená nepretržité sledovanie situácie 24/7 podľa schémy „Follow the Sun“ (na odkaze si môžete prečítať viac o ), s jej odovzdaním z jedného tímu technickej podpory na druhý pri každom posune časových pásiem. V podstate, do momentu, keď sa problém dostal k nášmu tímu v Zürichu, stihol obehnúť zemeguľu. Do tohto času už používateľ prijal opatrenia za účelom zníženia následkov, no obával sa opakovania situácie na produkcii, pretože hlavná príčina stále nebola zistená.
K momentu, keď tiket dorazil do Zürichu, sme už mali nasledujúce informácie:
- Obsah
/etc/hosts - Obsah
/etc/resolv.conf - Záver
iptables-save - Tím zhromaždil
ngrepsúbor pcap
S týmito údajmi sme boli pripravení prejsť na etapu „vyšetrenia“ a odstraňovania porúch.
Naše prvé kroky
Najprv sme skontrolovali logy a stav servera metadát a uistili sa, že funguje správne. Server metadát odpovedá IP adrese 169.254.169.254 a okrem iného zabezpečuje kontrolu nad názvami domén. Rovnako sme skontrolovali, že firewall správne funguje s VM a neblokuje pakety.
To bola nejaká zvláštna situácia: overenie pomocou nmap vyvrátilo našu základnú hypotézu o strate UDP paketov, takže sme si mentálne pripravili niekoľko ďalších možností a spôsobov ich overenia:
- Strácajú sa pakety výberovo? => Skontrolovať pravidlá iptables
- Nie je príliš malý ? => Проверить вывод
ip a show - Týka sa problém iba UDP paketov alebo aj TCP? => Spustiť
dig +tcp - Vrátia sa generované dig pakety? => Spustiť
tcpdump - Funguje správne libdns? => Spustiť
stracena kontrolu prenosu paketov oboma smermi
Tu sa rozhodujeme zavolať používateľovi na riešenie problémov naživo.
Počas hovoru sa nám podarí overiť niekoľko vecí:
- Po niekoľkých overeniach vylučujeme pravidlá iptables zo zoznamu možných príčin.
- Kontrolujeme sieťové rozhrania a smerovacie tabuľky a znova overujeme správnosť MTU.
- Zistíme, že
dig +tcp google.com(TCP) funguje ako má, aledig google.com(UDP) nefunguje. - Po spustení
tcpdumpto zatiaľ funguje.dig, zistíme, že UDP pakety sa vracajú. - Spúšťame
strace dig google.coma vidíme, ako dig správne volásendmsg()arecvms(), avšak druhé sa preruší z dôvodu časového limitu.
Bohužiaľ, koniec smeny prichádza a sme nútení preniesť problém do ďalšej časovej zóny. Napriek tomu vzbudilo naše oslovovanie záujem v našom tíme a kolega navrhuje vytvoriť pôvodný DNS paket pomocou Python modulu scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Tento fragment vytvára DNS paket a posiela požiadavku serveru metadát.
Používateľ spustí kód, DNS odpoveď sa vráti a aplikácia ju získa, čím potvrdzuje, že problém na úrovni siete neexistuje.
Po ďalšej "cestovateľskej" skúsenosti sa požiadavka vracia k nášmu tímu a ja si ju plne preberám, pretože som usúdil, že používateľovi bude pohodlnejšie, ak sa požiadavka prestane motať naokolo.
Medzitým užívateľ ochotne súhlasí, že poskytne snímku obrazu systému. To sú veľmi dobré správy: možnosť testovať systém samostatne výrazne urýchľuje odstraňovanie problémov, pretože už nemusím žiadať používateľa, aby spúšťal príkazy, posielal mi výsledky a analyzoval ich, všetko môžem urobiť sám!
Moji kolegovia mi začínajú trochu žiarliť. Na obede diskutujeme o žiadosti, no nikto nemá nápad, čo sa deje. Našťastie sám používateľ už prijal opatrenia na zmiernenie následkov a nikam sa neponáhľa, takže máme čas analyzovať problém. A keďže máme obraz, môžeme vykonávať akékoľvek zaujímavé testy. Skvelé!
Vrátime sa o krok späť.
Jedna z najčastejších otázok na pohovore na pozíciu systémového inžiniera znie: „Čo sa stane, keď pingujete ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
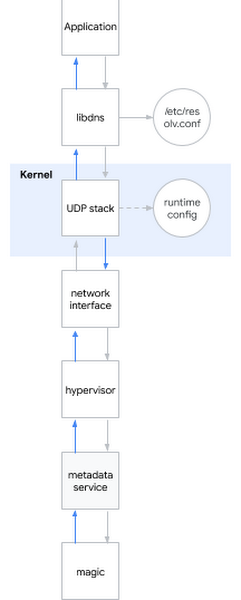
Rozhodujem sa aplikovať túto otázku na aktuálny problém. Hlavne, keď sa pokúšate určiť DNS meno, stane sa nasledovné:
- Aplikácia volá systémovú knižnicu, napríklad libdns
- libdns kontroluje konfiguráciu systému, na ktorý DNS server treba volať (na diagrame je to 169.254.169.254, server metadát)
- libdns používa systémové volania na vytvorenie UDP soketu (SOKET_DGRAM) a na prenos UDP paketov s DNS požiadavkou oboma smermi
- Cez rozhranie sysctl je možné nastaviť UDP zásobník na úrovni jadra
- Jadro interaguje s hardvérom na prenos paketov po sieti cez sieťové rozhranie
- Hypervízor zachytí a prenesie paket na server metadát pri jeho kontakte
- Server metadát svojím kúzlom určuje DNS meno a rovnakým spôsobom vracia odpoveď
Pripomínam, aké hypotézy sme už stihli preskúmať:
Hypotéza: Knižnice sú poškodené
- Test 1: spustiť v systéme strace, skontrolovať, či dig vykonáva správne systémové volania
- Výsledok: vykonávajú sa správne systémové volania
- Test 2: cez srapy skontrolovať, či môžeme určovať mená mimo systémových knižníc
- Výsledok: môžeme
- Test 3: spustiť rpm –V na balíku libdns a md5sum súboroch knižnice
- Výsledok: kód knižnice je úplne identický s kódom v pracovnom operačnom systéme
- Test 4: pripojiť obraz koreňového systému používateľa na VM bez podobného správania, spustiť chroot, pozrieť sa, či DNS funguje
- Výsledok: DNS funguje správne
Záver na základe testov: problém nie je v knižniciach
Hypotéza: V nastaveniach DNS je chyba
- Test 1: skontrolovať tcpdump a pozorovať, či sa správne odosielajú a vracajú DNS pakety po spustení dig
- Výsledok: pakety sa odosielajú správne
- Test 2: prekontrolovať na serveri
/etc/nsswitch.confa/etc/resolv.conf - Výsledok: všetko je v poriadku
Záver na základe testov: problém nie je v konfigurácii DNS
Hypotéza: jadro je poškodené
- Test: nainštalovať nové jadro, skontrolovať podpis, reštartovať
- Výsledok: rovnaké správanie
Záver na základe testov: jadro nie je poškodené
Hypotéza: nesprávne správanie používateľskej siete (buď rozhrania siete hypervízora)
- Test 1: skontrolovať nastavenia firewallu
- Výsledok: firewall prepúšťa DNS pakety ako na hostiteľovi, tak aj na GCP
- Test 2: zachytiť prenos a sledovať správnosť odosielania a vracania DNS požiadaviek
- Výsledok: tcpdump potvrdzuje prijatie obratných paketov hostiteľom
Záver na základe testov: problém nie je v sieti
Hypotéza: server metadát nefunguje
- Test 1: skontrolovať logy servera metadát na anomálie
- Výsledok: v logoch nie sú anomálie
- Test 2: obísť server metadát cez
dig @8.8.8.8 - Výsledok: rozlíšenie sa narušuje aj bez použitia servera metadát
Záver na základe testov: problém nie je v serveri metadát
Záver: testovali sme všetky podsystémy okrem nastavení prostredia behu!
Ponorenie do nastavení prostredia behu jadra
Na nastavenie prostredia behu jadra môžete využiť možnosti príkazového riadku (grub) alebo rozhranie sysctl. Pozrel som sa na /etc/sysctl.conf a predstavte si, našiel som niekoľko vlastných nastavení. Cítiac, akoby som sa chytil niečoho, odstránil som všetky nesiete alebo ne-tcp nastavenia, a zostal len pri hromade nastavení net.core. Potom som prešiel tam, kde sú u VM uložené povolenia hostiteľa a začal som aplikovať postupne, jednu po druhej nastavenia so zlomenou VM, kým som sa nedostal k páchateľovi:
net.core.rmem_default = 2147483647Tu je, rozbíjajúca DNS konfigurácia! Našiel som zbraň zločinu. Ale prečo sa to deje? Ešte som potreboval motiv.
Nastavenie základnej veľkosti bufferu DNS paketov sa vykonáva cez net.core.rmem_default. Typická hodnota sa pohybuje niekde okolo 200KiB, avšak ak váš server dostáva veľa DNS paketov, môžete zvýšiť veľkosť bufferu. Ak je buffer plný v momente príchodu nového paketu, napríklad preto, že aplikácia ho nestíha rýchlo spracovávať, začnete strácať pakety. Náš klient správne zvýšil veľkosť bufferu, pretože mal obavy z únikov dát, keďže používal aplikáciu na zber metrík cez DNS pakety. Hodnota, ktorú nastavili, bola maximálne možná: 231-1 (ak nastavíte 231, jadro vráti „NEPLATNÝ ARGUMENT“).
Zrazu som si uvedomil, prečo nmap a scapy fungovali správne: používali surové sokety! Surové sokety sa líšia od bežných: pracujú obchádzajúc iptables a nie sú bufferizované!
Ale prečo „príliš veľký buffer“ spôsobuje problémy? Zjavne nefunguje tak, ako bolo zamýšľané.
Do tohto bodu som mohol reprodukovať problém na niekoľkých jadrách a rôznych distribúciách. Problém sa už prejavoval na jadre 3.x a teraz sa takisto prejavoval na jadre 5.x.
Naozaj, pri spustení
sysctl -w net.core.rmem_default=$((2**31-1))DNS prestal fungovať.
Začal som hľadať fungujúce hodnoty pomocou jednoduchého algoritmu binárneho vyhľadávania a zistil som, že systém pracuje s číslom 2147481343, ale toto číslo pre mňa predstavovalo bezvýznamný súbor číslic. Navrhol som klientovi vyskúšať toto číslo a on odpovedal, že systém fungoval s google.com, ale stále vykazoval chybu s inými doménami, takže som pokračoval vo svojom vyšetrovaní.
Nainštaloval som , nástroj, ktorý som mal použiť skôr: ukazuje, kam presne v jadre ide paket. Viníkom bola funkcia udp_queue_rcv_skb. Stiahol som zdrojové kódy jadra a pridal niekoľko na sledovanie, kam konkrétne ide paket. Rýchlo som objavil potrebnú podmienku ak, a nejaký čas som sa na ňu len pozeral, pretože práve vtedy sa všetko konečne poskladal do celkovej mozaiky: 231-1, bezvýznamné číslo, nefungujúca doména… Problematika spočívala v úryvku kódu v __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Všimnite si:
rmemje typu intsizeje typu u16 (nepodpisovaný šestnásťbitový int) a uchováva veľkosť paketu.sk->sk_rcybufje typu int a uchováva veľkosť bufferu, ktorá je podľa definície rovná hodnote vnet.core.rmem_default
Keď sk_rcvbuf sa približuje k 231, sčítanie veľkosti paketu môže viesť k . A pretože je to int, jeho hodnota sa stáva zápornou, čo znamená, že podmienka sa stáva pravdivou, keď by mala byť falošná (viac na túto tému sa môžete dozvedieť z ).
Oprava sa vykonáva triviálnym spôsobom: konverziou na unsigned int. Aplikoval som opravu a reštartoval systém, po čom DNS opäť začal fungovať.
Chuť víťazstva
Preposlal som svoje zistenia klientovi a poslal patch jadra. Som spokojný: každý kúsok puzzle zapadol na správne miesto, môžem presne vysvetliť, prečo sme pozorovali to, čo sme pozorovali, a čo je najdôležitejšie, dokázali sme nájsť riešenie problému vďaka spolupráci!
Je potrebné uznať, že tento prípad bol zriedkavý a našťastie sa nám od používateľov málokedy dostávajú tak zložité požiadavky.
Zdroj: habr.com
