

Ahoj, Habr! Volám sa Maxim Vasiliev, pracujem ako analytik a projektový manažér vo FINCH. Dnes by som chcel rozprávať o tom, ako sme pomocou ElasticSearch dokázali spracovať 15 miliónov požiadaviek za 6 minút a optimalizovať denné zaťaženie na stránke jedného z našich klientov. Bohužiaľ, musíme sa zaobísť bez mien, pretože máme NDA; dúfame, že obsah článku tým nebude trpieť. Poďme na to.
Ako je projekt organizovaný
Na našej backendovej strane vytvárame služby, ktoré zabezpečujú funkčnosť webových stránok a mobilnej aplikácie nášho klienta. Celkovú štruktúru si môžete pozrieť na schéme:
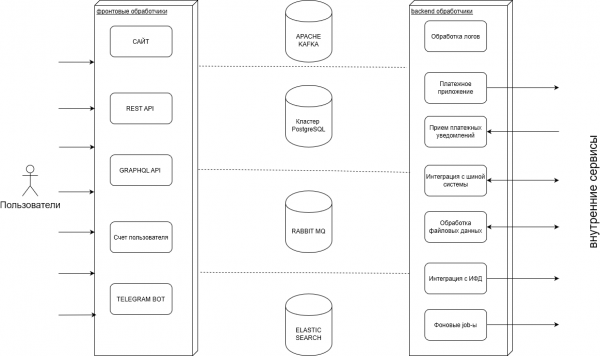
V procese práce spracovávame veľké množstvo transakcií: nákupov, výplat, operácií s používateľskými zostatkami, na ktoré uchovávame veľa logov, ako aj importujeme a exportujeme tieto dáta do externých systémov.
Existujú aj spätné procesy, keď prijímame dáta od klienta a prenášame ich používateľom. Okrem toho existujú procesy týkajúce sa platieb a vernostných programov.
Krátky úvod
Pôvodne sme ako jediné úložisko dát používali PostgreSQL. Jeho štandardné výhody pre SÚDB: prítomnosť transakcií, rozvinutý jazyk pre výber dát, široké nástroje na integráciu; v kombinácii s dobrou výkonnosťou uspokojovali naše potreby pomerne dlho.
V Postgres sme uchovávali úplne všetky dáta: od transakcií po novinky. Ale počet používateľov rástol, rovnako ako aj počet požiadaviek.
Pre pochopenie, ročný počet relácií v roku 2017 iba na desktopovej stránke — 131 miliónov. V roku 2018 — 125 miliónov. 2019 opäť 130 miliónov. Pridajte tam ešte 100-200 miliónov z mobilnej verzie stránky a mobilnej aplikácie, a získate obrovské množstvo požiadaviek.
S rastom projektu, Postgres prestal zvládať zaťaženie, nestíhali sme — objavilo sa veľké množstvo rozmanitých požiadaviek, pre ktoré sme nedokázali vytvoriť dostatočné množstvo indexov.
Uvedomovali sme si, že je potrebné iné úložiská dát, ktoré by uspokojili naše potreby a znížili zaťaženie z PostgreSQL. Ako možné varianty sme zvažovali Elasticsearch a MongoDB. Posledne uvedené prehrávalo z nasledujúcich dôvodov:
- Pomalá rýchlosť indexovania s rastom objemu dát v indexoch. U Elastic rýchlosť nezávisí od objemu dát.
- Žiadne vyhľadávanie v texte
Tak sme si vybrali Elastic a pripravili sme sa na prechod.
Prechod na Elastic
1. Prechod sme začali s vyhľadávaním predajných miest. Náš klient má celkovo približne 70 000 predajných miest a potrebujeme niekoľko typov vyhľadávania na webovej stránke a v aplikácii:
- Textové vyhľadávanie podľa názvu obce
- Geohľadanie v zadanom rádiuse od určitej položky. Napríklad, ak chce používateľ vidieť, ktoré predajné miesta sú najbližšie k jeho domu.
- Vyhľadávanie v zadanom štvorci – používateľ nakreslí štvorec na mape a zobrazia sa mu všetky body v tomto rádiuse.
- Vyhľadávanie podľa dodatočných filtrov. Predajné miesta sa od seba líšia sortimentom.
Čo sa organizácie týka, v Postgres máme uložený zdroj údajov ako na mape, tak aj v novinkách, a v Elastic sa vytvárajú Snapshoty z originálnych dát. Ide o to, že pôvodne Postgres nezvládal vyhľadávanie podľa všetkých kritérií. Nielenže bolo veľa indexov, ale mohli sa aj pretínať, takže plánovač Postgres sa strácal a nedokázal pochopiť, ktorý index má použiť.
2. Ďalším na rade bol sekcia noviniek. Na webovej stránke sa každý deň objavujú publikácie, a aby sa používateľ nestratil v prúde informácií, je potrebné dáta pred vydaním zoradiť. Na to je potrebné vyhľadávanie: na stránke môžete vyhľadávať podľa textu zhodu a zároveň pripojiť dodatočné filtre, ktoré sú tiež spracované cez Elastic.
3. Potom sme presunuli spracovanie transakcií. Používatelia môžu nakupovať určité produkty na webovej stránke a zúčastňovať sa súťaže. Po takýchto nákupoch spracovávame veľké množstvo dát, najmä cez víkendy a sviatky. Pre porovnanie, ak v bežné dni počet nákupov dosahuje približne 1,5–2 milióna, počas sviatkov sa číslo môže vyšplhať až na 53 miliónov.
Tieto údaje je potrebné spracovať v čo najkratšom čase — používatelia nemajú radi, ak musia čakať niekoľko dní na výsledok. Ceze Postgres takéto lehoty jednoducho nedosiahneme — často sme dostávali zamknutia a kým sme spracovali všetky požiadavky, používatelia nemohli skontrolovať, či vyhrali alebo nie. To nie je pre biznis príjemné, a preto sme presunuli spracovanie do Elasticsearch.
Frekvencia
Momentálne sú aktualizácie nastavené udalosťou, podľa nasledujúcich podmienok:
- Predajné miesta. Ako náhle dostaneme údaje z externého zdroja, okamžite spustíme aktualizáciu.
- Novinky. Keď sa na stránke upraví akákoľvek novinka, automaticky sa odošle do Elastic.
Tu sa ešte raz oplatí povedať o výhodách Elastic. V Postgres pri odosielaní požiadavky musíte čakať, kým spracuje všetky záznamy. V Elastic môžete odoslať 10 tisíc záznamov a okamžite začať pracovať, bez čakania, kým sa záznamy rozprídu po všetkých Shards. Samozrejme, nejaký Shard alebo Replica nemusia vidieť údaje okamžite, ale veľmi rýchlo budú všetky dostupné.
Spôsoby integrácie
Existujú 2 spôsoby integrácie s Elastic:
- Cez natívneho klienta po TCP. Natívny driver postupne vymiera: prestávajú ho podporovať, má veľmi nepraktickú syntax. Preto ho prakticky nepoužívame a snažíme sa ho úplne opustiť.
- Cez HTTP rozhranie, v ktorom môžeme použiť požiadavky v JSON formáte a syntax Lucene. To posledné je textový engine, ktorý používa Elastic. V takom prípade získavame možnosť Batch cez JSON požiadavky po HTTP. Tento variant sa snažíme používať.
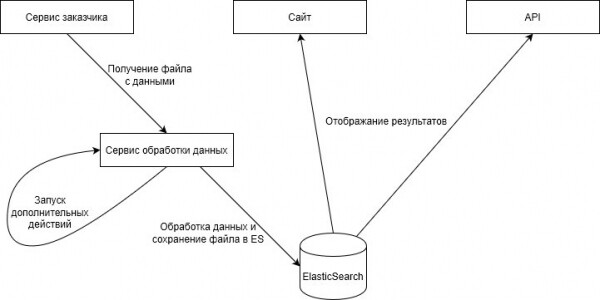
Vďaka HTTP rozhraniu môžeme využiť knižnice, ktoré poskytujú asynchrónnu implementáciu HTTP klienta. Môžeme využiť výhodu Batch a asynchrónneho API, čo nakoniec poskytuje vysoký výkon, ktorý nám veľmi pomohol počas veľkej akcie (o tom nižšie)
Trošku čísel na porovnanie:
- Uloženie používateľov, ktorí získali ceny v Postgres v 20 vláknach bez zoskupení: 460713 záznamov za 42 sekúnd
- Elastic + reaktívny klient na 10 vlákien + batch na 1000 prvkov: 596749 záznamov za 11 sekúnd
- Elastic + reaktívny klient na 10 vlákien + batch na 1000 prvkov: 23801684 záznamov za 4 minúty
Teraz sme napísali správcu požiadaviek po HTTP, ktorý vytvára JSON, ako Batch/ne Batch a posiela ho cez akéhokoľvek HTTP klienta bez ohľadu na knižnicu. Takisto je možné vybrať, či posielať požiadavky synchrónne alebo asynchrónne.
V niektorých integráciách stále používame oficiálne transportné klienty, ale to je len otázka najbližšej refaktorizácie. Pri tom sa používa vlastný klient postavený na základe Spring WebClient.
Veľká akcia
Raz ročne sa na projekte konajú veľké akcie pre používateľov — to je ten pravý Highload, keď pracujeme s desiatkami miliónov používateľov súčasne.
Zvyčajne sú špičky zaťaženia počas sviatkov, ale táto akcia je úplne iná úroveň. V predminulom roku sme v deň akcie predali 27 580 890 kusov tovaru. Údaje sa spracovávali viac ako pol hodiny, čo spôsobovalo nepríjemnosti používateľom. Používatelia získali ceny za účasť, ale ukázalo sa, že proces treba urýchliť.
Na začiatku roku 2019 sme sa rozhodli, že potrebujeme ElasticSearch. Celý rok sme organizovali spracovanie prijatých dát v Elastic a ich zobrazenie v API mobilnej aplikácie a webovej stránky. Výsledkom bolo, že na nasledujúci rok sme počas akcie spracovali 15 131 783 záznamov za 6 minút.
Keďže máme veľa záujemcov o nákup tovaru a účasť v súťažiach, je to dočasné opatrenie. Momentálne posielame aktuálne informácie do Elastic, ale v budúcnosti plánujeme presunúť archívne informácie z predchádzajúcich mesiacov do Postgres ako trvalé úložisko. Aby sme nezahltili index Elastic, ktorý má tiež svoje obmedzenia.
Záver/poznatky
V súčasnosti sme presunuli do Elastic všetky služby, ktoré sme chceli, a zatiaľ sme urobili prestávku. Teraz nad hlavné perzistentné úložisko v Postgres budujeme index v Elastic, ktorý preberá používateľské zaťaženie.
V budúcnosti plánujeme presúvať služby, ak pochopíme, že žiadosti o dáta sa stávajú príliš rozmanitými a hľadajú sa podľa neobmedzeného počtu stĺpcov. To už nie je úloha pre Postgres.
Ak budeme potrebovať fulltextové vyhľadávanie vo funkčnosti alebo ak budeme mať mnoho rôznorodých kritérií vyhľadávania, už vieme, že to treba presunúť do Elastic.
⌘⌘⌘
Ďakujeme, že ste si prečítali. Ak vo vašej spoločnosti tiež používate ElasticSearch a máte vlastné prípady realizácie, podeľte sa o ne. Bude zaujímavé zistiť, ako to robia iní 🙂
Zdroj: habr.com
