

Úvod
 „Musíme bežať všetkými silami, aby sme len zostali na mieste,
a aby sme sa niekam dostali, musíme bežať minimálne dvakrát rýchlejšie!“
(c) Alenka v ríši divov
Pred nejakým časom ma požiadali, aby som predniesol prednášku analytikom našej spoločnosti na tému navrhovania dátových modelov, pretože pri dlhodobom sedení na projektoch (niekedy aj niekoľko rokov) prehliadame, čo sa deje vo svete IT technológií. V našej spoločnosti (tak to už vyšlo) sa na mnohých projektoch nepoužívajú NoSQL databázy (aspoň zatiaľ), takže som vo svojej prednáške venoval niekoľko pozornosti tomuto téme na príklade HBase a snažil som sa orientovať výklad materiálu na tých, ktorí s nimi nikdy nepracovali. Najmä som ilustroval niektoré aspekty navrhovania dátového modelu na príklade, ktorý som pred niekoľkými rokmi prečítal . Pri prechádzaní príkladmi som porovnával niekoľko variantov riešenia toho istého problému, aby som lepšie preniesol na poslucháčov základné myšlienky.
Nedávno, „z nudy“, som si položil otázku (dlhé májové voľno v karanténnom režime tomu zvlášť nahráva), ako veľmi budú teoretické vývody zodpovedať praxi? Vlastne takto sa zrodila myšlienka tohto článku. Vývojár, ktorý už niekoľko rokov pracuje s NoSQL, pravdepodobne nenájde nič nové (a preto môže okamžite preskočiť polovicu článku). Ale pre analytikov, ktorí ešte úzko nespolupracovali s NoSQL, si myslím, že to bude užitočné na získanie základných predstáv o vlastnostiach navrhovania dátových modelov pre HBase.
Analýza príkladu
Podľa môjho názoru, predtým ako začnete používať NoSQL databázy, je potrebné dobre premyslieť a zvážiť „za“ a „proti“. Často je úlohu možné vyriešiť aj pomocou tradičných relačných DBMS. Preto by sme sa mali vyhnúť používaniu NoSQL bez zásadných dôvodov. Ak sa však rozhodnete použiť NoSQL databázu, je potrebné zohľadniť, že prístupy k návrhu sú tu trochu odlišné. Niektoré z nich môžu byť najmä nezvyčajné pre tých, ktorí sa predtým zaoberali iba relačnými DBMS (podľa mojich pozorovaní). Tak, v „relačnom“ svete obvykle začíname modelovaním predmetovej oblasti a až potom, ak je to potrebné, vykonáme denormalizáciu modelu. V NoSQL však musíme ihneď zohľadniť predpokladané scenáre práce s dátami a pôvodne denormalizovať dáta. Okrem toho existuje niekoľko ďalších rozdielov, o ktorých bude napísané nižšie.
Pozrime sa na nasledujúcu „syntetickú“ úlohu, s ktorou budeme ďalej pracovať:
Je potrebné navrhnúť štruktúru ukladania zoznamu priateľov používateľov v istej abstraktnej sociálnej sieti. Pre zjednodušenie predpokladajme, že všetky vzťahy sú smerované (ako na Instagrame, nie na LinkedIn). Štruktúra by mala umožniť efektívne:
- Odpovedať na otázku, či používateľ A číta používateľa B (šablóna čítania)
- Umožniť pridávať/odstraňovať vzťahy v prípade prihlásenia/odhlásenia používateľa A od používateľa B (šablóna zmeny dát)
Samozrejme, možností riešenia úlohy je veľa. V bežnej relačnej DB by sme pravdepodobne jednoducho vytvorili tabuľku vzťahov (možno typizovanú, ak napríklad potrebujeme uchovávať používateľskú skupinu: rodina, práca a pod., do ktorej patrí daný „priateľ“), a pre optimalizáciu rýchlosti prístupu by sme pridali indexy/particionovanie. Pravdepodobne by konečná tabuľka vyzerala približne takto:
user_id
friend_id
Vasja
Peťa
Vasja
Oľga
tu a ďalej pre prehľadnosť a lepšie pochopenie namiesto ID uvediem mená
V prípade HBase však vieme, že:
- efektívne vyhľadávanie, ktoré nevedie k full table scan, je možné výlučne podľa kľúča
- Takže, preto písanie bežných SQL dopytov pre takéto databázy je zlý nápad; technicky áno, môžete z Impala poslať SQL dopyt s JOINmi a ďalšou logikou do HBase, ale aké efektívne to bude…
Preto musíme použiť ID používateľa ako kľúč. A prvou myšlienkou na tému „kde a ako uchovávať ID priateľov?“ môže byť myšlienka uloženia ich v stĺpcoch. Tento najzrejmejší a „naivný“ variant by vyzeral približne takto (nazvime to Variant 1 (default), aby sa na ne dalo odkazovať ďalej):
RowKey
Stĺpce
Vasja
1: Peťo
2: Oľga
3: Daša
Peťa
1: Maša
2: Vašo
Tu každé riadky zodpovedajú jednému používateľovi siete. Stĺpce majú mená: 1, 2, … — podľa počtu priateľov a v stĺpcoch sú uložené ID priateľov. Dôležité je poznamenať, že každé riadky budú mať rôzny počet stĺpcov. V príklade na obrázku vyššie jeden riadok má tri stĺpce (1, 2 a 3), zatiaľ čo druhý má len dva (1 a 2) – tu sme využili dve vlastnosti HBase, ktoré nemá relácie databáz:
- možnosť dynamicky meniť zloženie stĺpcov (pridáme priateľa -> pridáme stĺpec, odstránime priateľa -> odstránime stĺpec)
- u rôznych riadkov môže byť rôzne zloženie stĺpcov
Skontrolujeme našu štruktúru na zhodu s požiadavkami úlohy:
- Čítanie údajov: na to, aby sme pochopili, či je Vašo prihlásený na Oľgu, potrebujeme prečítať celý riadok podľa kľúča RowKey = „Vašo“ a prechádzať hodnoty stĺpcov, kým v nich nenájdeme Oľgu. Alebo prejsť hodnoty všetkých stĺpcov, „nenájsť“ Oľgu a vrátiť odpoveď False;
- Úprava údajov: pridanie priateľa: pre takúto úlohu tiež potrebujeme prečítať celý riadok podľa kľúča RowKey = „Vašo“, aby sme spočítali celkový počet jeho priateľov. Tento celkový počet priateľov potrebujeme na určenie čísla stĺpca, do ktorého musíme zapísať ID nového priateľa.
- Úprava údajov: odstránenie priateľa:
- Musíme prečítať celý riadok podľa kľúča RowKey = „Vašo“ a prechádzať stĺpce, aby sme našli ten, v ktorom je zapísaný odstraňovaný priateľ;
- Následne, po odstránení priateľa, musíme „posunúť“ všetky údaje o jeden stĺpec, aby sme nezískali „výpadky“ v ich číslovaní.
Teraz sa poďme pozrieť, aká efektívna bude implementácia týchto algoritmov, ktoré budeme musieť realizovať na strane „podmienečnej aplikácie“, Označme veľkosť našej hypotetickej sociálnej siete ako n. Potom maximálny počet priateľov, ktorých môže mať jeden používateľ, môže byť (n-1). Túto (-1) môžeme pre naše účely v ďalšom ignorovať, pretože z pohľadu použitia O-symboliky je irelevantná.
- Čítanie údajov: potrebujeme prečítať celú riadku a prejsť všetkými jej stĺpcami. To znamená, že horný odhad nákladov bude približne O(n)
- Úprava údajov: pridanie priateľa: na určenie počtu priateľov je potrebné prejsť všetkými stĺpcami riadku a potom vložiť nový stĺpec => O(n)
- Úprava údajov: odstránenie priateľa:
- Podobne ako pri pridávaní – je potrebné prejsť všetkými stĺpcami => O(n)
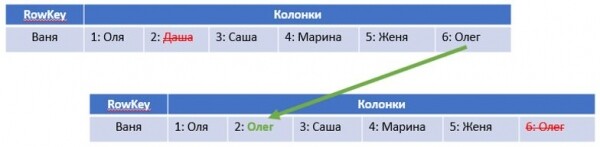
- Po odstránení stĺpcov musíme ich "posunúť". Ak by sme to realizovali "priamo", bolo by v konečnom dôsledku potrebné ešte do (n-1) operácií. Ale tu a v nasledujúcej praktickej časti použijeme iný prístup, ktorý bude realizovať "pseudo-posun" za fixný počet operácií – teda na to bude potrebné konštantné časové obdobie bez ohľadu na n. Túto konštantnú dobu (ak by sme boli presní, potom O(2)) môžeme v porovnaní s O(n) ignorovať. Prístup je ilustrovaný na obrázku nižšie: jednoducho skopírujeme údaje z "posledného" stĺpca do toho, z ktorého potrebujeme odstrániť údaje, a potom odstránime posledný stĺpec:

Celkovo, vo všetkých scenároch sme dostali asymptotickú výpočtovú zložitosti O(n).
Asi ste si už všimli, že takmer vždy musíme prečítať z databázy celú riadku, pričom v dvoch z troch prípadov iba preto, aby sme prešli všetkými stĺpcami a spočítali celkový počet priateľov. Preto ako pokus o optimalizáciu môžeme pridať stĺpec "count", v ktorom budeme uchovávať celkový počet priateľov každého používateľa siete. V tomto prípade nemusíme prečítať celú riadku na spočítanie celkového počtu priateľov, ale prečítame len jeden stĺpec "count". Hlavné je nezabudnúť aktualizovať "count" pri manipulácii s údajmi. Týmto spôsobom dostávame vylepšený Varianta 2 (count):
RowKey
Stĺpce
Vasja
1: Peťo
2: Oľga
3: Daša
count: 3
Peťa
1: Maša
2: Vašo
count: 2
V porovnaní s prvou variantou:
- Čítanie údajov: na odpoveď na otázku „Číta Vaša Oľga?“ sa nič nezmenilo => O(n)
- Úprava údajov: pridanie priateľa: Umožnili sme jednoduchšie pridanie nového priateľa, pretože teraz nemusíme prechádzať celým riadkom a kontrolovať jeho stĺpce, ale môžeme len získať hodnotu stĺpca „count“ a tým okamžite určiť číslo stĺpca na vloženie nového priateľa. To znižuje výpočtovú zložitost na O(1)
- Úprava údajov: odstránenie priateľa: Pri odstraňovaní priateľa môžeme rovnako využiť tento stĺpec, aby sme znížili počet vstupno-výstupných operácií pri „posune“ dát o jednu bunku doľava. Ale potreba prechádzať stĺpcami na nájdenie toho, ktorý je potrebné odstrániť, ostáva, preto => O(n)
- Na druhej strane, teraz pri aktualizácii údajov musíme zakaždým aktualizovať aj stĺpec „count“, ale to trvá konštantný čas, ktorý môžeme v rámci O-štatistiky ignorovať
Celkovo sa varianta 2 javí o niečo viac optimálna, ale je to skôr „evolúcia namiesto revolúcie“. Na uskutočnenie „revolúcie“ budeme potrebovať Varianta 3 (col).
Prevrátime všetko „z nôh na hlavu“: pridáme ako názov stĺpca identifikátor používateľa! Čo bude zapísané v samotnom stĺpci – pre nás už nie je podstatné, môže tam byť číslo 1 (vlastne tam môžeme uchovávať napríklad skupinu „rodina/priatelia/a pod.“). Tento prístup môže prekvapiť nepripraveného „obyčajného” človeka, ktorý predtým nemal skúsenosti s NoSQL databázami, ale práve on umožňuje využiť potenciál HBase v tejto úlohe omnoho efektívnejšie:
RowKey
Stĺpce
Vasja
Peťo: 1
Oľga: 1
Dasha: 1
Peťa
Maša: 1
Vasia: 1
Tu získavame hneď niekoľko výhod. Aby sme ich pochopili, analyzujme novú štruktúru a zhodnotíme výpočtovú zložitost:
- Čítanie údajov: aby sme odpovedali na otázku, či je Vasia prihlásený na Oľgu, stačí prečítať jeden stĺpec „Oľga“: ak existuje, odpoveď je True, ak nie – False => O(1)
- Úprava údajov: pridanie priateľa: Pridanie priateľa: stačí jednoducho pridať nový stĺpec „ID priateľa“ => O(1)
- Úprava údajov: odstránenie priateľa: stačí jednoducho odstrániť stĺpec „ID priateľa“ => O(1)
Ako vidíme, významnou výhodou tejto modelu ukladania je, že vo všetkých potrebných scenároch manipulujeme len s jedným stĺpcom, čím sa vyhneme čítaniu celej riadku z databázy a už vôbec nie prehľadávaniu všetkých stĺpcov tohto riadku. Na tom by sme mohli prestať, ale...
Môžete sa zamyslieť a ísť ešte o kúsok ďalej pri optimalizácii výkonu a znížení operácií vstupu a výstupu pri prístupe k databáze. Čo ak by sme uložiť úplné informácie o vzťahu priamo v kľúči riadku? Teda urobiť kľúč zložený ako userID.friendID? V tomto prípade nemusíme vôbec čítať stĺpce riadka (Variant 4(row)):
RowKey
Stĺpce
Vasya.Petya
Peťo: 1
Vasya.Olya
Oľga: 1
Vasya.Dasha
Dasha: 1
Petya.Masha
Maša: 1
Petya.Vasya
Vasia: 1
Je zrejmé, že ohodnotenie všetkých scenárov manipulácie s údajmi v takejto štruktúre bude rovnako ako v predchádzajúcej variante O(1). Rozdiel s variantom 3 bude už výlučne v efektivite operácií vstupu a výstupu v DB.
A nakoniec posledný „mašlička“. Je ľahko viditeľné, že v variante 4 bude kľúč riadka mať premennú dĺžku, čo by mohlo ovplyvniť výkon (tu si pripomíname, že HBase ukladá údaje ako súbor bajtov a riadky v tabuľkách sú usporiadané podľa kľúča). Navyše máme oddelovač, ktorý v niektorých scenároch môže byť potrebné spracovať. Aby sme vylúčili tento vplyv, môžeme použiť hash z userID a friendID, a pretože oba hashe budú mať konštantnú dĺžku, môžeme ich jednoducho skonkatenovať bez oddelovača. Potom budú údaje v tabuľke vyzerať tak (Variant 5(hash)):
RowKey
Stĺpce
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Peťo: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Oľga: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Maša: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasia: 1
Je zrejmé, že algoritmická zložitosť práce s takouto štruktúrou podľa nás presne taká istá, ako v variante 4 - teda O(1).
Celkovo zhrnieme všetky naše odhady výpočtovej zložitosti do jednej tabuľky:
Pridať priateľa
Overiť priateľa
Odstrániť priateľa
Variant 1 (default)
O(n)
O(n)
O(n)
Variant 2 (count)
O(1)
O(n)
O(n)
Variant 3 (column)
O(1)
O(1)
O(1)
Variant 4 (row)
O(1)
O(1)
O(1)
Variant 5 (hash)
O(1)
O(1)
O(1)
Ako je vidieť, možnosti 3-5 sa javia ako najpreferovanejšie a teoreticky zabezpečujú vykonanie všetkých potrebných scenárov manipulácie s údajmi za konštantný čas. V podmienkach našej úlohy nie je jasný požiadavok na získanie zoznamu všetkých priateľov používateľa, ale v skutočnej projektovej činnosti by bolo pre nás, ako dobrých analytikov, dobré „predvídať“, že takáto úloha sa môže objaviť a „pripraviť si pôdu“. Preto sú moje sympatie na strane možnosti 3. Ale je celkom možné, že v reálnom projekte mohla byť táto požiadavka už vyriešená inými prostriedkami, preto je lepšie ne robiť konečné závery bez celkového pohľadu na úlohu.
Príprava experimentu
Této teoretické úvahy by sme chceli overiť v praxi – o to išlo v zmene, ktorá vznikla počas dlhých víkendov. Na to je potrebné zhodnotiť rýchlosť práce našej „podmienečnej aplikácie“ vo všetkých opísaných scenároch používania databázy, ako aj rast tohto času s rastom veľkosti sociálnej siete (n). Cieľovým parametrom, ktorý nás zaujíma a ktorý budeme merať počas experimentu, je čas, ktorý „podmienečná aplikácia“ strávi na vykonanie jednej „biznis-operácie“. Pod „biznis-operáciou“ rozumieme jednu z nasledujúcich:
- Pridanie jedného nového priateľa
- Kontrola, či je používateľ A priateľom používateľa B
- Odstránenie jedného priateľa
Takže, s ohľadom na požiadavky uvedené v pôvodnej formulácii, scénar kontroly vychádza nasledovne:
- Zaznamenanie údajov. Náhodne vygenerovať počiatočnú sieť veľkosti n. Aby sa viac priblížila "reálnemu svetu", počet priateľov každého používateľa bude tiež náhodná veličina. Zmerať čas, za ktorý naša „podmienečná aplikácia“ zapíše do HBase všetky vygenerované údaje. Potom získaný čas rozdeliť na celkový počet pridaných priateľov – tak získame priemerný čas na jednu „biznis-operáciu“.
- Čítanie údajov. Pre každého používateľa zostaviť zoznam „identít“, pre ktoré je potrebné získať odpoveď, či je používateľ na nich prihlásený alebo nie. Dĺžka zoznamu = približne počet priateľov používateľa, pričom pre polovicu kontrolovaných priateľov by mala byť odpoveď „Áno“ a pre druhú polovicu – „Nie“. Kontrola sa vykonáva v takom poradí, aby sa odpovede „Áno“ a „Nie“ striedali (to znamená, že v každom druhom prípade budeme musieť prechádzať všetkými stĺpcami riadku pre varianty 1 a 2). Celkový čas kontroly sa následne rozdelí na počet kontrolovaných priateľov, aby sa získala priemerná doba overenia jedného subjektu.
- Odstránenie údajov. Odstrániť u používateľa všetkých priateľov. Pritom poradie odstraňovania je náhodné (to znamená „premiešame“ pôvodný zoznam, ktorý bol použitý na zaznamenávanie údajov). Celkový čas kontroly sa následne rozdelí na počet odstraňovaných priateľov, aby sa získala priemerná doba na jednu kontrolu.
Scenáre je potrebné spustiť pre každú z 5 variantov modelov dát a pre rôzne veľkosti sociálnej siete, aby sme videli, ako sa mení čas s jej rastom. V rámci jedného n spojení v sieti a zoznam používateľov na kontrolu by mali byť, samozrejme, rovnaké pre všetkých 5 variantov.
Pre lepšie pochopenie nižšie uvádzam príklad vygenerovaných údajov pre n= 5. Napísaný „generátor“ poskytuje na výstupe tri slovníky ID-čiek:
- prvý – na vloženie
- druhý – na kontrolu
- tretí – na odstránenie
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # celkom 15 priateľov

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # celkom 18 kontrolovaných subjektov

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # celkom 15 priateľov
Ako možno vidieť, všetky ID väčšie ako 10 000 v slovníku na kontrolu sú práve tie, ktoré určite dajú odpoveď False. Vloženie, kontrola a odstránenie „priateľov“ sa vykonáva presne v uvedenom v slovníku poradí.
Experiment sa konal na notebooku so systémom Windows 10, kde v jednom dockerovom kontajneri bola spustená databáza HBase a v druhom – Python s Jupyter Notebook. Dockeru boli pridelené 2 jadrá CPU a 2 GB operačnej pamäte. Celá logika, ako emulácie práce „podmieneného aplikácie“, tak aj „základný softvér“ na generovanie testovacích údajov a meranie času boli napísané v Pythone. Na prácu s HBase sa používala knižnica , na výpočet hashov (MD5) pre variant 5 – hashlib
S ohľadom na výpočtový výkon konkrétneho laptopu bol experimentálne zvolený spustenie pre n = 10, 30, … 170 – keď celkový čas behu plného cyklu testovania (všetky scenáre pre všetky varianty pre všetky n) bol ešte viac-menej rozumný a zmestil sa do času jednej čajovej prestávky (v priemere 15 minút).
Tu je potrebné urobiť poznámku, že v tomto experimente primárne hodnotíme nie absolútne čísla výkonu. Dokonca aj relatívne porovnanie rôznych dvoch variantov nemusí byť úplne presné. Teraz nás zaujíma práve charakter zmeny času v závislosti od n, keďže s ohľadom na uvedenú konfiguráciu "testovacej stanice" je veľmi ťažké získať časové odhady, "očistené" od vplyvu náhodných a iných faktorov (a ani taká úloha nebola stanovená).
Výsledok experimentu
Prvý test – ako sa mení čas, trávený na vyplnenie zoznamu priateľov. Výsledok – na grafe nižšie.
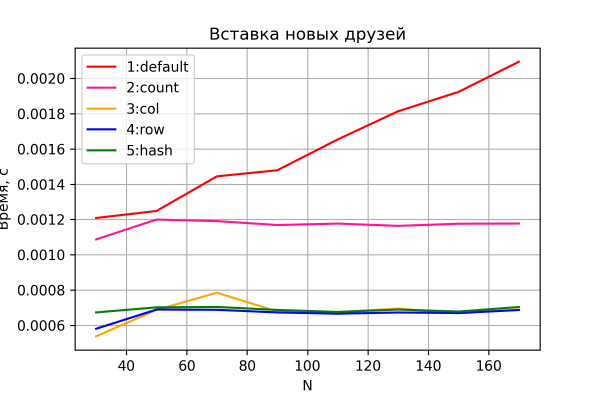
Varianty 3-5 očakávane vykazujú prakticky konštantný čas „biznis-operácie“, ktorý nezávisí od rastu veľkosti siete a nerozlišiteľný rozdiel vo výkone.
Variant 2 taktiež ukazuje konštantný, ale o niečo horší výkon, pričom prakticky presne dvakrát v porovnaní s variantmi 3-5. A to nemôže nepríjemne potešiť, pretože sa to zhoduje s teóriou – v tomto variante je počet operácií vstupu-výstupu do/z HBase presne dvakrát viac. To môže slúžiť ako nepriamy dôkaz, že naše testovacie stanice v zásade poskytujú dobrú presnosť.
Variant 1 sa taktiež očakávane ukazuje ako najpomalší a demonštruje lineárny rast času stráveného na pridávanie priateľa v závislosti od veľkosti siete.
Pozrime sa teraz na výsledky druhého testu.
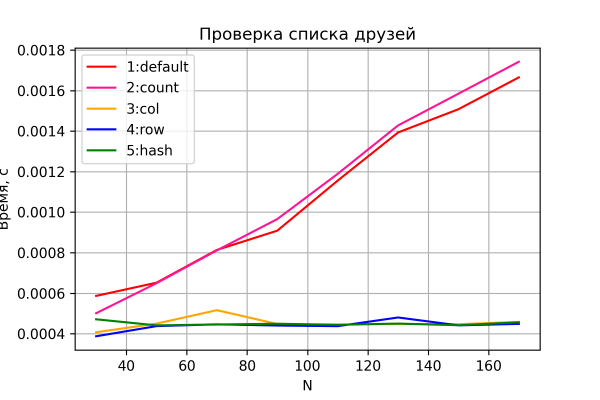
Možnosti 3-5 sa opäť správajú očakávane – konštantný čas, nezávislý od veľkosti siete. Možnosti 1 a 2 vykazujú lineárny nárast času so zvýšením veľkosti siete a podobnú výkonnosť. Možnosť 2 je pritom o niečo pomalšia – zjavne kvôli potrebe čítania a spracovania dodatočného stĺpca „count“, čo sa pri raste n stáva výraznejším. Napriek tomu sa však zdržím akýchkoľvek záverov, pretože presnosť tohto porovnania je relatívne nízka. Okrem toho sa tieto pomery (ktorá možnosť, 1 alebo 2, je rýchlejšia) menili z jedného testu na druhý (pričom si zachovávali charakter závislosti a „idú bok po boku“).
A posledný graf – výsledok testovania odstránenia.
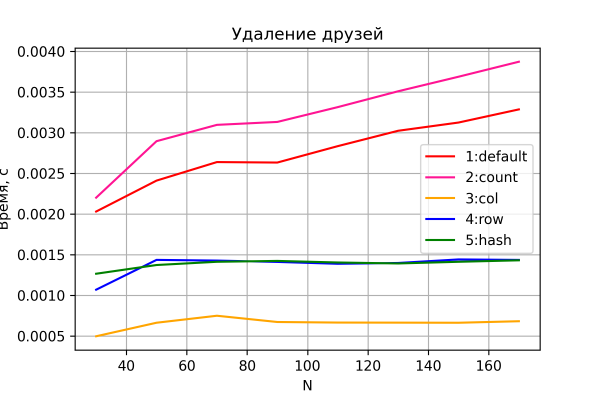
Opäť, žiadne prekvapenia. Možnosti 3-5 vykonávajú odstránenie za konštantný čas.
Zaujímavé je, že možnosti 4 a 5, na rozdiel od predchádzajúcich scenárov, vykazujú o niečo horšiu výkonnosť ako možnosť 3. Zjavne je operácia odstránenia riadku nákladnejšia než operácia odstránenia stĺpca, čo je celkovo logické.
Možnosti 1 a 2, ako sa očakávalo, vykazujú lineárny nárast času. Možnosť 2 je pritom stabilne pomalšia než možnosť 1 – kvôli dodatočnej operácii vstupu/výstupu na „údržbu“ stĺpca count.
Hlavné závery experimentu:
- Možnosti 3-5 vykazujú väčšiu efektivitu, pretože využívajú výhody HBase; ich výkonnosť sa pritom medzi sebou líši o konštantu a nezávisí od veľkosti siete.
- Rozdiel medzi možnosťami 4 a 5 nebol zaznamenaný. To však neznamená, že možnosť 5 by sa nemala používať. Je veľmi pravdepodobné, že použitý experimentálny scenár s ohľadom na technické parametre testovacieho zariadenia neumožnil jeho zistenie.
- Charakter nárastu času potrebného na vykonanie „obchodných operácií“ s dátami vo všeobecnosti potvrdil predtým získané teoretické úvahy pre všetky možnosti.
Epilog
Hrubé experimenty by sa nemali považovať za absolútnu pravdu. Existuje množstvo faktorov, ktoré neboli zohľadnené a spôsobovali skreslenia výsledkov (tieto fluktuácie sú obzvlášť dobre viditeľné na grafoch pri malých veľkostiach sietí). Napríklad rýchlosť fungovania Thrift, ktorý sa používa v HappyBase, objem a spôsob implementácie logiky, ktorú som mal napísanú v Pythone (nechcem tvrdiť, že kód bol napísaný optimálne a efektívne využíval možnosti všetkých komponentov), možno špecifiká cachovania HBase, pozadia Windows 10 na mojom notebooku a podobne. Všeobecne možno považovať, že všetky teoretické úvahy experimentálne ukázali svoju platnosť. Alebo minimálne, ich vyvrátiť takýmto „nárazom do tváre“ sa nepodarilo.
Na záver - odporúčania pre všetkých, ktorí práve začínajú navrhovať modely dát v HBase: abstrahujte od predchádzajúcej práce s relačnými databázami a pamätajte na „prikázania“:
- Pri projektovaní vychádzame z úlohy a šablón manipulácie s dátami, nie z modelu predmetovej oblasti
- Efektívny prístup (bez full table scan) – iba podľa kľúča
- Denormalizácia
- Rôzne riadky môžu obsahovať rôzne stĺpce
- Dynamické zloženie stĺpcov
Zdroj: habr.com
