

Túto jar sme už prediskutovali niektoré úvodné témy, napríklad, a . V druhom z nich sme dokonca prisľúbili pokračovať v skúmaní výkonu rôznych viacdiskových topológií v ZFS. Ide o súborový systém novej generácie, ktorý sa aktuálne zavádza všade: od do .
No čo, dnes je ten najvhodnejší deň na zoznámenie sa so ZFS, zvedaví čitatelia. jednoducho vedzte, že podľa skromného odhadu vývojára OpenZFS Matta Arensa, „je to naozaj zložité“.
Ale predtým, než sa dostaneme k číslam – a tie tu budú, sľubujem – o všetkých variantách osemdiskovej konfigurácie ZFS, musíme sa porozprávať o tom, ako vôbec ZFS uchováva dáta na disku.
Zpool, vdev a device
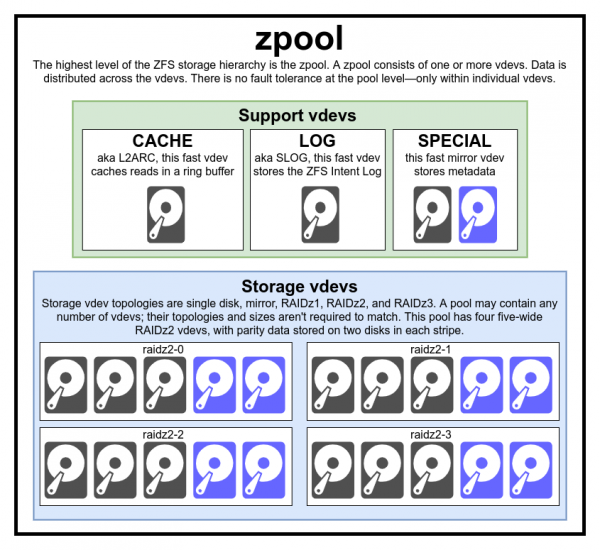
Táto schéma celého poolu obsahuje tri pomocné vdev-y, po jednom z každého typu, a štyri pre RAIDz2
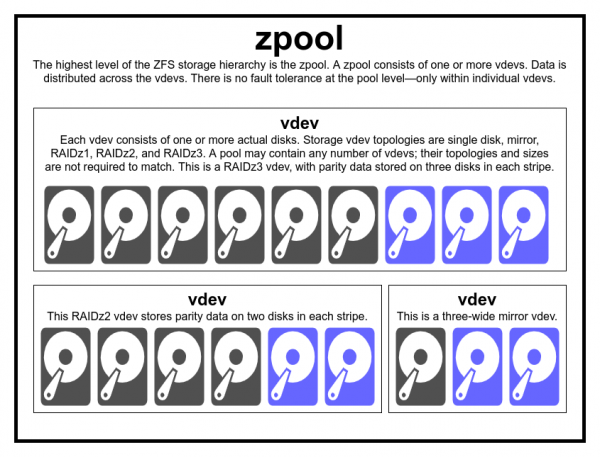
Zvyčajne nie sú dôvody na vytváranie poolu z nekompatibilných typov a veľkostí vdev – ale ak chcete, nič vám nebráni to urobiť
Aby ste naozaj pochopili súborový systém ZFS, musíte sa pozrieť na jeho skutočnú štruktúru. Po prvé, ZFS kombinuje tradičné úrovne správy objemov a súborového systému. Po druhé, používa transakčný mechanizmus kopírovania pri zápise. Tieto vlastnosti znamenajú, že systém je štrukturálne veľmi odlišný od bežných súborových systémov a RAID polí. Prvá sada základných stavebných blokov na pochopenie: je to úložný pool (zpool), virtuálne zariadenie (vdev) a reálne zariadenie (device).
zpool
Úložný pool zpool je najvyššia štruktúra ZFS. Každý pool obsahuje jedno alebo viac virtuálnych zariadení. Tie na oplátku obsahujú jedno alebo viac reálnych zariadení (device). Virtuálne pooly sú samostatné bloky. Jeden fyzický počítač môže obsahovať dva alebo viac samostatných poolov, ale každý je úplne nezávislý od ostatných. Pooly nemôžu zdieľať virtuálne zariadenia.
Redundancia ZFS sa nachádza na úrovni virtuálnych zariadení, a nie na úrovni poolov. Na úrovni poolov nie je absolútne žiadna redundancia – ak sa stratí akékoľvek zariadenie vdev alebo špeciálne vdev, spolu s ním sa stratí aj celý pool.
Súčasné úložné pooly môžu prežiť stratu cache alebo denníka virtuálneho zariadenia — hoci môžu stratiť malé množstvo špinavých údajov, ak stratí denník vdev počas výpadku napájania alebo systému.
Existuje rozšírené zavádzanie, že „údajové pásy“ (stripes) ZFS sú zapisované cez celý pool. To nie je pravda. Zpool nie je len zábavný RAID0, je to skôr zábavný so zložitým premenlivým mechanizmom distribúcie.
Vo väčšine prípadov sú zápisy distribuované medzi dostupné virtuálne zariadenia podľa dostupného voľného miesta, takže teoreticky budú všetky vyplnené súčasne. V novších verziách ZFS sa zohľadňuje aktuálne využitie (utilizácia) vdev — ak je jedno virtuálne zariadenie výrazne zaťažené viac ako iné (napríklad kvôli zaťaženiu pri čítaní), dočasne sa vynechá pre zápis, aj keď má najvyšší koeficient voľného miesta.
Mechanizmus určovania využitia, integrovaný do moderných metód distribúcie zápisu ZFS, môže znížiť latenciu a zvýšiť priepustnosť počas období nezvyčajne vysokého zaťaženia — ale to nie je blank check na neúmyselné miešanie pomalých HDD a rýchlych SSD v jednom poole. Takýto nevyvážený pool bude stále fungovať rýchlosťou najpomalšieho zariadenia, teda akoby bol úplne zložený z takýchto zariadení.
vdev
Každý úložný pool pozostáva z jedného alebo viacerých virtuálnych zariadení (virtual device, vdev). Každé vdev na druhej strane zahŕňa jedno alebo viac skutočných zariadení. Väčšina virtuálnych zariadení sa používa na jednoduché úložisko dát, ale existuje niekoľko pomocných tried vdev, vrátane CACHE, LOG a SPECIAL. Každý z týchto typov vdev môže mať jednu z piatich topológií: jediné zariadenie (single-device), RAIDz1, RAIDz2, RAIDz3 alebo zrkadlo (mirror).
RAIDz1, RAIDz2 a RAIDz3 sú špeciálne typy toho, čo starí nazývajú RAID s dvojitou (diagonálnou) paritou. 1, 2 a 3 sa vzťahujú na počet blokov parít, ktoré sú pridelené pre každý pruh dát. Namiesto samostatných diskov na zabezpečenie parity virtuálne RAIDz zariadenia rovnomerne rozdeľujú túto paritu na disky. RAIDz pole môže stratiť toľko diskov, koľko má blokov parít; ak stratí ešte jeden, zlyhá a odnesie so sebou úložný pool.
Vo zrkadlovo virtuálnych zariadeniach (mirror vdev) sa každý blok ukladá na každé zariadenie v vdev. Hoci najbežnejšie sú dvojité zrkadlá (two-wide), v zrkadle môže byť akékoľvek ľubovoľné množstvo zariadení — vo veľkých inštaláciách na zvýšenie výkonu čítania a odolnosti proti zlyhaniu sa často používajú trojité. Zrkadlo vdev môže prežiť akékoľvek zlyhanie, pokiaľ funguje aspoň jedno zariadenie v vdev.
Jednotlivé vdev sú z podstaty nebezpečné. Takéto virtuálne zariadenie neprežije žiadne zlyhanie — a ak sa používa ako úložisko alebo špeciálne vdev, jeho zlyhanie spôsobí zničenie celého poolu. Buďte tu veľmi, veľmi opatrní.
Virtuálne zariadenia CACHE, LOG a SPECIAL môžu byť vytvorené v akejkoľvek z uvedených topológií — ale pamätajte, že strata virtuálneho zariadenia SPECIAL znamená stratu poolu, preto sa dôrazne odporúča redundantná topológia.
device
Toto je pravdepodobne najjednoduchší termín na pochopenie v ZFS — je to doslova blokové zariadenie s náhodným prístupom. Pamätajte, že virtuálne zariadenia sa skladajú z jednotlivých zariadení a pool je zložený z virtuálnych zariadení.
Disky — magnetické alebo solid-state — sú najbežnejšie blokové zariadenia, ktoré sa používajú ako stavebné bloky vdev. Avšak akékoľvek zariadenie s deskriptorom v /dev je vhodné — takže ako jednotlivé zariadenia môžu byť použité celé hardwarové RAID polia.
Jednoduchý raw súbor je jedným z najdôležitejších alternatívnych blokových zariadení, z ktorých môže byť vdev postavený. Testovacie pooly z sú veľmi pohodlným spôsobom, ako testovať príkazy poolu a vidieť, koľko miesta je k dispozícii v poole alebo virtuálnom zariadení danej topológie.
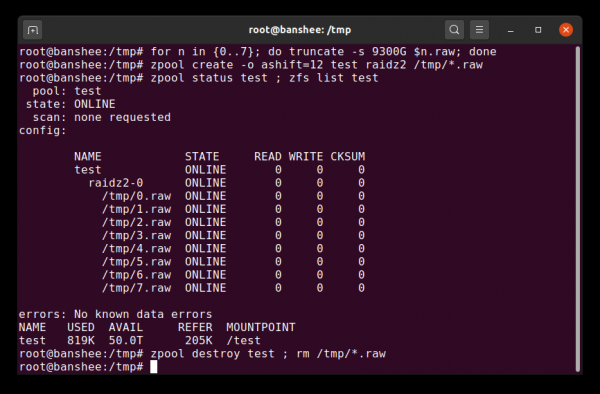
Môžete vytvoriť testovací pool zo zdieľaných súborov len za niekoľko sekúnd — ale nezabudnite neskôr odstrániť celý pool a jeho komponenty.
Predpokladajme, že chcete nastaviť server s ôsmymi diskami a plánujete použiť disky s kapacitou 10 TB (~9300 GiB) — ale nie ste si istí, ktorá topológia najlepšie vyhovuje vašim potrebám. V predchádzajúcom príklade vytvárame testovací pool zo zdieľaných súborov len za niekoľko sekúnd — a teraz vieme, že RAIDz2 vdev z ôsmich diskov s kapacitou 10 TB poskytuje 50 TiB využiteľnej kapacity.
Ďalšou špeciálnou triedou zariadení sú SPARE (náhradné). Zariadenia na horúcu výmenu, na rozdiel od bežných zariadení, patria celému poolu, nie jednému virtuálnemu zariadeniu. Ak nejaký vdev v poole zlyhá a náhradné zariadenie je pripojené k poolu a dostupné, automaticky sa pripojí k postihnutému vdev.
Po pripojení k postihnutému vdev náhradné zariadenie začína dostávať kópie alebo rekonštrukcie dát, ktoré by mali byť na chýbajúcom zariadení. V tradičnom RAID sa tomu hovorí obnova (rebuilding) a v ZFS to je "obnova redundancie" (resilvering).
Je dôležité poznamenať, že náhradné zariadenia trvale nenahrádzajú zlyhané zariadenia. To je len dočasná náhrada na skrátenie času, počas ktorého je vdev v degradovanom stave. Po tom, čo administrátor nahradí zlyhané zariadenie vdev, dôjde k obnove redundancie na toto trvalé zariadenie a SPARE sa odpojí od vdev a vráti sa k práci ako náhradný pre celý pool.
Sady dát, bloky a sektory
Ďalší súbor základných blokov, ktoré treba pochopiť v našej ceste cez ZFS, sa netýka toľko hardvéru, ako skôr toho, ako sú samotné dáta organizované a uložené. Prechádzame tu niekoľkými úrovňami — ako je metaslab — aby sme nezavádzali detaily a zachovali porozumenie celkovej štruktúre.
Súbor dát (dataset)
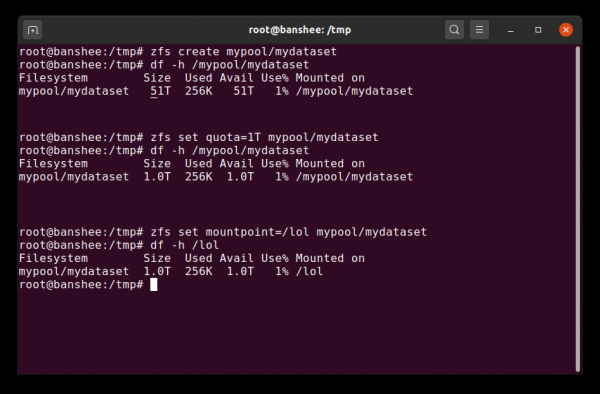
Keď prvýkrát vytvoríme súbor dát, zobrazuje všetok dostupný priestor poolu. Potom nastavíme kvótu — a meníme montážny bod. Čarovné!
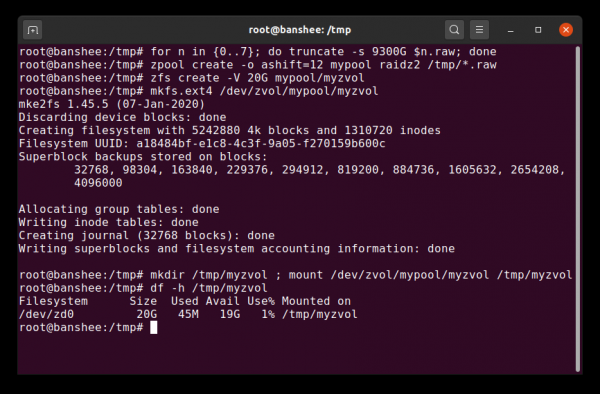
Zvol je v podstate len súbor dát bez svojej vrstvy súborového systému, ktorú tu nahrádzame úplne normálnym súborovým systémom ext4.
Dataset ZFS je približne rovnaký ako štandardný pripojený súborový systém. Rovnako ako bežný súborový systém, na prvý pohľad sa zdá, že je to "len ďalšia priečinok". Ale, ako v bežných pripojených súborových systémoch, každý dataset ZFS má svoj vlastný súbor základných vlastností.
Predovšetkým môže mať dataset stanovenú kvótu. Ak nastavíte zfs set quota=100G poolname/datasetname, nebudete môcť zapisovať do pripojenej priečinka /poolname/datasetname viac ako 100 GiB.
Všimli ste si prítomnosť – aj neprítomnosť – lomítok na začiatku každého riadku? Každý dataset má svoje miesto ako v hierarchii ZFS, tak aj v hierarchii systémového pripojenia. V hierarchii ZFS nie je vedúce lomítko – začínate s názvom poolu a potom smerujete od jedného datasetu k druhému. Napríklad, pool/parent/child pre dataset s názvom child pod rodičovským datasetom parent v puli s kreatívnym názvom pool.
Predvolene, bod pripojenia datasetu bude ekvivalentný jeho názvu v hierarchii ZFS, so zlomeným lomítkom na začiatku – pool s názvom pool bude pripojený ako /pool, dataset parent sa pripojí do /pool/parent, a dcérsky dataset child sa pripojí do /pool/parent/child. Môžete však zmeniť systémový bod pripojenia datasetu.
Ak uvedieme zfs set mountpoint=/lol pool/parent/child, dataset pool/parent/child sa pripojí do systému ako /lol.
Okrem datasetov by sme mali spomenúť aj objemy (zvols). Objem je približne rovnaký ako dataset, s výnimkou toho, že v ňom prakticky nie je súborový systém - je to len blokové zariadenie. Môžete napríklad vytvoriť zvol s názvom mypool/myzvol, potom ho naformátovať so súborovým systémom ext4 a následne pripojiť tento súborový systém - teraz máte súborový systém ext4, ale s podporou všetkých funkcií zabezpečenia ZFS! Môže to vyzerať hlúpo na jednom počítači, ale má to omnoho väčší zmysel ako backend pri exporte zariadenia iSCSI.
Bloky
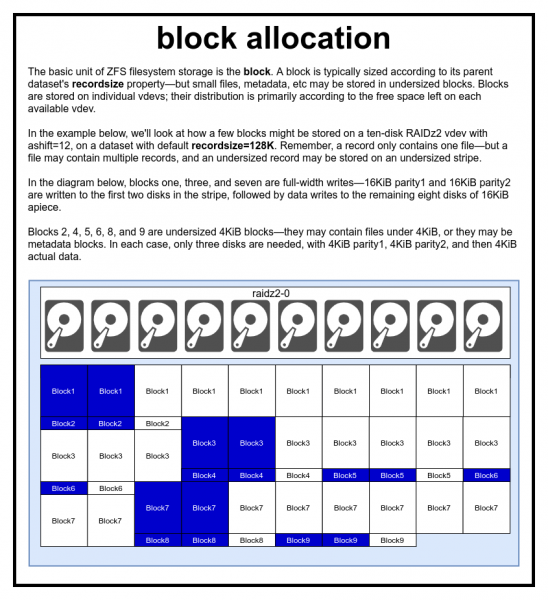
Súbor je reprezentovaný jedným alebo viacerými blokmi. Každý blok je uložený na jednom virtuálnom zariadení. Veľkosť bloku je zvyčajne rovná parametru recordsize, ale môže byť znížená na 2^ashift, ak obsahuje metadata alebo malý súbor.
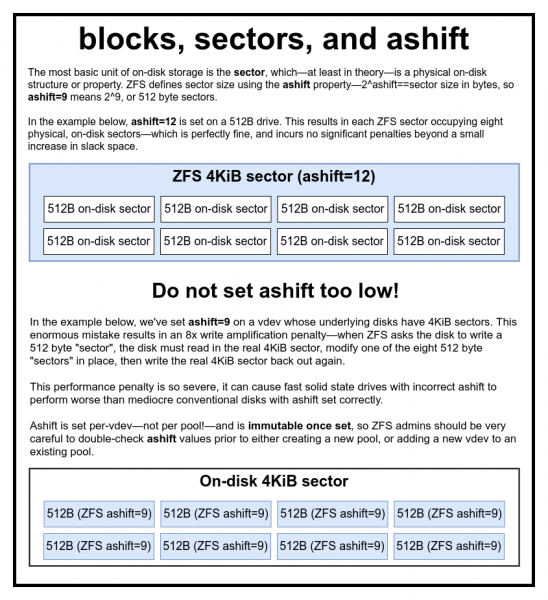
Naozaj, naozaj nežartujeme o obrovskom poškodení výkonu, ak nastavíte príliš malý ashift.
V ZFS pool sú všetky údaje, vrátane metadát, uložené v blokoch. Maximálna veľkosť bloku pre každý dataset je určená v vlastnosti recordsize (veľkosť zápisu). Veľkosť zápisu sa môže meniť, ale to nezmení veľkosť ani umiestnenie žiadnych blokov, ktoré už boli zapísané do datasetu – platí to len pre nové bloky pri ich zápise.
Ak nie je určené inak, aktuálna predvolená veľkosť zápisu je 128 KiB. Ide o akýsi zložitý kompromis, pri ktorom výkonnosť nebude ideálna, ale ani hrozná vo väčšine prípadov. Recordsize môže byť nastavená na akúkoľvek hodnotu od 4K do 1M (s ďalšími nastaveniami recordsize môže byť nastavená ešte vyššie, ale to zriedka býva dobrý nápad).
Každý blok odkazuje na údaje len jedného súboru – nemôžete natlačiť dva rôzne súbory do jedného bloku. Každý súbor sa skladá z jedného alebo viacerých blokov, v závislosti od veľkosti. Ak je veľkosť súboru menšia ako veľkosť zápisu, uloží sa v bloku menšej veľkosti – napríklad blok so súborom 2 KiB zaberie len jeden sektor 4 KiB na disku.
Ak je súbor dostatočne veľký a vyžaduje niekoľko blokov, všetky záznamy s týmto súborom budú mať veľkosť recordsize – vrátane posledného záznamu, jehož hlavná časť sa môže ukázať .
Voly zvol nemajú vlastnosť recordsize – namiesto toho majú ekvivalentnú vlastnosť volblocksize.
Sekundy
Posledný, najzákladnejší stavebný blok – sektor. Toto je najmenšia fyzická jednotka, ktorá môže byť zapísaná alebo čítaná z fyzického zariadenia. Po celé desaťročia sa na väčšine diskov používali sektory po 512 bajtoch. V poslednom čase je väčšina diskov nastavená na sektory 4 KiB a v niektorých – najmä SSD – sektory 8 KiB alebo dokonca viac.
V systéme ZFS existuje vlastnosť, ktorá umožňuje ručne nastaviť veľkosť sektora. Táto vlastnosť ashift. Celkom zložité, že ashift je mocnina dvoch. Napríklad, ashift=9 znamená veľkosť sektora 2^9, alebo 512 bajtov.
ZFS žiada od operačného systému podrobné informácie o každé blokové zariadenie, keď je pridané do nového vdev, a teoreticky automaticky nastavuje ashift správne na základe týchto informácií. Bohužiaľ, mnohé disky klamú o svojej veľkosti sektora, aby zachovali kompatibilitu s Windows XP (ktorá bola neschopná pochopiť disky s inými veľkosťami sektorov).
To znamená, že správca ZFS by mal dôkladne poznať skutočnú veľkosť sektora svojich zariadení a manuálne nastaviť ashift. Ak je nastavený príliš malý ashift, astronomicky sa zvyšuje počet operácií čítania/zápisu. Takže zápis 512-bytových „ sektorov“ do skutočného sektora 4 KiB znamená potrebu zapísať prvý „ sektor“, potom prečítať sektor 4 KiB, zmeniť ho druhým 512-bytovým „ sektorom“, zapísať ho späť do nového sektora 4 KiB a tak ďalej pre každý zápis.
V reálnom svete takýto trest zasahuje do pevných diskov Samsung EVO, pre ktoré by mal platiť ashift=13, ale tieto SSD klamú o svojej veľkosti sektora, a preto je predvolene nastavený ashift=9. Ak skúsený systémový administrátor tento parameter nezmení, tak tento SSD pracuje pomalšie ako bežný magnetický HDD.
Na porovnanie, za príliš veľkú veľkosť ashift neexistuje prakticky žiadny trest. Skutočné zníženie výkonu neexistuje a zvýšenie nevyužitého priestoru je nekonečne malé (alebo nulové pri zapnutom kompresii). Preto dôrazne odporúčame aj pre tie disky, ktoré skutočne používajú 512-bytové sektory, nastaviť ashift=12 alebo aj ashift=13, aby ste sa mohli s dôverou pozerať do budúcnosti.
Vlastnosť ashift sa nastavuje pre každé virtuálne zariadenie vdev, a nie pre pool, ako mnohí mylne predpokladajú – a nemení sa po nastavení. Ak ste náhodou narušili ashift pri pridávaní nového vdev do poolu, tak ste nenávratne znečistili tento pool zariadením s nízkym výkonom a spravidla niet inej cesty, len zničiť pool a začať všetko odznova. Ani odstránenie vdev nezachráni pred zmeneným nastavením ashift!
Mechanizmus kopírovania pri zápise
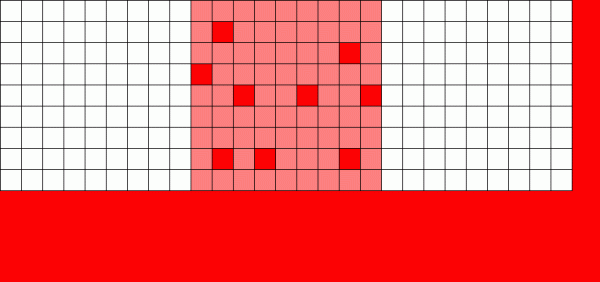
Ak bežný súborový systém musí prepísať dáta - mení každý blok tam, kde sa nachádza.
Súborový systém s kopírovaním pri zápise zapisuje novú verziu bloku a potom odomkne starú verziu.
V abstraktnom poňatí, ak ignorujeme reálne fyzické umiestnenie blokov, sa naša „kométa dát“ zjednodušuje na „čítač dát“, ktorý sa pohybuje zľava doprava po mape dostupného priestoru.
Teraz máme dobrú predstavu o tom, ako fungujú snímky kopírovania pri zápise — každý blok môže patriť viacerým snímkam a zachová sa, pokiaľ nebudú zničené všetky súvisiace snímky.
Mechanizmus kopírovania pri zápise (Copy on Write, CoW) je základnou základňou toho, čo robí ZFS tak úžasným systémom. Hlavná myšlienka je jednoduchá — ak požiadate tradičný súborový systém o zmenu súboru, urobí presne to, čo ste požiadali. Ak požiadate súborový systém s kopírovaním pri zápise o to isté, povie vám „dobre“ — ale zavádza vás.
Namiesto toho súborový systém s kopírovaním pri zápise zapisuje novú verziu zmeneného bloku a potom aktualizuje metadáta súboru, aby prerušením väzby na starý blok spojil nový blok, ktorý ste práve zapísali.
Odpojenie starého bloku a spojenie nového sa vykonáva v jednej operácii, takže ju nemožno prerušiť — ak vypnete napájanie po tom, čo sa to stane, máte novú verziu súboru, a ak vypnete napájanie skôr, tak máte starú verziu. V každom prípade v súborovom systéme nedôjde ku konfliktom.
Kopírovanie pri zápise v ZFS sa deje nielen na úrovni súborového systému, ale aj na úrovni správy diskov. To znamená, že ZFS nie je vystavený medzere pri zápise () — fenoménu, kdy páska bola len čiastočne zapísaná pred zlyhaním systému, s poškodením poľa po reštarte. Tu sa páska zapisuje atómovo, vdev je vždy konzistentný, a .
ZIL: žurnál úmyslov ZFS.
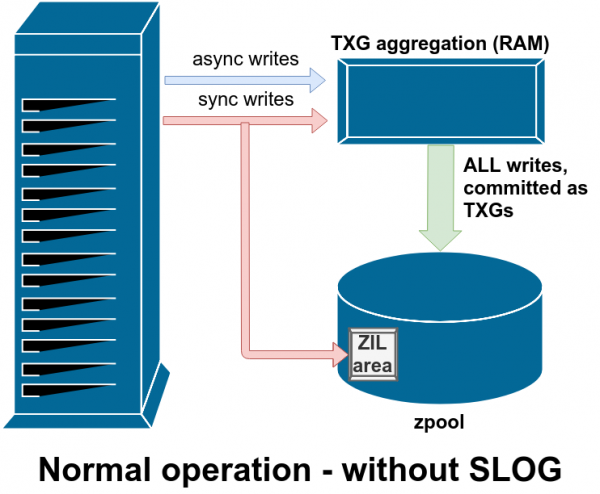
Systém ZFS spracováva synchronné zápisy osobitným spôsobom — dočasne, ale okamžite ich ukladá do ZIL, predtým než ich neskôr zapíše trvalo spolu s asynchrónnymi zápisami.
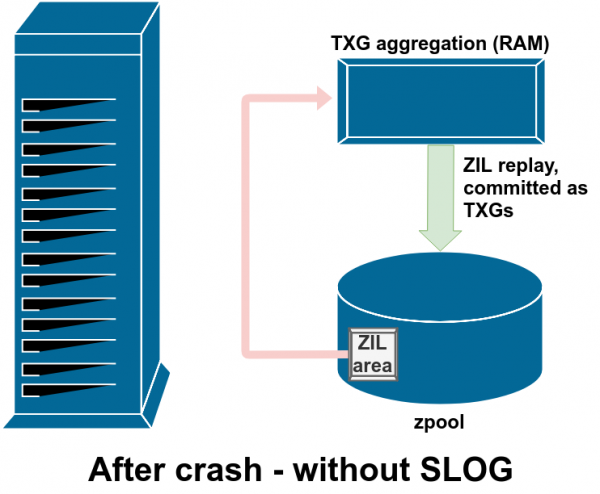
Zvyčajne sa údaje zapísané do ZIL už nikdy nečítajú. Ale to je možné po zlyhaní systému.
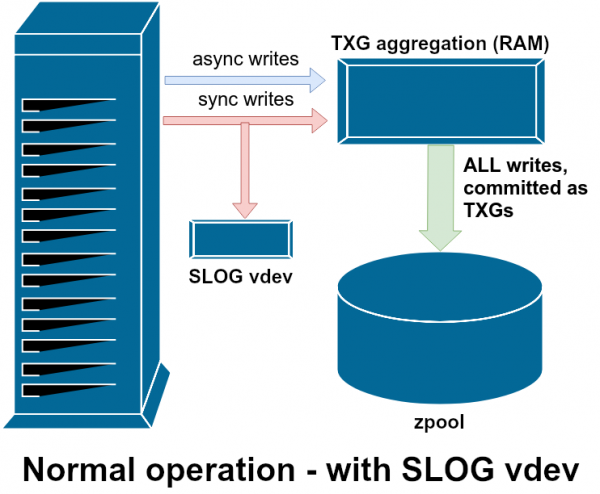
SLOG, alebo sekundárne LOG zariadenie, je jednoducho špeciálny – a, ak je to možné, veľmi rýchly – vdev, kde môže ZIL byť uložený oddelene od hlavného úložiska.
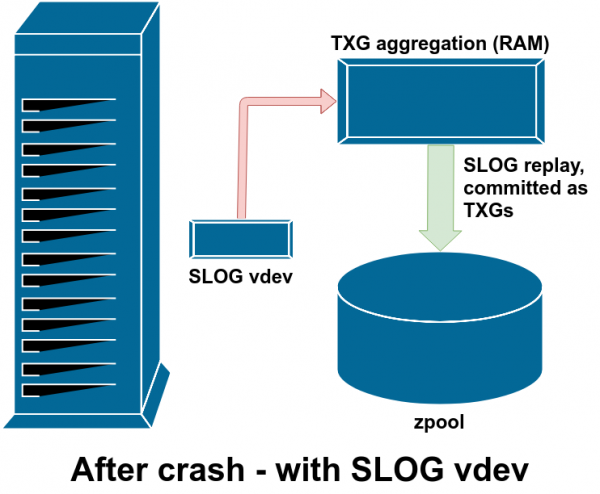
Po zlyhaní sa všetky nepresné údaje v ZIL obnovujú – v tomto prípade je ZIL na SLOG, takže sa obnovujú práve odtiaľ.
Existujú dve hlavné kategórie zapisovacích operácií – synchronné (sync) a asynchronné (async). Pre väčšinu pracovných záťaží je prevažná väčšina zapisovacích operácií asynchronných – súborový systém umožňuje ich agregáciu a vydávanie v dávkach, čím sa znižuje fragmentácia a značne zvyšuje priepustnosť.
Synchronné zápisy sú úplne iná vec. Keď aplikácia požaduje synchronný zápis, hovorí súborovému systému: „Musíš to zafixovať v nevolatile pamäti práve teraz. práve teraz., a dovtedy nemôžem urobiť nič iné.“ Preto musia byť synchronné zápisy okamžite zafixované na disku – a ak to zvyšuje fragmentáciu alebo znižuje priepustnosť, tak to bude.
ZFS spracováva synchronné zápisy inak ako bežné súborové systémy – namiesto okamžitého záznamu do bežného úložiska ZFS ich fixuje v špeciálnej oblasti ukladania nazývanej ZFS Intent Log, alebo ZIL. Trik je v tom, že tieto zápisy takisto ostávajú v pamäti, pričom sú agregované spolu s bežnými asynchronnými zápismi, aby mohli byť neskôr zapsané do úložiska ako úplne normálne TXG (skupiny transakcií, Transaction Groups).
V normálnom režime ZIL zapisuje a nikdy sa potom nečíta. Keď sa po niekoľkých momentoch zápisy z ZIL fixujú do hlavného úložiska v bežných TXG z operačnej pamäte, sú oddelené od ZIL. Jediný čas, kedy sa niečo číta z ZIL, je pri importe poolu.
Ak dôjde k zlyhaniu ZFS – zlyhaniu operačného systému alebo prerušenie napájania – keď sú v ZIL údaje, tieto údaje budú prečítané pri nasledujúcom importe poolu (napríklad pri reštartovaní havarijného systému). Všetko, čo je v ZIL, bude prečítané, zlúčené do TXG skupín, zafixované do hlavného úložiska a potom oddelené od ZIL v procese importu.
Jednou z pomocných tried vdev sa nazýva LOG alebo SLOG, sekundárne zariadenie LOG. Jeho úlohou je poskytnúť pulu samostatné a, ideálne, oveľa rýchlejšie, s veľmi vysokou odolnosťou proti zápisu, zariadenie vdev na ukladanie ZIL, namiesto uchovávania ZIL na hlavnom úložisku vdev. Samotný ZIL sa správa rovnako nezávisle od miesta uloženia, ale ak má vdev s LOG veľmi vysoký výkon zápisu, synchronizované zápisy sa uskutočnia rýchlejšie.
Pridanie vdev s LOG do pulu nijako nemôže zlepšiť výkon asynchrónneho zápisu - aj keď nútene vykonávate všetky zápisy do ZIL pomocou zfs set sync=always, aj tak budú viazané na hlavné úložisko v TXG rovnakým spôsobom a rovnakou rýchlosťou ako bez denníka. Jediným priamym zlepšením výkonu je latencia synchronizovaného zápisu (keďže vyššia rýchlosť denníka zrýchľuje vykonávanie operácií. sync).
Avšak v prostredí, ktoré už vyžaduje veľa synchronizovaných zápisov, môže vdev LOG nepriamo urýchliť asynchrónny zápis a nekacované čítanie. Presunutie zápisov ZIL do oddeleného vdev LOG znamená menšiu konkurenciu za IOPS v primárnom úložisku, čo do istej miery zlepšuje výkon všetkých operácií čítania a zápisu.
Snímky
Mechanizmus copy-on-write je tiež nevyhnutným základom pre atomárne okamžité snímky ZFS a inkrementálnu asynchrónnu replikáciu. V aktívnom súborovom systéme existuje strom ukazovateľov, ktorý označuje všetky zápisy s aktuálnymi údajmi - keď vytvárate snímku, jednoducho vytvárate kópiu tohto stromu ukazovateľov.
Keď sa v aktívnom súborovom systéme prepíše zápis, ZFS najprv zapíše novú verziu bloku do nepoužitého priestoru. Potom odpojí starú verziu bloku od aktuálneho súborového systému. Ale ak sa na nejakú snímku odkazuje na starý blok, ten zostáva nezmenený. Starý blok sa v skutočnosti nebude obnovovať ako voľný priestor, kým nebudú zničené všetky snímky, ktoré odkazujú na tento blok!
Replikácia
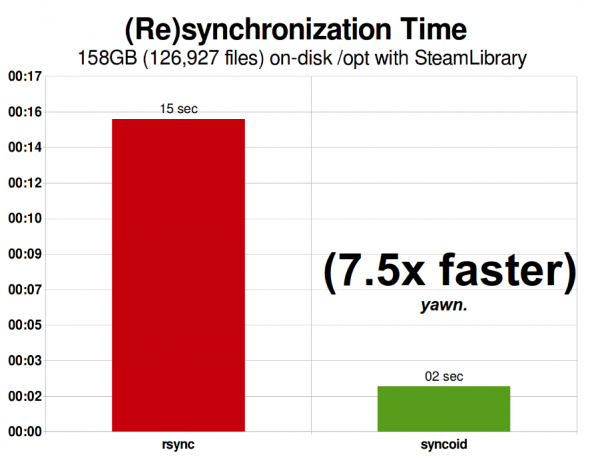
Moja knižnica Steam v roku 2015 zaberala 158 GiB a obsahovala 126 927 súborov. To je dosť blízko k optimálnej situácii pre rsync - replikácia ZFS po sieti bola "iba" o 750% rýchlejšia.
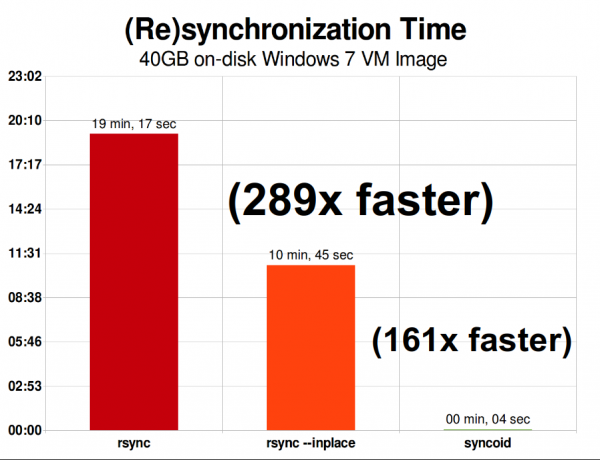
V rovnakej sieti je replikácia jedného 40-gigabajtového súboru obrazu virtuálneho stroja Windows 7 úplne iný príbeh. Replikácia ZFS prebieha 289-krát rýchlejšie ako rsync – alebo "len" 161-krát rýchlejšie, ak viete, ako zavolať rsync s kľúčom --inplace.
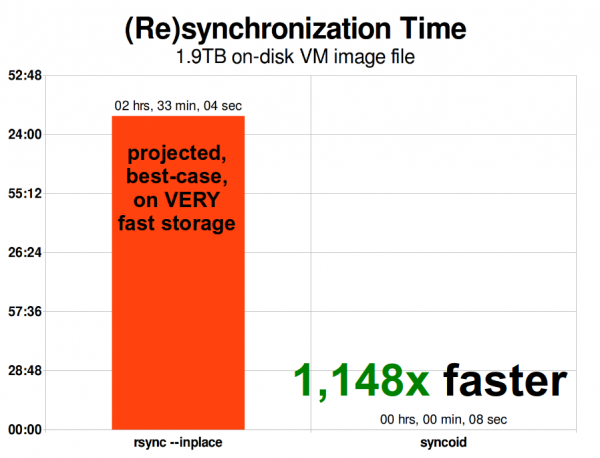
Keď sa obraz virtuálneho stroja zvyšuje, problémy s rsyncom sa zvyšujú spolu s ním. Veľkosť 1,9 TiB nie je taká veľká pre moderný obraz virtuálneho stroja – ale je dosť veľká na to, aby replikácia ZFS bola 1148-krát rýchlejšia ako rsync, aj keď použijete argument rsync --inplace.
Hneď, ako pochopíte, ako fungujú snímky, nebude ťažké pochopiť podstatu replikácie. Pretože snímka je len strom ukazovateľov na záznamy, vyplýva z toho, že ak robíme zfs send snímku, posielame tento strom aj všetky súvisiace záznamy. Keď tento zfs send v zfs receive posielame na cieľový objekt, zapisuje ako skutočný obsah bloku, tak aj strom ukazovateľov odkazujúcich na bloky do cieľového dátového súboru.
Všetko sa stáva ešte zaujímavejším na druhom zfs send. Teraz máme dva systémy, z ktorých každý obsahuje poolname/datasetname@1, a odoberáte novú snímku poolname/datasetname@2. Preto vo zdrojovom poole máte datasetname@1 a datasetname@2, zatiaľ čo v cieľovom poole je zatiaľ iba prvá snímka. datasetname@1.
Keďže medzi zdrojom a cieľom máme spoločnú snímku, môžeme vykonať datasetname@1inkrementálnu nad ňou. Keď hovoríme systému zfs send zfs send -i poolname/datasetname@1 poolname/datasetname@2 , porovnáva dva stromy ukazovateľov. Akékoľvek ukazovatele, ktoré existujú iba v, zjavne odkazujú na nové bloky – preto budeme potrebovať obsah týchto blokov. @2V vzdialenom systéme je spracovanie inkrementálneho
send rovnaké jednoduché. Najprv zapíšeme všetky nové záznamy zahrnuté v prúde , a potom pridávame ukazovatele na tieto bloky. Voilà, máme rovnaké jednoduché. Najprv zapíšeme všetky nové záznamy zahrnuté v prúdev novom systéme! @2 Asynchrónna inkrementálna replikácia ZFS je obrovské zlepšenie v porovnaní s skoršími metódami, ktoré nie sú založené na snímkach, ako je rsync. V oboch prípadoch sa prenášajú len zmenené údaje – ale rsync musí najskôr
prečítať prečítať z disku všetky údaje z oboch strán, aby sa skontroloval súčet a porovnal. Na rozdiel od toho, replikácia ZFS nečíta nič iné ako stromy ukazovateľov – a akékoľvek bloky, ktoré nie sú zastúpené vo všeobecnom snímke.
Zabudovaná kompresia
Mechanizmus kopírovania pri zápise tiež zjednodušuje systém zabudovanej kompresie. V tradičnej súborovej systéme je kompresia problematická – ako stará verzia, tak aj nová verzia zmenených údajov sa nachádzajú v rovnakom priestore.
Ak sa pozrieme na fragment údajov v strede súboru, ktorý začína svoj život ako megabajt núl od 0x00000000 a tak ďalej – veľmi ľahko sa dá stlačiť do jedného sektora na disku. Ale čo sa stane, ak tento megabajt núl nahradíme megabajtom nescompressibilných údajov, ako JPEG alebo pseudonáhodný šum? Zrazu tento megabajt údajov bude potrebovať nie jeden, ale 256 sektorov po 4 KiB, a na tomto mieste na disku je rezervovaný iba jeden sektor.
ZFS nemá tento problém, pretože zmenené záznamy sú vždy zapisované do nevyužitého priestoru – pôvodný blok zaberá iba jeden sektor 4 KiB, a nový záznam zaberie 256, ale to nie je problém – nedávno zmenený fragment zo "stredu" súboru by bol zapísaný do nevyužitého priestoru bez ohľadu na to, či sa jeho veľkosť zmenila alebo nie, takže pre ZFS je to celkom bežná situácia.
Zabudovaná kompresia ZFS je predvolene vypnutá, a systém ponúka pripojiteľné algoritmy – medzi nimi LZ4, gzip (1-9), LZJB a ZLE.
- LZ4 – je prúdový algoritmus, ktorý ponúka mimoriadne rýchlu kompresiu a dekompresiu a výhody v oblasti výkonu pre väčšinu prípadov použitia – aj na pomerne pomalých CPU.
- GZIP – vážený algoritmus, ktorý poznajú a milujú všetci používatelia systémov Unix. Môže byť realizovaný s úrovňami kompresie 1-9, pričom zvyšovanie stupňa kompresie a využitia CPU sa zvyšuje s priblížením sa k úrovni 9. Algoritmus sa dobre hodí pre všetky textové (alebo iné mimoriadne komprimovateľné) možnosti použitia, ale v opačnom prípade často spôsobuje problémy s CPU – používajte ho opatrne, najmä na vyšších úrovniach.
- LZJB – pôvodný algoritmus v ZFS. Je zastaraný a nemal by sa používať, LZ4 ho vo všetkých ohľadoch prekonáva.
- ZLE — kódovanie nulového levelu, Zero Level Encoding. Vo všeobecnosti sa nedotýka normálnych údajov, ale komprimuje veľké sekvencie núl. Je užitočné pre úplne nekomprimovateľné súbory dát (napríklad JPEG, MP4 alebo iné už komprimované formáty), pretože ignoruje nekomprimovateľné údaje, ale komprimuje nepoužité miesto v konečných záznamoch.
Odporúčame kompresiu LZ4 prakticky pre všetky varianty použitia; trest za výkon pri stretnutí s nekomprimovateľnými údajmi je veľmi malý, a prírastok výkonu pre typické dáta je značný. Kopírovanie obrazu virtuálneho stroja pre novú inštaláciu operačného systému Windows (čerstvo nainštalovaný OS, vo vnútri ešte žiadne údaje nie sú) s compression=lz4 prebehlo o 27 % rýchlejšie ako s compression=none, v .
ARC – adaptívny náhrady cache
ZFS je jediné známe moderné súborový systém, ktorý používa svoj vlastný mechanizmus cacheovania čítania, a nespolieha sa na cache strán operačného systému na ukladanie kópií nedávno prečítaných blokov v pamäti.
Aj keď vlastná cache nemá svoje problémy – ZFS nemôže reagovať na nové požiadavky na pridelenie pamäte tak rýchlo, ako jadro, a preto nový volanie malloc() na pridelenie pamäte môže zlyhať, ak potrebuje operačnú pamäť, ktorá je v súčasnosti obsadená ARC. Ale existujú presvedčivé dôvody na použitie vlastnej cache, aspoň zatiaľ.
Všetky známe moderné OS, vrátane MacOS, Windows, Linux a BSD, na realizáciu cache strán používajú algoritmus LRU (Least Recently Used). Je to primitívny algoritmus, ktorý posúva cacheovaný blok „nahor v poradí“ po každom čítaní a vytláča bloky „dole v poradí“ podľa potreby, aby pridali nové cache miss (bloky, ktoré mali byť prečítané z disku, a nie z cache) vyššie.
Zvyčajne algoritmus funguje v poriadku, ale v systémoch s veľkými pracovnými sadami dát LRU ľahko vedie k thrashing – vytláčanie často potrebných blokov, aby uvoľnilo miesto pre bloky, ktoré už nikdy nebudú prečítané z cache.
— oveľa menej naivný algoritmus, ktorý sa dá považovať za „vážený“ cache. Po každom prečítaní cacheovanej bloky sa stáva trochu „ťažším“ a ťažšie sa vyhadzuje — a dokonca aj po vyhodení blok je sledovaný po určitý čas. Blok, ktorý bol vyhodený, ale potom musí byť znovu prečítaný do cache, sa tiež stane „ťažším“.
Konečný výsledok tohto všetkého je cache s oveľa vyšším koeficientom zásahov (hit ratio) — pomer medzi zásahmi do cache (čítanie vykonávané z cache) a zlyhaniami (čítanie z disku). Toto je mimoriadne dôležitá štatistika — nie len to, že samotné zásahy do cache sú obsluhované poriadne rýchlejšie, zlyhania cache môžu byť tiež obsluhované rýchlejšie, pretože čím viac zásahov do cache — tým menej paralelných požiadaviek na disk a tým menšia latencia pre tie zostávajúce zlyhania, ktoré musia byť obsluhované z disku.
Záver
Po preskúmaní základnej sémantiky ZFS — ako funguje kopírovanie pri zápise a tiež vzťahy medzi storage poolmi, virtuálnymi zariadeniami, blokmi, sektormi a súbormi — sme pripravení diskutovať o reálnom výkone s reálnymi číslami.
V ďalšej časti sa pozrieme na skutočný výkon poolov so zrkadlovými vdev a RAIDz, porovnáme ich navzájom a tiež s tradičnými RAID topológiami jadra Linuxu, ktoré sme preskúmali .
Najprv sme sa chceli zaoberať iba základmi — samotnými topológiami ZFS — ale potom takého budeme pripravení hovoriť o pokročilejšom nastavení a ladení ZFS, vrátane používania pomocných typov vdev, ako sú L2ARC, SLOG a Special Allocation.
Zdroj: habr.com
