

Prezentácia z roku 2015 od Iľju Kosmodemjanského "Ladenie Linuxu na zlepšenie výkonu PostgreSQL"
Upozornenie: Upozorňujem, že táto prezentácia je datovaná novembrom 2015 — uplynuli viac ako 4 roky, odkedy sa tak stalo. Verzia 9.4, ktorú prezentácia pokrýva, už nie je podporovaná. Po uplynutí 4 rokov vyšlo 5 nových verzií PostgreSQL a 15 verzií jadra Linux. Ak by sa tieto časti prepisovali, nakoniec by to bola úplne iná prezentácia. Ale tu sa zaoberáme základným ladením Linuxu pre PostgreSQL, ktoré je doteraz relevantné.
Volám sa Iľja Kosmodemjanský. Pracujem v spoločnosti PostgreSQL-Consulting. A teraz vám poviem niečo o tom, čo robiť s Linuxom v kontexte databáz všeobecne a PostgreSQL konkrétne, pretože princípy sú dosť podobné.
O čom bude reč? Ak komunikujete s PostgreSQL, do určitej miery je potrebné byť administrátorom UNIX-u. Čo to znamená? Ak porovnáme Oracle a PostgreSQL, v Oracle musíte byť z 80 % DBA databázy a z 20 % administrátorom Linuxu.
S PostgreSQL je to trochu zložitejšie. S PostgreSQL je potrebné mať omnoho lepšie predstavy o tom, ako Linux funguje. A pritom sa musíte trochu snažiť držať krok, pretože v poslednej dobe sa všetko rýchlo aktualizuje. Nové jadrá sa vydávajú, prichádza nový funkčný obsah, výkon sa zlepšuje atď.
Prečo hovoríme o Linuxe? Nie kvôli tomu, že sme na konferencii Linux v Piter, ale preto, že za súčasných podmienok je jedným z najoprávnenejších OS pre prevádzku databáz všeobecne a PostgreSQL konkrétne – Linux. Pretože FreeBSD, žiaľ, sa rozvíja veľmi podivným smerom. A vzniknú problémy ako s výkonom, tak s mnohými ďalšími vecami. Výkon PostgreSQL na Windows – to je úplne iná náročná téma, súvisiaca s tým, že Windows nemá takú zdieľanú pamäť ako UNIX, a u PostgreSQL je to všetko na tom postavené, pretože ide o viacprocesný systém.
A exotika ako Solaris, myslím, zaujíma menšinu, takže poďme ďalej.
So súčasným distribúciou Linuxu je viac ako 1 000 parameterov syctl, v závislosti od toho, ako je jadro zostavené. Ak sa pozrieme ešte na rôzne nastavenia, dá sa to doladiť mnohými spôsobmi. Existujú parametre súborových systémov, ako ich pripojiť. Ak máte otázky, ako spustiť: čo zapnúť v BIOS-e, ako nastaviť hardware atď.
Toto je naozaj veľký objem, o ktorom sa dá hovoriť niekoľko dní, a nie za jeden krátky prejav, ale teraz sa zameriam na dôležité veci, ako sa vyhnúť tým pascám, ktoré určite zabránia dobrej prevádzke databázy na Linuxe, ak ich neopravíte. A pritom je dôležité, že mnohé parametre sú predvolene nastavené na nesprávne hodnoty pre databázu. T. j. z predpokladu bude fungovať zle alebo vôbec.
Aké tradičné ciele ladenia sú v Linuxe? Myslím, že keďže sa všetci zaoberáte administratívou Linuxu, nie je potrebné osobitne vysvetľovať, čo sú ciele.
Môžete ladit:
- CPU.
- Pamäť.
- Uloženie.
- Iné. O tom si povieme na konci, ako dezert. Napríklad aj také parametre, ako politika úspory energie, môžu veľmi nepríjemne a nepredvídateľne ovplyvniť výkon.
Aká je špecifikácia PostgreSQL a databáz vôbec? Problém je v tom, že nie je možné doladiť nejakú jednotlivú skrutku a pozrieť sa, či sa výkon výrazne zlepšil.
Áno, také skrutky existujú, ale databáza je zložitá vec. Interaguje so všetkými zdrojmi, ktoré server má, a uprednostňuje plnú interakciu. Ak sa pozriete na moderné odporúčania spoločnosti Oracle o tom, ako používať hostiteľský operačný systém, bude to ako v anekdote o mongolskom kozmonautovi – nakŕmiť psa a nič s tým nepohybovať. Dáme databáze všetky zdroje, databáza si to sama vyrovná.
Vo všeobecnosti je situácia s PostgreSQL celkom podobná. Rozdiel spočíva v tom, že databáza si nie všetky zdroje dokáže sama vziať, t. j. niekde je potrebné to všetko riešiť na úrovni Linuxu.
Hlavná myšlienka je – nevybrať nejaký jednotný cieľ a začať ho ladit, napríklad pamäť, CPU alebo niečo podobné, ale analyzovať pracovnú záťaž a pokúsiť sa maximálne zlepšiť priepustnosť, aby pre našu databázu prechádzala maximálne efektívne tá záťaž, ktorú nám dobrotiví programátori vytvorili, vrátane našich používateľov.
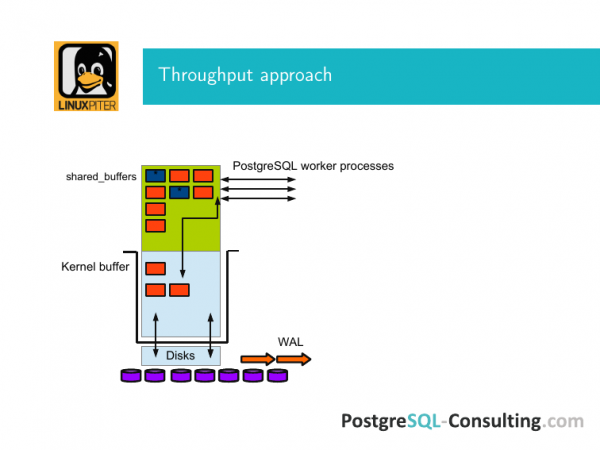
Toto je obrázok na vysvetlenie, čo to znamená. Existuje vyrovnávacia pamäť systému Linux a existuje zdieľaná pamäť a existujú zdieľané vyrovnávacie pamäte PostgreSQL. PostgreSQL na rozdiel od Oraclu pracuje priamo iba cez vyrovnávaciu pamäť jadra, t. j. aby sa stránka z disku dostala do jeho zdieľanej pamäte, musí prejsť cez vyrovnávaciu pamäť jadra a späť, presne rovnaká situácia.
Pod touto systémou sa nachádzajú disky. Nakreslil som to ako disky. V skutočnosti tam môže byť RAID radič a pod.
A tento vstup-výstup sa tak či onak deje cez túto vec.
PostgreSQL je klasická databáza. Dnu sú stránky. A celý vstup-výstup sa deje pomocou stránok. Skrze stránky prenášame bloky do pamäte. A ak sa nič nestalo a jednoducho sme ich prečítali, tak postupne miznú z tohto cache, zo zdieľaných vyrovnávacích pamätí a dostávajú sa späť na disk.
Ak niečo niekde nahradíme, celá stránka sa označuje ako znečistená. Tu som ich označil modrou farbou. To znamená, že táto stránka musí byť synchronizovaná s blokovým úložiskom. T. j. keď sme ju urobili znečistenou, vytvorili sme zápis v WAL. A v nejakom krásnom momente prišlo jav pod názvom checkpoint. A do tohto logu sa zapísala informácia o tom, že prišlo. A to znamená, že všetky znečistené stránky, ktoré tu v tom momente boli v týchto zdieľaných vyrovnávacích pamätiach, sa synchronizovali s diskom úložiska pomocou fsync cez vyrovnávaciu pamäť jadra.
Prečo sa to robí? Ak by sme prišli o napájanie, nemali by sme situáciu, že všetky dáta zmizli. Persistenčná pamäť, o ktorej nám všetci hovorili, to je zatiaľ v teórii databáz – to je svetlá budúcnosť, ku ktorej sa samozrejme snažíme a páči sa nám, ale zatiaľ ešte žijú v mínus 20 rokoch. A samozrejme, za týmto všetkým je potrebné dbať.
A úlohou maximalizácie priepustnosti je doladiť to na všetkých týchto etapách, aby to všetko fungovalo rýchlo. Zdieľaná pamäť je väčšinou stránková vyrovnávacia pamäť. V PostgreSQL sme poslali dotaz select niečo, získal tieto údaje z disku. Dostali sa do zdieľaných vyrovnávacích pamätí. Zodpovedajúcim spôsobom, aby to fungovalo lepšie, musí byť veľa pamäte.
Aby to všechno fungovalo dobře a rychle, musíte správně nastavit operační systém ve všech fázích. A vybrat vyvážený hardware, protože pokud budete mít někde nerovnováhu, můžete mít spoustu paměti, ale bude dostupná s nedostatečnou rychlostí.
Podíváme se na každý z těchto bodů.
Aby tyto stránky cestovaly sem a tam rychleji, je potřeba dosáhnout následujícího:
- Za prvé, je potřeba efektivněji pracovat s pamětí.
- Za druhé, musí být efektivnější přechod, když stránky z paměti přecházejí na disk.
- A za třetí, měly by být kvalitní disky.
Pokud máte 512 GB operační paměti v serveri a všechno to nakonec končí na SATA pevném disku bez jakékoli cache, promění se celý databázový server nejen v dýni, ale v dýni se SATA rozhraním. Budete s tím přímo narazit. A nic vás nezachrání.
Pokud jde o první bod s pamětí, existují tři věci, které mohou život značně zkomplikovat.
První z nich je NUMA. NUMA je koncept, který je navržen pro zlepšení výkonu. V závislosti na pracovním zatížení je možné optimalizovat různé věci. A ve svém novém současném stavu není pro takové aplikace, jako jsou databáze, které intenzivně používají page cache sdílené buffery, moc dobrá.
Stručně řečeno. Jak poznat, že s NUMA není něco v pořádku? Můžete mít nějaké nepříjemné zakolísání, náhle může být nějaký CPU přetížený. Při tom analyzujete dotazy v PostgreSQL a vidíte, že nic podobného tam není. Tyto dotazy by neměly tak intenzivně zatěžovat CPU. Chytat to můžete dlouho. Snazší je od začátku využít správné doporučení, jak nastavit NUMA pro PostgreSQL.
Co se vlastně děje? NUMA je Non-Uniform Memory Access. O co jde? Máte CPU, vedle něj je jeho lokální paměť. A tato paměť může připojovat paměť z jiných CPU.
Pokud spustíte numactl --hardware, dostanete velký výstup. Mezi jiným bude pole distances. Budou tam čísla – 10-20, něco podobného. Tato čísla nejsou nic jiného než počet skoků k připojení této vzdálené paměti a jejímu využití lokálně. V zásadě je to dobrý nápad. To podstatně zrychluje výkon při určitých zatíženích.
Predstavte si, že máte jeden CPU, ktorý najprv skúša využiť svoju lokálnu pamäť, a potom sa snaží získať ďalšiu pamäť cez interconnect na niečo. A na tento CPU sa dostane celý váš page cache PostgreSQL – všetky tie gigabajty. Vždy dostávate najhorší prípad, pretože na CPU je zvyčajne málo pamäte priamo v tomto pamäťovom module. A všetka pamäť, ktorá je obsluhovaná, prechádza cez tieto interconnects. Takže je to pomalé a smutné. A máte procesor, ktorý obsluhuje tento uzol, neustále preťažený. A doba prístupu k tejto pamäti je zlá, pomalá. Toto je situácia, ktorú nechcete, ak používate toto pre databázu.
Preto je lepším riešením pre databázu, aby operačný systém Linux vôbec nevedel, čo sa tam deje. Aby pristupoval k pamäti tak, ako by mal.
Prečo tak? Zdalo by sa, že by to malo byť naopak. To sa deje z jedného jednoduchého dôvodu, že potrebujeme veľa pamäte pre page cache – desiatky, stovky gigabajtov.
A ak sme toto všetko vyhradili a našich dát tam uložili do cache, zisk z používania cache bude podstatne väčší ako zisk z takého zložitých prístupov k pamäti. A týmto spôsobom získame neporovnateľne väčšie výhody, ako keby sme efektívnejšie pristupovali k pamäti pomocou NUMA.
Preto sú tu v súčasnosti dva prístupy, pokiaľ nenastane svetlá budúcnosť a databáza sa sama nenaučí zistiť, na ktorých CPU pracuje a odkiaľ čo potrebuje získať.
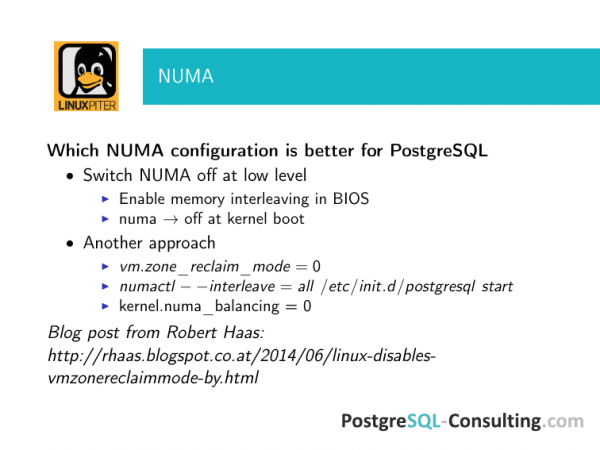
Preto je správny prístup jednoducho vypnúť NUMA, napríklad pri reštartovaní. Vo väčšine prípadov sú zisky také značné, že vôbec nie je otázka, ktorá je lepšia.
Existuje iná možnosť. Tú používame častejšie ako prvú, pretože, keď k nám príde klient na podporu, reštartovať server pre neho je veľká úloha. Jeho podnikanie je tam v činnosti. A problémy spôsobené NUMA zažívajú. Preto sa snažíme vypnúť to menej invazívnymi spôsobmi, ako je reboot, ale tu si dávajte pozor, aby ste skontrolovali, že sa naozaj vypnulo. Pretože, ako ukazuje prax, že pri vypínaní NUMA na rodičovskom procese PostgreSQL je to dobré, ale nie je vôbec zaručené, že to bude fungovať. Je potrebné overiť a pozrieť sa, či sa naozaj vypnulo.
Existuje dobrý príspevok od Roberta Haasa. Je to jeden z vývojárov PostgreSQL a kľúčových autorov všetkých nízkoúrovňových súčastí. Ak sa pozriete na odkazy v tomto príspevku, nájdete tam niekoľko zaujímavých príbehov o tom, ako komplexnosť NUMA komplikovala život. Pozrite sa, preštudujte si kontrolný zoznam pre správcu systému, čo treba nastaviť na serveri, aby naša databáza fungovala správne. Tieto nastavenia by ste mali zaznamenať a kontrolovať, pretože inak to nebude veľmi dobré.
Upozorňujem, že to platí pre všetky nastavenia, o ktorých budem hovoriť. Ale obyčajne sa databázy konfigrujú v režime master-slave pre zabezpečenie dostupnosti. Nezabudnite zahrnúť tieto nastavenia aj na slave, pretože v jeden pekný deň môže dôjsť k havárii a prepnite na slave, ktorý sa stane majstrom.
V havarijnej situácii, keď je všetko zlé, vám neustále zvoní telefón a váš šéf prichádza s veľkým palicou, nebudete mať čas myslieť na to, aby ste to skontrolovali. A výsledky môžu byť dosť žalostné.
Ďalším bodom sú huge pages. Huge pages sa ťažko testujú samostatne, ani to nemá veľký význam, hoci existujú benchmarky, ktoré to dokážu. Tie sa dajú ľahko vyhľadať.
O čo ide? Máte relatívne lacný server s veľkým množstvom operačnej pamäte, napríklad viac než 30 GB. Nepoužívate huge pages. To znamená, že nevyhnutne máte prebytok v používaní pamäte. A tento prebytok nie je práve najpríjemnejší.
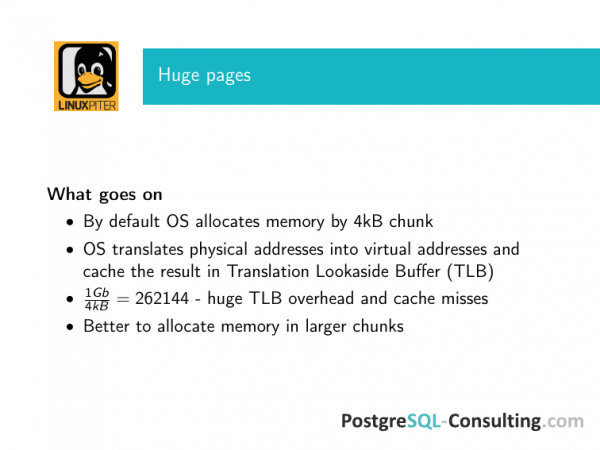
Prečo je to tak? A čo sa deje? Operačný systém prideľuje pamäť na malé kúsky. Je to pohodlné, takto to historicky vzniklo. A ak by sme sa dostali do podrobností, OS musí prekladať virtuálne adresy na fyzické. Tento proces nie je práve najjednoduchší, a preto OS výsledok tejto operácie cacheuje v Translation Lookaside Buffer (TLB).
A pretože TLB je cache, v tejto situácii sa objavujú všetky problémy, ktoré sú s cache spojené. Po prvé, ak máte veľmi veľa operačnej pamäte a všetka je pridelená na malé kúsky, buffer sa stáva veľmi veľkým. A ak je cache veľká, proces vyhľadávania je pomalší. Prebytok je značný a sám o sebe zaberá miesto, tj. operačná pamäť spotrebováva niečo nesprávne. To je prvé.
Dve – čím viac sa v takej situácii zväčšuje cache, tým väčšia je pravdepodobnosť, že budete mať cache misses. A efektivita tejto cache rýchlo klesá s rastom jej veľkosti. Preto v operačných systémoch vymysleli jednoduchý prístup. V Linuxe sa už dávno používa. V FreeBSD sa nedávno objavila. Ale hovoríme o Linuxe. To sú huge pages.
A tu treba poznamenať, že huge pages, ako myšlienka, boli pôvodne presadzované komunitami, ktoré zahŕňali Oracle a IBM, t. j. výrobcovia databáz starostlivo zvažovali, že to bude užitočné, aj pre databázy.
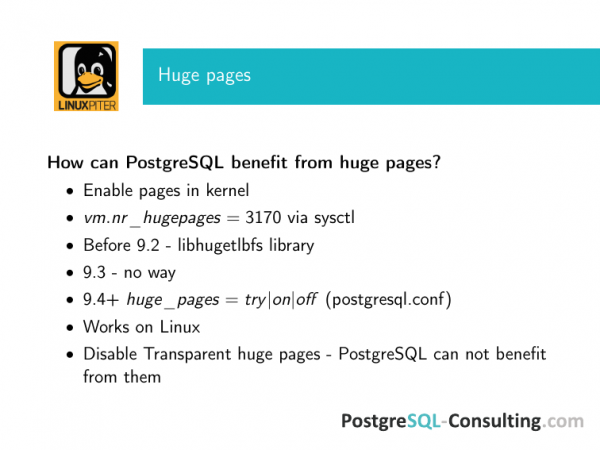
A ako to zladiť s PostgreSQL? Po prvé, v linuxovom jadre musia byť povolené huge pages.
Po druhé, musia byť výslovne uvedené parametrom sysctl – koľko ich je. Čísla sú tu z nejakého starého servera. Môžete si vypočítať, koľko približne máte shared buffers, aby sa huge pages tam zmestili.
A ak je celý server vyhradený pre PostgreSQL, dobrý východiskový bod je buď prerozdeliť 25 % operačnej pamäte na shared buffers, alebo 75 %, ak ste si istí, že do týchto 75 % sa vaša databáza určite zmestí. Prvý východiskový bod. A počítajte, ak máte 256 GB operačnej pamäte, teda 64 GB bude pre shared buffers. Vypočítajte približne s nejakou rezervou – akú hodnotu by ste mali mať nastavenú.
Do verzie 9.2 (ak sa nemýlim, od verzie 8.2) bolo možné pomocou tretej strany knižnice prepojiť PostgreSQL s huge pages. A to je vždy potrebné robiť. Po prvé, potrebujete, aby jadro vedelo správne prideľovať huge pages. A po druhé, aby aplikácia, ktorá s nimi pracuje, mohla využiť tieto stránky. Bez toho to nebude fungovať. Keďže PostgreSQL prideľoval pamäť v štýle system 5, bolo to možné urobiť pomocou libhugetlbfs — to je celé meno knižnice.
V verzii 9.3 sa zvýšil výkon PostgreSQL pri práci s pamäťou a bolo zrušené system 5 metódy prideľovania pamäte. Všetci sa veľmi potešili, pretože inak sa snažíte spustiť dva inštancie PostgreSQL na jednom stroji, a on hovorí, že mi chýba zdieľaná pamäť. A hovorí, že treba opraviť sysctl. A tam je taký sysctl, že treba ešte reštartovať atď. Všeobecne, všetci sa potešili. Ale prideľovanie pamäte mmap rozbilo používanie huge pages. Väčšina našich klientov používa veľké zdieľané buffery. A dôrazne sme odporúčali neprejsť na 9.3, pretože tam overhead začínal v dobrých percentách narastať.
Ale zato komunitná skupina venovala pozornosť tomuto problému a vo verzii 9.4 to veľmi dobre prepracovali. A vo verzii 9.4 sa objavil parameter v postgresql.conf, v ktorom je možné zapnúť try, on alebo off.
Try – je najbezpečnejší parameter. Pri štarte PostgreSQL, keď prideľuje zdieľanú pamäť, sa pokúša získať túto pamäť z huge pages. A ak sa to nepodarí, vráti sa na bežné prideľovanie. A ak máte FreeBSD alebo Solaris, môžete nastaviť try, je to vždy bezpečné.
Ak je on, tak sa proste nespustí, ak sa mu nepodarilo získať pamäť z huge pages. Tu už je to – komu a čo je milšie. Ale ak máte nastavené try, skontrolujte, či ste naozaj dostali to, čo potrebujete, pretože priestor na chyby tam je veľa. Tento funkčný prvok momentálne funguje iba na Linuxe.
Ešte jedno malé uľahčenie, predtým ako pôjdeme ďalej. Transparent huge pages – to zatiaľ nie je o PostgreSQL. Nemôže sa nimi normálne využiť. A pri Transparent huge pages pre taký workload, keď potrebujete veľký kus zdieľanej pamäte, prínosy prichádzajú iba pri veľmi veľkých objemoch. Ak máte terabajty pamäte, potom to môže mať význam. Ak hovoríme o bežných aplikáciách, keď máte 32, 64, 128, 256 GB pamäte na stroji, tak bežné huge pages je v poriadku, a Transparent jednoducho vypneme.
A posledná vec, týkajúca sa pamäte, priamo nesúvisí s priepustnosťou, môže veľmi skomplikovať život. Celá priepustnosť bude veľmi utrpená tým, že server neustále swapuje.
A to bude veľmi nepríjemné v niekoľkých momentoch. Hlavný problém spočíva v tom, že správanie sa moderných jadier mierne líši od starších jadier Linuxu. A toto je niečo, na čo je dosť nepríjemné siahať, pretože keď hovoríme o práci so swapom, končí to nedostatočným príchodom OOM-killera. A OOM-killer, ktorý prišiel neskoro a zabil PostgreSQL, je nepríjemné. O tom sa dozvie každý, t. j. až po posledného používateľa.
Čo sa deje? Máte tam veľa operačnej pamäte, všetko funguje dobre. Ale z nejakého dôvodu server zamrzne v swape a kvôli tomu spomaľuje. Na prvý pohľad sa zdá, že je pamäte dosť, ale takto to prebieha.
Predtým sme odporúčali nastaviť vm.swappiness na nulu, t. j. vypnúť swap. Zdalo sa, že 32 GB operačnej pamäte a zodpovedajúce zdieľané buffery sú ohromujúce množstvo. Hlavný účel swapa je mať miesto, kam vložiť proces, ak sa odpojí. A to už veľmi nefungovalo. A čo potom s týmto procesom spravíte? To je úloha, pri ktorej nie je jasné, prečo je swap potrebný, najmä takého rozmeru.
Ale v modernejších, t. j. v tretej verzii jadra, sa správanie zmenilo. A ak nastavíte swap na nulu, t. j. vypnete ho, skôr alebo neskôr, aj pri zvyšku určitej operačnej pamäte k vám príde OOM-killer, aby zabil najintenzívnejších spotrebiteľov. Pretože on si bude myslieť, že pri takomto pracovnom zaťažení nám zostalo ešte trošku a my sa prepadneme, t. j. nezabije systémový proces, ale niečo menej dôležité. Tým menej dôležitým bude intenzívny spotrebiteľ zdieľanej pamäte, konkrétne postmaster. A po tom bude dobré, ak nebude potrebné obnovovať databázu.
Preto teraz, pokiaľ si pamätám, väčšina distribúcií má predvolené hodnoty okolo 6, t. j. v akom momente začať používať swap v závislosti od toho, koľko pamäte zostalo. Teraz odporúčame nastaviť vm.swappiness = 1, pretože to v podstate vypína, ale nedáva taký efekt, ako s nečakaným príchodom OOM-killera, ktorý všetko zahubí.
Čo ďalej? Keď hovoríme o výkone databáz a postupne sa dostávame k diskovým jednotkám, všetci sa chytajú za hlavu. Pretože pravda, že disk je pomalý a pamäť rýchla, je nám všetkým známa už od detstva. A všetci vedia, že v databázach môžu vzniknúť problémy s diskovým výkonom.
Hlavný problém s výkonom PostgreSQL, ktorý súvisí s výkyvmi v checkpointoch, nevzniká kvôli pomalému disku. Je to skôr preto, že priepustnosť pamäte a disku nie je vyvážená. Môže byť nevyvážená na rôznych miestach. PostgreSQL nie je nakonfigurované, operačný systém nie je nakonfigurovaný, hardvér nie je nakonfigurovaný a hardvér je nesprávny. Tento problém nevzniká, iba ak všetko prebieha ako má, to znamená, že buď nie sú žiadne záťaže, alebo nastavenia a hardvér sú dobre prispôsobené.
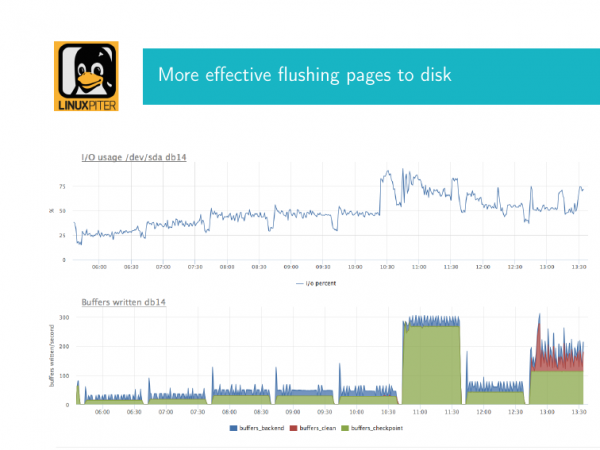
Čo to je a ako to vyzerá? Zvyčajne sa do tohto procesu zapájajú ľudia, ktorí pracujú s PostgreSQL viackrát. Vysvetlím. Ako som už spomínal, PostgreSQL pravidelne vykonáva checkpointy, aby presunulo znečistené stránky zo zdieľanej pamäte na disk. Ak máme veľký objem zdieľanej pamäte, checkpoint začne intenzívne pôsobiť na disk, pretože presúva tieto stránky pomocou fsync. Prichádza do kernel buffer a zapisuje sa na disky pomocou fsync. A ak je objem tohto procesu veľký, môžeme pozorovať nepríjemný efekt, a to veľmi vysokú využiteľnosť diskov.
Tu mám dve obrázky. Teraz vysvetlím, čo to je. Toto sú dva grafy, ktoré sú korelované v čase. Prvý graf – to je využitie disku. V tomto momente dosahuje takmer 90 %. Ak máte databázu s fyzickými diskami, a s RAID ovládačom je využitie pod 90 %, to sú zlé správy. Znamená to, že ešte chvíľu a dosiahne to 100 a vstup-výstup sa zastaví.
Ak máte diskový arzenál, je to trošku iný príbeh. Závisí to od toho, ako je nastavený, aký arzenál je a tak ďalej.
A súčasne je tu nakonfigurovaný graf z interného PostgreSQL pohľadu, ktorý ukazuje, ako prebieha checkpoint. A zelenou farbou je tu zobrazené, koľko bufferov, tých špinavých stránok, prišlo v tomto checkpoint na synchronizáciu. A to je hlavné, čo tu treba vedieť. Vidíme, že máme veľa stránok a v určitom momente sme narazili na obmedzenie, t. j. písali sme a zjavne je diskový systém veľmi zamestnaný. A náš checkpoint má veľmi silný vplyv na disk. Ideálne by situácia mala vyzerať skôr takto, t. j. tu by bolo menej zápisu. A môžeme to vyriešiť nastaveniami, aby to takto fungovalo. T. j. malá utilitizácia, ale niečo tu predsa len zapisujeme.
Čo treba urobiť, aby sme tento problém prekonali? Ak vám zastavilo IO pod databázou, znamená to, že všetci používatelia, ktorí prišli vykonávať svoje požiadavky, budú čakať.
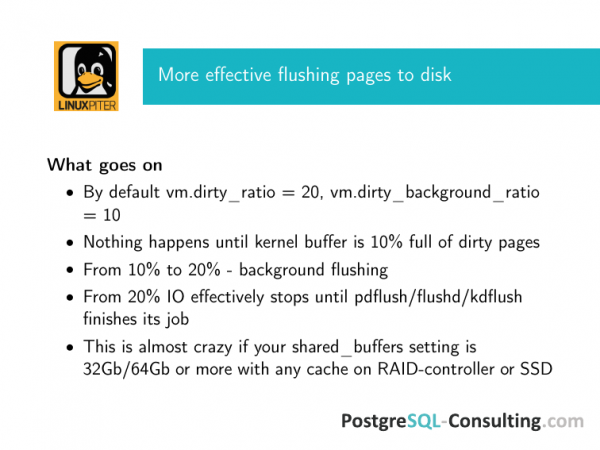
Ak sa pozrieme z pohľadu Linuxu, ak máte dobrý hardware, správne ho nastavíte, normálne nakonfigurujete PostgreSQL, aby robil tieto checkpoints menej často, rozložil ich v čase medzi sebou, potom sa dostanete na predvolené parametre Debianu. Pre väčšinu distribúcií Linuxu je takýto obraz: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Čo to znamená? S jadrom 2.6 sa objavil jeden démon pre vyprázdňovanie. Pgflush, v závislosti od toho, kto čo používa, ktorý sa zaoberá pozadím vyprázdňovaním špinavých stránok z kernel bufferu a zaistí vyprázdnenie, keď je potrebné, bez ohľadu na to, čo to znamená.
Kedy nastáva pozadie? Keď 10 % z celej operačnej pamäte, ktorá je na serveri, je obsadené špinavými stránkami v kernel bufferi, potom sa volá špeciálna funkcia na vyprázdnenie v pozadí. Prečo je to pozadí? Prijíma ako parameter, koľko stránok vyprázdniť. A, povedzme, vyprázdňuje N stránok. A na nejaký čas táto funkcia zaspí. A potom sa opäť vráti a vyprázdňuje ďalšie množstvo stránok.
To je extrémne jednoduchý príbeh. Tu je úloha ako s bazénom, keď do jednej rúrky sa vylieva, do druhej sa nalieva. Náš checkpoint prišiel a ak poslal málo špinavých stránok na vyprázdnenie, postupne sa to všetko z kernel bufferu pgflush opatrne rozptýli.
Ak sa tieto znečistené stránky naďalej hromadia, môžu dosiahnuť až 20 %, potom je operačný systém donútený všetko toto zapísať na disk, pretože dôjde k výpadku napájania a všetko pôjde zle. Tieto údaje stratíme, napríklad.
Aký je trik? Trik spočíva v tom, že tieto parametre, ktoré predstavujú 20 a 10 % z celkovej operačnej pamäte v počítači, sú z hľadiska priepustnosti akéhokoľvek diskového systému, ktorý máte, úplne obludné.
Predstavte si, že máte 128 GB operačnej pamäte. 12,8 GB prichádzajú do vášho diskového systému. A bez ohľadu na to, aká vyrovnávacia pamäť tam je alebo aký pole máte, nebudú to zvládať.
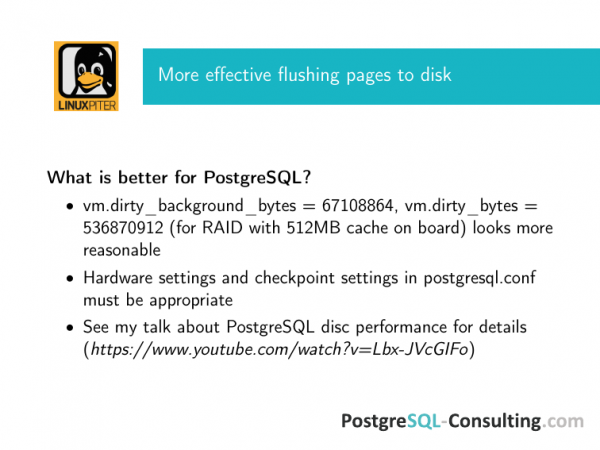
Preto odporúčame tieto čísla nastaviť podľa možností vášho RAID ovládača. Tu mám hneď odporúčanie pre ovládač, ktorý má 512 MB vyrovnávacej pamäte.
Všetko sa počíta veľmi jednoducho. Môžete nastaviť vm.dirty_background v bajtoch. A tieto nastavenia zrušia predchádzajúce dve. Buď pomer predvolene, alebo ak sú povolené tie, ktoré sú v bajtoch, budú fungovať tie, ktoré sú v bajtoch. Ale keďže som DBA konzultant a pracujem s rôznymi klientmi, snažím sa mať veci pod kontrolou, a preto, ak v bajtoch, tak v bajtoch. Nikto nedal žiadnu záruku, že dobrý admin nepridá serveru pamäť, neobnoví ho a číslo zostane rovnaké. Jednoducho si vypočítajte tieto čísla, aby sa s istotou všetko zmestilo.
Čo sa stane, ak sa nezmestíte? Napísal som, že efektívne sa zastaví akékoľvek ukladanie, ale v skutočnosti ide o frazé. Operačný systém má veľký problém – má veľa znečistených stránok, preto sa efektívne zastavuje ten IO, ktorý generujú vaši klienti, t. j. prišlo aplikácia s SQL dotazom do databázy, čaká. Akýkoľvek vstup/výstup do nej je na najnižšej priorite, pretože databáza je zaneprázdnená checkpointom. A kedy ho dokončí, je úplne nejasné. A keď dosiahnete nie pozadie, nie pozadia flushingu, to znamená, že všetko IO je stále obsadené týmto. A pokiaľ to neskončí, nič neurobíte.
Existujú ešte dva dôležité body, ktoré presahujú tento príspevok. Tieto nastavenia by mali zodpovedať nastaveniam v postgresql.conf, t. j. nastaveniam kontrolných bodov. A váš diskový systém musí byť adekvátne nastavený. Ak máte RAID cache, mala by obsahovať batériu. Ľudia kupujú RAID s dobrým cashom bez batérie. Ak máte SSD v RAID, mali by to byť serverové, mali by mať kondenzátory. Tu je podrobný kontrolný zoznam. Na tomto odkaze je moja prednáška o tom, ako nastaviť výkon disku v PostgreSQL. Obsahuje všetky tieto kontrolné zoznamy.
Čo ešte môže veľmi skomplikovať život? To sú dva parametre. Sú relatívne nové. Môžu byť predvolene zapnuté v rôznych aplikáciách. A môžu veľmi skomplikovať život, ak sú zapnuté nesprávne.
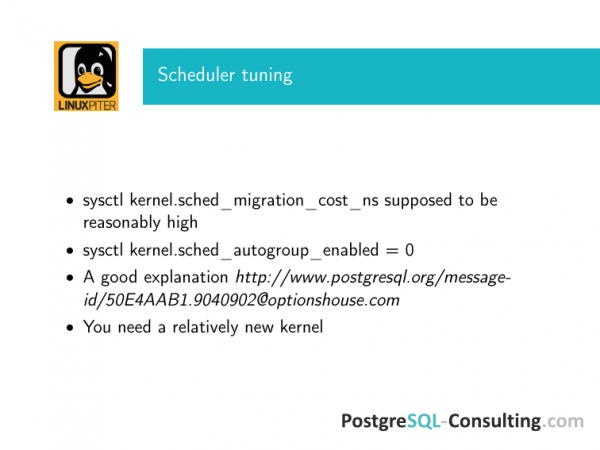
Existujú dve relatívne nové veci. Objavili sa už v treťom jadre. Je to sched_migration_cost v nanosekundách a sched_autogroup_enabled, ktorý je predvolene zapnutý.
A ako komplikujú život? Čo je to sched_migration_cost? Linuxový plánovač môže migrovať proces z jedného CPU na druhý. A pre PostgreSQL, ktorý vykonáva dotazy, migrácia na iný CPU je úplne nepochopiteľná. Z pohľadu operačného systému, keď prepínate okná medzi OpenOffice a terminálom, to môže byť dobré, ale pre databázu – to je veľmi zlé. Preto rozumná politika je nastaviť migration_cost na nejakú vysokú hodnotu, aspoň niekoľko tisíc nanosekúnd.
Čo to znamená pre plánovač? Bude považovať, že počas tejto doby je tento proces stále horúci. T. j. ak máte nejakú dlhú transakciu, ktorá niečím zaoberá, plánovač to pochopí. Bude si myslieť, že pokiaľ neprejde tento časový limit, migrácia tohto procesu nie je potrebná. Ak sa proces niečoho dotýka, nebude nikam migrácia a pokojne dokončí na tom CPU, ktoré mu bolo pridelené. A výsledok je výborný.
Druhý aspekt – to je autogroup. Existuje dobrý nápad pre špecifické pracovné zaťaženia, ktoré nemajú vzťah k moderným databázam – to je skupinová procesy podľa virtuálneho terminálu, z ktorého boli spustené. Je to pohodlné pre niektoré úlohy. V praxi je PostgreSQL viacprocesový systém s predpreparovaním (prefork), ktorý sa spúšťa z jedného terminálu. Máte zámok pre zapisovanie, kontrolný bod a všetky vaše klientské požiadavky sa zoskupujú do jedného plánovača, na jeden CPU. A budú tam spolu čakať, kedy sa uvoľní, aby si navzájom prekážali a viedli ho čo najdlhšie. Toto je situácia, ktorá nie je potrebná pri takomto zaťažení, a preto je potrebné to vypnúť.
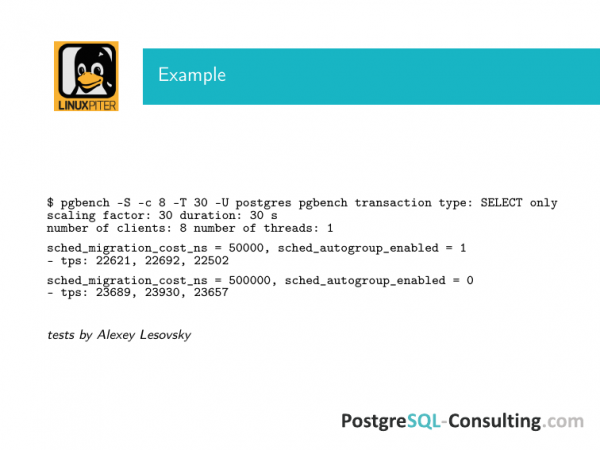
Môj kolega Alexej Lesovský vykonal testy s jednoduchým pgbenchom, kde zvyšoval poradie migration_cost a vypínal autogroup. Rozdiel na slabom hardvéri bol takmer 10 %.Existuje diskusia v mailing liste PostgreSQL, kde ľudia zdieľajú výsledky, ako takéto zmeny ovplyvnili rýchlosť požiadaviek. ovplyvnili o 50 %.Takýchto príbehov je pomerne veľa.
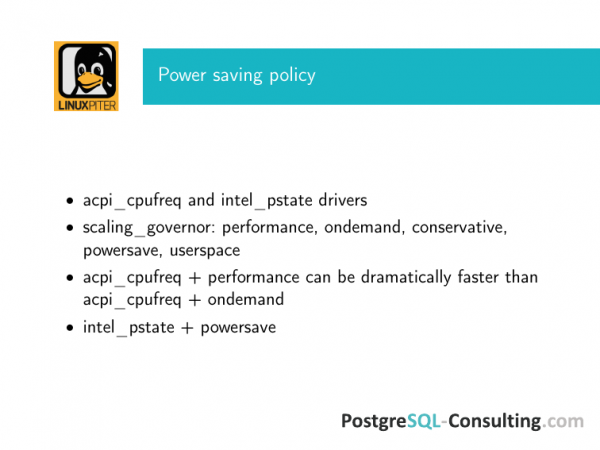
A nakoniec o politike šetrenia energie. Dobré je, že teraz možno používať Linux na laptopoch. A mal by údajne dobre hospodáriť s batériou. Ale zrazu sa ukazuje, že na serveroch to môže byť tiež.
Navyše, ak si prenajímate servery od nejakého poskytovateľa, tak "hodní" hostitelé sa nestarajú o to, aby ste mali lepší výkon. Ich úlohou je zabezpečiť, aby sa hardvér maximalizoval efektívne. Preto môžu mať predvolene v operačnom systéme zapnutý režim úspory energie pre laptopy.
Ak na serveri s databázou pod intenzívnym zaťažením použijete toto, vaša voľba je acpi_cpufreq + performance. Už s ondemand budú problémy.
Intel_pstate je už trošku iný ovládač. A teraz sa preferuje tento, pretože je novší a lepšie funguje.
A teda, guvernér len performance. Ondemand, powersave a všetko ostatné – to nie je pre vás.
Výsledky po explain analyze PostgreSQL sa môžu líšiť o niekoľko poriadkov, ak zapnete powersave, pretože pod databázou sa CPU plánuje úplne nepredvídateľným spôsobom.
Tieto veci môžu byť zapnuté predvolene. Pozorne sa pozrite – nezapli ich predvolene. Môže to byť naozaj veľký problém.
Na záver by som chcel poďakovať chlapcom z nášho DBA tímu PosgreSQL-Consulting, najmä Maxovi Bohuku a Alexejovi Lesovskému, ktorí sa každý deň potýkajú s problémami v tejto oblasti. A pre našich klientov sa snažíme zabezpečiť, aby to všetko fungovalo čo najlepšie. Je to ako s pokynmi na bezpečnosť letectva. Všetko je napísané krvou. Každý z týchto skrutiek bol objavený počas niektorého problému. Rád sa o ne s vami delím.
Otázky:
Ďakujem! Ak napríklad firma chce ušetriť a umiestniť databázu a aplikačnú logiku na jednom serveri, alebo ak firma ide s moderným trendom mikroslužieb, kde sa PostgreSQL spúšťa v kontejnere. O čo ide? Sysctl vplýva globálne na celé jadro. Nevedel som o tom, že by sa sysctl nejakým spôsobom virtualizovali, aby fungovali v kontejnere oddelene. Existuje len cgroup a tam je iba čiastočná kontrola. Ako je možné s tým existovať? Alebo ak chcete výkon, tak spustite PostgreSQL na samostatnom fyzickom serveri a doladte ho?
Na vašu otázku sme odpovedali približne tromi spôsobmi. Ak ide o fyzický server, ktorý môžete doladiť atď., tak sa uvoľnite, všetko bude bez týchto nastavení fungovať dobre. Ak máte takú záťaž, že potrebujete tieto nastavenia, fyzickému serveru sa dostanete skôr, ako k týmto nastaveniam.
Aký je problém? Ak je to virtuálka, pravdepodobne budete mať veľa problémov, napríklad s tým, že na väčšine virtuálok je dosť nekonzistentná latencia disku. Aj keď je priepustnosť diskov dobrá, jedna zlyhávajúca transakcia vstupno-výstupnej operácie, ktorá výrazne neovplyvňuje priemernú priepustnosť, sa môže vyskytnúť v momente checkpointu alebo pri zápise do WAL, a databáza to bude znášať ťažko. A toto si všimnete skôr, ako sa dostanete k týmto problémom.
Ak budete mať NGINX na tom istom serveri, tiež budete mať ten istý problém. Bude súťažiť o zdieľanú pamäť. A ku problémom, ktoré sú tu opísané, sa nedostanete.
Na druhej strane, niektoré z týchto parametrov budú pre vás stále relevantné. Napríklad, s pomocou parametra sysctl si nastavte dirty_ratio na nižšiu hodnotu, aby to nebolo také extrémne – v každom prípade to pomôže. Tak či onak, interakcia s diskom bude nevyhnutná. A táto interakcia bude na nesprávnej schéme. To, čo som ukázal, sú predvolené parametre. A v každom prípade je lepšie ich zmeniť.
S NUMA môžu byť problémy. VmWare, napríklad, dobre funguje s NUMA s presne opačnými nastaveniami. A tu je potrebné sa rozhodnúť – fyzický server alebo nefyzický.
Mám otázku týkajúcu sa Amazon AWS. Majú predkonfigurované image. Jeden z nich sa volá Amazon RDS. Existujú tam nejaké vlastné nastavenia pre ich operačný systém?
Existujú nastavenia, ale sú to iné nastavenia. Tu nastavujeme operačný systém z pohľadu toho, ako databáza bude túto situáciu využívať. A tam sú parametre, ktoré určujú, akým smerom ideme, aké zdroje potrebujeme a ako ich teraz využijeme. Po tomto Amazon RDS tie zdroje priradí, a tam výkon klesá. Sú samostatné príbehy, ako sa niektorí ľudia s týmto zaobchádzajú. Niekedy aj celkom úspešne. Ale to nesúvisí s nastaveniami OS. To je skôr hacking v cloude. To je iný príbeh.
Prečo transparentné obrovské stránky nemajú efekt v porovnaní s obrovským TLB?
Nemajú. Toto môžeme vysvetliť mnohými spôsobmi. Ale v skutočnosti jednoducho nemajú efekt. Aký je príbeh PostgreSQL? Pri spustení si vyhradí veľký kus zdieľanej pamäte. Či sú transparentné alebo nie – nie je to vôbec dôležité. Fakt, že sa vyčlenia pri štarte, vysvetľuje všetko. A ak je pamäte veľmi veľa a treba prestavať segment zdieľanej pamäte, potom budú transparentné obrovské stránky relevantné. U PostgreSQL je to jednoducho pri štarte vyčlenené ako veľký kus a hotovo, a ďalej sa už nič mimoriadne nedeje. Samozrejme, môžete ich použiť, ale existuje riziko získania poškodenia zdieľanej pamäte, keď sa niečo bude prealokovávať. PostgreSQL o tom však nevie.
Zdroj: habr.com
